LangChain 发布 LangSmith Fine-Tuning:打通智能体轨迹到模型微调的端到端闭环
LangChain 正式推出 LangSmith Fine-Tuning 功能及 `smithtune` CLI 工具,旨在将存储在 LangSmith 中的智能体运行轨迹直接转化为微调数据集。该工具不仅驱动训练流程,还自动评估微调后的模型并将结果上传回 LangSmith 进行分析。通过与 Fireworks 和 Baseten 的合作,实现了从数据收集、微调到评估的一站式自动化工作流。
报道正文
本文目录15 个章节

Ankush GolaJake BroekhuizenVivek Trivedy2026年9月24日8分钟返回博客创建智能体创建智能体
核心要点
- 使用 LangSmith Fine-Tuning CLI 和技能
smithtune,利用存储在 LangSmith 中的智能体轨迹(agent trajectories),通过一个端到端的工作流生成微调模型 - 除了驱动训练过程外,
smithtuneCLI 还负责评估微调后的模型,并将评估结果上传至 LangSmith,以便轻松进行分析 - 我们与 Fireworks 和 Baseten 合作,建立了 LangSmith 轨迹与这两个平台微调数据集创建之间的无缝连接
今天,我们正式推出 LangSmith Fine-Tuning 和 smithtune——一款帮助团队将 LangSmith 轨迹转化为用于其智能体的自定义微调模型的 CLI 工具。它通过单个 CLI 处理整个微调流程:从 LangSmith 轨迹中创建和准备数据集、使用 Fireworks 或 Baseten 进行训练,以及使用 LangSmith 进行评估。你可以直接运行 smithtune,也可以配合你的编码智能体来执行命令并检查结果。
smithtune 专为模型后训练(post-training)构建。目前支持监督微调(SFT),即使用良好行为示例来训练模型。你向模型提供输入/输出数据,模型通过更新权重来模仿这种行为。LangSmith 的轨迹数据旨在支持 SFT,而 smithtune 有助于将这些轨迹转化为有用的训练数据。
这为团队提供了一种无需手动构建数据管道即可训练专用模型的方法。在你的示例上训练的模型,在特定任务上的表现往往能与通用前沿模型持平甚至更优,且通常具有更低的成本和延迟。
在 GitHub 上试用 LangSmith Fine-Tuning,并通过安装来自该仓库的 smithtune 技能,让你的编码智能体端到端地驱动微调流程。
数据选择是微调效果提升的最大驱动力之一。随着
smithtune的推出,连接这一闭环变得更加容易——从 LangSmith 中精选的生产环境追踪记录,到 Fireworks 上的托管训练及模型服务。团队可以无缝地完成从数据准备、模型训练到部署的全流程,而无需自行搭建基础设施。这正是我们期待与 LangChain 共同构建的路径。
– Pranav Jain, Fireworks 产品负责人
smithtune与 Baseten Loops 的集成,使团队能够在几分钟内无缝地从数据收集过渡到运行微调实验。借助 Loops 提供的全托管训练基础设施,开发者能够持续收集并优化数据,从而随时间推移产出更优质的模型,让他们可以专注于为最重要的客户用例进行设计。
– Aaron Ellis-Bloor, Baseten 应用研究员
Agent 轨迹与后训练
在深入探讨 smithtune 提供的功能之前,我们先来讨论一下 agent 轨迹(agent trajectories)。
轨迹是一个有序的消息、工具调用和工具结果序列,展示了 agent 如何解决任务。LangSmith 从追踪记录或会话线程中组装这一序列,将支持的消息格式统一为标准表示形式,保留工具定义,并去除重复的历史记录。
LangSmith 的轨迹格式在设计时充分考虑了后训练(post-training)的需求。对于监督微调(SFT),学生模型需要教师模型在产生成功结果时所拥有的确切上下文。在复杂的长周期 agent 中,工具可用性上下文往往随着 agent 的工作进程而变化(例如,延迟工具加载),而简单导出最终消息列表会丢失这些细微差别。LangSmith 的轨迹格式精确记录了模型在每一轮交互中所看到的内容,因此 smithtune 可以将每个动作与其真实的上下文配对。
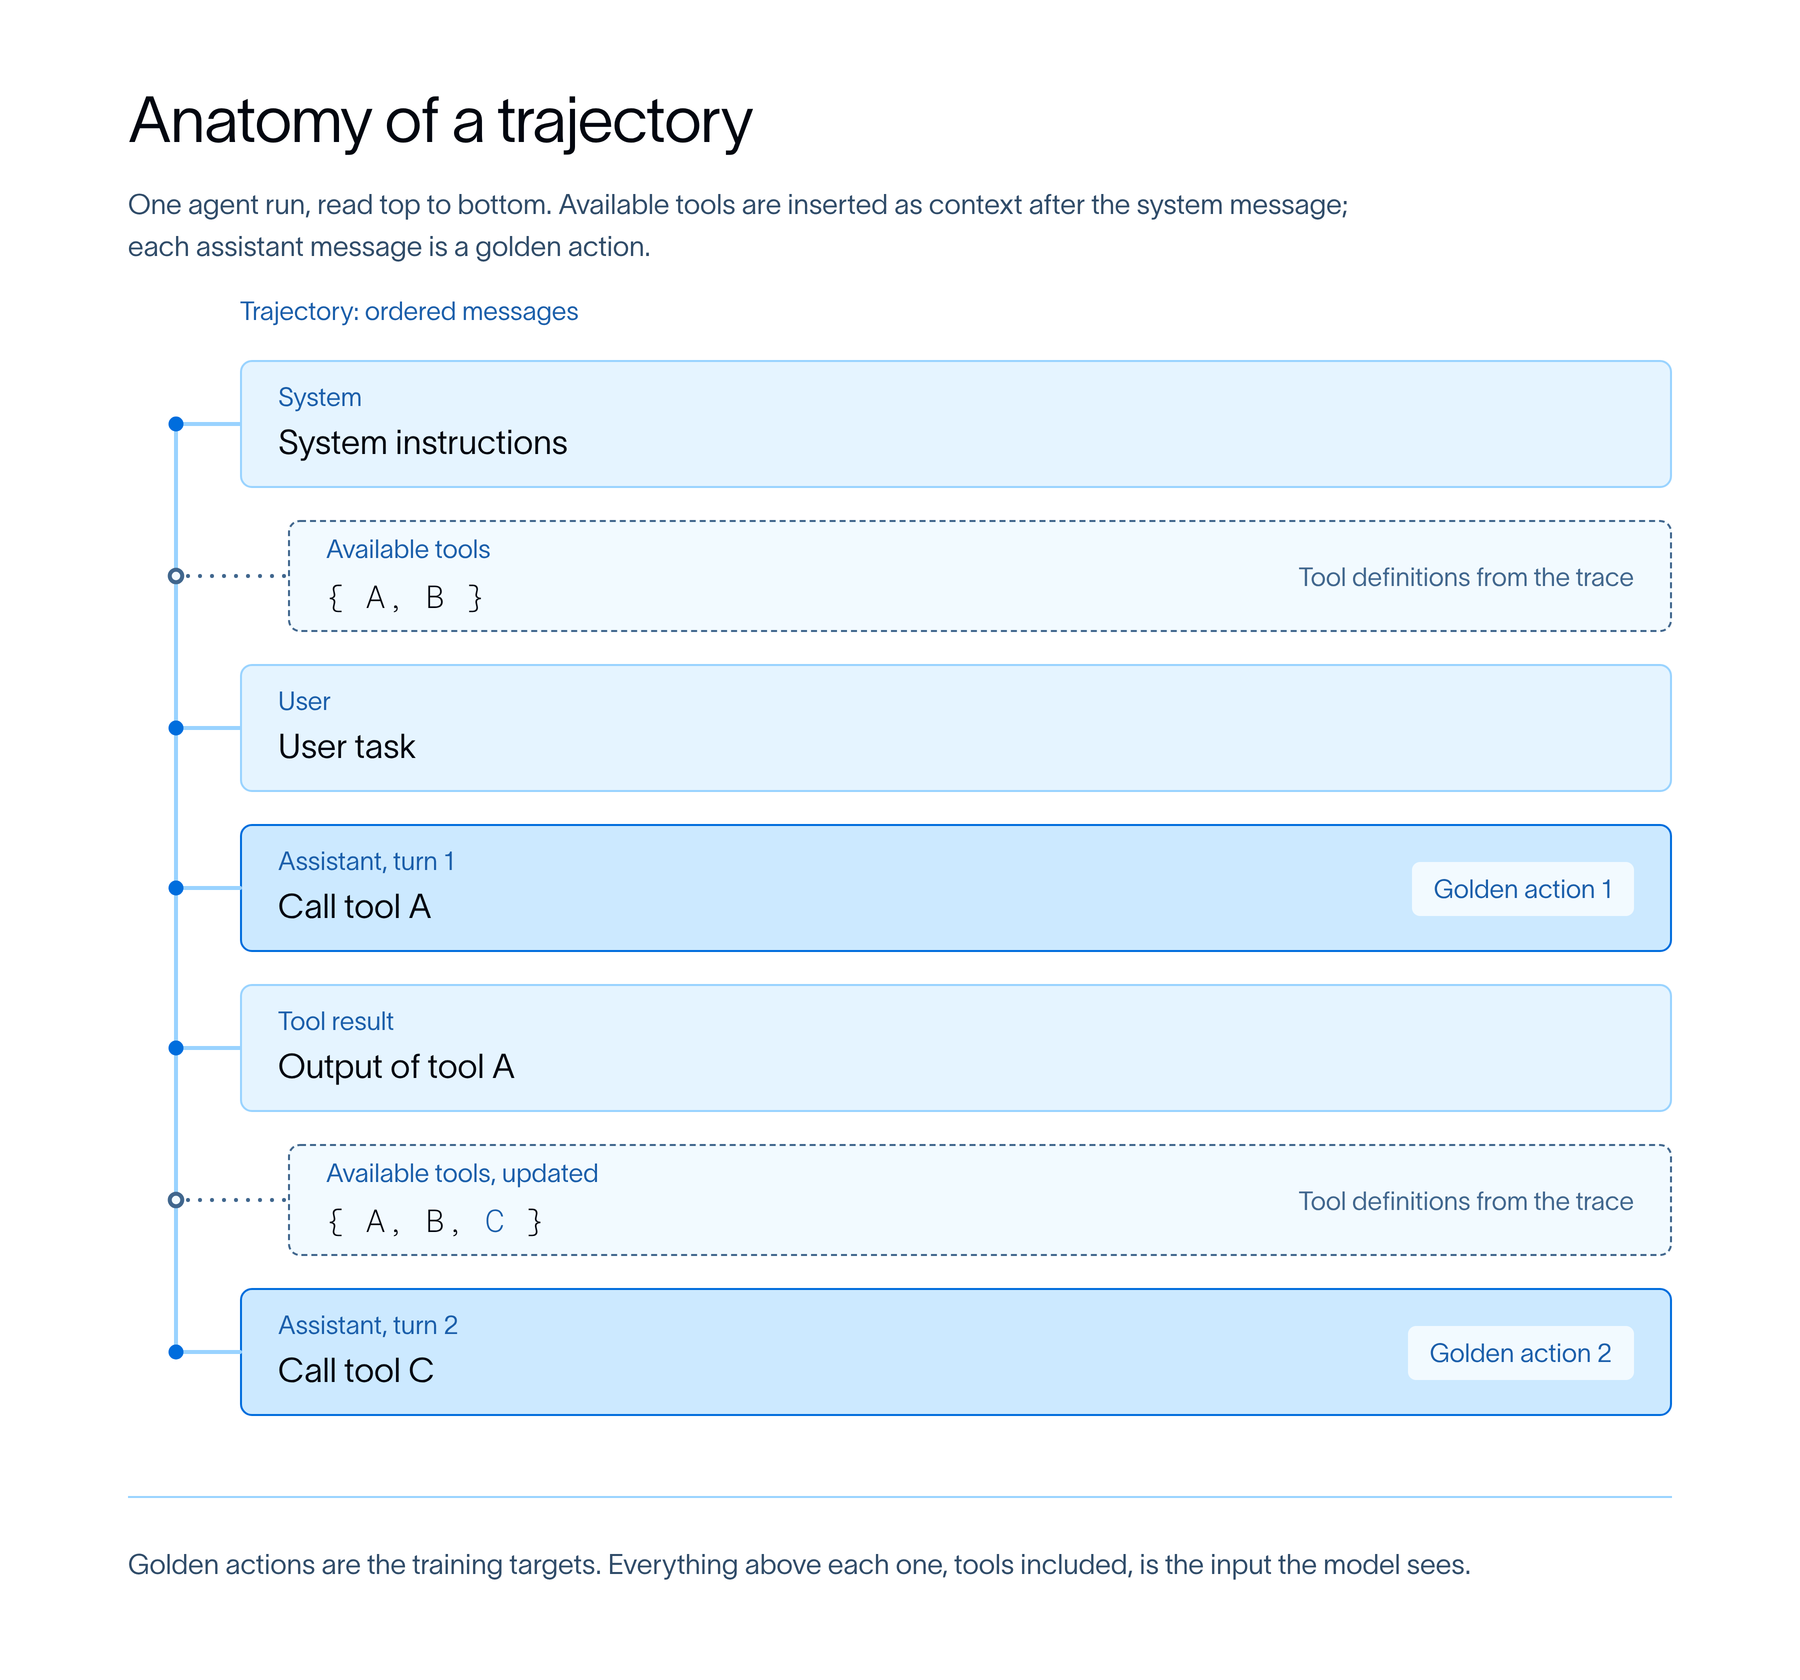
smithtune 在整个工作流中使用轨迹。你可以精选成功的示例轨迹,针对所选模型进行预处理,并使用其中记录的响应和工具调用进行训练。未纳入训练集的轨迹则为评估提供了上下文和参考动作。
逐步操作指南
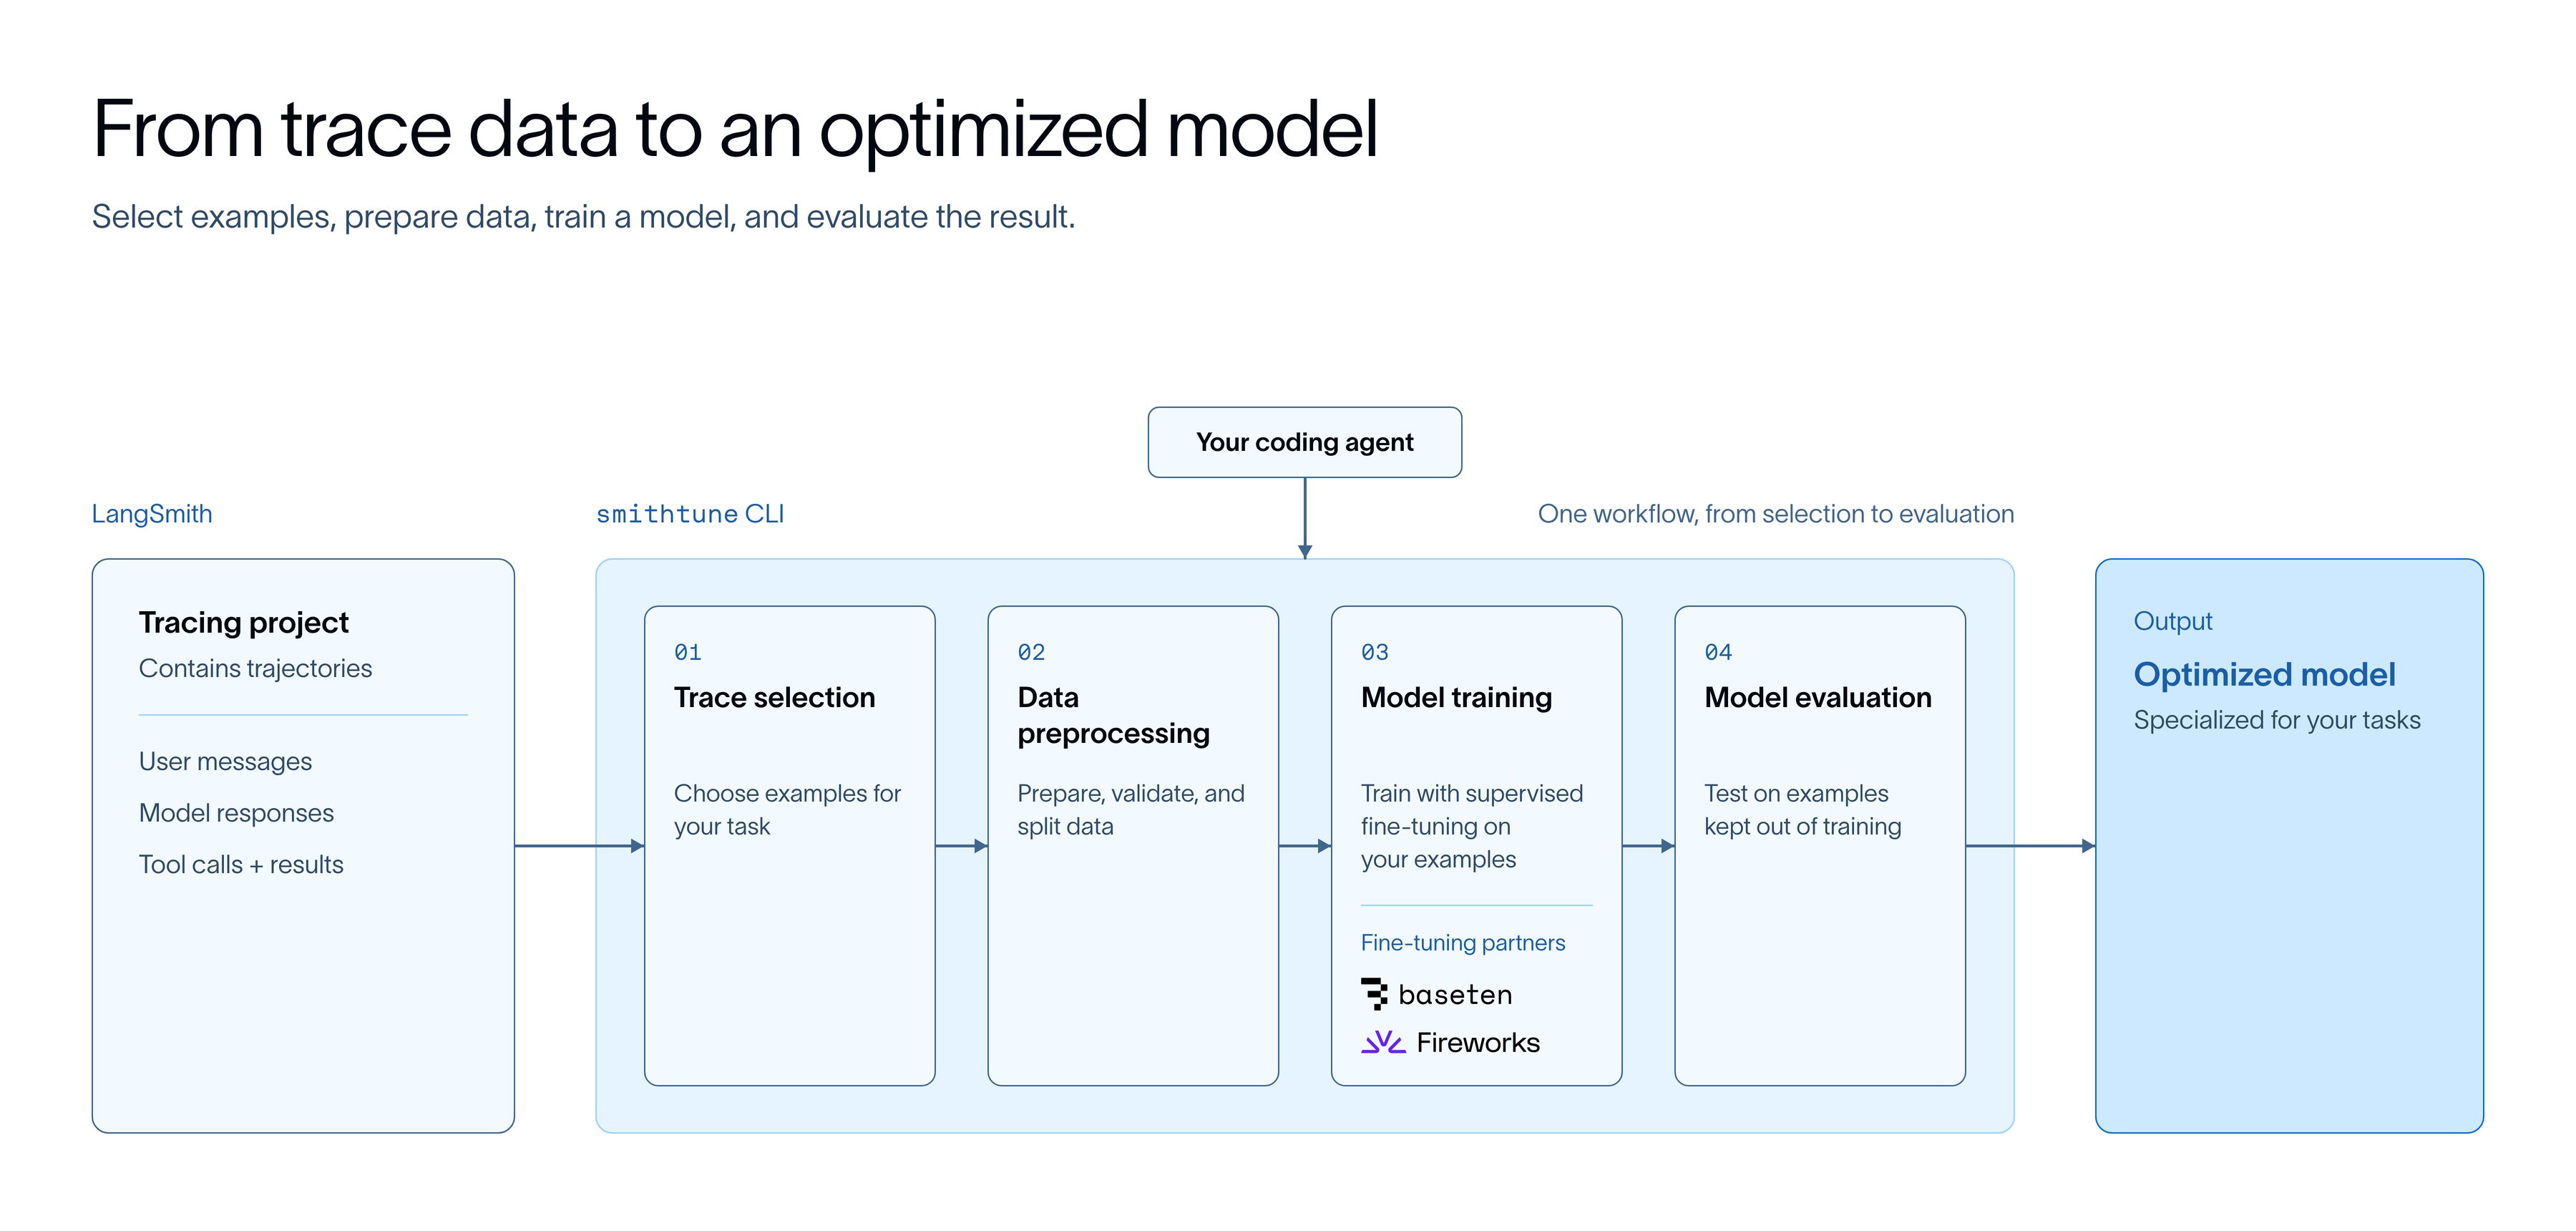
构建数据集
数据集包含目标模型将拟合的“黄金”轨迹(golden trajectories)。这些数据是监督微调(SFT)的基础。
使用 smithtune 创建数据集时,主要有以下几个关键阶段:
- 拉取数据集:
smithtune从 LangSmith 追踪项目中将轨迹拉取到本地目录DIR,并支持可选的过滤条件。 - 标注追踪记录:
smithtune与人类(及其代理)协作,识别“优质”追踪记录的特征,据此制定评估标准(rubric),然后派遣一个代理委员会来审查和筛选适合作为 SFT 候选的优质轨迹。 - 存储持久化数据集:
smithtune确保用于训练的任何数据都可以作为持久化产物进行后续审计。它将商定的黄金轨迹集上传至 LangSmith 数据集,用于训练和评估。
在此过程中,smithtune 还会处理以下细节:
- 通过过滤超出指定序列长度的追踪记录,确保轨迹与所选模型兼容
- 将数据拆分为训练/验证/测试集,以便进行下游评估
训练模型
在正式提交训练任务之前,smithtune plan 可帮助人类审查各项设置,例如所选模型、训练样本数量以及学习率、批次大小(batch size)和轮数(epochs)等超参数。
你可以在运行 smithtune train 启动微调任务之前调整这些设置。smithtune 会将任务提交给 Fireworks 托管 SFT 或 Baseten Loops,这两者均支持在你准备好的轨迹上进行 LoRA 训练。你无需自行管理 GPU 资源调配或训练基础设施。在训练期间,smithtune 还会检查验证集上的性能,并选择验证损失最低的保存检查点(checkpoint)。
评估结果
训练完成后,运行 smithtune evaluate 以比较选定的检查点与基础模型。
smithtune 使用内置的重放评估机制来测试基础模型与微调后的模型。评估重点在于模型能否完成黄金轨迹中的动作,并由评判器(judge)根据真实记录的示例对这些预测结果进行打分。
CLI 会返回一个 LangSmith 对比链接,随着评估的进行,结果会实时呈现。你可以比较得分、检查单个响应和工具选择情况,并查看微调在哪些地方带来了提升或引入了回归问题。
部署你的模型
如果你对评估结果满意,请使用 smithtune deploy 来部署你经过微调的模型,并将其连接到你的应用程序中。
如果结果不符合预期,请优化数据集或调整训练设置,然后重新进行训练和评估。你可以与编码代理(coding agent)一起在 LangSmith 中审查对比结果,以确定哪些响应或工具选择需要进一步改进。
实际运行结果
为了评估 smithtune 流程的质量,我们将其应用于 LangChain 中两个使用频率极高的代理:
- Engine 分析代理轨迹以发现故障并对相关问题进行分组。我们使用了 Engine 中某个代理的精简版本,测试 SFT(监督微调)是否能提高其识别和组织这些问题的能力。
- OpenSWE Review 审查我们真实代码仓库中的代码变更。我们测试了 SFT 是否能在减少查找 bug 所需工作量的同时,保持审查质量不变。
Engine:通过专业化实现更高的任务性能
我们精心整理了一组高质量的轨迹数据,并使用这些数据对基础版 Kimi K3 进行了微调。基础版 Kimi 模型本身已经很强,但我们通过 harness engineering(框架工程)挖掘其潜力以及 GPT-5.6 Sol 的能力已接近极限。在 IssueBench(我们内部用于问题检测和分组的基准测试)的一个子集上,微调后的模型得分显著高于基础版 Kimi 和 GPT-5.6 Sol。
| 模型 | 任务得分 ↑ |
|---|---|
| GPT-5.6 Sol | 87.0 |
| Kimi K3 | 90.0 |
| Kimi K3 + SFT | 96.0 |
OpenSWE Review:以更少的调用次数实现相近的质量
我们还在一个内部评估集上对 Qwen-3.8-27B 进行了评估,该评估集包含真实的 Pull Request,用于衡量代码审查质量和 bug 检测能力。在此次对比中,SFT 将 F1 分数从 48.9% 提升至 53.7%,同时减少了 29.8% 的模型调用次数和 29.4% 的工具请求次数。
| 模型 | F1 ↑ | Precision ↑ | Recall ↑ | 每次审查的模型调用次数 ↓ | 每次审查的工具请求次数 ↓ |
|---|---|---|---|---|---|
| Qwen-3.8-27B | 48.9% | 62.9% | 40.0% | 55.9 | 65.8 |
| Qwen-3.8-27B + SFT | 53.7% | 81.5% | 40.0% | 39.2 | 46.5 |
早期一个选择性较低的训练集在 SFT 后降低了 F1 分数。随后,我们回到数据整理流程中,为每条 Trace 增加了一个审查阶段,旨在对智能体认为确实存在潜在问题的 Trace 进行过采样。
实际机会在于以更少的模型和工具调用实现类似的审查质量。这意味着每次审查的成本更低,且每个 PR 的审查周转时间更快。
后训练的考量因素
何时适合使用 SFT
当你的应用程序执行重复性任务,并且你拥有展示其应有行为的示例时,SFT 特别有用。寻找希望模型学习的一致模式,例如遵循工作流、利用工具结果决定下一步操作以及验证自身工作成果。
我们建议团队首先进行 Harness 工程优化,以了解更好的 Harness 是否能带来良好的性能表现。如果智能体在任务上仍会犯反复出现的错误,并且你拥有展示如何正确完成该任务的轨迹(trajectories),那么 SFT 是一个值得尝试的绝佳候选方案。
数据选择
我们一致发现,最成功的后训练运行往往源于在训练数据选择上投入的时间。smithtune 明确帮助用户与智能体一起审视数据,我们发现让领域专家与智能体协作审查用于 SFT 的 Trace,能够提高后训练成功运行的几率。
开始使用 LangSmith Fine-Tuning
LangSmith Fine-Tuning 现已推出公开测试版(Public Beta)。要开始使用,你需要:
- 一个包含智能体 Trace 数据的 LangSmith 账户
- Fireworks 或 Baseten 的 API 密钥
smithtuneCLI
请在 GitHub 上试用 smithtune,并告诉我们你接下来希望看到什么功能。随着我们不断改进 LangSmith 中的微调工作流,我们非常期待你的反馈。
在 GitHub 上开始使用 LangSmith Fine-Tuning。

查看你的智能体究竟在做什么
LangSmith 是我们的智能体工程平台,帮助开发者调试每一个智能体决策、评估变更,并一键部署。