量子位官网 · 10/19/2026, 18:15:19
Zhongxing Micro Unveils 12 Interconnect Chips for Domestic AI Clusters
Domestic interconnect chipmaker Zhongxing Micro unveiled 12 mass-produced chips, including NICs, storage cards, and switches. The company focuses on full-stack self-developed solutions for general and AI computing to address bandwidth bottlenecks in large-scale clusters. With 800,000 units shipped cumulatively, it has secured strategic partnerships with major ecosystem players like Kylin, Tencent Cloud, and Inspur.
SOURCE COVERAGEFull Original Report
Contents3 sections
允中 发自 凹非寺 量子位 | 公众号QbitAI
算力产业的宏大叙事方兴未艾,头部玩家的目光已投向牌桌最隐秘的要害位置。
近日,一家被称之为“中国博通”的国产互连芯片企业,迅速闯进算力市场主流视野。一场发布会,整整12款量产芯片登场,外加三款高性能互连芯片新品和一整套核心IP。
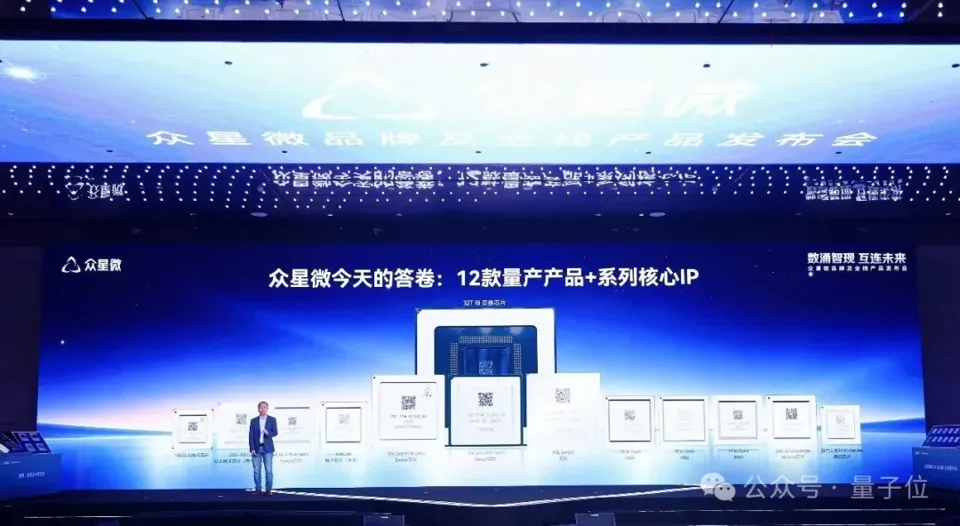
这就是“众星微”。低调整整6年,一场首秀差点把国际巨头的桌子掀了。
震动业界的不仅是横跨“通算互连+智算互连”的全场景自研产品布局。现场,从操作系统、云、整机等软硬件生态伙伴,到运营商、金融等各行业客户,都在为这家高性能互连公司站台。
翻开成绩单,包含网卡、存储卡和Switch芯片,众星微全栈产品出货量已达到80万颗。
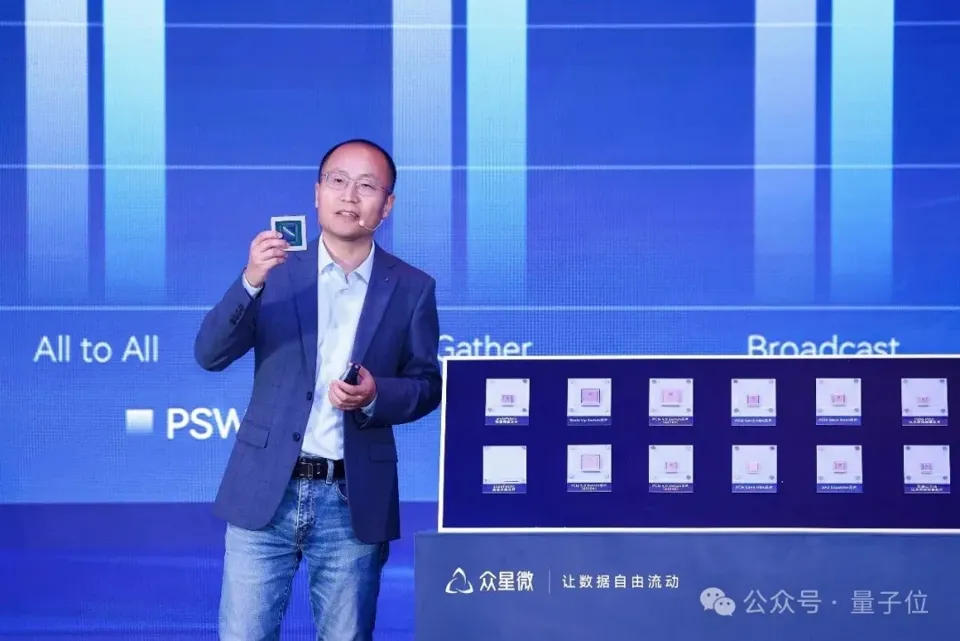
出道即引爆,在这个“酒香也怕巷子深”的年代着实罕见。尤其国内高性能互连市场一直由国际巨头主导,互连芯片层的替代工作又极其复杂,头部算力玩家为什么抱团选TA?
解开那只扼住喉咙的手
近年来,随着数字化、智能化应用狂飙,算力市场需求增速有目共睹。其中,互联网巨头资本开支持续加码,超大规模算力基建频频落地,算力竟赛俨然成为AI时代核心主线。
不过,在大规模计算集群中,算力效能的释放是一道连环命题。
单卡能力的提升、集群卡数的堆叠,都是提升算力性能参数的常规手段。但要真正跑出集群整体效能,互连芯片才是连通算力基础设施的“高速公路”。
“算力基础设施建设是一个系统工程。”
无锡众星微系统技术有限公司总经理郭二辉认为,“算力绝非简单的设备堆砌,而是计算、网络、存储、供电、散热、调度等子系统深度耦合的有机整体。”
他指出,想要充分释放出算力效能,必须以系统工程的方法统筹规划、协同寻优,否则任何短板都会被放大为整体瓶颈。
显然,当国产GPU、CPU、存储芯片纷拥崛起,集群规模扩展到万卡、十万卡层级时,互连芯片成为集群系统效能的那块短板,也是扼住算力产业咽喉的又一只“黑手”。
具体来看,大规模算力集群中,多个计算节点需要频繁交换梯度、模型参数等数据,这些通信操作正在无限放大网络带宽瓶颈,制约着集群有效算力的发挥。
互连芯片的价值由集群规模放大。郭二辉给出一个公式,集群有效算力=单点算力×规模×互连效率。
这也意味着,算力建设方若一味在单卡和卡数上用功,投资回报率将出现明显的边际递减效应。把互连短板补全,才是当前最迫切、也最见效的一环。
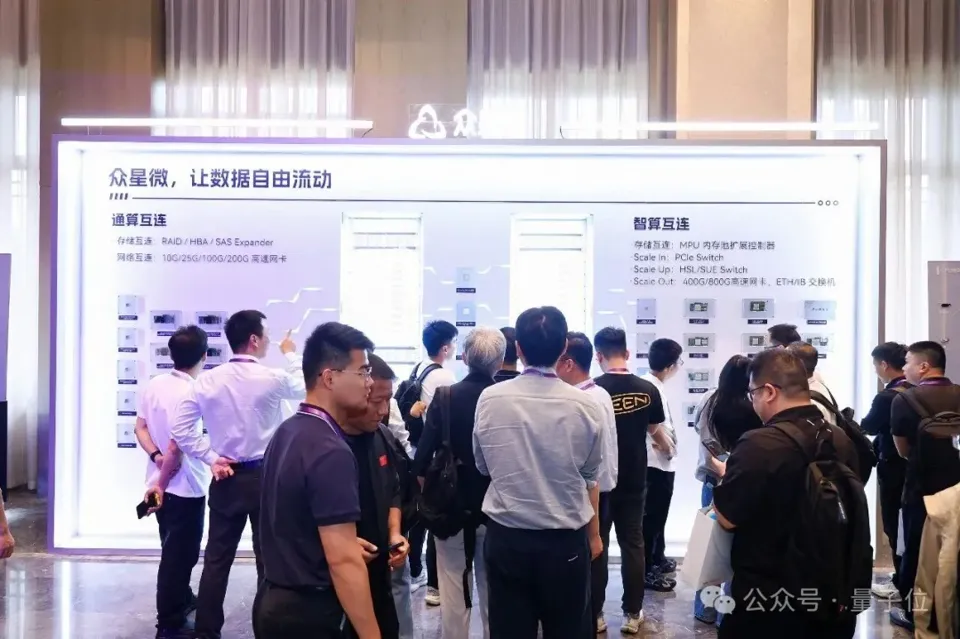
那么问题来了,过去全球高性能互连市场主要由博通等国际巨头主导,国内相关品牌在技术成熟度和产品布局上远未臻至完善。
前者产品全、性能强,但供应链不确定因素大;后者起步慢、芯片性能和产品覆盖度不足,但在本土供应保障上有优势。“二选一”的困境,真切地摆在了国产算力玩家面前。
筑稳高端互连芯片供应链
前段时间,工信部、国家发改委联合印发了《电子信息制造业发展“十五五”规划》(简称“规划”)。其中,高速互连被明确列为“构筑先进计算生态体系”的重点技术攻关方向之一。
规划提出,要“加快计算架构、数据存储、高速互连、软硬协同、算电协同等先进计算产品及技术创新攻关……持续提升计算根技术、关键元器件、核心零部件……等供给水平。”
毋庸置疑,高速互连的国产化供给,成为算力时代关键命题。
幸运的是,6年前,众星微提前布局了这一赛道。
2020年4月,恰逢国家大基金加大高速互连芯片领域的投资,众星微接过了这一使命。彼时,国内高性能互连芯片研发基础十分薄弱。用郭二辉的话说,创业之初面临的是“四无”:
没有相关研发经验的工程师,没有一行代码,没有成熟的高性能互连芯片研发经验,也很难找到合适的核心IP。
一切都得从头开始,也意味着走过的每一步都在自己脚下。
选定赛道后,众星微短短几年间组建起一支千余人规模的研发团队,并且成功打通了核心IP、芯片、硬件、软件及系统研发链条。
曾经制约国产高性能互连芯片的关键环节,如高速SerDes、低时延交换架构、网络拥塞、无损传输与数据可靠性等,这家公司均已形成完整的自主技术沉淀。
就此,中国厂商开始平视国际巨头,真正具备了高性能互连芯片全栈研发能力。
根据测试数据,在16盘RAID5配置、256KiB顺序写测试中,众星微RAID卡写入带宽较国际大厂对标产品高约47%。
PCIe 5.0交换芯片在主机到设备、设备到主机传输测试中,带宽均达55GB/s,与国际大厂对标产品相当。
另外,众星微此次还基于PCIe 6.0 Switch、800G多协议AI NIC及多模RAID芯片三大新品,成功完成了高速计算互连、AI集群网络和企业级存储的全线拓展。
PCIe 6.0 Switch最多支持144条通道,带宽较上一代翻倍,具备100纳秒级时延,并支持CXL内存扩展与池化;
800G多协议AI NIC支持800G线速转发,达到微秒级时延,为大规模AI集群提供高性能高速通信能力;
多模RAID芯片支持SAS、SATA及PCIe 5.0三模连接,内置硬件加密引擎,兼顾存储吞吐性能与数据安全保障。
发布会上,郭二辉自豪宣布,“众星微12款芯片实现量产,累计出货超过80万颗,产品体系已覆盖通用计算和智能计算两大场景。”
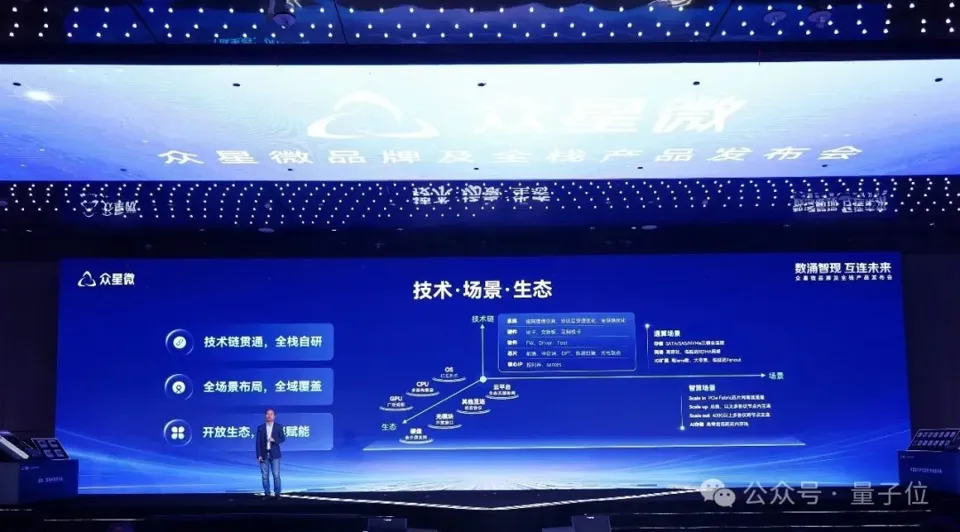
这种站位更高的规模化产品供给能力,终于让本土算力玩家,告别了高性能互连芯片断供危机。
头部厂商开始抱团投票
面对长期霸榜全球互连芯片赛道的博通,一家刚刚崛起的国产厂商凭何快速取得主流市场信任?
答案很简单:不趋易避难,多下笨功夫。
在计算系统工程中,互连芯片面临的需求场景十分复杂。尤其不同层级的数据传输需求,对底层芯片的要求存在明显差异,而且需要长期的稳定性、可靠性验证。
很多企业往往只能从门槛相对较低的环节入手,以快速完成市场导入和商业变现。这也导致国产互连芯片严重缺乏体系化和平台化能力。
众星微起步之初就选择了长期主义路线。不追求一时的利润报表,不着眼于局部市场的内卷式竞争,而是一步一个脚印,逐个攻克通用计算和智能计算全场景互连技术。
回头来看,这让其整整蛰伏了6年,也让这场首秀交出了一份含金量十足的成绩单。
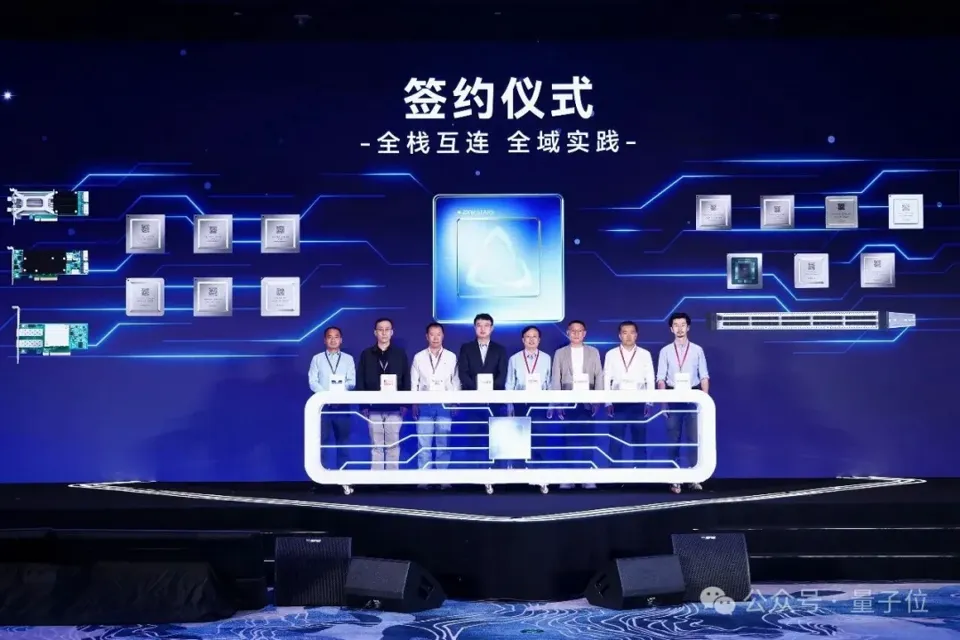
当然,真正让互联网巨头和整机厂商抱团投票的原因,在于供应链质量保障上的水磨工夫。
众所周知,互连芯片作为连接“存算网”的核心骨架,很大程度上决定着计算系统的长稳运行能力。比如在金融领域,用户对数据安全和系统稳定性的要求极为严苛——
产品能否长期稳定运行,能否适应复杂的软硬件环境,并在出现问题时迅速定位和解决,都是互连芯片厂商的必答题。
面对这张考卷,众星微并未急于推销产品,而是在交货前期建立了一套贯穿研发、设计、验证和量产的全流程质量管理体系。
比如在RAID卡产品领域,众星微研发团队曾使用500台服务器、1000张板卡,开展累计60万小时的实机测试,并通过高强度压力测试反复检验产品可靠性。
这种把问题解决在交付之前的精诚态度,也正命中了那些头部企业对产品稳定性的核心诉求。截至目前,众星微芯片产品客户退货率低于100 DPPM,板卡产品客户退货率低于500 DPPM。
据悉,众星微产品已全面进入浪潮、联想、新华三、中兴通讯等企业的产品与解决方案,在互联网、金融、运营商、电力能源等领域成功实现规模部署。
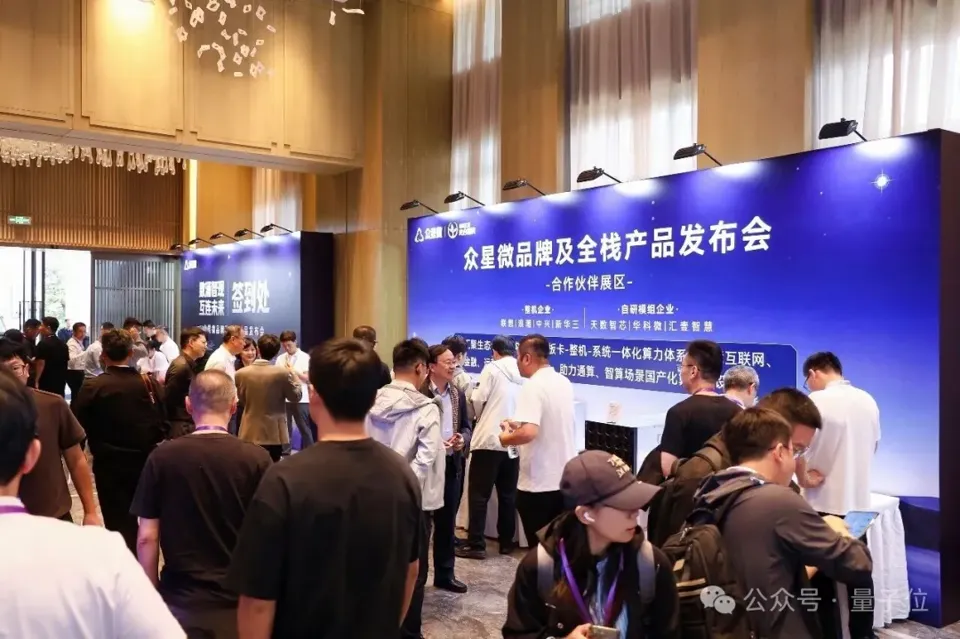
其中,运营商行业客户已部署众星微存储卡超10万片,稳定运行超过18个月。
这次发布会上,包括麒麟、统信、腾讯云、浪潮、新华三、中兴、联想等产业伙伴,进一步宣布与众星微达成战略合作。下一步,就是软硬件厂商协同推进国产高性能互连方案落地。
撼大摧坚,需久久为功。
从全栈布局到量产成果以及累计出货量,这家将“笨功夫”用到极致的芯片企业,刚刚冒头就迎来巨大的市场声量。这或许是时代对其战略定力的一种延迟奖赏。
*本文系量子位获授权刊载,观点仅为原作者所有。