InfoQ 中文 · 10/15/2026, 18:16:27
Zhipu's GLM Aids Discovery of 23 Microsoft Vulnerabilities as Top White Hat Yuki Chen Joins
Top white hat researcher Yuki Chen joined Zhipu after his team used the GLM model to discover 23 Windows vulnerabilities, including a critical CVSS 9.8 flaw, earning official credit from Microsoft. This validates LLMs' practical capabilities in cybersecurity and accelerates Zhipu's commercialization and talent integration in this vertical.
SOURCE COVERAGEFull Original Report
Contents3 sections
一个常年霸榜微软安全研究者榜单的顶级白帽,最近有了新身份。
10 月 14 日,知名白帽安全研究员古河(Yuki Chen)在社交平台 X 上发布了一条动态,低调宣布加入智谱。他表示,希望借助前沿 AI 的力量,构建一个更加安全的网络空间。
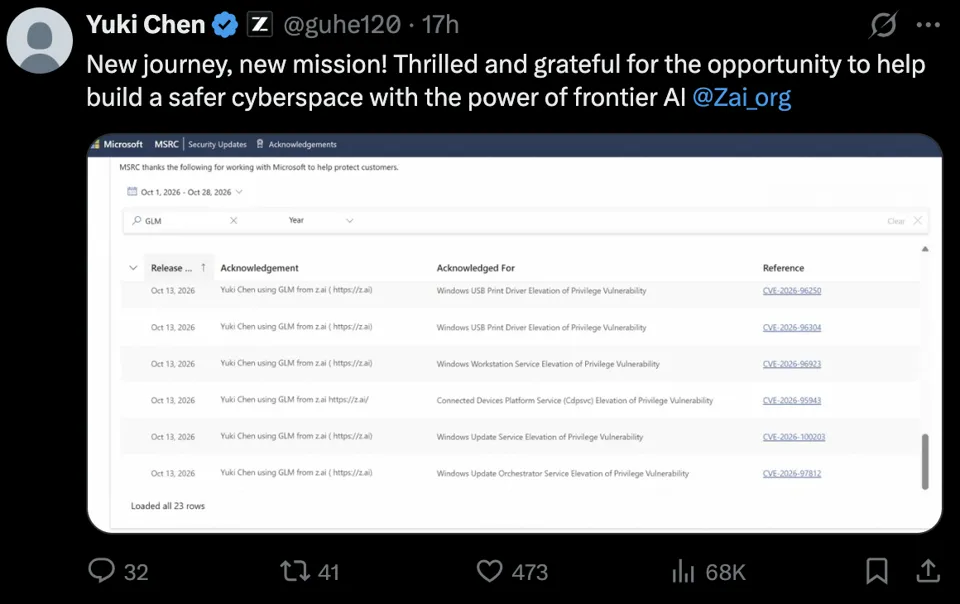
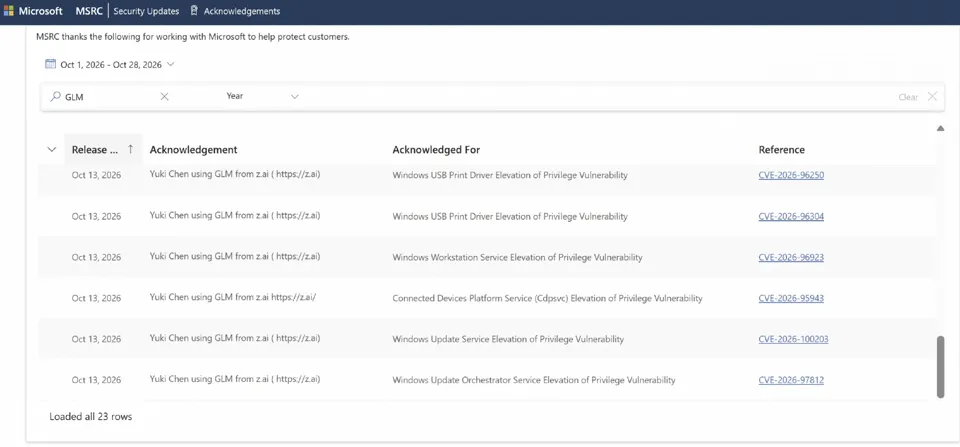
稍早前,微软最新一轮安全更新公布了一份颇为特别的漏洞致谢名单:23 个 Windows 漏洞的发现与 GLM 辅助的安全研究有关,其中包括一个 CVSS 评分高达 9.8 分的严重漏洞。在公开漏洞记录中,研究者署名明确写着“Yuki Chen using GLM from z.ai”。
过去两年,大模型厂商在编程、数学、推理等榜单上打得不可开交。如今,网络安全似乎逐渐成为新的竞争焦点。当一位长期站在传统安全研究顶端的专家,开始进入大模型公司,也意味着,挖洞这件事,看来要真的“变天”了。
常年霸榜微软的顶级白帽,开始用 AI 挖洞了
在全球安全研究圈,古河是个响当当的名字。
公开资料显示,古河拥有超过 15 年的攻防安全研究经验,曾在 2019 年、2021 年至 2024 年五次登顶微软 MSRC 最具价值安全研究者年度榜单,是首位获得该榜年度第一名的中国安全研究员。
他还曾两次斩获有“黑客奥斯卡”大奖之称的 The Pwnie Awards,分别是最佳远程漏洞奖和史诗级成就奖。此外,他曾在 Pwn2Own、天府杯等国际安全赛事中获奖,也曾担任 360 漏洞研究院院长。
古河的实力,近期再次得到了微软官方的认可。在全球安全研究圈,微软 MSRC 的漏洞致谢有着相当高的含金量。研究人员发现微软产品中的潜在漏洞后,可以向 MSRC 提交报告,经过确认、评估及相应的安全响应流程,相关研究成果才有机会获得公开致谢。
对于安全研究员而言,能在这样的名单上反复出现,本身就是专业能力的证明。这一次,与古河一起出现在微软漏洞记录中的,还有智谱的 GLM。古河及其团队借助 GLM 取得的 23 项漏洞研究成果获得微软致谢,其中还包括一个 CVSS 评分高达 9.8 分的严重漏洞。
过去,发现复杂漏洞往往高度依赖安全专家的经验。研究人员需要熟悉系统架构、理解大量代码、寻找异常的程序行为,再通过测试和分析验证漏洞是否真实存在。这是一项门槛很高、同时耗费大量时间的工作。AI 的加入,正在改变其中的一部分流程。它可以辅助阅读大规模代码库、分析函数调用关系、发现潜在异常,并借助工具开展验证。
这也是为什么古河这次加盟智谱,值得业内关注。这样一位长期站在微软安全研究者榜单前列的顶级白帽,选择用 GLM 挖洞,并将职业生涯的下一站放在智谱,无疑为 GLM 的网络安全能力增添了一份颇具分量的认可。
GLM 如何成为 23 个漏洞背后的“新武器”?
事实上,这并不是 GLM 第一次在挖洞上立功。
据智谱此前披露,早在今年 6 月,智谱发布 GLM-5.2 时,就曾联合国内多支安全团队,让模型在真实代码库上做漏洞挖掘。经过专家复核、筛选、去重后,模型在 269 个项目中发现了 2436 个漏洞,其中 1097 个为中高危,涉及系统内核、操作系统、浏览器引擎、开源基础组件等。据悉,相关漏洞已陆续提交 CNNVD/CNVD,智谱还建立了公开的安全披露账本,用于跟踪相关漏洞的披露进展。
今年 8 月,智谱发布 GLM-5.3 时,也将网络安全能力作为一次重要的技术进展对外披露。根据智谱公布的技术说明,团队在训练中引入了漏洞发现相关的数据与环境,希望强化模型发现、理解和分析安全漏洞的能力。
在白盒漏洞验证基准 CyberGym 上,GLM-5.3 取得 84.5% 的成绩,高于 GLM-5.2 的 77.2%,也领先 Anthropic Mythos 5 和 GPT-5.6 Sol。
Anthropic 甚至专门研究了 GLM-5.3 的网络安全能力。9 月 29 日,Anthropic 发布报告指出,GLM-5.3 已经具备自主构建端到端漏洞利用程序的能力,在部分测试中接近自家 Claude Mythos Preview 的水平。在 ExploitBench 测试中,GLM-5.3 成功完成了 410 次漏洞利用尝试中的 50 次,而 Mythos Preview 为 56 次。
智谱称,GLM-5.3 在后训练过程中展现出超乎预期的网络安全能力,在漏洞发现方面已接近全球领先模型水平,但在更深层次的漏洞利用任务上仍有差距。
第三方机构的评估也给出了类似判断。9 月 17 日,美国国家标准与技术研究院(NIST)下属人工智能标准与创新中心 CAISI 发布的评估报告显示,GLM-5.3 被评为当时网络安全能力最强的开放权重模型。不过,报告也指出,在综合网络安全能力上,GLM-5.3 与同期美国最前沿模型仍有差距,按照其评估方法估算,大致落后约四个月。
网络安全,正在成为大模型厂商的新战场
把目光从智谱移开,会发现网络安全正在成为全球前沿模型厂商共同押注的方向。
今年 3 月,OpenAI 推出应用安全 Agent——Codex Security 研究预览版。它能够理解代码库的上下文,构建与项目相关的安全分析,寻找潜在漏洞,再通过自动化验证降低误报,并生成相应的修复建议。
OpenAI 在发布时特别提到,现有 AI 安全工具存在的一个常见问题,是容易标记大量低影响缺陷或者误报,迫使安全人员花费大量时间筛选真正重要的问题。
一个月后,Anthropic 联合 AWS、苹果、Google、微软、英伟达等公司推出 Project Glasswing,利用 Claude Mythos Preview 的网络安全能力,对关键软件基础设施开展漏洞研究。
按照 Anthropic 当时披露的信息,Mythos Preview 已经在多个主流操作系统、浏览器及其他软件中发现了大量高危漏洞。Anthropic 还宣布投入最高 1 亿美元的模型使用额度,用于支持相关安全研究。
到了 10 月,Anthropic 又进一步扩展了面向专业安全研究人员的 Cyber Verification Program,为符合条件的安全团队提供不同等级的模型访问权限。与此同时,微软也在通过 FORGE Lab 探索由多个模型和 Agent 组成的自动化漏洞研究工作流。
几家公司的技术路线和产品策略并不完全相同,但指向的趋势已经相当清晰:网络安全正在从大模型的一类应用场景,进一步演变成模型厂商展示技术实力、争夺专业客户的重要方向。谁能率先在网络安全领域交出一份漂亮的答卷,谁就能打开一条新的商业化路径。
在这场竞争中,智谱已经率先尝到了商业化的甜头。按照智谱披露的信息,GLM-5.3 发布一个月后,网络安全成为 GLM 率先实现规模化收入的垂直场景,有上百家安全企业把 GLM 接入自己的产品与业务流程。
现在,古河补上了最后一块,也是最难买到的一块拼图:顶级人才的公信力。顶级安全研究员的加入,有望让模型技术与长期积累的专业攻防经验产生更紧密的结合。
当然,古河未来将具体承担哪些研究工作,又会如何影响 GLM 的技术演进,还需要更多公开信息来验证。但可以确定的是,随着前沿模型越来越深入网络安全这一专业领域,顶级安全研究人才的价值,也在被重新认识。