Tiger Data Open-Sources pg_vectorsearch with 25x Faster Index Builds
Tiger Data (formerly Timescale) released pg_vectorsearch, an Alpha-stage open-source PostgreSQL extension whose PRISM index uses partitioning and compression instead of pgvector's graph-based HNSW. In a 100M-vector benchmark, PRISM built its index in 1h40m on 128 GB RAM versus 42 hours on 512 GB for HNSW. It works with existing pgvector columns, letting apps run vector search without a separate vector database.
Full Report
Tiger Data 发布了 pg_vectorsearch,这是一个用于向量相似性搜索的开源 PostgreSQL 扩展,目前处于 Alpha 阶段。其 PRISM 索引采用数据分区和压缩技术,而非 pgvector 的 HNSW 索引所使用的基于图的方法,这样可以降低内存需求并缩短索引构建时间。
据开发者介绍,pg_vectorsearch 支持直接在 PostgreSQL 中进行更快、更节省内存的向量搜索,减少了处理大型向量数据集所需的基础设施。该扩展支持现有的 pgvector 列,使应用程序不需要单独的向量数据库就可以执行向量搜索。要使用这些新功能,开发者必须安装这个扩展,并在向量列上创建一个 PRISM 索引:
CREATE EXTENSION pg_vectorsearch;
CREATE INDEX ON documents USING prism (embedding vec32_l2_ops);
复制代码
在 Tiger Data 自己使用 1 亿个向量进行的基准测试中,PRISM 在一台配备 128 GB 内存的机器上仅用 1 小时 40 分钟就构建好了索引,而 HNSW(Hierarchical Navigable Small World)在配备 512 GB 内存的机器上要耗时 42 小时。Tiger Data(前身为 Timescale)是 TimescaleDB 的开发公司。TimescaleDB 是一款用于时间序列数据和实时分析的开源 PostgreSQL 扩展。
Tiger Data 高级工程师 Erik Nordström、首席工程师 Matvey Arye 以及产品营销经理 Noah Hein 写道:
PRISM 为 PostgreSQL 引入了一种基于分区的方案,这与比较新的专用向量搜索系统所采用的方法类似。PRISM 并非将每个向量与其在图中的邻居连接起来,而是将相似的向量分组到分区中,并以压缩格式将其存储为列表,然后高密度地封装在数据库页中。
HNSW 是一种近似最近邻算法,可以在大型数据集中快速查找相似的向量;而 PRISM 则将搜索范围缩小到相关分区,并依次扫描压缩后的向量。这不仅减小了索引大小,还避免了耗时的随机内存或磁盘访问,从而能够直接在 PostgreSQL 中使用更少的 RAM 实现更快的向量搜索。
Tiger Data 联合创始人兼首席技术官 Michael Freedman 发表了一篇文章,详细介绍了 PRISM 向量索引的架构。该索引在 pg_vectorsearch 中结合了分层聚类技术,缩小了搜索空间,压缩了向量,实现了高效的顺序扫描,并通过 RaBitQ 量化技术减少了耗时的距离计算。为了提高召回率,它会在分区边界附近复制向量,并依托 PostgreSQL 的原生存储、日志记录和并发机制。
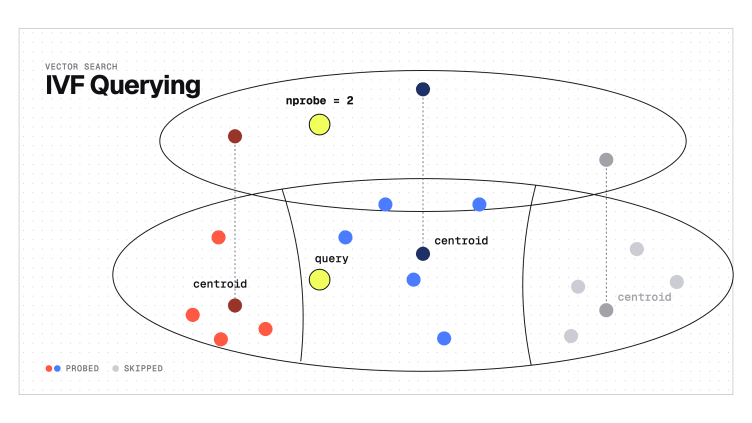
增量重平衡功能尚未完全实现,因此如果数据频繁变化,可能需要通过重建索引来保持搜索效率。Freedman 解释道:
更棘手的问题在于,如何随着数据集的变化维持聚类结构。当新向量加入时,聚类中心不会自动移动,而索引列表也会逐渐失去其最初的物理局部性。目前,我们仅支持对扁平索引中的超大索引列表进行有限的按需拆分,但包括合并和重新分配在内的更通用的重平衡操作尚未实现。
在 Hacker News 上一个热门的帖子中,大家的整体反应是既感兴趣又持谨慎态度。从业者们看到了在 PostgreSQL 内部实现更快且内存占用更低的向量搜索的潜力,但同时也对独立的基准测试验证、pg_vectorsearch 能否取代 pgvectorscale,以及缺乏过滤搜索支持等问题表达了疑问。Hermon Hagos 评论道:
向量搜索的成本刚刚降低了(……)对于像我们这样在单个数据库上构建 RAG 应用且预算紧张的人来说,这一点至关重要。无需启动单独的向量存储或更大的服务器就能实现快速语义搜索,这确实能节省一大笔开支。目前,该功能仍然处于 Alpha 阶段,因此暂不建议将其部署给客户,但这确实是一个值得密切关注的功能。
尽管尚未经过独立验证,但 Tiger Data 的基准测试使用了开源工具,将前 10 位召回率与精确搜索结果做了对比,并在相同的 PostgreSQL 配置和实例类型下,将两种索引进行了比较——其中 HNSW 采用了 pgvector 的 16 位 halfvec。
这个新的向量扩展需要 PostgreSQL 18 或更高版本,目前支持最多 1968 维的向量。在正式发布之前,不支持结合 WHERE 和 ORDER BY 进行向量搜索过滤。该项目的代码已经在 GitHub 上开源。Tiger Data 计划将其现有的 pgvectorscale 扩展转入维护模式。
声明:本文为 InfoQ 翻译,未经许可禁止转载。
原文链接:https://www.infoq.com/news/2026/11/postgresql-vector-search/