Amap Details Marketing AI Quality Engineering with Decision Graph and AgentLoop
Amap's marketing team shared an engineering practice that embeds AI into software quality assurance: a LangGraph-based Graph Engineering decision graph on the R&D side organizes multi-role code review and outputs risks plus verification conditions, while an AgentLoop workflow on the testing side handles change analysis, test case design and automation. Both capabilities are live separately, but a unified task protocol, cross-side handoff and delivery gates remain under construction.
Related Entities
Full Report
阿里妹导读
文章内容基于作者个人技术实践与独立思考,旨在分享经验,仅代表个人观点。
一、问题背景
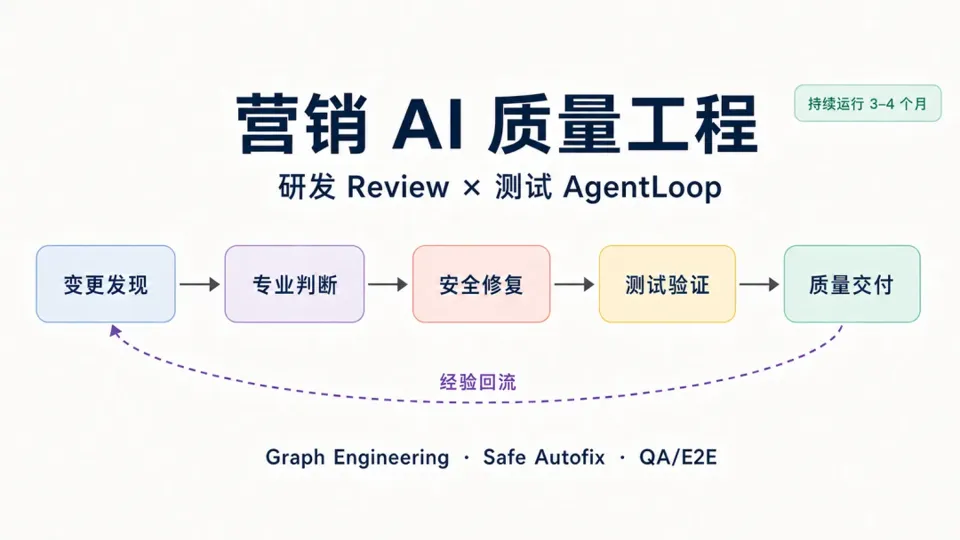
本文所说的 AI 质量工程,是将 AI 的分析与执行能力纳入软件质量保障过程的一种工程实践:由 AI 辅助识别风险、设计测试和执行验证,通过明确的业务规则、权限边界、人工审阅与运行记录,约束其判断和动作。它关注的是每一条建议如何被验证、每一次修改如何被追踪,以及最终凭什么作出交付决定。
AI 参与软件交付后,团队需要解决两个相连的问题:研发侧如何识别值得处理的风险,测试侧如何验证这些风险是否已经得到控制。只有把风险依据、测试预期和实际运行结果关联起来,"发现问题"才能进一步转化为可追溯的交付依据。
在高德营销业务中,我们分别建设了研发侧的 Graph Engineering 决策图和测试侧的 AgentLoop 工作流。前者围绕代码变更组织多角色评审,输出风险、代码位置及验证条件;后者围绕业务规则完成变更分析、用例设计、测试方案设计和自动化实现,产出测试资产与运行记录。本文沿着"研发识别风险—测试验证风险—形成交付证据链"介绍这两侧实践。
目前,研发风险识别与测试验证能力已分别落地。统一任务协议、跨侧自动交接、结果回流和交付门禁仍在建设。本文分别介绍已落地的能力、案例记录及后续协同设计。
图 1 研发决策图与测试交付图的协同设计。统一证据协议与跨侧自动回流为后续建设方向。
二、研发侧风险识别
决策图如何形成可验证的风险结论
研发侧以研发平台中的应用为入口,组织仓库、分支、扫描范围和验证命令等上下文。评审由规则与 Agent 配合完成:规则处理边界明确的问题,Agent 结合代码、需求和历史信息识别需要进一步判断的风险。
我们用 LangGraph``StateGraph 显式组织评审过程。Generator 先形成基础 Finding;PM、QA、Developer、SRE、Security 等角色并行审查需求边界、测试条件、稳定性和安全性;Reducer 合并重复结论;Judge 判断有效性、严重度和处理优先级。在策略允许时,Executor / Refiner 再生成修复方案,并根据验证诊断进行有限次数的迭代。
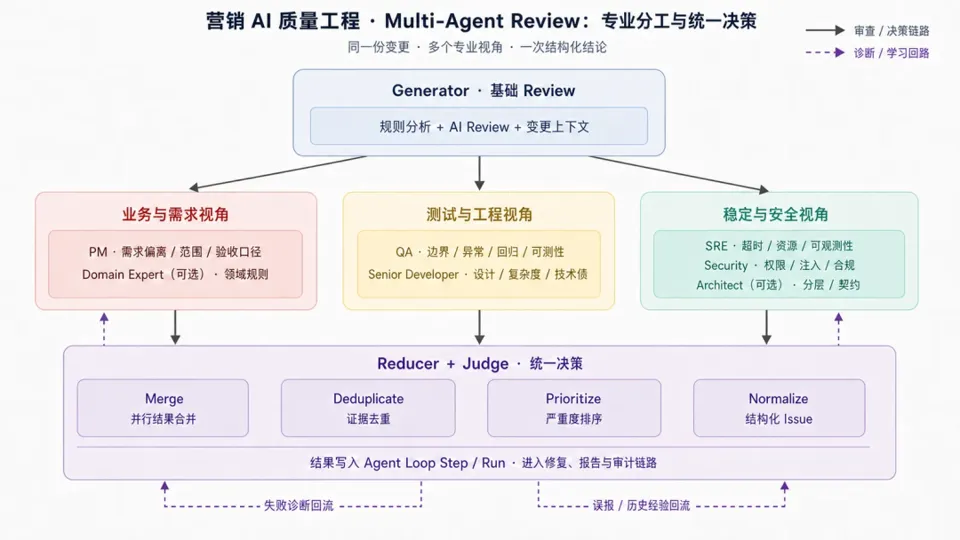
图 2 多角色评审决策图,包括角色分工、结论合并与诊断回路。
这张决策图的输出不仅是修改建议,还要说明风险是什么、判断依据位于哪里,以及需要什么结果才能确认风险得到处理。例如,"新增枚举未覆盖兜底分支"需要同时给出变更位置、可能受影响的业务条件和待验证场景,才能成为测试侧可继续使用的输入。
安全修复权限阶梯
风险判断与执行权限分开管理。Safe Autofix将修复流程拆分为以下动作,各动作由策略分别控制:
proposal → dry-run → apply → verification → commit → push → optional MR
进入修复前,先检查策略白名单、风险等级、置信度和证据锚点;实际修改前执行 dry-run,修改后运行仓库验证。commit、push 和 MR 分别受控,验证通过本身不会自动开启后续交付权限。每次尝试均记录验证结果、失败原因及操作来源。
验证失败时,命令输出与诊断可以回流给 Refiner。超过迭代或预算上限后,停止自动尝试,按执行状态处理本地改动并转为报告项;已经发生的远端动作需要单独处理。保留这些边界,是为了让风险识别、修复建议和实际交付各自具有可核查的依据。
当前 Safe Autofix 主要完成了流程和权限机制建设,相关快照中自动修复记录为 0,现阶段仍以风险识别、人工确认和安全边界验证为主,尚未将自动修改数量作为建设目标。
三、测试侧验证闭环
Oracle Problem:预期结果从哪里来
能够生成和编译测试代码,并不意味着测试验证了正确的业务行为。假如 Agent 从实现代码推导出预期值,再用这个值检查同一段实现,代码中的错误可能被一并写进断言。这就是测试中的 Oracle Problem:如何确定正确的预期结果。
我们的处理方式是标注预期来源。需求文档中的业务规则可以提供独立于实现的依据;提交说明可辅助理解意图,但仍需核对;仅从实现代码推导的预期只能说明代码行为,不能单独证明业务正确。阶段一提取 requirement_expectations[],把规则及其适用条件传递给后续阶段。缺少独立规则时,应明确验证能力受限,而不是把代码行为直接提升为业务标准。
对关键风险点,我们比较实际响应、需求规则和用例断言是否一致,并设计能够区分目标行为与错误行为的场景。例如,在业务规则确实要求不同输出时,合法与非法输入应有不同断言。正反向检查能提高测试的辨别能力,但有限用例通过不等于证明所有实现路径都正确;需求本身的准确性仍需人工判断。
四阶段 AgentLoop
AgentLoop 通过变更分析、测试用例设计、测试方案设计和自动化实现四个核心阶段形成测试资产,再通过执行验证、失败诊断、覆盖率分析和报告汇总完成后续验证。初始化属于运行准备。
| 核心阶段 | 主要工作与产物 |
|---|---|
| ① 变更分析 | 识别变更范围、风险点和需求预期,形成 change-impact-analysis.md。 |
| ② 测试用例设计 | 确定业务场景、输入条件与断言,形成 test-cases.md;检查可构造性、重复场景、边界真实性、可观测性及环境可行性。 |
| ③ 测试方案设计 | 将业务场景映射到测试框架、数据准备和执行方式,形成 test-plan.md。 |
| ④ 自动化实现 | 生成测试代码与实现摘要;结合执行结果定位失败原因,产出可复查的验证记录。 |
图 3 测试工作流。①—④为四个核心阶段,⑤—⑧为执行验证、失败诊断、覆盖率分析和报告汇总。上游设计回溯须经人工确认。
相邻核心阶段之间设置人工审阅。阶段四可以在本阶段内进行受限修订;如果失败根源在上游业务理解或测试设计,应暂停并请求人工确认,不绕过已经通过的审阅环节。这样可以分别检查"测什么""怎么测"和"代码怎样实现",避免把不同层次的问题混在一次生成中处理。
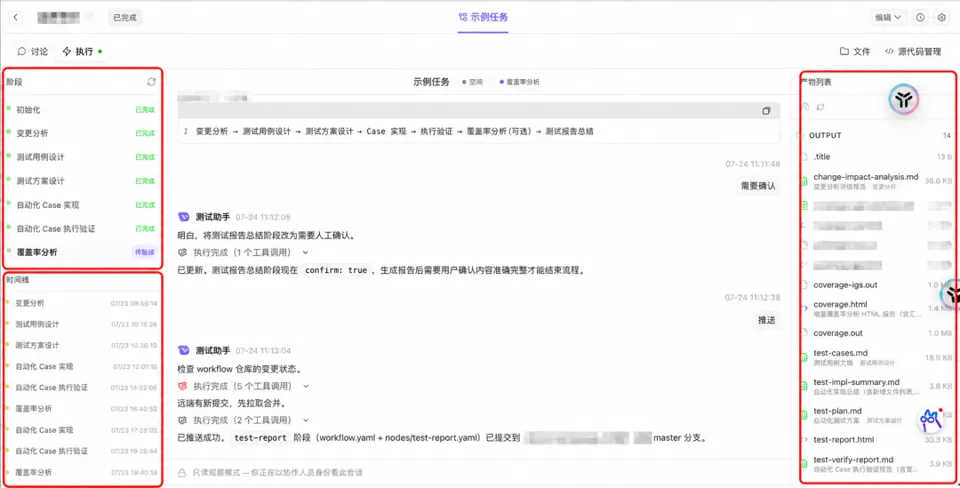
图 4 工作流界面脱敏展示,呈现阶段、时间线与产物列表。初始化等准备节点和人工确认环节也在界面中显示;本图用于说明工作流组织方式。
Kbase 用于补充代码差异中缺少的环境知识,例如缓存规则、Mock 方式和 TestBase 差异。相关知识以结构化条目进入用例设计、方案设计和实现阶段,并随知识库与仓库更新同步。它为环境适配提供上下文,不替代需求规则对测试预期的约束。
自愈规则与缺陷判定
用例执行失败后,先区分环境瞬时问题、数据残留、用例自身问题、预期错误和服务实现缺陷。归因应依靠请求、响应、环境状态和独立需求依据;证据不足时保留"待判定",不以让测试通过为目标反向修改判断标准。
自愈遵守三项约束:预期修订必须有独立依据,不能照抄实际响应;不得通过删除断言或降低精度掩盖失败;所有修订都保留记录。当前工作流将修订达到三次的用例标记为弱验证,作为人工复核的管理提示。修订次数本身不决定断言是否正确,验证结论仍取决于独立预期、执行结果和覆盖范围。涉及上游规则或设计变更时,须回到人工确认。
四、一次从风险识别到复测的协同案例
当前研发侧与测试侧主要通过人工确认完成产物衔接,统一协议、自动交接和结果回流仍在建设中。
以营销业务中一次涉及行业类型与静态券面额的变更为例,研发侧关注新增行业类型是否遗漏兜底处理,测试侧将这一风险转化为可执行的用例。以下依据该任务的案例记录,介绍风险发现、七条用例设计、TC-03 返回差异、开发补充分支和复测的处理过程。应用和仓库名称使用代称。
图 5 风险、验证与修复记录的逻辑关联。箭头表示处理顺序。
研发侧识别兜底风险并提出验证要求
这次变更新增了行业类型枚举。研发侧的 Generator 在审查代码时形成一条 Finding:新增类型未覆盖兜底路径。多角色评审进一步关注到,这段逻辑关联券面额,遗漏处理可能影响资金相关行为,因此 Judge 要求补充验证。
这条 Finding把后续测试的关注点收敛到一个具体问题:行业参数的变化,会不会让静态券面额偏离业务规则。研发侧负责说明代码中可疑的处理路径,测试侧则需要确定合法、非法输入分别应该得到什么结果,再通过实际执行检查两者是否一致。
测试侧把风险转化为七条用例
测试侧按四个核心阶段推进。阶段一结合需求提取行业参数与券面额的预期;阶段二将其展开为七条用例,其中TC-03 检查合法与非法行业输入的差异;阶段三把用例映射到数据准备、接口调用和执行条件;阶段四完成自动化实现并运行测试。这样,研发侧提出的兜底风险被落实到了具体输入和断言上。
当次测试设计以"合法行业参数返回配置面额、非法行业参数返回兜底值"为断言约定,TC-03围绕这一区别进行验证。这里呈现的是该次测试采用的预期;需求中对规则适用范围的表述存在差异,因此本案例用于说明返回差异及其处理过程,不据此认定全部业务约定已经得到验证。
TC-03 发现返回差异后进入修复与复测
首次执行TC-03时,非法行业参数返回了配置面额,与用例设定的兜底值预期不一致。这个失败把前面的代码风险落实为一组具体的输入、预期和实际结果,排查也随之聚焦到非法行业输入对应的处理路径。
案例记录记载,开发随后定位到缺少兜底分支并补充处理;之后 TC-03 复测通过,Finding被记为"已验证修复"。这一过程把研发识别的风险、用例执行暴露的差异、代码修改和复测结果关联起来。此处报告的验证结果限定于 TC-03的处理记录。
| 核对项 | 记录中的首次执行 | 记录中的后续处理 |
|---|---|---|
| 兜底处理 | 开发定位为缺少兜底分支。 | 开发补充相应处理。 |
TC-03 执行 | 非法行业输入返回配置面额,与用例预期不同。 | 案例记录为复测通过。 |
Finding状态 | 研发提出需要验证的兜底风险。 | 案例记录将其标为"已验证修复"。 |
本次记录描述了 TC-03 的首次执行与后续处理,未包含其他六条用例的执行结果,也未展示全部请求、响应及断言。它说明一条风险如何得到定位和复测,不用于判断整个业务链路的验证覆盖情况。完整的交付证据还应关联独立业务规则、修复前后版本以及对应的执行结果。
把风险与验证结果关联为交付依据
案例中需要对应起来的内容很具体:新增行业类型的变更、兜底路径 Finding、TC-03 的输入与预期、首次执行的返回差异、开发的分支修复,以及复测结果和 Finding 状态。将这些内容放在同一条记录中,读者才能从"发现了什么风险"追踪到"做了什么修改、用什么结果判断修改有效"。
为逐步统一这种关联,计划采用的证据模型包括少量核心字段:change_id 与 source_revision 标识变更及版本;claim /locator 说明风险或验证结论及其依据;verification_status 区分待验证、人工确认和执行验证状态。通过一致的标识关联需求依据、代码修改与运行结果,可以让交付判断被复查。
本案例展示的是风险、用例、代码处理与结果记录之间的对应关系。统一协议、跨侧自动交接和自动回流属于建设目标,图中的箭头表示处理顺序。
这个案例体现的协同方式,是让研发发现的风险进入具体测试场景,再让执行结果进入问题处置记录。每一项交付判断都需要说明其依据、版本和验证范围,才能在出现分歧时追溯到具体输入与结果。
五、阶段运行快照与适用边界
从看板记录观察问题处置与流程完成
研发侧与测试侧的看板分别记录问题处置和测试工作项的流程状态。以下数字来自各自看板的一次截屏,范围限定为画面中展示的记录集合。两套看板并非同一统计队列,本文分别说明其含义,不据此计算端到端交付效果或长期效率变化。
| 指标与对象 | 看板显示的记录 | 解释范围 |
|---|---|---|
| 业务仓库 A 的问题处置 | 94 条问题记录中,50 条被标记为可信修复;50 ÷ 94 = 53.2%。 | 范围是该次快照呈现的 94 条记录。看板另有上报修复与 Autofix 分类,不将其合并为自动修复成效。 |
| 测试工作项的流程状态 | 46 个工作项中,34 个被标记为全阶段完成;34 ÷ 46 ≈ 74%。其余 12 个未完成。 | 范围是该次快照呈现的 46 个工作项。未完成是流程状态,不等于发生缺陷或测试失败。 |
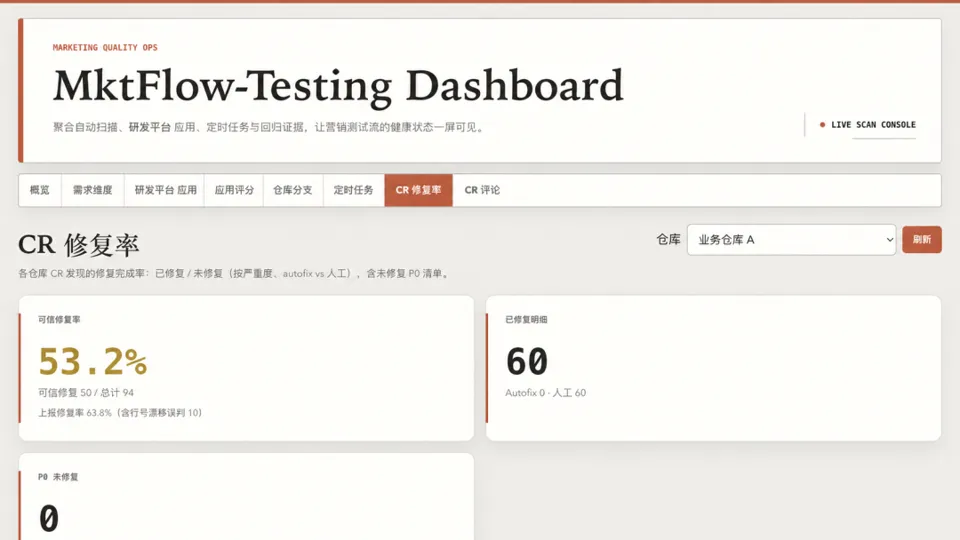
图 6 业务仓库 A 问题处置快照。
看板标记可信修复 50/94,即 53.2%;上报修复 60 项包含 10 项行号漂移误判。Autofix 为 0,两种修复记录口径不同。
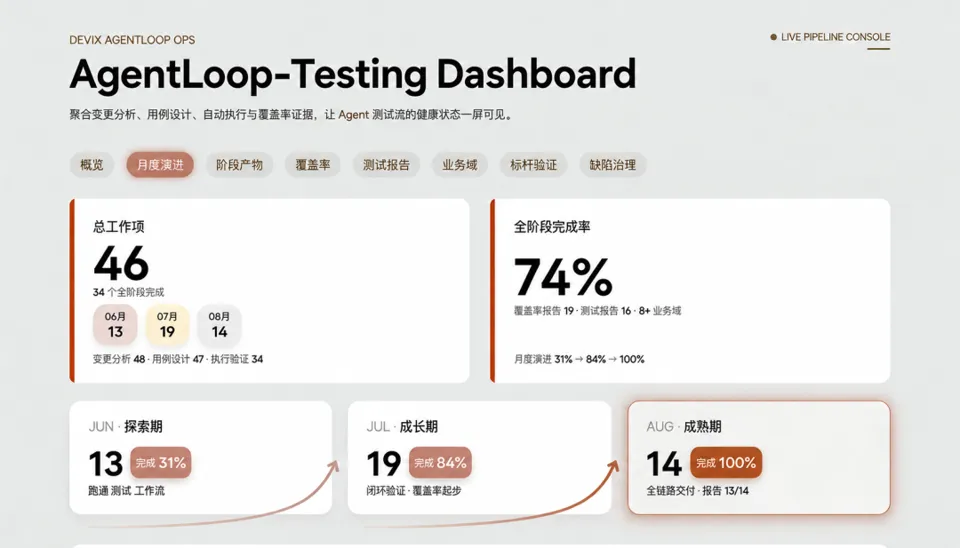
图 7 测试工作项看板。
图中 6、7、8 月标签下分别列出 13、19、14 个工作项,共 46 个;完成比例描述相应工作项的流程状态。图中的"全链路交付"指该测试工作流,不代表跨研发与测试的自动交付已贯通。
第一组数据说明单仓库看板中的问题处置状态,其中 Autofix 记录为 0;第二组数据说明所展示工作项的流程完成状态。流程完成与业务验证通过是不同判断,单次快照也不能说明整体质量或效率的变化。
适用边界与下一步
这套实践更适用于业务规则明确、环境可控且结果可观测的场景。需求规则不完整、并发时序复杂或结果具有概率性时,仍需要人工判断和其他验证手段。当前两侧能力已分别落地,统一协议、自动交接和交付门禁仍在建设。
结语
营销AI质量工程长期目标不是追求"无人参与"——让 AI 扩大认知和执行半径,让工程机制约束不确定性,让人保留关键决策权,最终由可追溯的运行证据决定是否可以交付。当建议能够被验证、阻断、修正和追踪,AI 才真正成为研发质量体系的一部分。
千问AI平台-为Agent而生,驱动AI生产力 扫描下方二维码,直达千问AI平台体验
点击阅读原文即可体验!