GEAR Open-Sources Modular RSI Framework for Self-Improving Agents
Researchers from Imperial College London, Duke and other institutions have released GEAR, an open-source modular toolkit for recursive self-improvement (RSI) of LLM agents, styled after Scikit-learn. It decomposes parent selection, mutation planning, task sampling, scoring and candidate ranking into swappable modules while sharing execution, evaluation and versioning infrastructure. Experiments built on the GEPA algorithm show notable gains on marketing, customer service and coding tasks with frozen model weights.
Related Entities
Full Report
Contents9 sections
让开发者能够组合、替换和比较不同的进化策略,复用已有的任务执行、评测和版本管理能力。
GEAR 可以让研究者像使用 Scikit-learn 一样模块化构建 RSI 算法。它将采样、候选评测和多样性管理所需的算法模块与并行推理等测评设施组织起来,使得 RSI 算法能够快速搭建、比较和复用。基于 GEPA(Genetic-Pareto)算法改进的实验结果证明,GEAR 调优的 Agent 在营销、客服和代码任务上均取得显著提升。
一、研究意义、亮点与主要结果:
打造 Scikit-learn 式的模块化 RSI 框架
来自 Imperial College London、Duke 等机构的研究者提出开源框架 GEAR,希望为递归自我改进(Recursive Self-Improvement,RSI)提供一套通用工具箱。它的定位可以概括为 toolkits for RSI:让开发者能够组合、替换和比较不同的进化策略,复用已有的任务执行、评测和版本管理能力。
- 论文:GEAR: An Open General Evolutionary Architecture for Recursive Self-Improvement of LLM Agent Harness,2026 年 10 月 26 日预印本。
- 论文作者:Yehui Tang、Guanqi Zhu、Shao-Jun Xia、Xin Chen、Mengzhe Geng、Hongyang Du、Yuhao Tang。
- 项目主页:rsi-gear.github.io
- 开源代码:github.com/rsi-gear/gear
- 论文:https://huggingface.co/spaces/WizardTY/GEAR
GEAR 将父版本选择、修改方案规划、任务采样、评分和候选排序拆成可替换模块。研究者可以围绕这些环节开发新算法,而每个候选的代码版本、运行条件和评测证据都由共用设施记录,方便检查结果并继续实验。
论文以 harness 的进化为验证对象。提示词、工具、技能、工作流和上下文管理可以被修改,目标模型权重保持不变。在固定 GPT 5.6 Luna 模型、使用 medium 推理档位时,经过 GEAR 进化的 DeepSeek Harness(DSH)将营销任务通过率从 27.0% 提高到 40.0%,客服任务从 17.0% 提高到 25.0%,代码任务从 52.8% 提高到 62.9%。且进化的 harness 对不同的推理档位和模型同样有效。
这些结果展示了系统性优化 Agent 工作方式的潜力。通过开放共用的实验工具,GEAR 希望让后续研究能够在已有基础上开发和检验新的进化方法,积累可复用的版本与实验结果。
二、研究背景:自进化绕不开的三个核心问题
围绕递归自我改进(Recursive Self-Improvement,RSI)的工作正不断涌现。从优化提示词、进化工作流,到让 Agent 修改自身的运行代码、训练新模型,不同研究给出了各自的进化方案。但这些方法无论采用什么形式,都绕不开几个共同的核心问题。
第一,如何更好、更高效地 Sampling?进化的搜索空间很大,计算预算却有限。从哪些已有版本出发,探索哪些改进方向,优先在哪些任务上收集反馈,都会影响一次搜索能走多远。采样策略需要帮助系统把有限的尝试机会分配到有价值的探索上。
第二,得到当前版本的 Variant(修改后产生的候选变体)后,如何更准确地测评?生成一个新版本只是开始,更关键的是判断它究竟有没有变好:分数上升是修改起了作用,还是任务难度、推理档位或运行波动带来的差异?又该用多少评测,才能支持保留或淘汰它的决定?评测既要控制成本,也要为进化提供可信的反馈。
第三,如何在进化过程中保持多样性?如果每一轮都只留下总分最高的版本,搜索可能过早集中到一条路线。某个暂时落后的变体,也许擅长一类任务,或者采用了不同的解决方式。如何保留这些有价值的差异,让它们有机会成为后续进化的起点,是持续探索的重要问题。
Sampling、Variant 评测和多样性管理,构成了理解与比较自进化方法的一组共同问题。不同研究可以在这些环节提出不同策略,也需要一套共用的设施来执行实验、保存候选,并检验策略是否有效。
Agent Harness 是这些问题的一个具体研究场景。实际任务需要调用工具、组织上下文、处理异常并核对结果,这些工作方式会影响模型能否完成任务,也为自进化提供了可修改的对象。
当研究者尝试新的采样策略、评测方案或多样性机制时,底层都需要并发任务执行、保存版本和管理证据。GEAR 的出发点,就是把这些共用环节组织起来,让不同方法可以在明确的实验条件下接受比较。
三、框架设计:基于 Meta-learning 的双层自进化框架
GEAR 将 Agent 的自进化建模为一个元学习(Meta-learning)问题:从一批任务的执行经验中,改进解决后续任务的方法。具体而言,它将系统分成两个层次:内层解决当前任务,外层优化可复用的 Harness。
内层是任务层面的执行与适应。任务 Agent 使用给定的模型和运行框架,与环境交互、调用工具,并根据反馈调整当前任务的计划。任务结束后,系统记录执行轨迹、最终结果和评测反馈。这一层中的临时调整只服务于当前任务,不会自动成为后续任务的运行规则。
外层是跨任务的元学习。Meta Agent 汇总多个任务的轨迹和评测证据,识别反复出现的问题,并提出对提示词、工具、技能、工作流或上下文管理的修改。候选版本经过评测和选择后,才成为后续任务使用的新 Harness。
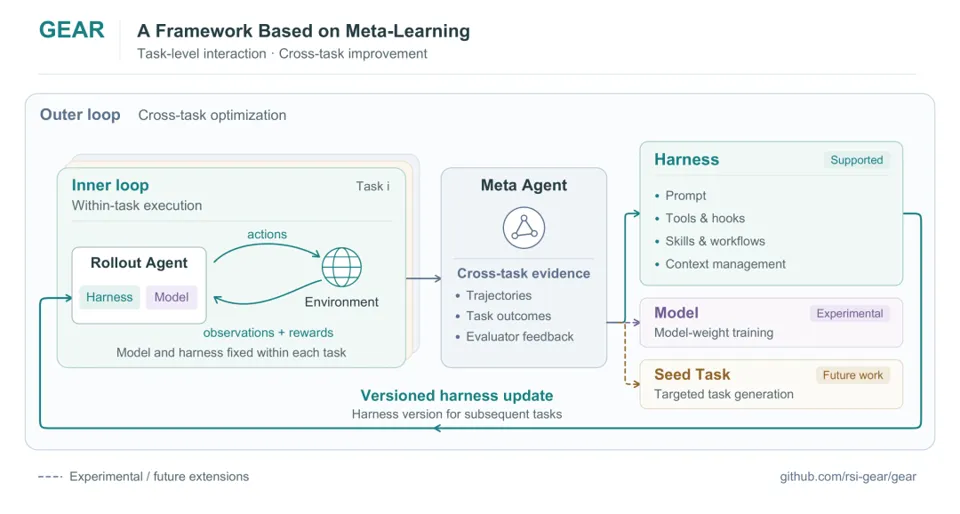
图 1|GEAR 基于元学习的双层框架。内层执行具体任务并产生证据,外层利用跨任务经验改进可复用的运行框架。实线表示当前支持的 harness 进化路径;模型训练与自动生成任务分别属于实验性和未来扩展。
两层由此形成循环:任务执行产生经验,跨任务经验推动框架改进,新框架再参与后续任务并产生新的经验。一次任务中的临时补救,只有被整理为经过验证的框架修改,才能进入这个持续积累的过程。
前述 Sampling、Variant 评测和多样性管理,都可以在外层配置不同策略:选择从哪些历史版本出发、如何评估候选,以及保留哪些版本供后续探索。论文用分阶段 GEPA 搜索实现了一个具体实例,而这些策略可以在共用框架中替换。
这里的元学习体现为任务执行与跨任务改进的双层结构。本文的 harness 进化保持目标模型权重固定,通过运行框架的搜索与选择实现改进,不要求内层求解过程可微。
四、详细结果、实验分析与未来应用
固定模型与推理档位后,三个领域均有提升
研究选用了 AutomationBench 的 100 道 Marketing 任务、100 道 Support 任务,以及 Terminal-Bench 2.1 的 89 道命令行任务。每个模型与运行框架配置在每道任务上进行一次评测。
最直接的对照来自 GPT 5.6 Luna、medium 推理档位。研究保持任务、模型、推理档位、评测器和运行设置一致,比较初始 DSH 与针对相应数据集进化后的 DSH。
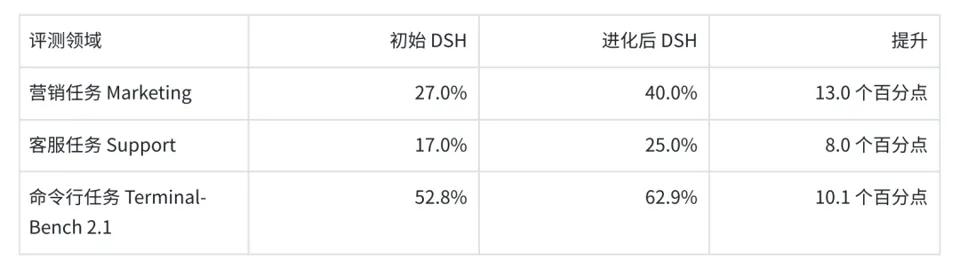
表 1|固定 GPT 5.6 Luna 和 medium 推理档位的任务通过率对照。数据来自论文表 1;三个领域分别进化各自的运行框架。
以 Marketing 为例,从 27% 到 40%,意味着这 100 道评测任务中多通过了 13 道。它说明,对工作方式进行系统优化,可以帮助同一个模型完成更多任务。
研究还考察了「目标完成度」。一个任务可能包含多项最终状态检查,这项指标先计算每道任务满足了多少比例的评分要求,再对所有任务取平均。在上述配置下,Marketing 的目标完成度从 75.4% 提高到 83.9%,Support 从 72.9% 提高到 81.3%。也就是说,完整任务通过率和部分目标完成情况都获得了改善。
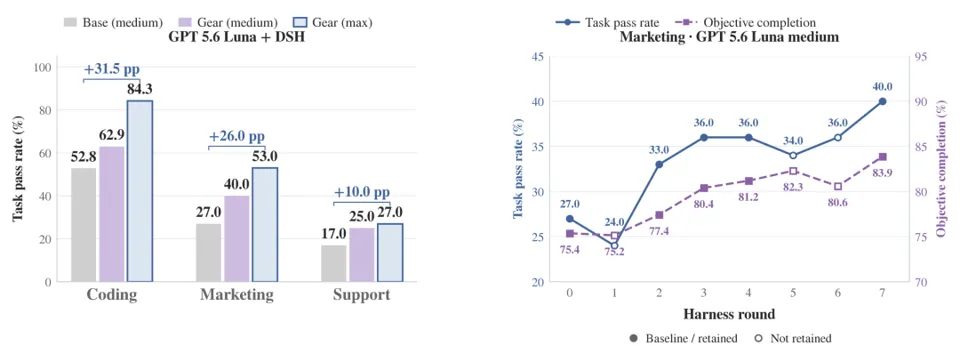
图 2|论文图 4 及项目主页使用的实验结果原图。左图展示三个领域在不同配置下的表现,右图展示固定 Luna medium 配置下的 Marketing 进化过程。左图蓝色括号比较的是初始 medium 与进化后 max,包含推理档位变化;上表的同档增益对应灰色与紫色柱之间的差值。
改进后的工作方式可以在另一模型上使用
GEAR 的实验还探索了一个实用问题:在一个模型上进化出的运行框架,换一个模型之后是否仍然有效?
研究将 Luna 上进化出的相应运行框架用于 GPT 6 Astra 的 max 推理档位。Marketing 和 Support 的任务通过率分别达到 61% 和 39%,论文中对应的 Codex 对照为 57% 和 35%。这为改进后的工作方式能够跨模型复用提供了初步证据。在 Terminal-Bench 2.1 上,进化后的运行框架配合 Luna max 和 Astra max,分别取得 84.3% 和 87.6% 的通过率。
有些候选指标更高,却没有被采用
Marketing 的进化过程解释了为什么自我改进需要明确的验收机制。
从图 2 右侧可以看到,初始版本的通过率为 27.0%、目标完成度为 75.4%;第 7 轮最终保留的版本达到 40.0% 和 83.9%。但这条搜索路径并非每一步都向上,第 1、5、6 轮候选均未被保留。
第 5 轮尤其有代表性:相较当时保留的第 4 轮版本,目标完成度从 81.2% 提高到 82.3%,完整任务通过率却从 36% 降到 34%。平均完成度更高,并不意味着完整完成的任务更多。因此,这个候选没有替换当前版本。
第 6 轮的通过率虽然仍为 36%,目标完成度却降至 80.6%,同样未被采用。系统用显式规则拦下这些退步,保留能够同时满足验收要求的版本。
这也说明了 GEAR 中记录和评测设施的作用:让研究者看见改进过程中的得失,检查一次修改究竟改变了什么,而不仅仅得到一个最终分数。
从研究工具箱走向业务流程优化
对于研究者,GEAR 可以成为比较自我改进方法的实验平台。在共用任务执行和证据记录设施的基础上,研究者可以尝试不同的搜索策略、任务采样方式和验收规则,进一步分析哪些方法在相同预算下更有效。
对于开发者,一个值得探索的方向是把业务测试接入这套循环。例如,为客服处理或开发运维流程建立可重复的任务集,利用失败轨迹改进技能与工作流,再通过回归评测决定是否采用新版本。人工专家也可以查看修改依据和运行记录,参与分析与标注。
对于真实业务场景,该框架基于 toolkits for RSI 的领先架构设计,可以在不同场景快速构建针对性的算法,已在客服、营销和代码任务上用较小的模型实现了顶尖大模型同等的水平。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:[email protected]