机器之心 (微信公众号) · 10/10/2026, 18:23:00
Yuan-Tian Reflects on AI Research Automation: Predicts Researcher Obsolescence Within Five Years After Co-Writing with GPT-5
Former Meta Chief Scientist Yuan-Tian Tian revealed in a podcast that after co-writing his final paper with GPT-5, he realized traditional researchers' jobs could be replaced by AI within five years. This insight stems from OpenAI's recent release of 722 mathematical manuscripts generated by an internal model, signaling that AI research output has reached the 'hundreds' scale. Tian advocates for proactive entrepreneurship to leverage these models for larger challenges rather than facing passive unemployment.
SOURCE COVERAGEFull Original Report
与其被动地丢掉工作,不如主动去开一家朝这个方向走的公司。
编辑|Panda
前些时日,OpenAI 在 GitHub 上一口气放出了 722 篇数学论文手稿。这些手稿被归为 372 个结果「家族」,横跨 17 个数学领域,全部出自一个尚未发布、也没有公开名字的内部模型——其性能远胜 GPT-6 Astra。
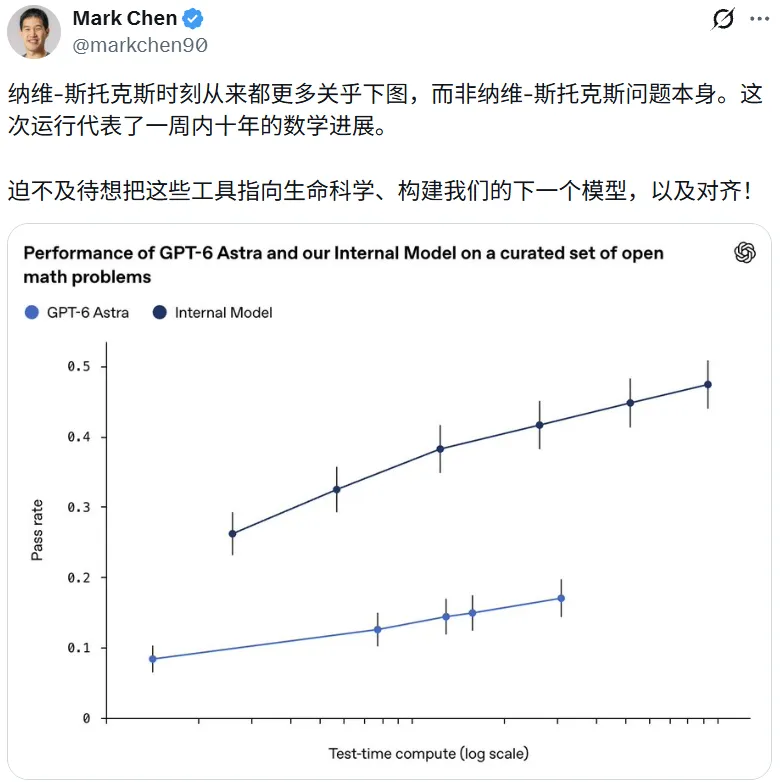
OpenAI 首席研究官 Mark Chen 的推文
当然,数学界对这批成果的质量和披露方式仍有不少争议,但有一点已经很难否认:AI 产出研究成果的速度,开始以「百篇」为单位计算了。
几乎在同一时间,最新一期 The Information Bottleneck 播客里,一位深度学习老兵说出了一句让不少研究者心头一紧的话:「做完这个项目,拿到一些挺有意思的结果之后,我突然意识到:哇,我的工作大概五年内就会被取代。」
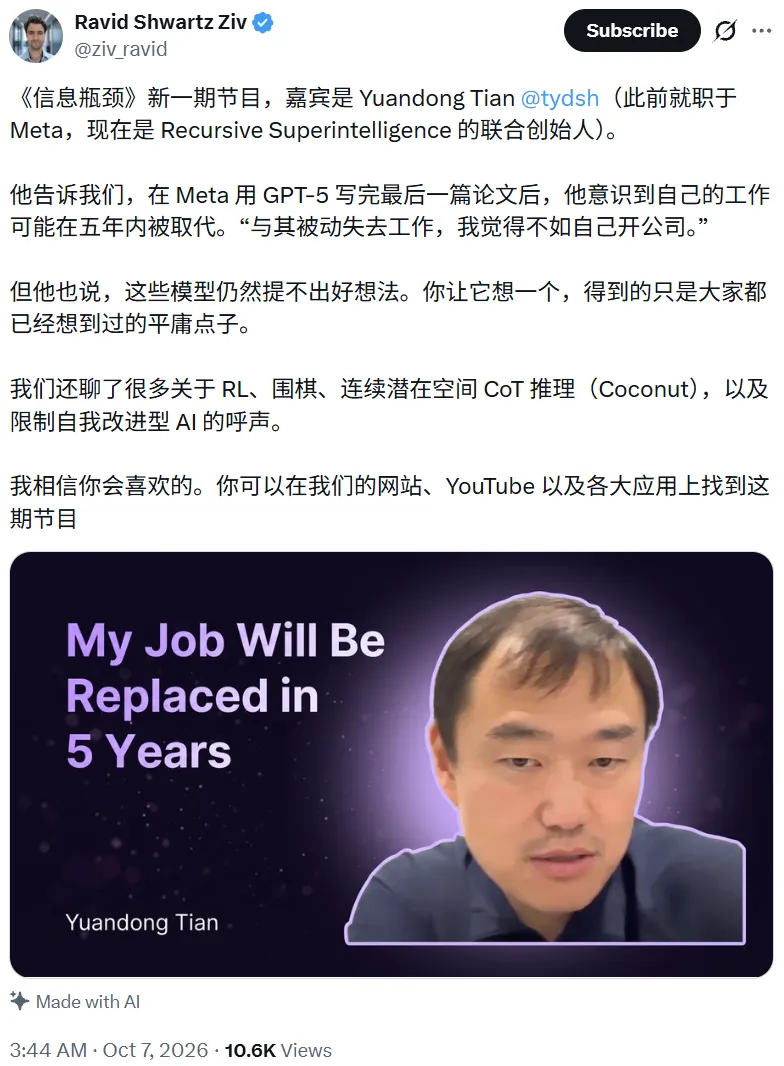
播客地址:https://www.the-information-bottleneck.com/p/yuandong-tian-on-recursive-self-improvement-600
说这话的是田渊栋。他在 Meta FAIR 待了近十年,做过围棋 AI、强化学习、神经网络可解释性,也是 Coconut(连续潜空间思维链)论文的作者之一。
如今,他的身份是 Recursive Superintelligence 的联合创始人。今年 5 月,这家公司结束隐身状态,宣布以 46.5 亿美元估值完成超过 6.5 亿美元融资,由 GV 和 Greycroft 领投,英伟达和 AMD 参投。
在 Ravid Shwartz-Ziv 主持这一期播客中,田渊栋解释了自己为什么出来创业:「与其被动地丢掉工作,不如主动去开一家朝这个方向走的公司。」不过,他也在节目里给 AI 泼了点冷水。「如果你让模型自己想点子,它会给你一些非常平庸的想法,基本上谁都知道,也不是什么有意思的方向。」
在将近一小时的对话里,田渊栋从 CMU 时代的 AlexNet 争论讲到围棋 AI,从「动作空间」讲到潜空间推理,最后落到递归自我改进、新架构和开源。以下是这场对话的整理。
Smith Hall 里的争吵:AlexNet 到底是不是个意外?
田渊栋 2008 年来到美国,在卡内基梅隆大学机器人研究所读博。那时,机器学习远没有今天的地位。「当时很多人其实不认为机器学习是一条靠谱的路,大家会说它不太行,因为会过拟合,也搞不清楚里面发生了什么。」
他的博士课题是计算机视觉里的非凸优化问题,比如还原水面折射造成的图像畸变。他用一种分层的方法去优化,并证明了即便问题非凸,只要数据足够多,仍然可以在一定程度上证明最优性。「数据驱动加上优化,这个组合挺有意思的,我到现在都还挺为这份工作骄傲。」
2012 年 AlexNet 横空出世。田渊栋给 Alex Krizhevsky 发了封邮件,要来代码自己摆弄了一番。他很快意识到,卷积网络的层级化处理,和自己论文里的分层优化思路其实是一回事,「可能是我一直在追求的东西,只是换了一种形式」。
但当时 CMU 的气氛并不友好。「大家每天来办公室,在 Smith Hall 里激烈争论 AlexNet 的结果到底是侥幸还是真正的突破。大多数人都说只是侥幸,因为这不合常理。」
2013 年毕业时,田渊栋拿到了几家想做深度学习的机构的 offer,最终却选择了 Google 自动驾驶团队,一方面是名气,一方面是朋友内推。可在那里的一年零三个月里,他并没能做成深度学习,因为团队更像创业公司,需要用成熟方案解决实际问题,而不是做科学探索。于是他跳槽去了 FAIR,并称这是「当时做过的最好的选择之一」。
两个人、一块 GPU:田渊栋的围棋往事
在 FAIR,田渊栋启动的第一个项目是围棋 AI。2015 年,他的团队做出了 DarkForest,靠卷积网络在网上击败了顶尖业余棋手。几个月后,AlphaGo 在 2016 年春天击败了职业棋手。
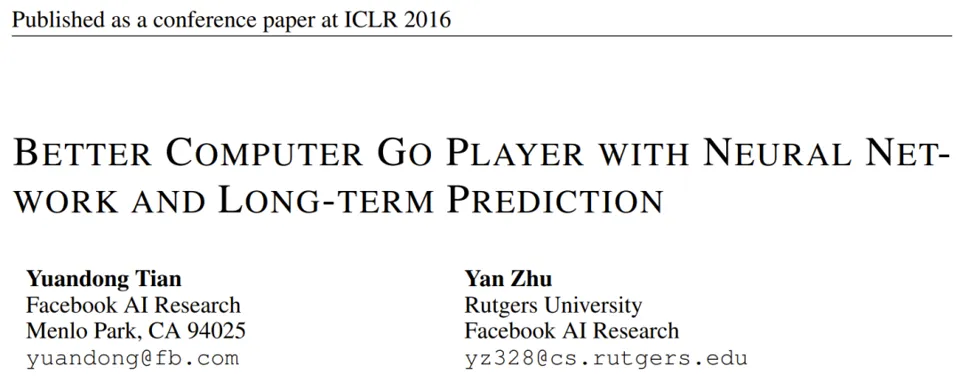
面对这样的「撞车」,田渊栋的复盘认为 AlphaGo 有两点自己没有的:
- 价值网络,DarkForest 当时只有策略网络;
- 他本人此前几乎没有强化学习背景,「基本是边做边学,就像对自己做强化学习」。这段经历让他之后转向了大量强化学习研究。
被问到 AlphaGo 是否令人意外,他的回答很有意思:方法本身并不惊人,因为卷积网络能捕捉到人类下棋时依赖的棋盘模式,「真正让人惊讶的是,它居然能打败职业棋手」。
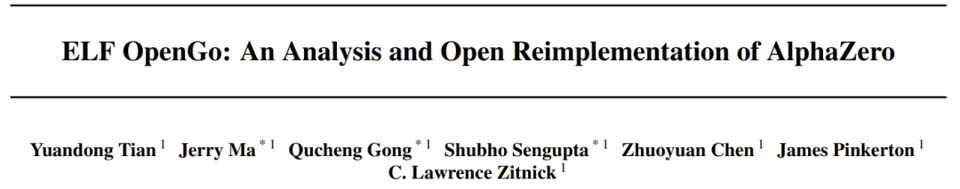
2018 年,团队复现了 AlphaZero,即完全不依赖人类棋谱、从零自我对弈的方案,并做了一些效率改进,得到了 OpenGo。这个 AI 在与韩国棋院的正式对局中,只用一块 V100 GPU,就让四位职业棋手一盘未胜。「我想那大概是第一次有人用单块 GPU 战胜职业棋手。」
比赛前还有个小插曲。团队请职业和半职业棋手朋友评估 OpenGo 的棋力,结果对方表示,开局还看得懂,之后就完全看不明白了,只能说「看起来很强,但我也不知道是不是真的强」。于是田渊栋决定:那就直接找真正的职业棋手下一场。
动作空间比算法更重要
谈到那个时代的强化学习,田渊栋认为有不少方法至今仍被低估。比如分布式强化学习,用奖励的分布而非单个标量来调整模型;又比如 Q-learning 等不同的建模方式。「但现在我们大多数时候用的都是策略梯度,这是很不一样的时代。」
他同样看好无梯度优化方法,而且认为大模型给了它们新的可能性:「大模型现在对系统、对要优化的目标函数有更好的高层理解,这种高层理解比局部梯度信息要有用得多。」在梯度起伏剧烈、局部最优随处可见的情况下,梯度可能会把人带进死胡同,而无梯度方法天然包含探索,「这是梯度方法从来不会做的事」。
2018、2019 年前后,田渊栋开始尝试把强化学习用在真实世界的问题上,结论颇为出人意料:「真正重要的不是算法,而是动作空间和状态空间的设计。」
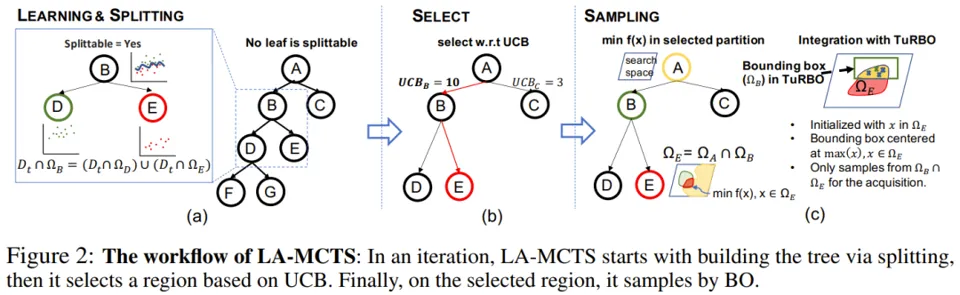
他以神经架构搜索为例。人类知道网络深度很关键,但 AI 不知道。如果 AI 一开始去搜索第一层卷积核大小这样的细节,所有分支的表现都差不多,价值函数给不出有用信号,只能逐层深入,搜索空间就会指数爆炸,「这时你用什么算法都没用」。反过来,如果能把动作空间重新组织,让 AI 先「意识到」深度很重要,深网络和浅网络之间就会出现鲜明对比,几次 rollout 就能看出方向。团队据此提出了潜空间蒙特卡洛树搜索(LA-MCTS),核心思想就是自动找到能让搜索子空间区分度最高的动作空间。
Coconut:「我思考的时候从来不用语言」
联合主持人提到了田渊栋参与的 Coconut 论文,即让模型在连续潜空间而非 token 空间中推理。田渊栋说,这个想法源于他对自己的观察:「我思考的时候从来不用语言。我能清楚地感觉到,思考时用的是大脑的另一个部分,然后必须把想法翻译成语言,才能和别人顺畅交流。」
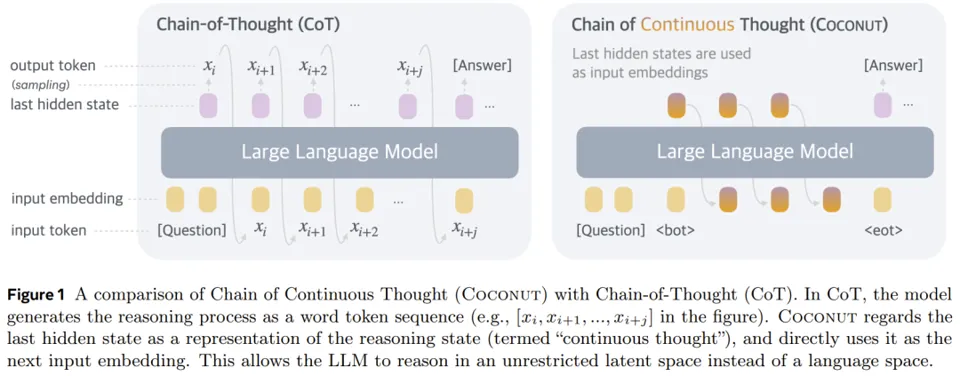
从这个直觉出发,团队做了理论推导,发现潜在表示可以是多种想法的叠加态,用它来推理,在图遍历之类的问题上可能获得显著优势,「也许不是指数级的,但至少有一定优势」。
那为什么前沿模型至今没有采用连续思维链?田渊栋给了两个原因。
- 数据:人类大量的思考过程以语言形式被记录下来,潜空间则没有这样的数据。
- 潜在表示可能是高度个人化的,「每个人多少都在用自己的潜在表示」,而大模型的学习效率远低于人类,只能先用语言作为替代。
Ravid Shwartz-Ziv 追问,这是否和 JEPA 等自监督方法面临的正则化难题类似。田渊栋表示认同,并把问题推得更深:梯度下降可能本身就陷入了一种「元层面的局部最优」,有些很好的表示,现在的训练范式也许根本学不到,「我们现在并不知道边界在哪」。
在他看来,这正是可解释性研究的意义所在,「就像炼金术和化学的区别」。只不过当下模型太强,所有人都在追结果,愿意投身这个方向的人和时间都还不够。
和 GPT-5 合写最后一篇论文之后
说到大模型时代的转型,田渊栋认为,自己从 2018 年起持续在做的神经网络训练动力学分析,换到大模型上方法依然相通,并没有带来断裂。真正的冲击在实证层面:研究者过去自己提假设、做实验、得结论,这一流程和一两百年前没什么本质区别;而当模型越来越强,自己就能产出想法,「研究者可能被迫在元层面思考,而不是把时间花在提出一个个具体假设上」。
同时,工程能力的地位大幅抬升。大模型时代的许多好工作「一半是研究,一半是工程」。直到 AI 编程智能体出现,局面又发生了变化:有扎实经验的研究者可以让智能体快速实现想法、定位关键问题,「突然之间就拥有了超能力,可以去探索真正深层的东西」。
转折点是他在 Meta 的最后一篇论文——他也是唯一作者。这篇论文研究的是神经网络的 grokking 现象,即网络先死记硬背、训练到某一时刻突然学会泛化。
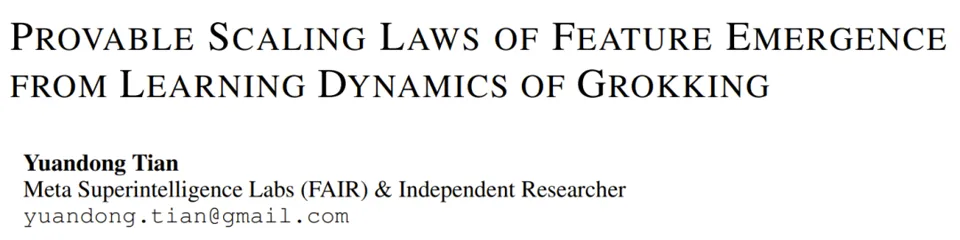
整个过程中,他把 GPT-5 当作合作者:问它问题,给它「布置作业」,让它证明定理、检查定理是否成立、一起头脑风暴。
结果是效率提升了大约 6 到 10 倍,「而且这还是保守估计,因为当时我还在自己写代码」。如今代码和实现也可以交给强大的智能体,速度只会更快。
于是有了开头那句话。田渊栋坦言,研究者通常不愿去小公司当联合创始人,因为要操心大量研究之外的事情,「但我觉得现在是一次相变,如果我什么都不做,以后可能就无关紧要了」。
联合主持人半开玩笑地回应,自己的应对方式是去学动手干活,可惜「我并不擅长动手」。
AI 还想不出好点子
不过,田渊栋并不认为人类已经可以退场。「我不觉得现在的模型能在没有任何人类干预的情况下给出很好的结果。」即便是那篇和 GPT-5 合写的论文,高层思路也是他给的,而不是让模型自己想。
人类目前仍然要负责:
- 发起,决定什么问题值得做
- 验证,判断 AI 给出的方案靠不靠谱
Ravid Shwartz-Ziv 提到,近期不少让智能体自主做后训练、刷 Kaggle 的工作,都暴露出想法空间狭窄、容易对指标过拟合的问题。田渊栋认为,这在一定程度上是暂时的:模型被要求处理细节却缺乏上下文,给它更多背景,它就可能提出比调超参数更有意思的想法。
但他也承认,补上下文只是「临时修补」。现在的模型擅长重复性工作,因为互联网数据里充满了这类内容;如果要模型真正跳出框框,就需要新的架构,让它能用极少的数据快速捕捉新信号。「从常规的重复性工作走到下一个层级,我们需要一次大的跃迁。」
在「提出想法、写代码、跑实验、分析结果」这个研究闭环里,他认为最难自动化的是想法。当被问到 Recursive 在 NanoGPT Speedrun 上的成绩,即把训练时间从 79.7 秒压到 77.5 秒,究竟是真正的发现,还是对已知技巧的高效搜索时,田渊栋的回答是「两者兼有」。比如在注意力里加入 bigram 信息的做法,可以在 DeepSeek、Gemma 3 乃至他在 Meta 时参与的 STEM 论文中找到相近思路,但如何在不同层使用不同的嵌入表、把这些想法组合起来,又包含了新的创造性。
新架构为何总在规模化时「失灵」?
不少公司提出过 Transformer 的替代架构,在小规模实验上表现亮眼,却始终没能扩展到大模型。田渊栋的解释是归纳偏置:小规模时数据不足,必须引入额外的结构假设,效果自然好;数据一多,最好的做法反而是让模型自己去找规律。他举了 ViT 的例子:ImageNet 量级的数据上,ViT 不如卷积网络,但数据量到了数亿级别,Transformer 就反超了。
那么,新架构该怎么验证?
田渊栋认为当然要从小规模开始,但关键在于理解网络内部到底发生了什么,「我们需要知道其中有某种洞见是能扩展到更大规模的,这样才有信心」。否则,如果只是盲目遵循 scaling law,就永远无法证明小规模上有效的东西在大规模上也有效,「那唯一的结果就是,算力最多的公司赢」。
他心目中更长远的目标,是找到与人类相当的学习效率。人脑只用二三十瓦功耗和极少的数据,就能在很短时间内理解事物。机器人领域今天强调需要海量数据,在他看来只是当前范式的要求,「看看猫、狗这些具身的生物,它们并不需要那么多数据,处理器也很粗糙,却能在复杂世界里生存,那里面一定有新的算法」。而强化学习和自我改进,可能是通往那里最快的路。
限制自我改进?「边界太模糊了」
节目最后,主持人问到了当下 AI 安全领域的一个热点:有人呼吁限制最新模型,并就递归自我改进进行行业协调。
田渊栋的回答很直接:「说实话,我觉得很难阻止人们这么做。」在他看来,边界本身就模糊不清:你和编程智能体讨论新想法、让它迭代,某种程度上就是自我改进;你和别人合作写论文,也是自我改进。再加上越来越强的开源模型,用它们做研究算不算自我改进?又该如何监管?
他明确表示,Recursive 会开源研究成果。此前公司的博客文章就开源了全部内核和训练方案,让外界可以检验、在此基础上继续开发。他更担心另一种局面:「最糟糕的情况是,一小撮精英掌控着世界上最强的模型,然后让其他所有人支付高昂溢价来使用。」
对于开源模型能否追上闭源,他相当乐观。他以 Kimi 为例,认为它已经很好用,只是思考过程可能略长。在他看来,编程智能体并不需要「AI 牛顿」、「AI 爱因斯坦」上门帮你写代码,只要模型越过某条可用的线就够了。
前沿实验室早已越线,开源模型也正在越线,「一旦越过,它就会被商品化,每个人都会用自己喜欢的模型」。
从 Smith Hall 里那场关于 AlexNet 是否「侥幸」的争论算起,已经过去了十四年。当年被质疑的深度学习,如今已经开始自己写论文、改代码、刷记录。田渊栋选择站到这股浪潮的最前面,用他的话说,接下来真正的问题是:「我们如何利用所有这些模型,去做更好、更大的事情。」
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:[email protected]