Iluvatar CoreX Launches TG300 GPU, Outperforms Nvidia H200 in Live Benchmarks
Chinese GPU maker Iluvatar CoreX unveiled the TG300 cloud chip based on its 'Tianshu' architecture and the TY1200 edge module. In live random benchmarks, the TG300 outperformed Nvidia's H200 in text-to-image inference (95.6s vs 112s), while third-party tests showed 1.05x end-to-end throughput for LLMs compared to H200. This release marks a shift from roadmap promises to tangible delivery, accompanied by a new software stack to build a cloud-edge computing ecosystem.
Full Report
Contents5 sections
跟H200和Thor T5000硬碰硬
金磊 发自 上海
量子位 | 公众号 QbitAI
我愿称之为,国产芯片界的真勇士。
事情是这样的。
一家国产芯片公司,竟敢把自家的GPU和英伟达H200,直接在现场真枪实弹地来了一把PK。
而且题目还不是自己出的,是随机挑了几个人、当场出题的那种!
例如文生图,有人出的题目是“一只老虎把月亮踢飞”:
结果,这块国产GPU跑赢了!
它用时仅为95.6秒,而英伟达H200耗时为112秒。
这还没完。
刚才的PK是在云端跑的,而后这家国产芯片公司,又拿出了一台巴掌大的银色小盒子,在端侧断网去跟英伟达的机器人大脑Jetson Thor T5000硬碰硬。
依旧是现场随机挑人、随机出题,这次的题目是“狮子和老虎单挑,谁会赢?”
肉眼可见,这个国产银色小盒子的速度,明显要比Thor T5000快得多。
那么这家国产芯片公司到底是谁?
不卖关子,它就是天数智芯。
刚才云端跑赢H200的,是天垓300;端侧跑赢Thor的,则是彤央TY1200。
除此之外,天数智芯还在同一场活动,一道发布了用AI来开发AI的天数智算软件栈。
熟悉天数智芯的朋友们可能还会记得,今年1月份,在它刚上市敲钟半个月之际,就一口气发布了四款彤央边端产品,当时TY1000实测超过的是英伟达AGX Orin。
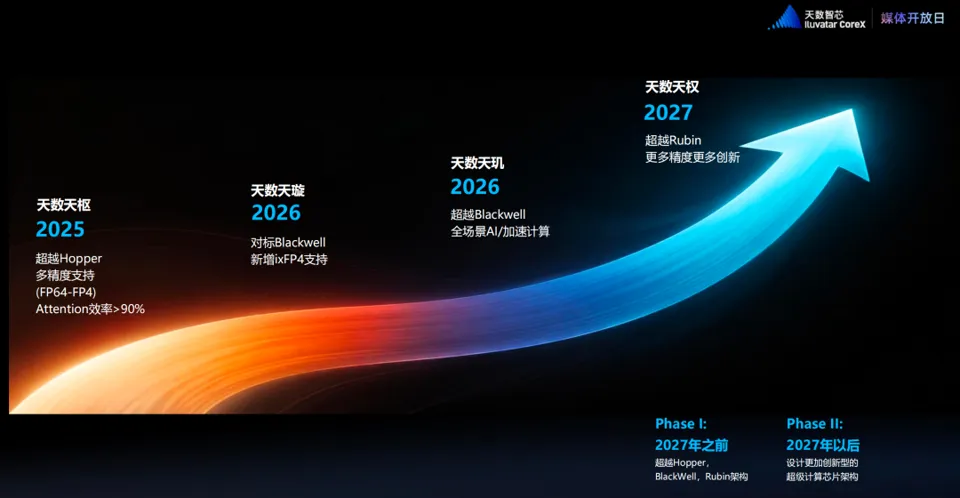
同一天,它还亮出一张四代架构路线图,第一站就是天枢架构,目标直指超越Hopper,后面还排着Blackwell和Rubin。
但毕竟当时只是路线图嘛(谁都会画)……
而9个多月后,天数智芯还真来交作业了。
天垓300正是基于天枢架构,这次对标的是Hopper家族的旗舰H200;端侧的对手,也从Orin换成了更强的Thor。
至于为什么云、软件、端三条线一起发,天数智芯的逻辑是这样的:
云端负责生产智能,软件栈负责让适配和优化跑得更快,端侧负责把智能送进工厂、实验室、医院这些真实现场。
在天数智芯看来,三者咬合在一起,才是它口中的高质量算力,即高效率、可预期、可持续。
那么接下来,我们详细地来品鉴一下这场实测~
天垓300:对标H200,交出实测答卷
先来看下云端的天垓300。
其实它并非第一次亮相,早在今年7月之际,第三方权威机构拿四大主流模型、三类场景,给天垓300做了一轮测试。
在大模型最典型的PD分离部署下,天垓300折算单卡端到端吞吐,是H200的1.05倍。
但这里比的不是纸面峰值,是一条推理链路从头跑到尾、实打实吐出来的Token。
按天数智芯的说法,天垓300由此成为国内首个实测性能达到H200水平的通用GPU。
不仅如此,毕竟天垓300定位是通用GPU,所以它得是训练和推理两头都能打的那种。
我们先来看推理这一块。
对于现在的大模型来说,长上下文是一道绕不开的坎。天数智芯AI与加速计算负责人单天逸在现场打了个比方:
情侣恋爱十周年,女生问男生,这十年里最刻骨铭心的时刻是什么?男生不会把3650天挨个回忆一遍,脑子里蹦出来的,也就那么几个瞬间。
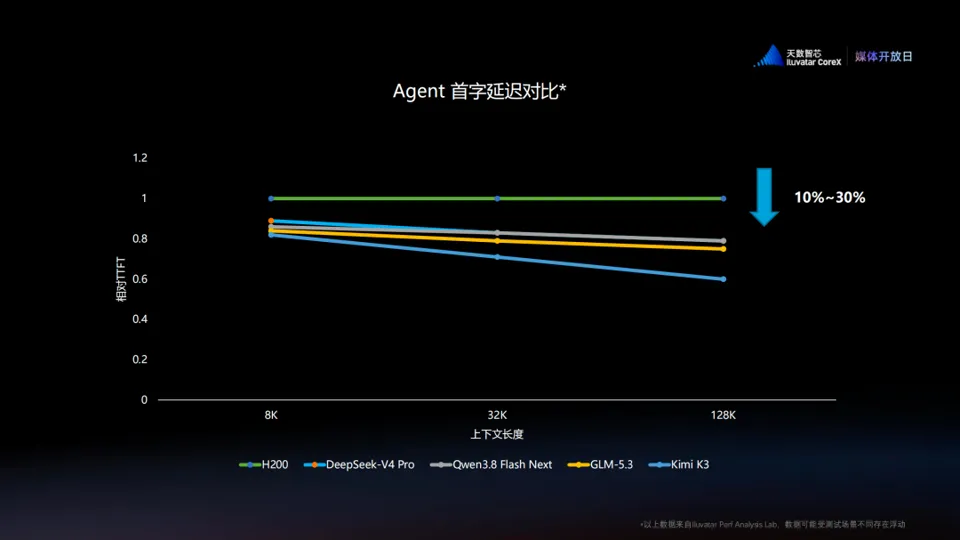
而Attention干的就是这件事,天垓300也专门为此做了定制优化。结果显示,GLM-5.3在64K规模下,MoE吞吐是H200的1.15倍;8K到128K长上下文里,Agent首字延迟比H200低10%到30%。
接下来,我们再来看训练这一块。
在Qwen3-32B的8卡FP8训练中,天垓300每卡有效吞吐是H100的1.33倍。在现场,单天逸放了一段加速100倍的训练命令行录屏,天垓300那边早早跑完,H100还在一步一步往前挪。
在常规训练之外,天垓300还是扛得住强化学习的那种,而这恰恰是当下主力大模型都在用的后训练路线。
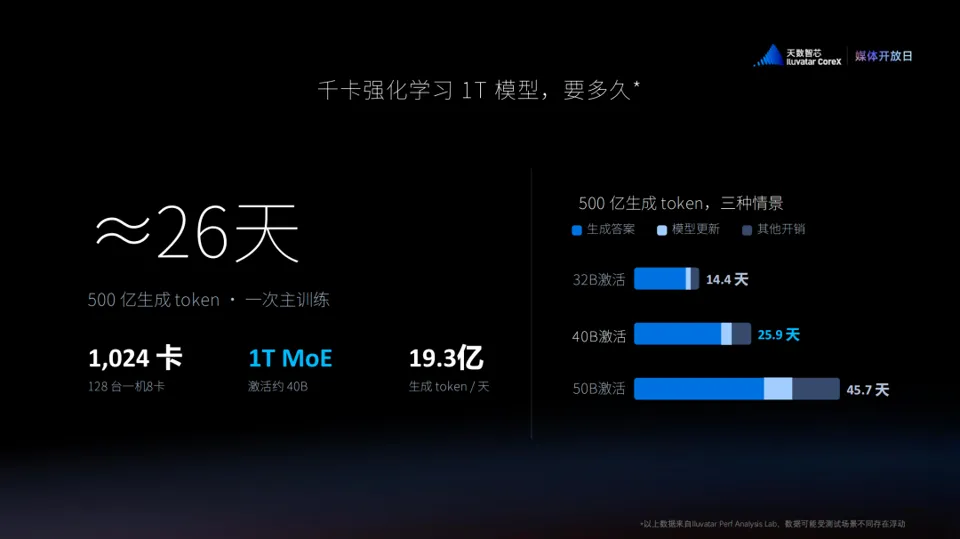
按天数智芯的工程测算,1024张卡,约26天就能对一个1T参数、40B激活的MoE模型完成一轮强化学习——差不多正好卡在大模型厂商一个多月一迭代的节奏上。
推理、训练之外,我们再来看看眼下爆火的Token工厂。
建一座Token工厂,大约75%到80%的投入都花在设备上。既然设备这笔钱省不下来,那么每一张卡就必须跑得多、跑得稳,Token的单位成本才降得下来。
在“跑得多”这一点上,前面提到的1.05倍已经给出了答案。至于“跑得稳”,则要看步时波动:
满负荷运行时,天垓300的步时波动是0.43%,而作为对比的Hopper方案是0.76%。这意味着即便长时间高负载运行,天垓300也不容易掉链子。
如果再把规模往上推,天数智芯给出的方案是IXL144超节点。
它在一个标准机柜里塞进了144颗GPU,聚合显存约10.1TB,是目前业界密度最高的单机柜GPU超节点。据天数智芯测算,与H200方案相比,它的每百万有效Token成本可以降低约40%。
除了单卡性能,天垓300还有一个细节挺有意思,那就是它并不打算用一种芯片包打天下。
天垓300既能和英伟达的H100、H200混合训练,也能和其他厂商的芯片搭伙干活。
这次天数智芯跑通的,是国内首个GPU+XPU异构AFD分离方案:由天垓300负责Prefill和Attention,由合作厂商的XPU负责FFN,实测Decoding推理延迟降低了60%。
在这些和大模型直接相关的测试之外,现场还播放了一组更硬核的物理仿真演示。在单天逸看来,AI远不止Transformer,芯片也不该反过来限制算法的发展。为了证明这一点,他现场放了三段仿真视频。
首先是用一张天垓300模拟一台龙门吊。整个过程中,每个滑块的摩擦力、起吊的速度和力量,都需要芯片实时算出来。
其次是把256个二连杆装进了同一个模型里做强化学习,相当于让256个并行世界同时试错,这对GPU的并行计算能力要求非常高。
最后是一场撞击实验。140个滑块相互碰撞,每一块都会影响其他所有滑块,所以每撞一次,芯片都要同时算出140个滑块的受力情况。
这些演示虽然看起来像物理课上的动画,但它们其实是机器人进入真实世界之前,必须在仿真环境里反复练习的基本功。
彤央TY1200:300T稠密算力,反超Thor T5000
说完云端,我们再来看端侧。
正如我们刚才提到的,这次彤央TY1200的对手,是英伟达的Jetson Thor T5000。
用天数智芯彤央产品市场负责人宋远盈的话说,Thor T5000是英伟达目前端侧非常能打的产品,它的官方标称算力是2070 TFLOPS(FP4,稀疏)。相比之下,TY1200的标称算力是300 TOPS,而且是稠密算力。
如果只看这两个数字,TY1200显然是吃亏的。宋远盈自己也在台上承认,粗略换算下来,TY1200的标称算力是不如Thor的。
不过,实测结果却是另一回事。在大模型上,TY1200跑Qwen3.8-27B的性能是Thor T5000的138%,跑MoE架构的Qwen3.6-35B-A3B也达到了110%。
更有意思的是英伟达自家开源的世界模型Cosmos。在Cosmos-R2-2B上,TY1200跑出了Thor的158%;换到R2-8B,这个数字更是达到了180%。
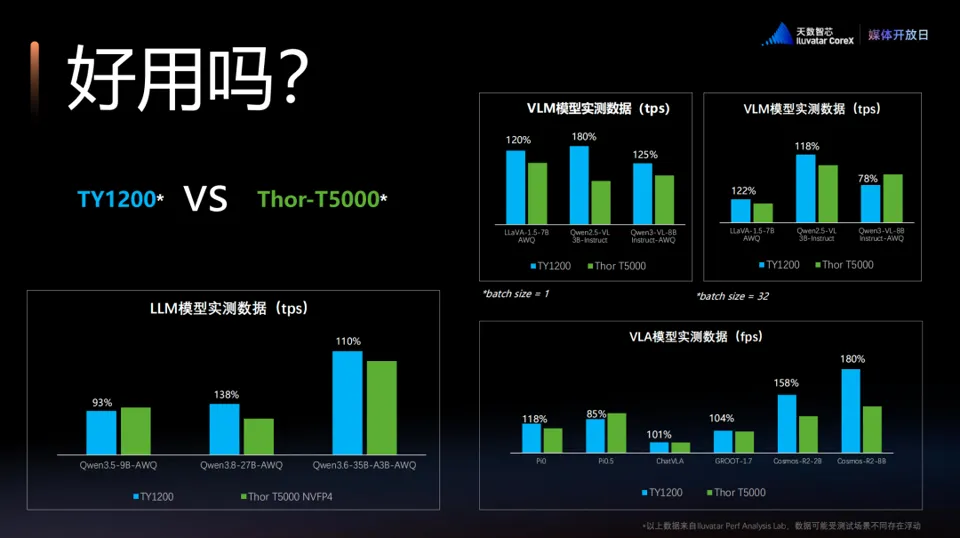
换句话说,TY1200是在英伟达的主场赢了英伟达。
在跑分之外,宋远盈还准备了三组真实任务,也全部都是在现场的TY1200上运行的。
第一组任务是在本地生成视频,同样是现场随机给出题目并交给MiniMax H3开源视频模型,在TY1200上运行,全程不联网、不上云。
大约6分钟出头,一段1056×608分辨率、5秒长的视频就生成了。
虽然6分钟比云端要慢,但做过AI视频的人都知道,在云端每改一版就得重新排一次队,账单也很难预测。而在TY1200上,这6分钟不用付一分钱的云端调用费。
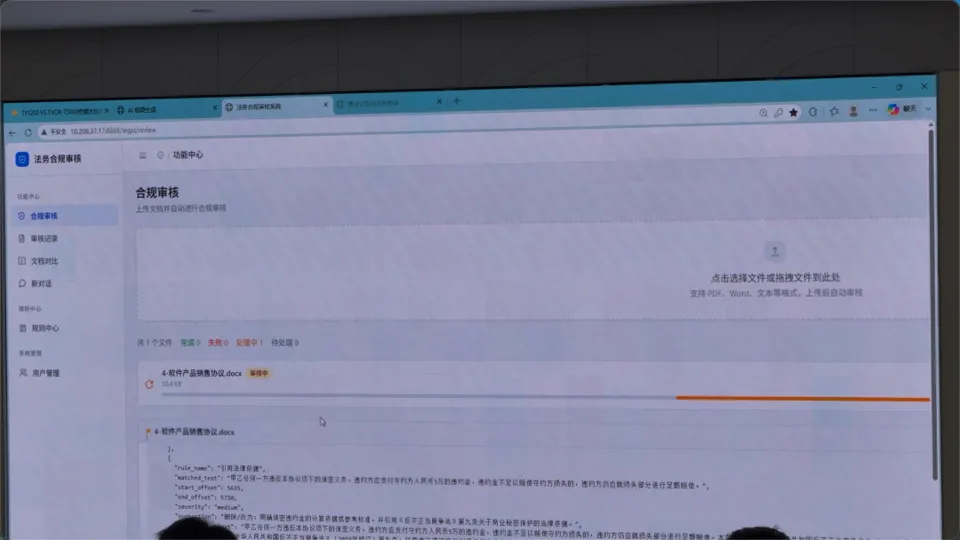
第二组任务是审合同。
宋远盈把一份1万字的软件合同丢进去,TY1200一两分钟就把高中低风险逐条标了出来,还附上了法律法规和企业内部规则的依据。
而最有意思的,还要数第三组任务——MicroDuck小鸭子。
按宋远盈的说法,英伟达展示过的版本,是先借助云端超级计算机训练出来的。而天数智芯这次想挑战的,是把仿真训练、仿真验证和实物部署全部放进一台TY1200里完成。
为此,TY1200首次在国产端侧产品上跑通了基于MuJoCo-Warp的GPU加速物理仿真。
不过宋远盈还特意打了预防针,说“从拿到鸭子到部署完模型,前后只用了三四天;团队之前自己试的时候,一次都没成功过。”
结果,这只鸭子站起来了。它摇摇晃晃地走了几步,摔了一跤,然后又自己站了起来。用现场同事的话说,这是它表现最好的一次。
嗯,挺给面儿的。
除了MicroDuck之外,其实彤央在具身智能上已经有了不少的落地。
两周前的工博会上,搭载TY1000模组的机器狗已经露过一手:它不需要人遥控,就能在本地完成人脸识别,自己跟着主人走,全程没有一帧画面上传到云端。
搭载TY1200的陪诊机器人,则已经在上海市阳光康复中心上岗。视障人士只要说一句“我膝盖疼,不知道去哪看”,机器人就会领着他一路走到挂号处,路上还会提醒避让障碍。
最后,宋远盈还预告了下一代端侧产品TY2000,它的标称算力将达到600T。正如她所说:
云端GPU厂商做端侧,不是把芯片做小,而是把能力下沉。
让一位工程师的经验,服务千千万万开发者
硬件上虽然跑赢了,但到了开发者这边,好不好用就是另一回事了。
正如天数智芯副总裁、软件开发负责人石加圣在现场讲的一个很有年代感的例子:
早年想在DOS上玩《仙剑奇侠传》《大富翁3》,玩家得先折腾一堆配置,游戏才跑得起来。
在他看来,今天的云端服务器多少有点像当年的DOS,不同的CPU、不同的拓扑、不同的操作系统,坑一个接一个。
为此,天数智芯给出的解法,是把AI请进软件栈。
这次的天数智算软件栈全面拥抱Agentic AI,把过去服务几百家客户时踩过的坑,沉淀成了一套套Skills。开发者只需要说清目标、定好约束,剩下的工作交给Agent,关键节点再由人来拍板。
如此一来,比如装环境、拉起PD分离部署这件事,按经验估计人工要花1小时以上;交给Agent之后,10分钟以内就能搞定,人工操作也从数十步减少到了1步。
性能调优同样可以交给AI。
Agent会调用天数智芯自家的性能分析工具,定位瓶颈、提出方案、跑验证,一轮不行就再来一轮。在某大模型调优任务中,按经验估计原本要一周左右,现在不到2小时就走完了分析、优化、验证的全流程,运行性能接近翻倍。
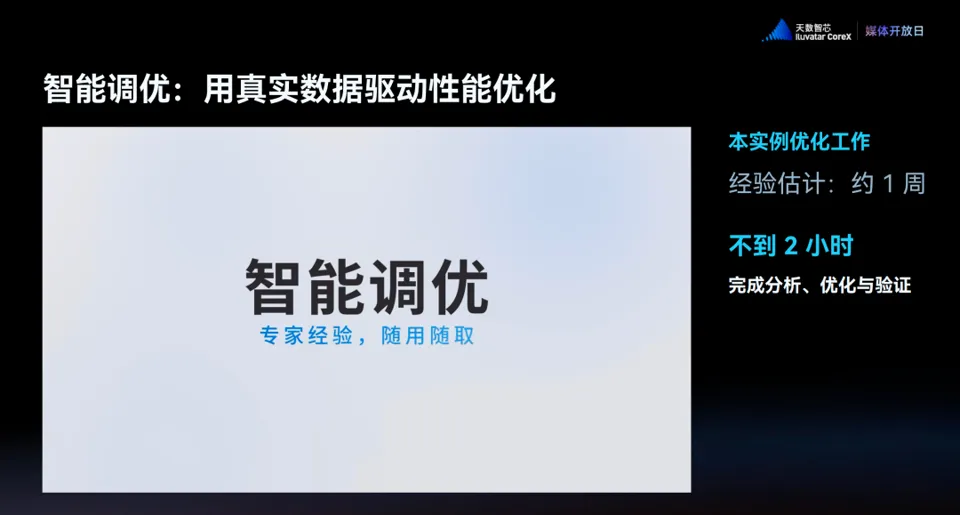
以前开发者找原厂专家调优,最常听到的答复是什么?石加圣自己给出了答案:排队。毕竟专家的时间就那么多。
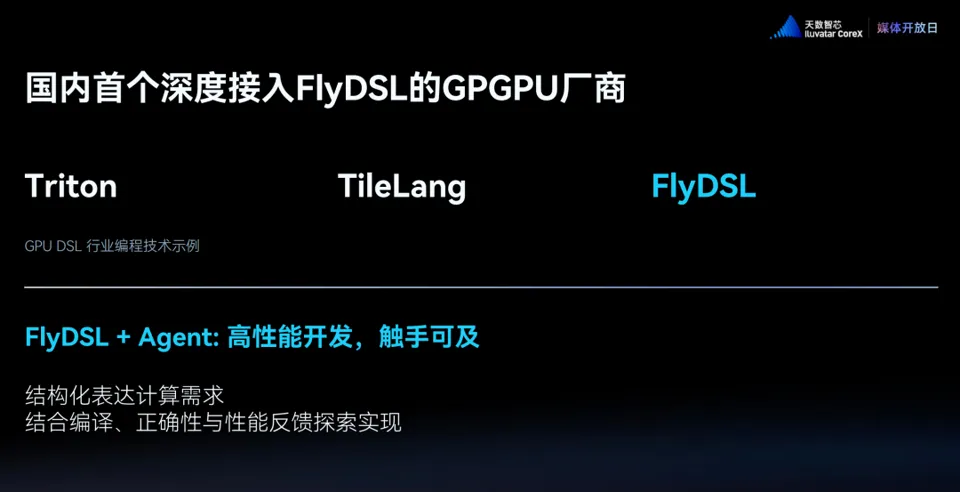
写算子也是同样的思路。天数智芯是国内首个深度接入FlyDSL的GPGPU厂商,它让AI借助FlyDSL来生成、编译、测试和优化代码。
在某主流模型的适配调优中,原本预估要10人天的工作,在Agent辅助下不到2小时就实际完成了,正确性和性能也都达标;每次编译反馈的等待时间,则下降了90%以上。
过去是GPU加速AI,现在则轮到AI反过来加速GPU了。这大概就是这场分享标题里“以智生智”的意思。用石加圣的话说:
Agentic AI让一位工程师的经验,能够持续服务千千万万开发者。
敢跟英伟达现场PK的底气
最后,我们还得讨论一个问题:
天数智芯到底哪里来的底气,敢跟英伟达现场PK?
说到底,是天数智芯有足够的自信。
天数智芯这次拿出来的数据是实测的,能复现;产品是量产的,能交付。
再加上现场随机提出的提示词、有可能被反超的速度、很可能站不起来的小鸭子……敢玩Live Show,就得做好面对这些不可控的变量的准备。
而把云、软件、端三条线放在一起看,它们其实构成了一个转起来的回路:
云端高效生产智能,软件栈让AI加速进化,端侧再把智能送进工厂、实验室和医院。高效率、可预期、可持续,就在这一圈圈的循环里,复利式地积累下来。
至于天数智芯的下一张考卷,其实早已写在路线图上。在那张四代架构路线图里,“超越Hopper”是第一站,如今天垓300已经交了作业;接下来要面对的是Blackwell,再往后则是Rubin。
到那时,天数智芯还敢不敢把实机搬上台,跟英伟达的新一代产品再同场PK一把呢?
至少在这一次,它把说过的话,用实测兑现了。
PS:遥想AI刚兴起的时候,老黄就是用类似的方式来对比CPU的……只能说,天道好轮回,苍天饶过谁。
一键三连**「点赞」「转发」「小心心」**
欢迎在评论区留下你的想法!
— 完 —
🌟 点亮星标 🌟
科技前沿进展每日见