Tencent Cloud Restructures Hunyuan R&D Around Real-World Business Evaluation
At its Digital Ecosystem Summit, Tencent Cloud outlined a restructuring of Hunyuan's R&D pipeline: a reorg began in December 2025, post-training infrastructure was upgraded in January 2026 for long-horizon agent reasoning, and major releases now land every two to three months. On evaluation, it supplements public benchmarks with blind tests by 163 internal domain experts and an internal suite spanning nine business lines, addressing the coding-heavy bias of existing agent benchmarks.
Full Report
Contents3 sections
过去几年,大模型厂商发布新产品,总少不了一张密密麻麻的 Benchmark 成绩表。但当模型真正进入工作场景,评判标准就没那么简单了。
今年 3 月,一项研究分析了 43 套 Agent 评测基准,涉及超过 7.2 万项任务,并与美国劳动力市场的 1016 种职业进行对照。结果发现,现有评测高度集中于编程等计算机相关任务,管理、法律等大量真实工作场景却明显覆盖不足。
模型在测试中表现出色,究竟能在多大程度上反映它解决实际问题的能力?
10 月 30 日,2026 腾讯全球数字生态大会「模型与 MaaS 服务专场」上,腾讯云 MaaS 产品中心总经理邹辉谈到了大模型市场的三项变化:模型能力持续增强,百万 Token 调用成本从“元”降至“角”甚至“分”,Agent 也从对话接口逐渐发展为能够规划和执行任务的智能主体。
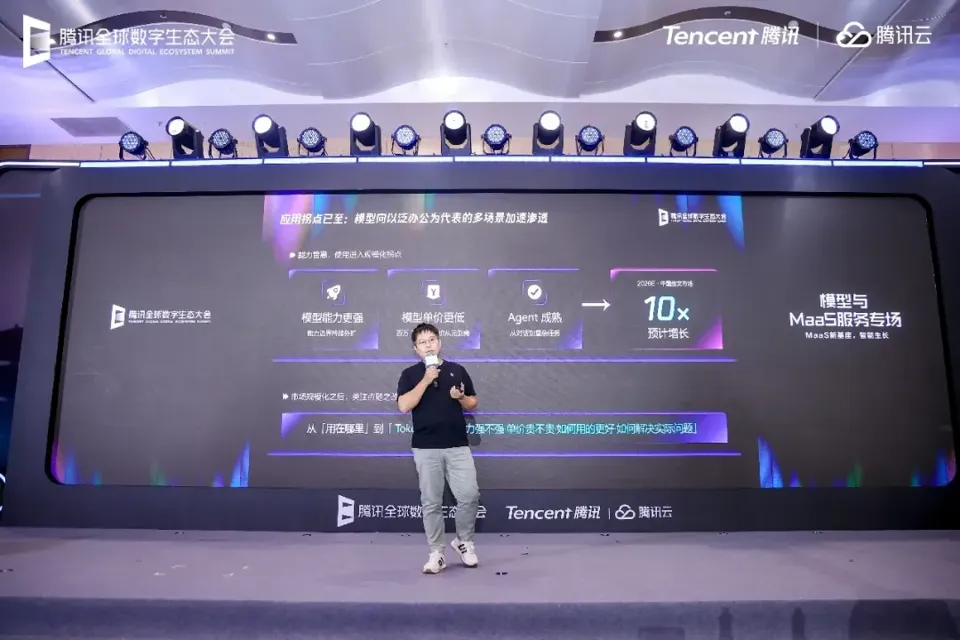
随着应用门槛降低,企业关心的问题也越来越具体:模型能力是否匹配业务,成本能否控制,服务是否稳定,以及复杂任务能否真正完成。
这些要求贯穿模型研发、训练推理和业务应用,也让 MaaS 的技术体系面临新的挑战。 此次专场上,腾讯云围绕混元、TI-ONE、TokenHub 以及产业伙伴的模型实践,展示了模型能力从研发、部署到实际应用的完整链路。
当排行榜无法回答所有问题
Benchmark 依然是衡量模型能力的重要工具,但真实工作往往比测试题更复杂。
一段代码通过单元测试,与完成涉及需求理解、跨文件修改、调试验证的软件工程任务,并不是一回事。尤其在 Agent 场景中,模型还需要持续调用工具、处理执行异常,并根据中间结果调整后续动作。单项能力出色,不意味着整项任务一定能够完成。
混元在模型研发过程中,除了 Terminal-Bench、DeepSWE 等公开基准,以及 Arena 等第三方评测平台,还组织了 163 名内部高频使用大模型的业务专家,围绕软件工程、游戏开发等四类典型场景,对模型开展盲测。
目前,腾讯已建立覆盖 9 大业务方向的内部评测体系。这些来自具体业务的评价,也成为模型后续迭代的重要参考。
评测方式的变化,与混元研发体系的调整同步发生。2025 年 12 月,混元启动研发体系重组;2026 年 1 月,重点升级后训练基础设施,以适应智能体长程推理任务的需求。此后,混元逐步形成每两到三个月进行一次重大版本迭代的节奏。
模型与产品联合设计(Co-Design)是其中的重要一环。
WorkBuddy、CodeBuddy 等产品连接着大量具体任务。代码开发关注跨文件修改、调试验证和工程质量;办公应用涉及跨文档分析、数据处理与成果交付。不同业务对准确性、长程执行能力、响应速度和 Token 消耗各有要求。
这些实际需求为模型研发提供了更具体的优化方向。公开榜单能够帮助团队判断模型的能力水平,真实工作流则让能力短板变得更加清晰。
模型足够聪明,还要足够好用
模型能够完成复杂任务,并不意味着它已经适合生产环境。
长程任务通常伴随着更大的上下文窗口、更频繁的工具调用,以及持续增长的推理开销。即便最终结果正确,如果响应过慢、运行成本过高,也很难支撑规模化应用。
尤其当企业需要同时使用不同厂商、不同规模的模型时,底层硬件、推理框架和部署方式的差异,还会进一步增加工程复杂度。如何在不同算力环境下稳定交付模型服务,成为 MaaS 平台需要解决的问题。
腾讯云 TI-ONE 产品总监王仿坤将生产级推理的难点归纳为性能、成本和运营三方面。
Prefill 和 Decode 阶段对算力的需求不同,算子效率、并行通信、缓存策略以及长尾时延都会影响推理性能;异构算力适配与资源闲置影响使用成本;模型上线之后,还需要具备可观测、弹性伸缩和平滑更新能力。
基于开源权重部署模型已不算困难,真正的挑战是让它长期稳定地满足生产要求。
作为腾讯云的训推一体化平台,TI-ONE 向下兼容并调度国产及海外异构算力,向上支撑 TokenHub 等 MaaS 服务及企业专属部署。训练工具链、推理加速、资源调度和部署工具被整合在同一体系中,以降低模型与硬件的适配门槛。
国产算力上的推理优化是此次升级的重点之一。 王仿坤介绍,在主流国产加速卡的测试环境下,Hy4 preview 经过优化后,单卡吞吐达到初始版本的 5 倍。相关团队仅用两周完成了这轮专项优化,并将成果沉淀到 TI-ONE 平台,供后续部署复用。
平台还将推理配置与调优经验封装为部署模板,减少企业针对不同模型、不同硬件反复配置推理服务的工作量。
这些工程优化不会直接提高模型在 Benchmark 上的得分,却能够让相同的模型能力以更低的成本、更稳定的性能进入业务。
而模型版本更新越快,持续适配和交付这种能力的重要性也越突出。
真实业务需要怎样的模型?
模型能力持续提升,企业却未必总是需要参数规模最大的版本。
复杂科研任务更看重推理深度,终端交互需要更快响应,工业预测则关注数据适配、准确率和运行稳定性。不同任务对模型的要求,并不存在统一答案。
小米 MiMo-V2.6 系列体现了这种差异。据小米大模型商业化产品负责人崔巧英介绍,MiMo-V2.6 Pro 面向专业场景与复杂长程工作流;Pro-Ultraspeed 重点优化推理速度,适合强实时交互;Flash 则兼顾能力与成本,面向高频调用和批量任务。
在小米披露的测试中,Ultraspeed 版本的输出速度最高可达 Pro 版本的 20 倍以上。不同版本的性能取舍,直接对应不同应用对响应时间和资源消耗的要求。
模型进入应用,也需要高效的服务通路。MiMo-V2.6 在腾讯云 TokenHub 首发,并接入腾讯 ima、WorkBuddy 等产品。小米方面披露,V2.6 上线后的日调用量较 V2.5 增长 15 倍以上。
TokenHub 产品负责人何世友介绍,平台通过 Day 0 接入机制,尽可能在重点模型正式发布当天完成上架,并提供不同等级的模型服务,让开发者能够根据业务需要更快开展选型和验证。
终端设备的模型选择则更加复杂。荣耀全场景产品软件总经理席迎军介绍,荣耀在 YOYO Claw 中采用端云双向智能路由:适合本地处理的任务尽量利用设备侧算力,复杂任务则交由云端处理,并根据任务特点选择模型。目前,相关产品已接入腾讯提供的多类模型服务。
用户并不需要了解模型运行在哪里,但响应速度、操作体验和任务完成质量会直接影响他们是否愿意持续使用 Agent。
工业场景则有不同的能力需求。稳准智能研发平台负责人原豪介绍,其结构化数据基础模型 LimiX-2 面向表格、时序等数据进行预测与决策。在石油化工场景中,传统方案需要针对单口油井的 13 项指标分别训练专有模型,而 LimiX-2 能够以单一模型统一覆盖这些预测任务。
据稳准智能披露,这一方案缩短了部署周期,并改善了部分关键指标的预测效果。
与通用语言模型侧重文本理解、推理和任务执行不同,结构化数据模型的价值更多体现在预测精度、生产效率等业务指标上,其训练方式与工程要求也有所区别。
LimiX-2 借助腾讯云 TI-ONE 开展训练与迭代,通过资源组管理、任务调度和故障恢复等机制保障运行。原豪特别提到,对于需要长时间运行的训练任务,稳定性往往比瞬时峰值速度更重要。
从实时交互到工业预测,模型的能力、运行环境和成本结构都需要与业务相匹配。混元持续优化基础模型能力,TI-ONE 提供训练与推理的工程支撑,TokenHub 则承接多模型接入与服务,让不同能力能够更有效地进入实际应用。
当模型开始承担越来越多实际工作,能力的边界也在被重新审视。一次出色的评测表现或任务演示,远不足以证明它在生产环境中的价值。如何让模型持续进步,并以稳定、经济的方式服务于不同业务,将越来越考验模型厂商从研发到 MaaS 服务的整体能力。
- 点击链接(https://qdrl.qq.com/uiViAqav),查看精彩回放