Agora Promotes Real-time Voice Infrastructure at iRTE Conference
The iRTE2026 conference highlights the shift in AI voice interaction from single-turn Q&A to full-duplex continuous communication. Agora, as an infrastructure provider, showcased its underlying capabilities supporting models like OpenAI and Gemini, aiming to lower development barriers by reusing network and interaction components. The event primarily reflects industry trends and vendor marketing, lacking specific technical breakthroughs or parameter details.
Related Entities
Full Report
Contents2 sections
闻乐 发自 凹非寺 量子位 | 公众号 QbitAI
不是我说,AI现在确实代码写得快,研究做得飞起;
可一到语音聊天,我就想问一句:
它到底急什么?!!
你话还没说完,它抢着就开口了;你情绪上来了,它还在一板一眼念答案;你想打断换个话题,它偏要把最后一句念完……
这哪是聊天啊,这不纯纯较劲嘛。
△图片AI生成
说白了,AI“会说”这关早过了,但“会聊”,还差着一大截。
要说会聊,TA得能听懂情绪和言外之意吧,得跟上你说话的节奏吧,得在你打断时及时把话口让给你吧。
这些体验上的小别扭,看着不起眼,背后却牵着语音识别、模型理解、实时传输、终端响应一整条链路。
哪一环慢了,聊天的体感就容易崩。
也正因如此,实时交互成了模型、应用和硬件团队一块儿攻关的方向。
刚刚落幕的iRTE2026实时智能大会,把这些团队全凑到了一块儿:
研究下一代交互模型的、做客服Agent的、造智能硬件的,都在聊同一件事——
怎么让AI跟上真实交流。
一场对话式AI的风向标大会
站在行业观察者的视角可以清晰看到,当下对话AI的核心演进主线,已经从单纯的“生成一句话式回答”,转向深度“持续参与真实交流”。
OpenAI的GPT-Realtime把实时推理和工具调用带进语音模型,让AI在听懂需求之后,进一步判断怎么回应、调用什么工具。
Google的Gemini Live让对话与深度思考并行,后台处理复杂任务时,用户仍能继续交流;GPT-Live配合Decisions,则让Agent根据增量转写,在用户说话过程中就触发操作。
从全双工的边听边说,到结合声音、画面的全模态判断,AI正逐渐走出一问一答的回合制。
头部厂商持续推进实时交互,iRTE也成了观察这些技术如何走向产业的窗口。
早在2020年,这场行业大会便由RTC升级为RTE,议题从实时音视频通信,拓展到更丰富的实时互动体验;
到了今年,又在RTE上加了“i”(代表着Intelligent,实时智能),正式升级为iRTE,进一步聚焦实时互动与生成式AI的融合。
名字只多一个字母,要接住的工作可多了不少。
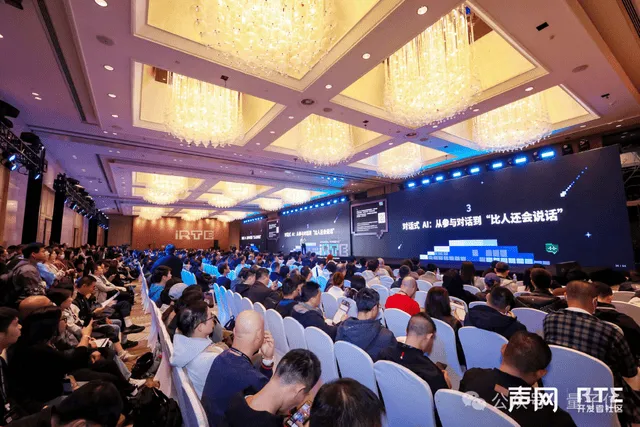
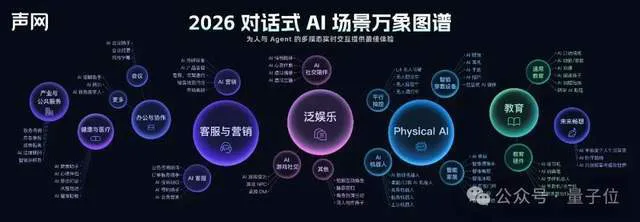
从专场议题不难看出这届iRTE大会的核心风向,十余场论坛、100余场深度分享,共同叩问对话式AI落地要跨过的三道现实命题。
第一道命题是模型能力与业务结果的对齐。
美团、阿里、MiniMax、声网在企业级客服智能体专场同台探讨,大模型对话表现再优异,如果不能适配真实业务流程,依然无法产生商业价值。
行业亟需弥合模型路线、工程实现与业务目标之间的鸿沟。
第二道命题:流畅对话背后,是一整套不可缺位的底层技术底座。
想要实现自然的实时对话,不能只依靠大模型本身。来自阶跃星辰、香港中文大学(深圳)、清华大学语音与音频技术实验室、Qwen Audio、蚂蚁百灵、小米、Soul等企业及高校/机构的技术专家在对话式AI、音频AI技术专场,围绕交互模型、目标人声提取、多说话人识别、实时语音生成等方向展开研讨。
产业形成共识,上述基础技术任何一块短板,都会直接破坏对话体验。
第三道命题,则是技术从实验室走向终端硬件之后的现实考验。
当AI能力下沉到硬件设备,技术方案必须直面复杂真实物理环境。
瑞芯微、宇视科技、PETKIT小佩在智能硬件与具身智能专场提出,仅仅把大模型接入硬件远远不够,端侧算力约束、现实环境感知,最终都要回归产品价值本身来考量。
搭载AI之后,设备必须长出真正让用户愿意持续使用的差异化能力。
主论坛圆桌进一步把讨论推向落地层面。
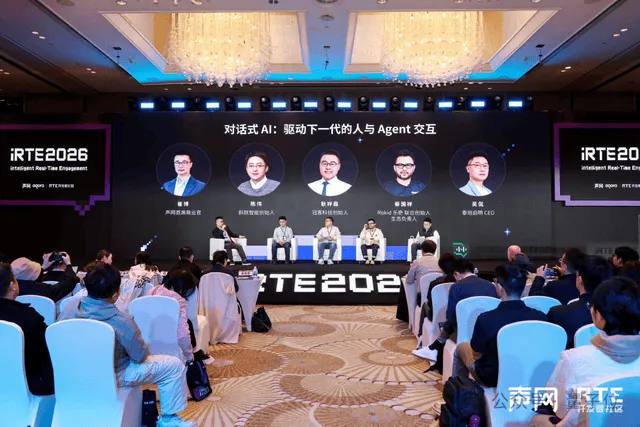
斜跃智能创始人陈伟认为,具身智能的关键是让人的意图真正转化为机器人的行动。 机器人不仅要理解语音指令,还需要融合视觉、语音及自身状态等多模态信息,完成对物理环境的感知、规划与决策,并根据行动后的环境变化持续调整任务执行。
Rokid乐奇联合创始人蔡国祥提出,对话的自然度,是决定AI穿戴设备用户体验的核心;
冠客科技创始人耿祥磊则指出,语音座席的延迟、打断交互的时机把控,会直接左右业务成效。无论是智能硬件,还是企业客服场景,所有考验最终都收敛到用户开口之后短短数秒的交互窗口之中。
模型负责理解与推理,实时网络、音视频处理、交互编排同样需要协同跟上。
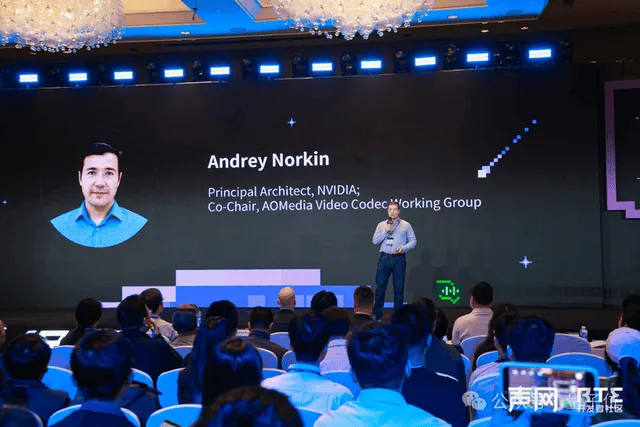
英伟达首席架构师、2025技术与工程艾美奖得主Andrey Norkin带来AV2新一代视频编码分享,补齐媒体交付这关键一环,探索在更高压缩效率之上保障优质视频交互体验的路径。
从模型能力到业务闭环,从终端硬件到媒体传输,iRTE呈现的行业动向逐渐清晰:
对话式AI的竞争,已经延伸至完整真实交互全链路。
而支撑这条链路、决定交互体验下限、对实时性要求最高的底层底座,正是声网深耕的领域。
声网要做的,是打造生成式AI时代的实时基础设施
沿着这条链路看,声网要承担的工作,也在发生变化。
过去,视频会议、在线课堂、语音连麦,主要需要让人与人之间的声音和画面顺畅传递。
如今Agent加入进来,语音识别、模型推理、工具调用与终端反馈,都需要在交流中及时配合。
声网创始人兼CEO赵斌在主论坛提出的“五级对话能力”框架,进一步展开了这种变化:
从L1的问一句答一句,到L2掌握互动规律、协调听说时机,再到L3理解个人意图与处境、L4理解多人关系和沟通边界,最终走向L5基于长期上下文的深度沟通。
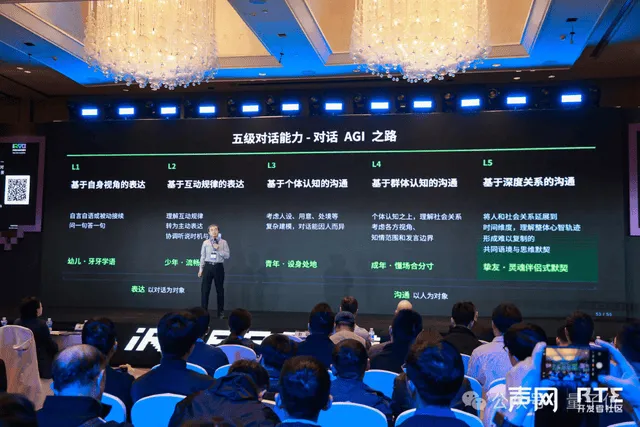
顺着这套框架看,回答快、声音自然,只是部分能力。AI还需要理解,自己在跟谁交流,对方为什么这样说,什么回应才合适。
眼下最直接的考验,就是处理好停顿、打断和任务执行。
“快慢脑”协作处理的就是这类问题。
该框架让交互模型维持实时对话,后台模型负责深度推理、搜索和工具调用。用户可以继续补条件、改要求,系统据此调整执行。
但并行之后,几个模型还得保持一致:前面已经接受了新要求,后面就不能继续按旧任务操作。
声网展示的Agora Conversational Model,采用多模型协作的混合对话系统,将声音感知、全双工响应、推理、工具、记忆与语音表达组织起来,协调持续聆听、意图判断和行动。
实时基础设施的作用,也由连接和传输,延伸到了对话过程中的模型协同。
赵斌介绍的Conversational Agent System,将上述能力与全球实时网络、音频处理及推理基础设施结合起来。声音、画面要持续传递,轮次、上下文与业务状态也要及时同步。
他进一步提出的分布式实时推理云方向,还包括让模型靠近用户运行,并根据时延、负载和场景,动态选择模型、工具与路径。
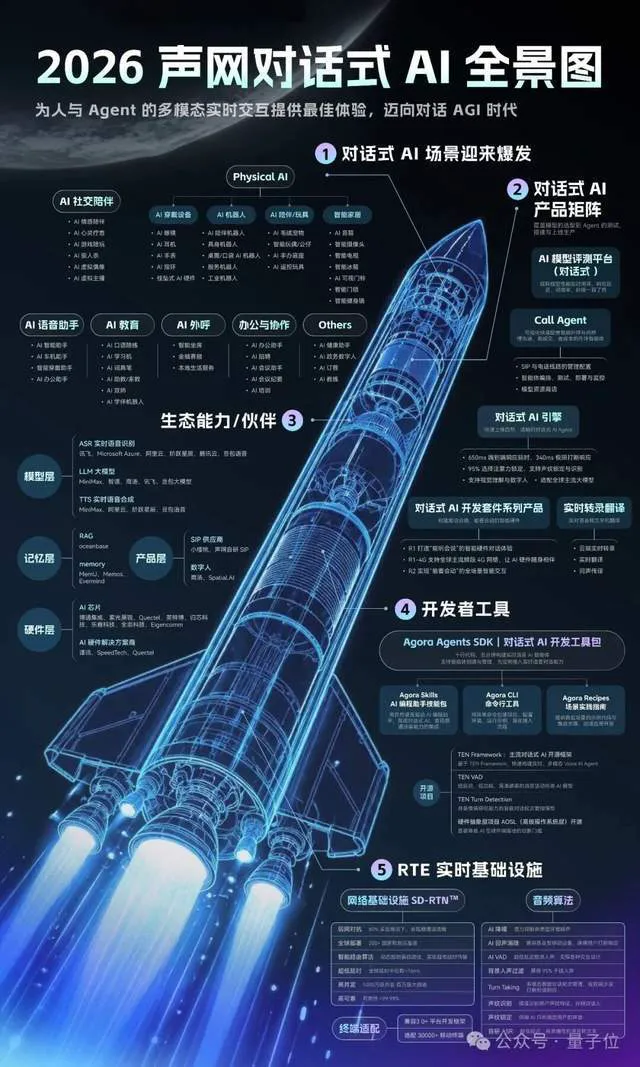
这些能力进入业务和终端,也有相应产品承接。
对话式AI引擎连接模型、Agent运行框架与用户,兼容级联式和端到端架构,提供轮次管理、打断处理、注意力锁定等能力;
开发套件帮助硬件从语音对话向视觉、动作交互拓展;
Call Agent面向电话业务,提供线路配置、流程编排、测试部署与监控等工具。
开发者则可以通过SDK、Skills、CLI和Recipes,获得接入、AI编程辅助和场景示例支持,借助TEN Framework等开源项目组合模型、工具与记忆,减少基础环节的重复建设。
从网络、交互处理到产品和工具,声网正在把人与Agent交流所需的能力,组织成一套可复用的基础设施。
这也与大会从RTE走向iRTE相呼应。
实时互动开始承载智能,底层系统就需要让模型的理解、推理与行动,在真实交流中持续配合。
至于普通用户,未必关心后台有几个模型协作、走了多少网络节点。咱们的要求其实一直很朴素:
话没说完,先听着;主意改了,能跟上;事情交代了,办得好——
AI都这么聪明了,聊起天来,也该让人省点心了。