Chinese Medical LLM Beats Doctors in 40 Complex Lung Cancer Cases
Future Doctor's MedGPT, in collaboration with top-tier Chinese thoracic surgery teams, conducted a large-scale empirical study on 40 complex lung cancer cases under a unified evaluation standard, winning 88 to 12 against physicians, most of whom were chief or associate chief doctors from tertiary hospitals. With MedGPT assistance, doctors' overall scores rose from 53.40 to 66.27, a 24.1% relative gain, outperforming general models such as GPT-5.4, Claude Opus 4.7 and Gemini 3.1 Pro.
Related Entities
Full Report
Contents4 sections
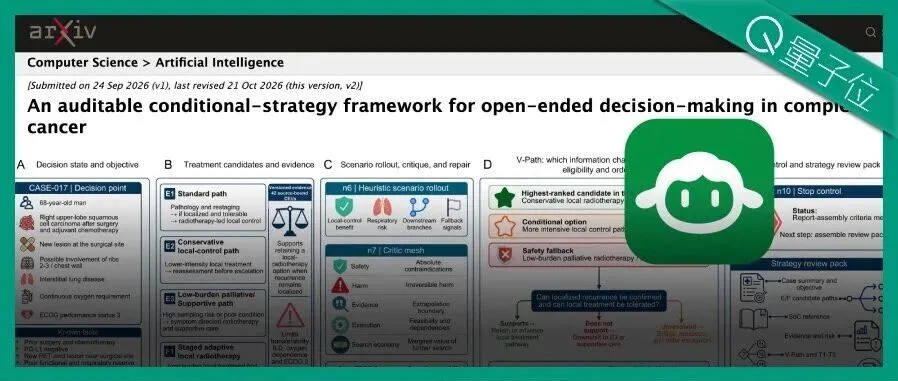
250名国内顶尖三甲医院医生联合评测
鹭羽 发自 凹非寺
量子位 | 公众号 QbitAI
了不起!国产AI首次完成大规模肺癌实证,挑战「头号癌症杀手」取得重大突破:
围绕40例复杂肺癌病例,在完全统一的标准评估下,AI对医生,88比12。
几乎是临床表达上的断崖式领先。
其中参与实验的250名医生,来自全国各地的三甲医院。
多数还是主任或副主任医师,平时排号都排不上的那种……含金量自然不言而喻。
该项研究由中国AI医疗公司**“未来医生”与国内顶级三甲医院胸外科团队**联合开展,将医疗AI直接放进了临床最考验综合判断的一类场景:
肿瘤病情复杂、多种治疗方案相互牵制,且没有唯一标准答案。
背后发挥作用的,正是未来医生医疗大模型MedGPT*(以下简称:未来医生MedGPT)*。
不仅对比GPT-5.4、Claude Opus 4.7、Gemini 3.1 Pro等当前国际主流通用大模型优势明显,人机协作一侧的变化也同样具体。
未来医生MedGPT辅助下,医生总体得分从53.40跃迁至66.27,相对增幅24.1%。
它的表现,也让包括中华医学会主委级专家、美国顶尖肿瘤医学专家在内的近10位一线临床权威纷纷竖起大拇指:
国内包括中国医学科学院肿瘤医院胸外科食管病区主任李印、山东省肿瘤医院乳腺病中心主任王永胜、四川大学华西医院胸外科学科带头人陈龙奇在内的多位中华医学会主委级专家均认可其临床实用价值,认为这正是一线医生迫切需要的医疗AI。
美国UCSF Health肿瘤外科主任Robert Warren、美国“希望之城”国家医疗中心乳腺肿瘤内科主任Hope S. Rugo、有迈阿密地区顶尖前列腺癌放疗专家之称的Mark Pomper、加州大学旧金山分校血液肿瘤科荣誉主任Marc Shuman等顶尖专家也同步发声,肯定研究的行业价值与落地潜力。
放到行业看,这场肺癌实验,让医疗AI参与复杂诊疗的能力,有了一份可以展开讨论的国产实证答卷。
从理论到实践,AI正在为更多人的癌症治疗开辟新的可能。
250名三甲医生参与,专攻肺癌诊疗灰区
坦白来讲,“攻克癌症”一直是AI进入医学领域备受关注的方向之一。
过去几年,AI在相关领域的突破,已经一路深入到蛋白质结构预测、基因研究和药物研发。
但要走到患者面前,临床上还需要回答一个更为具体的问题:
怎么治?
尤其是类似肺癌这样的重大疾病。世界卫生组织的资料显示,肺癌是全球癌症死亡的首要原因,2024年约造成190万人死亡。
全球每5个癌症死亡者中,就有近1个死于肺癌。
而在中国,这一负担更为集中,肺癌连续多年位居国内恶性肿瘤发病和死亡首位。
实际诊疗中,患者的情况也是千差万别。同样的治疗方案,遇到器官功能、共病和既往治疗不同的患者,适用条件就会发生变化,非常考验医生及AI的随机应变能力。
本次实验带头人、知名胸外科专家梁教授,在长期临床工作中就经常面对这样的难题。
在他看来,肺癌灰区诊疗需要把循证医学与前沿研究放到患者的个体差异中,找到合理的治疗安排。团队与未来医生合作开展研究,便是希望将这些临床判断梳理成AI能够参与、医生能够审阅的决策过程。
研究从真实临床中选取40例未公开病例,这些病例均具备灰区特征,存在指南推荐不明确、共病约束冲突等情况,具体治疗路径需要结合多个条件共同判断。
对照组的阵容也做了充分设计。
250名参与医生覆盖全国27个省级地区、98个标准化中心,横跨胸外科、呼吸科和肿瘤科。其中,主任医师、副主任医师共159位,占63.6%。
这样做的好处在于,能够让不同地区的临床经验与诊疗视角同时进入评估,让实验更充分地纳入本土多样化的诊疗实践。
接着每位医生将分别在无辅助、检索参考和未来医生MedGPT支持下,各完成3个不同病例,最终形成2250份策略文本。研究由此观察医生对同类肺癌复杂问题的处理表现差异。
先看人机比较维度。
在与医生无辅助条件下提交的750份诊疗方案的比较中,未来医生MedGPT有660次获得更高评分,以88比12战胜了250名三甲医生。
它的标准化输出也平均比医生短四成以上,相当于以更少的文字表达了更完整的临床内容。
在人机协作维度上,医生的总体得分也存在显著提升。
有未来医生MedGPT辅助的医生,明显对候选路径的考虑更加完整,路径选择中的关键判断和风险评估也更聚焦。
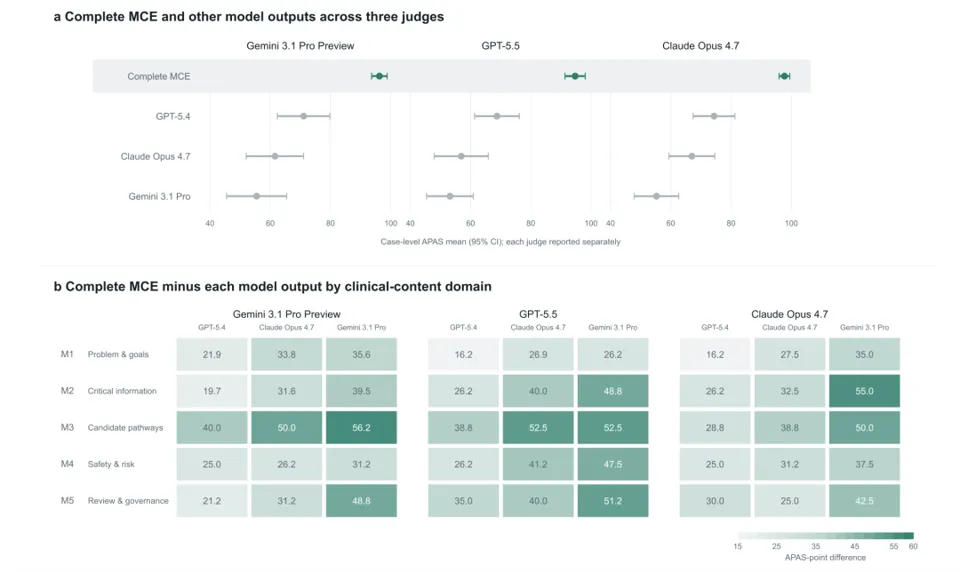
同时在与通用大模型的同条件横评中,未来医生MedGPT综合得分96.22分,大幅度超越GPT-5.4*(71.38分)、Claude Opus 4.7(61.81分)和Gemini 3.1 Pro(54.62分)*。
其优势在于候选治疗路径****生成。通用大模型通常给出单一诊疗方案,未来医生MedGPT更倾向于同时提出多个合理备选路径,以及每条路径的准入退出条件。
这也是后续将重点提及的未来医生MedGPT核心架构的条件式多路径策略。
为了确保实验成绩可信,研究团队还提前建立了一套评分依据。
20名多学科专家通过三轮过程,形成240条病例评价规则,逐例明确需要处理的临床问题、治疗前必要信息和可选路径,并将医生复评一并纳入评价体系。
其中40条锚定治疗资格与治疗强度的安全边界,触及即判负。个中考量,梁教授是这样形容的:
因为在医疗工作中,安全性的优先级往往高于有效性。
规则冻结后,再由三个AI裁判*(GPT-5.5、Claude Opus 4.7、Gemini 3.1 Pro)*独立评分,评审全程隐藏答案来源。
最终输出的高分策略,需要将治疗选择的依据和实施条件一并交代清楚,才能供后续临床讨论使用。
先会诊,再推演:未来医生MedGPT技术拆箱
此次研究使用的临床智能体系统为未来医生MedGPT。
未来医生MedGPT是一个原生为临床使用场景设计的医疗大模型,也是中国首个获得批准的用于疾病诊断和治疗建议的生成式AI模型算法。
1.0时代主要面向通用问诊,控制模型输出安全、有效;新升级的2.0版本则把复杂诊疗决策做得更扎实。
相比通用大模型和医学检索工具,未来医生MedGPT能够整合前沿医学证据,将候选路径、适用条件与风险应对组织成更完整的诊疗策略。
系统设计的起点,从一场多专科会诊开始。
以这位68岁的肺癌患者为例,患者病情复杂,疑似术后复发,本身兼有间质性肺病。医生纠结的点是——要不要对局部病灶动手,但又怕放疗把本就脆弱的肺彻底打坏。
患者病历进入未来医生MedGPT后,多个专科Agent会先各自分析患者问题,并将需要进一步判断的分歧汇总,留待后续推演核验。
随后系统进行病例编译,把病史和检查结果按时间整理,明确患者当前状态,再根据治疗目标确定约束条件。
先诊断评估,再推进治疗,也符合真实临床逻辑。
在此基础上,系统依次生成多组候选路径:
- 标准路径E-Path:依据指南、共识和药品说明书生成,该方案符合常规规范;
- 前沿路径F-Path:结合最新研究与会议成果,为患者生成有证据支持的多元选项。
这一环节相当依赖证据的细分程度,目前未来医生MedGPT的肺癌证据库已包含约1.3万篇原始文档,形成20.1万条临床证据单元*(CEU)*。
每条CEU均保留适用人群、治疗情况等信息,系统再拿该患者的背景逐项匹配,医生也可以随时沿着CEU进行原始研究检索,及时查看结论适用范围。
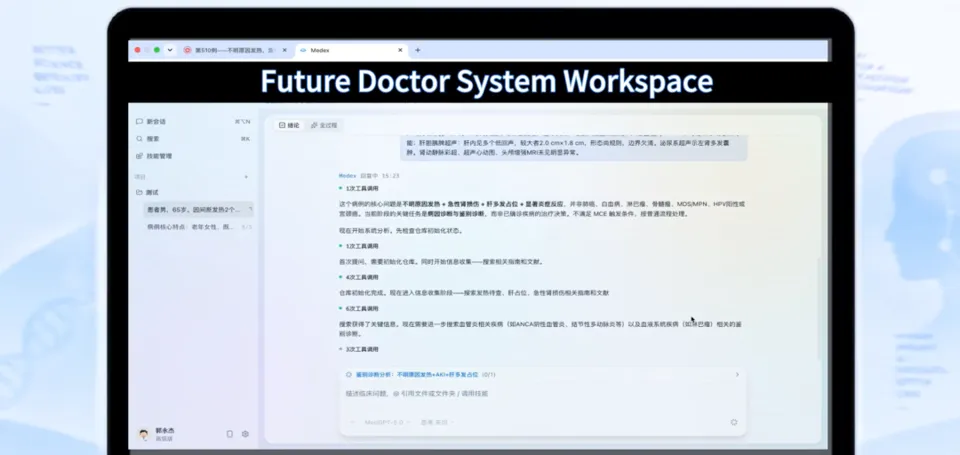
形成E-Path和F-Path之后,还要做补证检索和校验。例如,在选择某条F-Path时,还要看缺什么证据、需要补充哪些信息,才能判断该路径是否可行。
未来医生MedGPT会围绕争议点和证据缺口检索数据库,再针对患者情况,对每条候选路径进行世界模型模拟推演。
从患者当前状态展开,预测接下来的治疗过程:
如果碰到有依据可以修正的风险点,补证后调整;遇到无法解决的风险,则降低优先级甚至移除相应路径,再检验剩余方案。
经过反复推演,系统逐渐收敛到可供审阅的策略,并形成V-Path验证路径,明确下一步需要完成的检查与判断。
整个过程持续循环,直到基于现有证据推不出新的可执行路径为止。
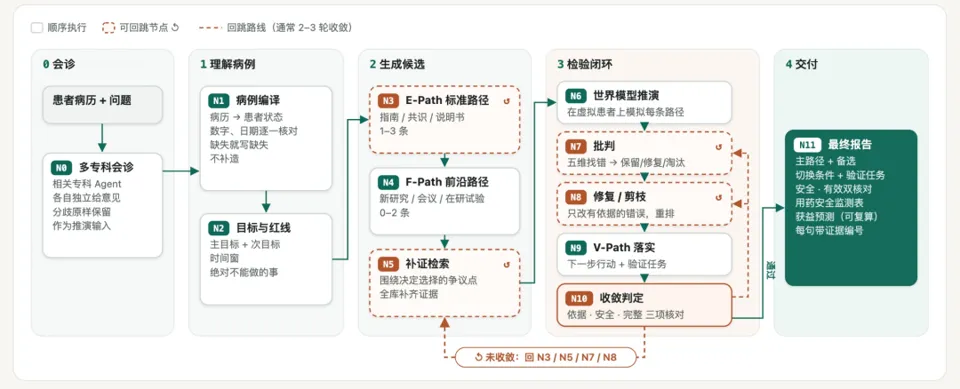
最终交付给医生的是一份可核对的报告,包括:当前主要的治疗路径、备选方案,以及执行安排。
每条路径还配有患者获益分析,结合研究中的总生存期*(OS)、无进展生存期(PFS)*等数据,帮助医生综合比较不同路径。
AI更多承担的是多专科分析、证据匹配和路径校验的工作,待医生拿到材料后,可以围绕影响选择的关键条件展开审阅,再结合药物可及性、患者意愿和家庭情况,完成个体化判断。
这套方法也延续了团队此前的研究。
发表于Nature子刊《npj Digital Medicine》的CSEDB临床安全性与有效性双轨基准,已经将用药安全、危重症识别和诊疗路径优化纳入评价体系。
此次研究进一步进入肺癌灰区,确保新一代医疗AI在参与复杂策略形成时,同时做到安全与有效并重。
医疗AI拓展医生能力边界
从这个视角看,也就更容易理解,中美专家为何集体关注此次实验:
医疗AI正处于从简单医学问答走向复杂临床决策的关键转型期。未来医生MedGPT以肺癌灰区为切口,为这一进展提供了实在的案例支撑。
它证明的是技术能力边界的推进,回应的是医疗AI当下最迫切的临床需求。
AI能不能用?能用到什么程度?可信度如何?
结果一目了然,以未来医生MedGPT为代表的医疗AI已经初步具备临床诊疗可能性。
对医生而言,这意味着更为完整的决策参考。AI辅助在前,医生判断在后,最终协同完成方案选择与执行。
在既定的路径之外,这样的系统也更有可能探索出癌症等复杂疾病的全新思路。
当这些思路逐步得到验证,人类就有望跑赢这场与病症抗争的拉锯战。
用山东省肿瘤医院乳腺病中心主任王永胜教授的话来说:
未来医生MedGPT是能够给肿瘤临床医生带来巨大帮助的医疗AI。
除去对临床医生的实用价值外,美国方面,加州大学旧金山分校*(UCSF)*医学中心肿瘤外科主任Robert Warren博士也看到了模型水面下的潜力:
这是一项重要研究!AI在医学诊断和治疗决策中的作用正在发展,有望为患者和护理人员提供重要的信息支持。
围绕具体实验结果,中美医学专家纷纷表达了对AI参与诊疗决策的认可,以及寻求潜在合作的可能。
未来医生也因此成为这一轮医疗AI临床探索中,备受关注的中国代表。
事实上,让医生获得能力增强,一直是未来医生投入AI的出发点。
创始人兼CEO王仕锐长期用「继绝学、开太平」来解释公司的医疗AGI路线。
化用张载横渠四句中的理念,他希望将顶尖医生积累的医疗能力广泛复制,让优质资源触达更多患者,同时让AI参与疑难疾病探索,撬动医学知识继续更新。
这两件事,都在此次联合实验中有了具体的落脚点。
研究将过往的专家经验整理为评价依据,让AI有理可依。换句话说,这也是优质医疗能力传播的一种途径。
而在复杂肺癌灰区中寻找候选路径,检验AI对疑难决策的支持能力,正是未来医生沿着「开太平」理念推进的一次实证探索。
沿着这一理念,后续研发将与临床工作保持紧密联系。病历持续更新后,系统需要跟进患者状态的变化;医生在审阅和使用中提出的问题,又能成为下一轮研究的起点。
虽说转速还不够快,但至少从今天起,轮子已经造好。
88,让人看到了进展,24.1%的得分提升,则让人机协作的价值有了更为具体的刻度。
未来医生接下来要推进的,是让这条路径在更多临床任务中得到广泛验证。
一键三连**「点赞」「转发」「小心心」**
欢迎在评论区留下你的想法!
— 完 —
🌟 点亮星标 🌟
科技前沿进展每日见