LiQing AI Releases PrismWAM and RoboDoctor to Advance Physical AI Scaling
LiQing AI released two Physical AI breakthroughs: the World Action Model PrismWAM, which ranks first on RoboTwin 2.0, and the Agentic framework RoboDoctor, leading in RoboDojo tests. The initiative shifts focus from 'Scaling Semantics' to 'Scaling Physics,' emphasizing physical state representation and execution feedback to enhance robotic interaction capabilities.
Full Report
厘清智能新成果:PrismWAM 与 RoboDoctor
机器之心发布
近日,厘清智能创始人、清华大学人工智能学院李一鸣教授团队发布了两项 Physical AI 研究成果:世界动作模型 PrismWAM,以及面向机器人执行诊断与持续改进的 Agentic 框架 RoboDoctor。
PrismWAM 从模型层面探索如何更好地表征物理状态、预测状态变化并生成动作,在 RoboTwin 2.0 评测中以领先优势位列第一;RoboDoctor 则从系统层面探索如何利用执行反馈进行诊断、纠错与经验积累,在覆盖 RoboDojo 全部 54 项任务的测试中取得 57.1 分,位居当前对比首位。
过去几年,人工智能的进步,很大程度上来自对语义智能的规模化扩展——更大的模型、更多的数据、更强的理解与推理能力。然而,随着 GPT-6 Astra、Gemini 等通用基础模型不断展现出更强的理解、推理与规划能力,一个更根本的问题正在浮现:让机器人理解世界,和让机器人真正改变世界,是两种不同的能力。
理解一条指令,不等于知道如何施力;识别一个物体,不等于理解它在接触、运动与受力中的变化;规划一条看似合理的路径,更不意味着机器人能够在真实环境中将任务可靠地完成。
这正是 Physical AI 下一阶段的关键命题:Scaling Semantics,还是 Scaling Physics?
前者让模型拥有更广泛的知识、更强的语义理解与任务推理;后者则让模型真正理解物理状态与动作后果,让机器人能够感知变化、应对不确定性,并在失败中持续纠正并自我改进。
两项工作分别从模型与系统两个层面探索 Scaling Physics:PrismWAM 研究物理状态如何被表征、预测并转化为动作;RoboDoctor 进一步研究动作进入真实执行后,系统如何利用物理反馈诊断偏差、纠正动作并积累经验。
一、语义与物理的解耦
让物理状态变化参与动作生成
当语义理解逐渐成为通用能力,机器人还需要什么样的世界模型?
近年来,视觉语言模型与视频生成模型的发展,为通用机器人策略提供了新的基础。世界动作模型(World Action Model,WAM)进一步尝试将未来世界状态预测与机器人动作生成结合起来,使机器人不仅能够根据当前观测选择动作,还能够学习动作与未来状态变化之间的关系。
但现有方法也面临一个值得重新审视的问题:我们是否应该把世界的外观,当作世界状态本身来建模?
一段 RGB 视频同时包含了大量不同性质的信息:物体的颜色、纹理、光照与背景,物体的几何形状、空间位置、接触关系,以及它们在动作作用下发生的变化。这些信息在图像中交织在一起,却并不具有相同的控制价值。
对于机器人而言,理解“这是一个杯子”与判断“杯口在哪里、瓶子应当如何倾斜、接下来会不会洒出液体”,是两类不同的问题。前者主要涉及语义识别与任务理解,后者则要求系统准确把握几何关系、物理状态及其随动作演化的过程。
视频模型特征中包含了语义和物理等多重信息
随着通用基础模型越来越擅长理解场景与任务,Physical AI 的研究重心也有必要进一步向物理层深入:与其让同一个表征承担所有任务,不如明确区分语义信息与物理状态,让不同信息各自服务于最适合的目标。
PrismWAM:从“预测世界看起来怎样”到“建模世界如何变化”
围绕这一思路,李一鸣团队提出了 PrismWAM(Prismatic World Action Model)。
PrismWAM 的核心洞察,是将语义上下文(Semantic Context)与物理状态(Physical State)解耦,不再把外观丰富的视频特征视为统一的物理世界状态,而是建立一条职责清晰的注意力链路:Semantic Planning → Physical Rollout → Executable Action
- Semantic Planning:理解任务意图。模型从 RGB 观测中学习任务语义与目标场景,回答“最终应该发生什么”。
- Physical Rollout:建模物理演化。模型通过深度表征预测连续的几何状态变化,刻画物体如何移动、空间关系如何改变,以及任务如何逐步接近目标。
- Executable Action:生成可执行动作。动作生成直接利用物理演化表征,将状态变化转化为机器人可以执行的连续控制。
PrismWAM 概念示意
在这条链路中,信息从 RGB 语义表征流向深度物理表征,再进入动作生成;动作模块并不直接读取 RGB 特征。使模型把更多建模能力用于几何结构和空间状态的变化。接触与受力能在多大程度上被准确预测,仍需通过具体任务和实验结果检验。
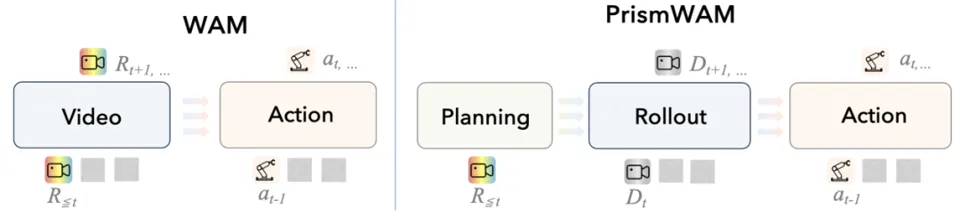
传统世界动作模型与 PrismWAM 的架构对比
这一设计背后,是对 Physical AI 中一个更本质问题的探索:模型究竟应该学习世界的哪些变化,才能更有效地控制世界?
如果任务语义越来越多地成为通用基础模型可以提供的能力,那么物理状态与动作之间的关系,就更值得被明确建模。PrismWAM 并不是否定语义能力的重要性,而是尝试让语义不再承担全部建模任务,使物理状态演化成为连接世界理解与动作执行的核心环节。
从这个角度看,PrismWAM 探索的并非简单地为现有模型增加一种模态,而是重新思考世界动作模型的学习目标:不只学习世界如何呈现,更要学习世界如何在动作作用下发生变化。这就是 Scaling Physics 在模型层面的具体体现。
RoboTwin 2.0:在复杂操作与场景迁移中检验模型能力
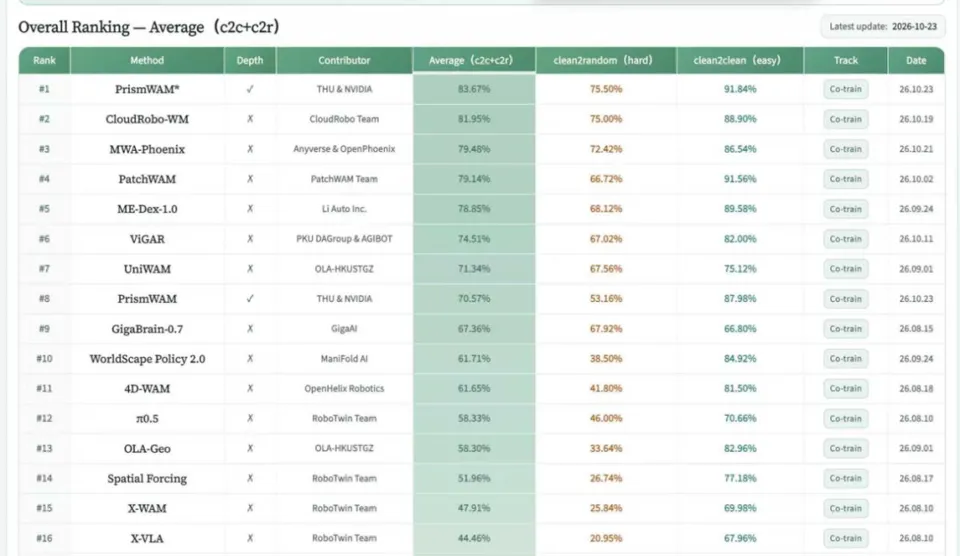
RoboTwin 是双臂机器人操作领域的权威评测基准,涵盖 50 项双臂操作任务,并在背景、光照、桌面杂物、桌面高度与语言指令五个维度上进行随机化,以测试模型泛化能力的上限。其中,Clean-to-Random(C2R)评测重点考察模型从相对干净、规则的训练环境迁移到具有随机化变化的测试环境后,能否依然稳定地完成操作任务。这不仅检验模型对已知任务的掌握程度,更是对其跨场景泛化能力与环境适应能力的直接考验。
在没有动作数据预训练的情况下,PrismWAM 在两类场景上的平均成功率达到 83.67%,取得官方榜单第一名(截至 2026 年 10 月 23 日)。 Clean-to-Random 高难度评测中,PrismWAM 取得了 75.5% 的成功率,进一步展现出其在复杂场景变化下的泛化能力。
二、无额外动作数据预训练
重新审视 Physical AI 的数据效率
更强的操作能力,是否只能来自更大规模的动作数据?
在论文设定中,PrismWAM 使用预训练视频模型作为初始化,并针对深度编码器进行了约 2,300 小时深度数据的预训练;但没有进行额外的动作数据预训练。这一设定减少了对大规模动作预训练的依赖。动作数据通常需要专门的采集和标注流程。若模型能够通过物理表征设计降低对这类数据的依赖,就有机会降低训练高性能操作策略的成本。
值得关注的是, PrismWAM 在 RoboTwin 2.0 上超越了多种采用大规模动作数据预训练的模型,包括 OpenWAM、Xiaomi Robotics-0、与 π0.5 等方法。在覆盖泛化、精细操作、长程任务、记忆与开放任务等能力的 RoboDojo 上,也超越了一众有大规模动作数据预训练的方法。
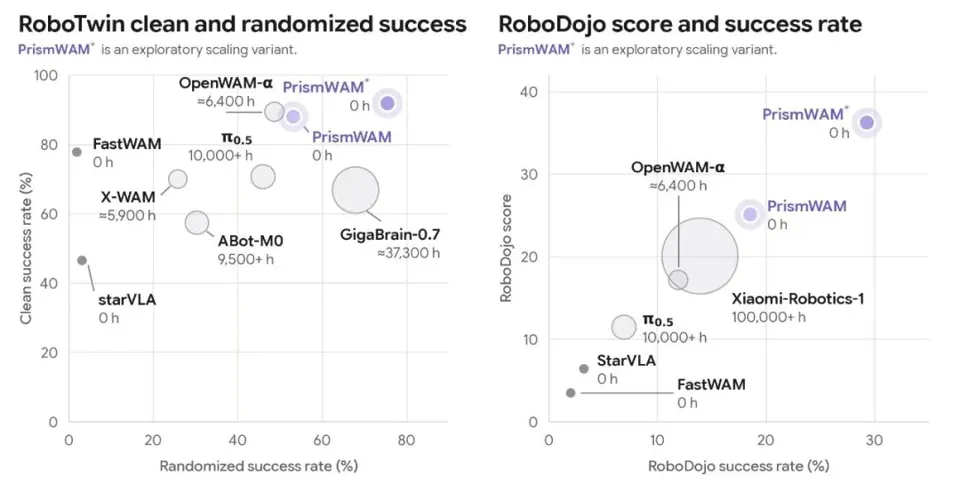
这些结果并不意味着动作数据预训练不再重要,也不意味着规模化训练已经到达终点。它们揭示的是另一种可能性:决定数据价值的,不只是数据规模,还有数据质量和模态,以及模型究竟以什么方式学习世界。
如果模型的表征能够更直接地对齐物理状态与动作后果,那么同样的训练资源就可能转化为更有效的控制能力。这也是 Scaling Physics 的一个重要目标:不仅扩展数据规模,更要提升数据到物理能力的转化效率。
PrismWAM 只是 A Proof of Concept:Scaling 仍在继续,但方向可以改变
需要强调的是,PrismWAM 仍然是一项 proof of concept。它并未证明大规模动作数据不再必要,它所尝试证明的是:通过重新思考语义理解、物理状态与动作输出之间的关系,模型有机会以更高的数据效率建立强大的世界动作模型。
因此,Scaling Physics 并不是拒绝 Scaling,而是重新思考 Scaling 的对象。除了更大的模型和更多的数据,物理状态表征、状态演化建模,以及动作与结果之间的学习,同样可以成为能力扩展的核心方向。
当机器人从单次动作生成走向长程任务执行,Scaling Physics 还需要进一步走出模型内部,进入系统层面:这正是第二项工作 RoboDoctor 的出发点。
三、从 Policy 到 Agent
让策略在执行过程中诊断、纠错与自我进化
有了更强的动作模型,为什么还需要执行中的诊断与纠错?
PrismWAM 探索了如何将物理状态的变化转化为可执行动作。但在长程任务中,前一步的结果会不断改变后一步的条件:一次抓取偏移,可能影响随后的放置;一次接触失误,可能让原本合理的动作失去作用。即使机器人具备较强的局部操作能力,也仍然需要判断整个任务是否在向目标推进。这带来了一个新的问题:当实际结果偏离预期,机器人能否识别偏差、调整执行,并避免在下一次尝试中重复同样的错误?
从 Policy 到 Agent,正是对这一问题的回应。底层策略根据观测生成动作,系统则进一步管理动作与任务结果之间的关系:执行前判断是否需要干预,执行后检查是否达到预期,并将这些判断连接到后续步骤。这使物理能力的提升,从单次动作生成延伸到完整任务的闭环执行。
RoboDoctor:让诊断、纠错与经验积累形成闭环
围绕这一思路,李一鸣团队提出 RoboDoctor,将底层策略的连续控制能力与 Agent 的诊断、规划和经验管理结合起来。在 RoboDojo 实验中,系统采用 5B 参数版本的 PrismWAM 作为固定的底层策略,围绕控制组织、干预判断与具体操作三个层面开展递归自我改进。
-
Harness RSI:改进策略与 Agent 的协作方式。 PrismWAM 提供连续、精细的动作能力,Agent 负责推理、规划与执行管理。反复纠错却难以推进任务时,系统需要重新审视由谁主导、如何组织工具与反馈。在当前实验中,少量 Warmup 回合用于评估策略适应程度,再从两种预设控制器中选择:Hybrid 保留策略主导的执行,由 Agent 辅助;Direct 则由 Agent 直接规划并组织动作。这是控制组织适配任务的一种具体实现。
-
Intervention RSI:改进何时以及为何需要干预的判断。 在 Hybrid 模式下,Agent 结合场景观测、动作提案与机器人运动学预览,判断哪些有效行为应当保留、哪些偏差需要矫正。执行后的新观测进一步检验这一判断:遗漏的失败、不必要的干预,以及干预引入的新问题,都成为修订诊断经验的依据,使后续决策能够利用此前的执行反馈。
-
Operation RSI:改进具体操作与纠错方法。 确定需要行动后,Agent 通过场景定位与动作工具实施操作,再根据实际接触、运动与任务结果修订方法。失败促使系统调整接近方式、接触位置或执行计划,经过验证的方法及其适用条件则保留为外部经验,并在复用前重新定位和检查。这一过程既服务于 Hybrid 中的局部矫正,也服务于 Direct 中的任务执行。策略与 Agent 模型权重始终保持不变,改进发生在控制组织、决策与经验利用中。
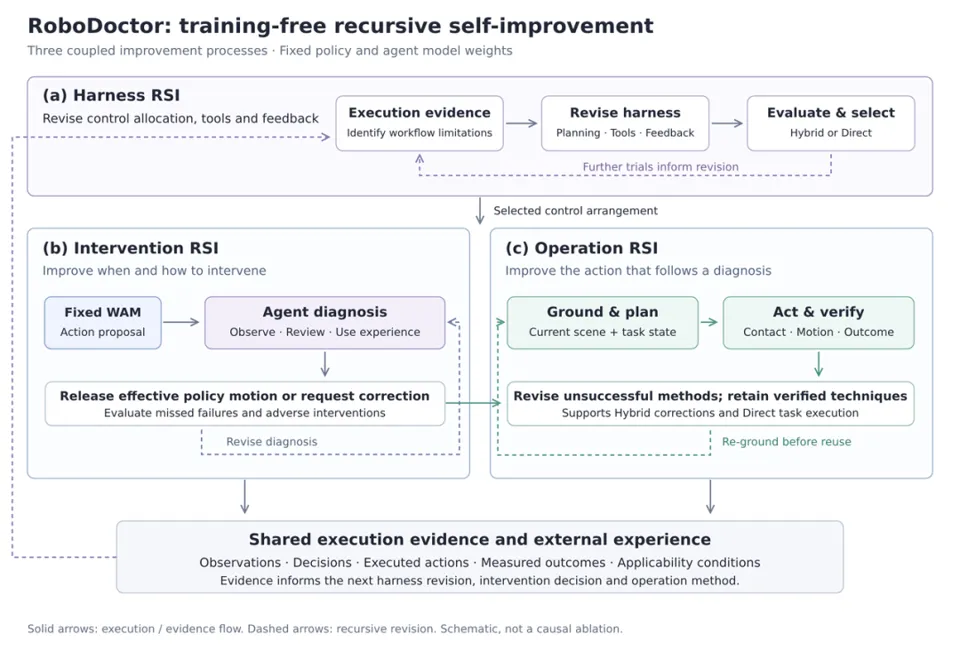
RoboDoctor 的三个递归自我改进过程:执行证据共同支持控制组织、干预判断与操作方法的更新,策略与 Agent 模型权重保持固定。
这一设计进一步追问了 Physical AI 中的另一个核心问题:机器人如何将与物理世界交互的经历,转化为下一次行动的依据?当通用基础模型能够提供任务理解与推理能力,底层策略能够生成连续动作,系统仍需要把两者与实际执行结果连接起来。一次抓取是否稳定、一次矫正是否有效,都需要从物理反馈中获得证据。RoboDoctor 尝试将这些证据组织为可检查、可复用的经验,使机器人的后续决策能够建立在已经发生的交互之上。
从这个角度看,机器人能力的扩展,也可以发生在模型与环境持续交互的过程中:让执行产生反馈,让反馈形成经验,再让经验指导行动。 这就是 Scaling Physics 在系统层面的探索——通过更有效地利用物理交互,将已有的模型能力转化为能够持续改进的任务执行能力。
RoboDojo:从动作能力到完整任务表现
RoboDojo 从泛化(Generalization)、精细操作(Precision)、长程任务(Long-Horizon)、记忆(Memory)与开放任务(Open)五个维度检验机器人能力。在覆盖全部 54 项任务的仿真实验汇总中,RoboDoctor v1.0 取得 57.10 分,在当前方法对比中居于首位。相比官方榜单中总分排名前两位的 HexaShell-Preview(53.18 分)与 WorldScape-R²SI(46.58 分),分别领先 3.92 分和 10.52 分;相比 GPT-6-Astra 和 DeepSeek-Flash,分别领先 28.13 分和 54.11 分。
以上为百分制得分,并非成功率。RoboDoctor 结果更新于 2026 年 10 月 21 日,参考方法来自官方 10 月 20 日榜单。
分项结果进一步展示了物理模型与 Agent 协同的价值:
- 精细操作:将物理表征转化为动作优势。 结合 PrismWAM 的 RoboDoctor 在 Precision 上取得 47.60 分,高于官方榜单所有已公布的 Agent 方法,比该维度得分最高的 Agent 参考方法 HexaShell-Preview(41.25 分)高出 6.35 分。相比 WorldScape-R²SI 的 23.51 分、EmbodiedEvo 的 25.15 分和 GPT-6-Astra 的 12.65 分,RoboDoctor 同样保持明显优势。这一表现说明,引入 Agent 的记忆与任务管理能力,可以与领先的精细操作能力并存,与以物理状态建模支撑动作执行的设计方向一致。
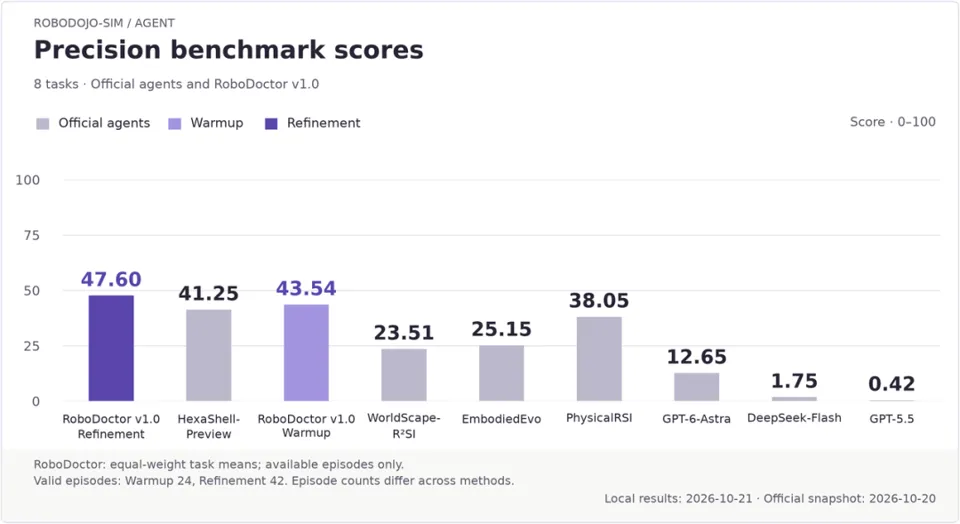
-
记忆能力:让动作执行能够利用任务上下文。 RoboDoctor 在 Memory 上取得 77.50 分,比 WorldScape-R²SI 高 11.72 分,比 GPT-6-Astra 高 34.46 分。结合精细操作结果来看,系统展现了动作能力与任务信息利用能力的互补:机器人既需要完成当前操作,也需要利用此前的信息判断接下来如何行动。
-
递归自我改进:在固定权重下继续提升系统表现。 从试运行(Warmup)到改进阶段(Refinement),总体得分由 49.74 分升至 57.10 分,提高 7.36 分。其中,Memory 得分也提升 3.61 分,泛化得分提升 9.48 分;开放任务提高最为明显,提升了 21.35 分。这些阶段结果展示了系统在利用执行反馈、调整控制方式与积累经验后的进一步提升。
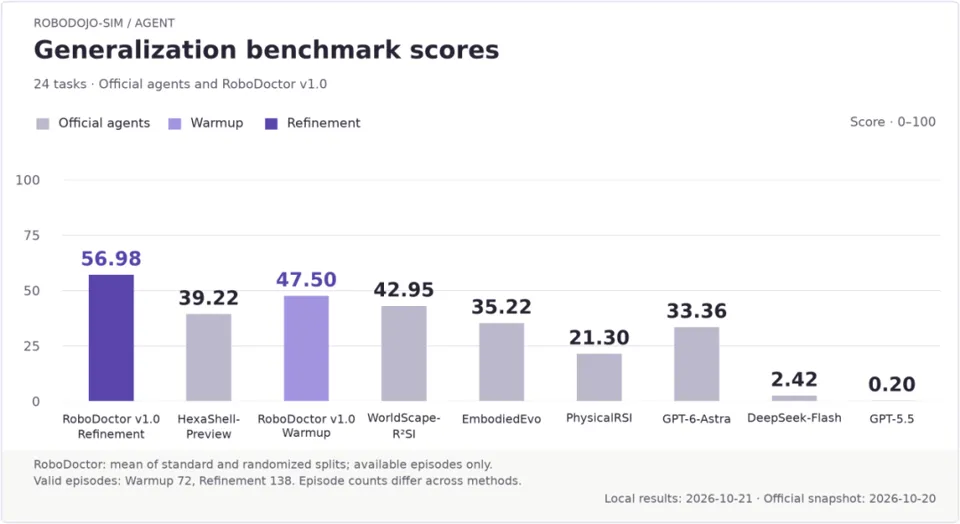
RoboDoctor 在五个维度上均高于 GPT-6-Astra,展现了将通用推理与物理执行结合的系统价值。后续,团队将继续围绕这一闭环展开研究:如何以更低的干预成本纠正偏差,如何更准确地验证接触结果与任务完成,以及积累的经验能否跨策略、跨环境复用。从 PrismWAM 到 RoboDoctor,两项工作由此形成衔接:前者探索如何更好地建模物理变化并生成动作,后者探索如何利用执行反馈,让动作能力转化为可持续改进的任务能力。
四、Physical AI 的下一阶段
从 Scaling Semantics 到 Scaling Physics
通用智能正在为机器人打开新的可能性。过去,Physical AI 的重要发展路径之一,是将更强的视觉语言理解能力与大规模人类动作数据相结合,让机器人理解场景、理解指令,并学习人类的操作方式。
然而,随着 GPT-6 Astra、Gemini 等通用基础模型持续提升语义理解、推理与规划能力,一个值得重新审视的问题是:当通用语义能力可以越来越多地从基础模型中获得,Physical AI 的下一轮扩展,可能需要从单纯 Scaling Semantics 转向更加重视 Scaling Physics。
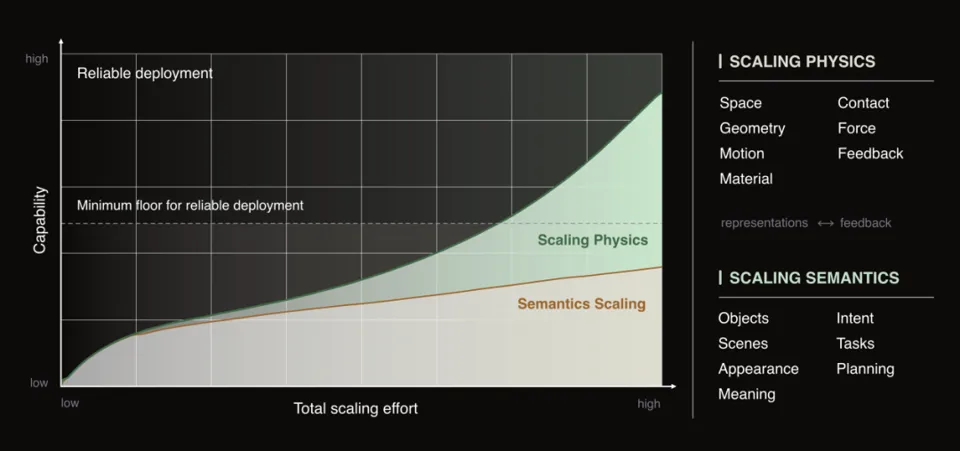
这并不意味着语义能力不再重要。恰恰相反,通用基础模型越强,机器人就越有机会复用成熟的语义理解与任务知识,并将更多研究资源投入物理智能本身。
对产业而言,这意味着 Physical AI 的竞争,可能不再局限于模型参数规模或纯视频数据规模,而将进一步延伸到物理数据的获取与利用、物理状态的有效表征、动作后果的准确预测,以及机器人在真实环境中的闭环执行能力。
PrismWAM 从模型层面探索如何将语义目标转化为物理状态与可执行动作;RoboDoctor 从系统层面探索如何让真实执行产生反馈,并让反馈继续改善任务表现。两项工作分别推进了物理能力的形成与执行,也共同构成了厘清智能对 Scaling Physics 的一次阶段性探索。
Scaling Semantics,让模型理解得更多;Scaling Physics,让模型做得更好。
厘清智能选择押注后者:不只是继续扩大模型和数据规模,更要提高数据、算力与真实交互向物理能力的转化效率。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:[email protected]