Google DeepMind · 2026/10/6 19:57:04
Google 开源 EmbeddingGemma 2:支持端侧多模态嵌入
Google DeepMind 发布开源轻量级模型 EmbeddingGemma 2,基于 Gemma 4 架构实现文本、图像、音频和视频的统一嵌入空间。该模型专为消费级硬件设计,旨在提升端侧搜索与 RAG 管道的多模态处理能力,延续了前代超过 2000 万次下载的高社区热度。
报道全文原始报道全文
本文目录3 个章节
EmbeddingGemma 2 是功能最强大的端侧多模态嵌入模型,能够将文本、图像、音频和视频的组合原生映射到统一的嵌入空间中。
Sahil Dua
Google DeepMind 研究工程师
Henrique Schechter Vera
Google DeepMind 研究工程师
Your browser does not support the audio element.
Listen to article [[duration]] minutes
去年,我们推出了 EmbeddingGemma,旨在为高质量文本嵌入提供一个轻量级选项,帮助您的应用直接在消费级硬件上组织、搜索和连接信息。开发者社区的热烈反响远超我们的预期。凭借超过 2000 万次下载量,构建者们利用它打造了更智能的端侧搜索工具和注重隐私的检索增强生成(RAG)流程。
今天,我们正式发布 EmbeddingGemma 2,将其能力从文本扩展至代码、图像、视频和音频,并将它们统一在一个共享的嵌入空间中。该模型基于 Gemma 4 架构构建,并以商业友好的 Apache 2.0 许可证发布,拥有 7.4 亿参数,非常适合端侧推理。它可以帮您根据语音备忘录查找特定的视频片段,或基于文本查询在数小时的录音中进行搜索——所有这些均由单个原生多模态模型处理。
与 Gemini Embedding 模型采用相同技术构建,EmbeddingGemma 2 具备以下特点:
- 同尺寸中的最佳表现: 在 MTEB(Massive Text Embedding Benchmark)Code 和 MAEB(Massive Audio Embedding Benchmark)等基准测试中,其得分在 10 亿参数以下的多模态嵌入模型中处于领先地位,同时在文本、视觉和音频任务上匹敌甚至超越许多更大的模型。
- 模块化设计: 纯文本工作负载仅需 270M 参数;若需完整的多模态支持,可选配视觉编码器(170M)和音频编码器(300M)。
- 存储高效: 采用 Matryoshka Representation Learning (MRL) 技术,开发者可将输出向量从 768 维动态截断至 512、256 或 128 维。这可为本地向量数据库提供高达 6 倍的存储空间节省,并降低内存占用。
- 针对端侧性能优化: 在严格的资源限制下仍能高效运行。经过量化处理后,EmbeddingGemma 2 在 Google Pixel 11 Pro 上运行纯文本权重仅需约 191MB 活跃 RAM,运行完整多模态模型则需约 567MB。
- 支持长上下文: 具备 8K token 的上下文窗口(比 EmbeddingGemma 1 大 4 倍),允许直接在本地硬件上处理长达 5.5 分钟的音频、29 张图像、58 个视频帧或其交错组合。
在代码、视觉和音频领域实现顶尖质量
EmbeddingGemma 2 保持了 EmbeddingGemma 强大的多语言文本性能,同时在代码性能上实现了显著的 9.92 分提升(在 MTEB Code 基准中,从 68.76 提升至 78.68),使其非常适合用于本地代码库索引、语义代码搜索以及编码代理检索。在图像、视频、文档和音频方面,它为 10 亿参数以下的模型树立了新的“每参数质量”标准,甚至超越了某些体积超过其两倍的专业模型。
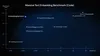
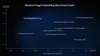
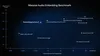
完整的评估指标和模型信息请参见 EmbeddingGemma 2 模型卡片。
实现完全在设备端运行的语义搜索、路由与检索
EmbeddingGemma 2 将强大的能力直接带到边缘硬件上。在本地生成嵌入向量有助于确保数据隐私,降低流水线延迟,并赋能开发者构建完全离线运行的跨模态搜索与检索系统。
当与 Gemma 4 等生成式模型配合使用时,EmbeddingGemma 2 能够支持理解复杂多模态数据的设备端 RAG(检索增强生成)流水线。由于 EmbeddingGemma 2 基于 Gemma 4 构建,并共享其文本分词器和音频编码器,开发者可以在统一的流水线中同时运行这两个模型,从而显著降低总内存占用。
使用文本或图像,根据语义相似度在您的媒体库中查找最佳匹配项。可在 Google AI Edge Gallery 的“即时媒体搜索”功能中体验。
使用文本或音频查询定位视频中的特定时刻。可在 Google AI Edge Gallery 的“视频时刻查找器”功能中体验。
结合 EmbeddingGemma 2 进行本地文件检索,并利用 Gemma 4 进行上下文推理。可在 Google AI Edge Foresight 应用中体验。
通过 MediaPipe Decision Task API,利用多模态上下文创建实时决策引擎,以实现分类、路由和预测功能。
如需了解如何使用 LiteRT 构建设备端搜索和 RAG 系统,请阅读 Google AI Edge 博客文章。
EmbeddingGemma 2 入门指南
我们与以下合作伙伴紧密协作,以确保 EmbeddingGemma 2 能在您构建应用的环境中立即投入使用:
- 下载模型: 在 Hugging Face 和 Kaggle 上查找模型权重,Gemini Enterprise Agent Platform Model Garden 即将支持。访问 LiteRT Community on Hugging Face 获取针对端侧优化的模型。
- 端侧部署: 使用 Google AI Edge MediaPipe 开发跨平台应用,实现开箱即用的嵌入、检索与决策任务;或使用 LiteRT 进行自定义模型集成。通过 transformers.js 或 WebGPU 构建浏览器端应用。
- 使用你喜爱的开发工具: 利用 transformers、sentence-transformers、MLX、vLLM、llama.cpp、SGLang、Ollama 和 LMStudio 高效部署模型。使用 Qdrant 存储你的嵌入向量。
- 微调: 参考 Unsloth 的指南,了解如何针对你的用例微调 EmbeddingGemma 2。
发布于: