Artificial Analysis (@ArtificialAnlys) · 2026/10/23 08:17:33
Artificial Analysis 发布 Coding Agent Index v2.0,Claude Opus 5.5 领跑
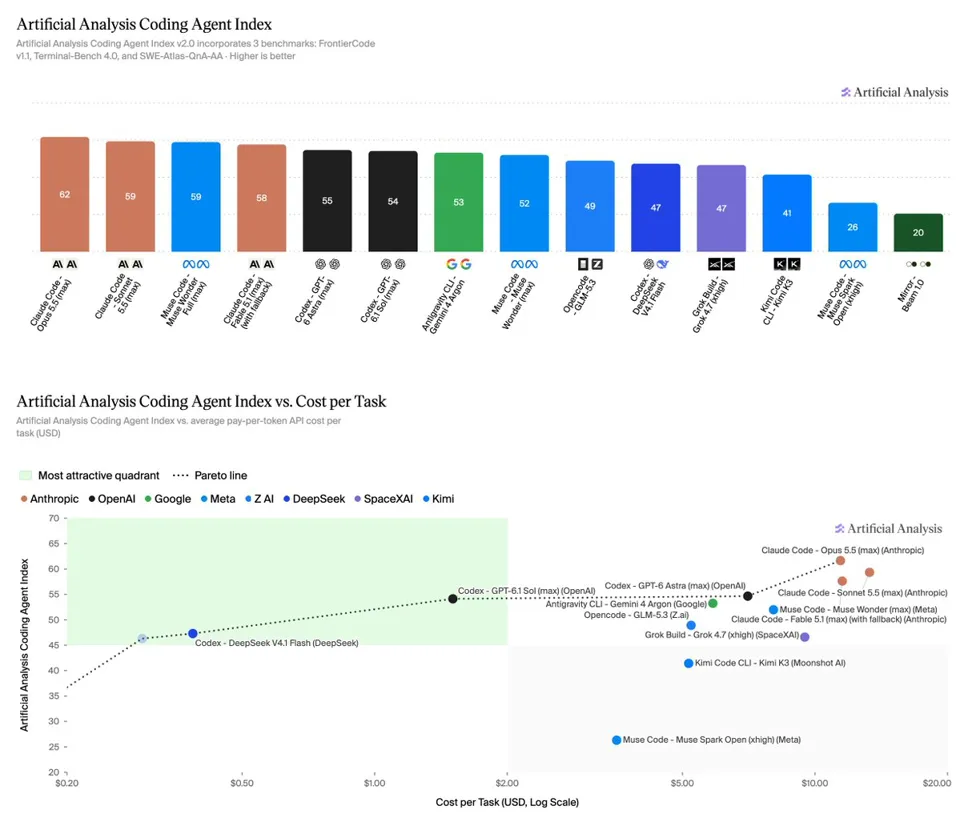
Artificial Analysis 推出编程智能体指数 v2.0,引入 Cognition 的 FrontierCode v1.1 替代 DeepSWE,并修订了 SWE-Atlas-QnA 评分标准。该指数覆盖软件工程、终端使用及仓库问答三大领域共 290 个任务,其中 Claude Code 搭载 Claude Opus 5.5 以 61.7 分位居榜首。
报道全文原始报道全文
Artificial Analysis (@ArtificialAnlys) · 2026-10-23 00
发布 Artificial Analysis Coding Agent Index v2.0:Cognition 的 FrontierCode v1.1 取代 DeepSWE,SWE-Atlas-QnA 评分标准修订,Claude Opus 5.5 在 Claude Code 中以 61.7 分领跑
今天,我们正式发布 Coding Agent Index v2.0。该指数评估模型及其配套的 agent harness(智能体框架),目前涵盖软件工程、终端使用和代码库问答三大领域的 290 个任务,三个基准测试权重相等。
更新日志(Index v1.5 → Index v2.0):
→ FrontierCode v1.1 取代 DeepSWE v1.1。FrontierCode 是由 @cognition 提供的一个包含私有测试集的基准测试:基于真实开源仓库的 100 个软件工程任务,评分依据是维护者是否会合并该变更。若尝试未通过阻塞性检查(blocking check),得分为零;若通过所有检查,则根据满足的非阻塞性检查(non-blocking checks)情况,得分介于 70% 到 100% 之间。此外,我们还使用 Cognition 规则扫描器的修改版对每个轨迹进行扫描,任何被标记为访问了解决方案材料的尝试均得零分。
→ 修订后的 SWE-Atlas-QnA 评分标准,现称为 SWE-Atlas-QnA-AA。Scale AI 的 124 个代码库问答任务保持不变。我们对 1,306 条评分细则中的 127 条进行了措辞调整,以确保判决的一致性,并改用 GPT-6 Luna (xhigh) 作为评审模型,每条细则由五个投票决定。数据集和评审配置已在 Hugging Face 上发布。
关键结果:
➤ Claude Opus 5.5 领跑指数:搭载 Claude Opus 5.5 (max) 的 Claude Code 得分为 61.7,其次是搭载 Claude Sonnet 5.5 (max) 的 Claude Code(59.3)、搭载 Muse Wonder Full (max) 的 Muse Code(58.9),以及搭载 Claude Fable 5.1 (max with fallback) 的 Claude Code(57.6)。
➤ FrontierCode v1.1 是 Opus 5.5 拉开差距的关键:Opus 5.5 在 FrontierCode 上的得分为 56.0%,领先于搭载 DeepSeek V4.1 Flash (max) 的 Codex(52.6%)、搭载 GPT-6.1 Sol (max) 的 Codex(49.4%)以及搭载 GPT-6 Astra (max) 的 Codex(49.3%)。在头部梯队之下,FrontierCode 的得分非常接近:指数中 24 种配置里有 15 种的得分集中在 43% 到 49% 之间。
➤ SWE-Atlas-QnA-AA 评分更严格且更具一致性:在两个版本指数中均进行评估的 21 种配置中,平均得分下降了 1.7 个百分点,从 58.8% 降至 57.1%,其中 14 种配置的得分有所下降。个别配置的变动幅度高达 7 个百分点:搭载 Muse Spark Open (xhigh) 的 Muse Code 下降 7.0 分,Kimi Code CLI 中的 Kimi K3 和搭载 GPT-6 Luna (max) 的 Codex 各下降 6.2 分,搭载 Muse Wonder (max) 的 Muse Code 下降 5.6 分;而搭载 GPT-6.1 Sol (max) 的 Codex 则上升了 2.1 分。
➤ 四种配置位于成本前沿:Codex 搭配 DeepSeek V4.1 Flash(max)以每任务 1.50 的成本获得 54.1 分,Codex 搭配 GPT-6 Astra(max)以 11.42 的成本获得 61.7 分。这些成本为按 token 计费的 API 成本,而非订阅价格。
我们将持续增量更新编码智能体指数(Coding Agent Index),后续将纳入更多评估和智能体。