Hacker News AI · 2026/10/7 18:08:38
AI 模型群体思维测试:中国模型更倾向共识,独立观点需显式提示
一项针对 12 个主流 AI 模型的“Top 3”推荐测试显示,中国模型在缺乏特定指令时更易顺应广泛共识,表现出显著的“群体思维”特征。该研究通过构建 Web 工具收集模型独立排名,发现默认设置下模型倾向于趋同,而明确要求“独立观点”的系统提示词能有效提升多样性。这一现象揭示了当前大模型在 RLHF 对齐过程中可能存在的过度顺从风险,对多智能体系统的去中心化决策设计具有警示意义。
报道全文原始报道全文
本文目录11 个章节
向多个 AI 模型征求可比较的观点,中国模型似乎更倾向于给出符合广泛共识的回答。
我最近构建/通过 vibe coding 开发了一个小型 Web 工具,它向由 12 个 AI 模型组成的评审团提出任何类型的“前三名”问题,并像奥运会奖牌榜一样统计答案。其理念是提供一种快速方式,获取关于从好书推荐、城市游玩建议到低风险购物决策等任何主题的“蜂群思维”(hivemind)推荐。
系统提示词很简单,围绕以下请求构建:
你正在回答一个排名问题,请提供你自己的独立观点。给出你的前 3 个答案,按从 1(最佳)到 3 的顺序排列。
该调用明确要求每个模型提供自己的看法,而不是猜测大众的想法。
需要进行一些标准化处理:如果我们询问爱尔兰最好的城堡,而 Luna 投票给 “Rock of Cashel”,Gemini 投票给 “Cashel Rock”,我们希望将其视为共识。该应用使用 Gemini Flash 来裁定此类情况。
结果——从顺从者到反叛者
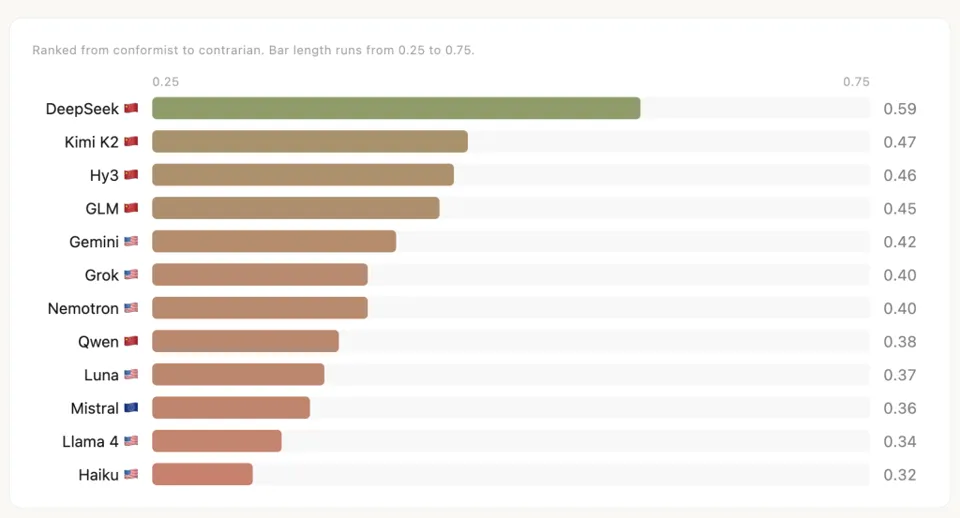
关于如何解读这张图表的一点说明。长条形和顶部的获胜者使其看起来像一个排行榜,仿佛更多的共识就是好事。但这并不一定如此。然而,在点击浏览了几个查询后:异常值响应更可能是有趣的,而不是那种优于其他所有模型响应的、具有深刻洞察力的正确回答。我喜欢 Gemini 建议你用赤陶色粉刷成人卧室,而其他所有模型都推荐绿色、奶油色和灰褐色(greige),但我理解许多人希望他们的机器人坚持文化主流,谢谢。
每个模型都根据其他十一个模型的共识进行评分:如果将正确的条目放在正确的领奖台位置,则获得满分;如果将正确的条目放在错误的位置,则获得半分。得分为 1.0 意味着与群体其余成员得出的获胜结论完全一致;得分为 0 则意味着彻底的反叛。
排名前四的顺从者全部是中国模型:DeepSeek、Kimi K2、腾讯的 Hy3 和 GLM。
按国家分组得分,差距依然存在。五个中国模型的平均分为 0.47,六个美国模型为 0.38,而欧洲唯一的参赛者 Mistral 得分为 0.36。
例外的是阿里巴巴的 Qwen,其得分为 0.38,位列美国模型阵营之中,仅落后于 Grok 和 Nemotron(均为 0.40)。而在另一端,最具逆向倾向的两个模型分别是 Meta 的 Llama 4 Scout(0.34)和 Anthropic 的 Claude Haiku(0.32)。
详细表格:
| 模型 | 开发商 | 地区 | 模型 ID | 发布时间 | 知识截止日期 | 推理模式 | 得分 |
|---|---|---|---|---|---|---|---|
| DeepSeek | DeepSeek | CN | deepseek-v4-flash-0731 | 2026-07 | 2025-05 | Default | 0.59 |
| Kimi K2 | Moonshot | CN | kimi-k2 | 2025-07 | 2024-12 | Default | 0.47 |
| Hy3 | Tencent | CN | hy3 | 2026-07 | Not published | Off | 0.46 |
| GLM | Zhipu AI | CN | glm-5.3-flash | 2026-08 | Not published | Off | 0.45 |
| Gemini | US | gemini-3.1-flash-lite | 2026-05 | 2025-01 | Default | 0.42 | |
| Grok | xAI | US | grok-4.3 | 2026-04 | 2025-12 | Off | 0.40 |
| Nemotron | NVIDIA | US | nemotron-3-super-120b-a12b | 2026-03 | 2025-06 | Off | 0.40 |
| Qwen | Alibaba | CN | qwen-plus | 2026-08 | 2025-03 | Default | 0.38 |
| Luna | OpenAI | US | gpt-5.6-luna | 2026-07 | 2026-02 | Off | 0.37 |
| Mistral | Mistral | EU | mistral-small-2603 | 2026-03 | 2024-11 | Default | 0.36 |
| Llama 4 | Meta | US | llama-4-scout | 2025-04 | 2024-08 | Default | 0.34 |
| Haiku | Anthropic | US | claude-haiku-4.5 | 2025-10 | 2025-02 | Off | 0.32 |
为什么中国模型的共识度更高?
我也不清楚。以下是我认为较为合理的几种解释,大致按可能性排序。
1. 蒸馏(Distillation)
蒸馏是指利用另一个模型的输出来训练新模型,本质上是一种克隆技术。包括 OpenAI 和 Anthropic 在内的美国实验室曾公开指控中国实验室大规模蒸馏其模型。今年早些时候,Anthropic 点名 DeepSeek 和 Kimi 的开发商 Moonshot(以及未包含在本次样本中的 MiniMax)针对 Claude 进行了大规模的蒸馏攻击。这并不能证实蒸馏导致了此处观察到的模式,甚至不能证明这些模型确实是通过这种方式训练的。但如果一个模型大量基于其他模型的输出进行训练,预期的结果之一是其偏好会与源模型趋同,尤其是在源模型本身也趋于一致的情况下。这样构建出来的模型在某种程度上就是一个“共识机器”。值得注意的是,在表格中排名第一和第二的 DeepSeek 和 Kimi,正是那些最常被卷入此类指控的实验室所开发的模型。
2. 中国模型之间的相互学习
中国开放权重生态系统紧密相连。实验室发布权重、公开方法,并使用彼此模型生成的合成数据进行训练。这可能使这五个中国模型呈现出某种“家族相似性”。
这一点之所以重要,是因为评分机制的运作方式。这里的十二个模型中有五个是中国的,因此如果它们共享一种风格,就会帮助构建用于评分的共识。一个投票一致的集团总会显得循规蹈矩。(Qwen 脱离这一集团是一个反例,或者至少表明这个“家族”并没有那么紧密。)
3. 模型规模与层级
表格底部挤满了更小、更便宜的模型:Llama 4 Scout、Claude Haiku 和 Mistral Small。较小的模型在记忆中保留的共同文化经典较少,因此它们的选择更为分散。Gemini Flash-Lite 和 DeepSeek 的 Flash 模型是反例,因此规模并非唯一因素。
4. 知识截止日期
大约 一半出现在可爬取 URL 上的新文本 是由人类撰写的,另一半由 AI 撰写。训练时间较近的模型阅读了更多此类低质内容(slop)。这里的大多数中国模型都是 2026 年中期发布的版本。同样存在反例:Kimi(知识截止至 2024-12)排名第二,而 Luna 拥有面板中最新的截止日期,却排名第九。
5. 后训练个性
也许美国实验室在后训练方面的投入赋予了模型更具特色的个性,以及选择不那么显而易见答案的意愿。如果在个性与刷榜(benchmark-maxxing)之间存在权衡,这也可能影响到另一面,即中国实验室可能更侧重于达成基准测试指标。
6. 英语经典语料库
所有提示词均为英文。其英语训练数据依赖于最广泛传播来源的模型,往往倾向于给出最符合规范的英语答案,而这正是共识所奖励的。
注意事项
仍需进一步工作,因为……
- 数据集规模较小。 该数据基于我个人使用的前几百个问题,以及部分从 Reddit 点击而来的真实用户。
- 评审小组构成具有任意性。 “正常”回答的衡量标准本身取决于评审小组的构成。6 个美国模型、5 个中国模型和 1 个欧洲模型的选择,是我根据对行业格局的主观判断做出的随意决定。更具实操性的决策包括:每个实验室最多选择一个模型,并避免使用高成本模型。合理的补充选项可能包括来自 MiniMax 和字节跳动的模型。若进一步考虑地域多样性,评审小组还可纳入 Aleph Alpha(德国)、Apertus(瑞士)、Cohere(加拿大)、Falcon(阿联酋)、Sarvam(印度)或 LG 的 Exaone(韩国)。此外,加入 Claude Sonnet 等旗舰模型,与低价位模型并列,也有助于揭示价格层级是否会产生影响。
- 一致性不等于准确性。 高分仅意味着某个模型的回答与其他模型一致,并不代表其正确。在“最佳”类问题上,往往根本不存在唯一正确答案。
- 问题以英语为主。 目前的问题倾向于英语使用者及西方视角。
结论
回到那个卧室配色推荐:
- 11 个模型推荐绿色、奶油色或灰米色(greige)
- 1 个模型推荐赤陶色(terracotta)
哪一种更“正确”?哪种行为是我们希望鼓励的?我怀疑大多数人并不想要一个陷入群体思维、如同博格人(Borg)般的 AI 生态系统。我们喜欢一点 Temperature(温度/随机性),希望模型之间存在分歧、带来惊喜,偶尔甚至坚持推荐赤陶色的卧室方案。同时我也认为,作为用户,我们往往倾向于奖励那些给出“安全”答案的模型。在未来几年内,巨额资金将把这两种本能推向对立面。
当这种动态扩展到数百万寻求建议的用户时,便演变为一种更大的现象:一种无声且持续的压力,推动形成由实验室主导的共识中间地带。
从商业角度看,跻身这一共识中间地带已极具价值。过去二十年,企业投入巨额资本以提升搜索引擎排名(SEO),而明智者已开始转向争夺在 AI 响应中的展示位置(AIO/GEO)。自我强化的反馈循环将进一步抬升这一“奖品”的价值。如果各实验室通过竞争相互提取对方的响应内容,那么使某产品在某一模型的回答中获得高位展示,就可能使其流入下一个模型的训练数据,进而再流入下一个……一旦共识被操纵过一次,它就会被不断复制,直至看起来像是关于世界的客观事实。
油漆颜色只是一个无害的切入点,但同样的机制也会回答关于该信任哪位候选人、哪个新闻来源可靠以及哪段历史真实的问题。显然,装饰建议并不等同于政治或事实判断,模型在不同领域中的表现也可能截然不同,但日益增多的正是同一套基础机制在中介所有这些决策。当模型相互复制观点并将这些观点反馈到现实世界时,共识无需正确,只需率先达成即可。
如需更多装饰或政治建议,你可以在这里向机器人寻求推荐。
链接
在此运行查询:top3.best
统计页面在此:top3.best stats page
模型数据参考:
- Claude Haiku 4.5 overview, Anthropic
- DeepSeek V4 Flash, model tracker
- GLM-5.3-Flash specifications, APIYI
- Hy3 launch coverage, Unite.AI
- Gemini 3.1 Flash-Lite, Google Cloud docs
- Grok 4.3, Vercel AI Gateway
- Nemotron 3 Super model card, NVIDIA
- Qwen-Plus, OpenRouter
- Mistral Small 4, OpenRouter
实现说明:这十二个模型均通过 OpenRouter 调用,主要使用其较便宜的“flash”或小参数变体,并在提供商允许的情况下关闭了推理功能。“Default”意味着模型以提供商默认提供的推理行为运行。我未调整 Temperature(温度)参数,也未探究不同模型所使用的默认设置。