Microsoft Research · 2026/10/7 16:00:00
微软开源 Agent Lightning v1.0:3500 行代码实现真实 Harness 智能体强化学习
微软亚洲研究院发布 Agent Lightning v1.0,这是一个仅约 3500 行代码的轻量级智能体强化学习框架。其核心突破在于“Harnessed Agentic RL”范式,允许直接使用部署时的真实 Agent Harness(如 mini-SWE-agent)参与训练,无需在训练框架中重新实现逻辑。该框架原生支持 Kubernetes,消除了对昂贵商业沙箱服务的依赖,显著降低了智能体 RL 训练的门槛与成本。
报道全文原始报道全文
本文目录7 个章节
概览
- Harnessed Agentic RL:微软亚洲研究院提出了一种新的训练范式,其中部署时使用的同一 agent harness 直接参与强化学习,从而无需在训练框架内重新实现 agent。
- 轻量级设计:Agent Lightning v1.0 以约 3,500 行代码实现了完整的 agent RL 控制平面。
- 原生 Kubernetes 支持:agent 可作为标准 Kubernetes job 运行于自建集群、云 Kubernetes 或本地基础设施上,无需依赖付费的商业沙箱服务。
- 数据高效训练方案:端到端的 coding agent pipeline 仅使用基于开源数据集的约 6,000 个训练样本,就将 Qwen3.5-9B 在 SWE-bench Verified 上的 Pass@1 从 41.8% 提升至 56.4%,提高了 14.6 个百分点。
AI agent 已从单一模型演变为由模型、工具和执行环境构成的复杂全栈系统。其能力越来越依赖于在模型外部协调各组件的 agent harness。强化学习(RL)是一种让 AI 系统通过试错进行学习的方法,其行为受到奖励和惩罚信号的引导。RL 可以提升 agent 的性能,但大多数 agent RL 系统要求开发者在训练框架内重新实现 agent。这不仅成本高昂,还导致被训练的 agent 与实际部署的 agent 存在差异。
为解决这一问题,微软亚洲研究院的研究人员提出了 Harnessed Agentic RL 训练范式,并开源了完全重构的 Agent Lightning v1.0 (opens in new tab)。与原版 Agent Lightning 相比,v1.0 更强调保持轻量级、集成真实 harness,以及构建完整且可复现的 agent RL 训练 pipeline。
Agent Lightning v1.0 围绕 Harnessed Agentic RL 进行了重构,主要改进包括:
- 轻量级:整个框架仅约 3,500 行代码。Agent Lightning v1.0 在一个小巧且清晰的代码库中实现了完整的 Harnessed Agentic RL(带代理的 Agent 强化学习)系统,便于理解、修改和扩展。
- 基于真实 Agent Harness 训练:在 Agent Lightning v1.0 中,Agent 通过大语言模型(LLM)代理与模型交互,无需改动现有的 harness 代码。
- 原生 Kubernetes 支持:Agent 可直接作为 Kubernetes Job 运行,无需依赖外部商业沙箱服务。无论是自管理集群还是本地基础设施,均可支持大规模 rollout。
- 完整的 Coding Agent 训练示例:基于 Qwen3.5-9B 构建的端到端流水线,仅使用约 6,000 个训练样本,便将 SWE-bench Verified 上的 Pass@1 从 41.8% 提升至 56.4%,绝对提升达 14.6 个百分点。
传统 Agentic RL 的局限性
传统的 Agentic RL 假设训练框架掌控着与环境的交互循环。在 ReAct 风格的循环中,模型生成动作,环境返回观测结果,观测结果被追加到上下文中,随后模型生成下一个动作,因此整个 rollout 映射为一条连续的 token 轨迹。早期的 RL 系统如 verl、AReaL 和 slime 均采用这种架构,这意味着若要训练 Agent,必须在 RL 框架内部重建其循环逻辑。
然而,真实的 harness 已超越了这一假设。诸如 mini-SWE-agent、OpenHands、OpenCode、Claude Code 和 Codex 等 coding agent,以及通用 Agent 系统,各自拥有独立的上下文管理、工具协议、执行逻辑和依赖关系。为训练目的而重建这些 Agent 成本高昂,且重建后的 Agent 行为可能与部署时的 Agent 不一致。
Agent Lightning 采取了不同的路径。它在 Agent 与模型之间插入了一个 LLM 代理。Agent 照常运行:只需将原本调用模型 API 的 endpoint 指向 Agent Lightning,训练框架即可观察并记录其模型调用。在 v1.0 版本中,研究人员进一步将该范式正式定义为 Harnessed Agentic RL:即部署时所使用的任何 Agent harness,在训练过程中都直接参与强化学习(图 1)。
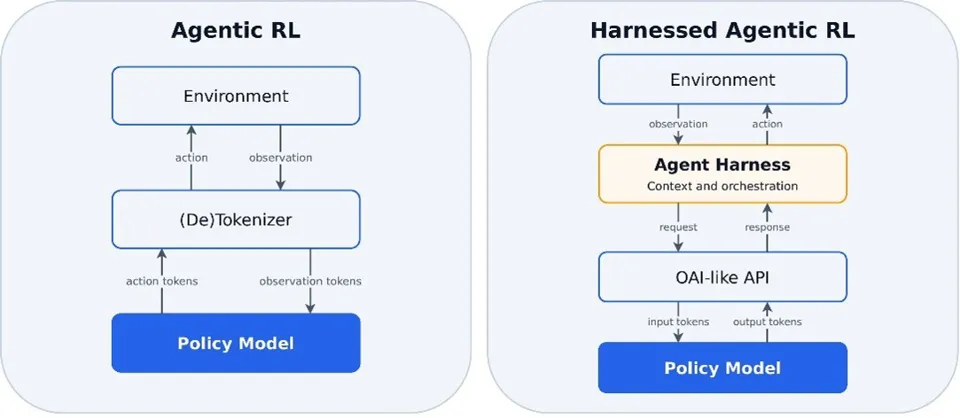
图 1. 传统智能体强化学习(Agentic RL)与带框架的智能体强化学习(Harnessed Agentic RL)对比。在传统智能体强化学习中,训练框架负责管理环境和智能体循环。而在带框架的智能体强化学习中,这两者均由框架(harness)管理。
使用真实框架进行训练的四大挑战
带框架的智能体强化学习与传统智能体强化学习的核心区别在于:环境交互循环由智能体框架而非训练框架处理。训练系统只能观察到一系列 LLM 的请求和响应对,因此单次 rollout 可能会被拆分为数量不定的训练样本。这带来了四个关键挑战:
- 重新分词与样本合并:框架以文本形式维护上下文,但 RL 训练需要的是 rollout 期间采样得到的 token ID。若将文本再次通过聊天模板和分词器处理,可能会导致 token 边界发生偏移,从而使得相邻调用无法总是合并为一个样本。
- 优势值计算:重新分词、子智能体以及上下文摘要等操作可能会将一次 rollout 拆分为多个样本。如果直接在样本层面计算基线和优势值,会导致产生更多样本的 rollout 被重复计数,进而改变 rollout 层面原有的统计关系。
- 损失归一化:按样本数量对损失取平均值,会赋予产生更多样本的 rollout 更高的权重。由于样本数量往往只是框架行为的结果,因此损失归一化也必须避免受到这种因素的扭曲。
- 训练后端调度:只有在框架执行完毕后才能确定样本的数量和长度,而 GPU 数量以及数据/张量并行配置通常是固定的。后端必须将可变的工作负载映射到固定资源上。
用 3,500 行代码构建完整的智能体 RL 控制平面
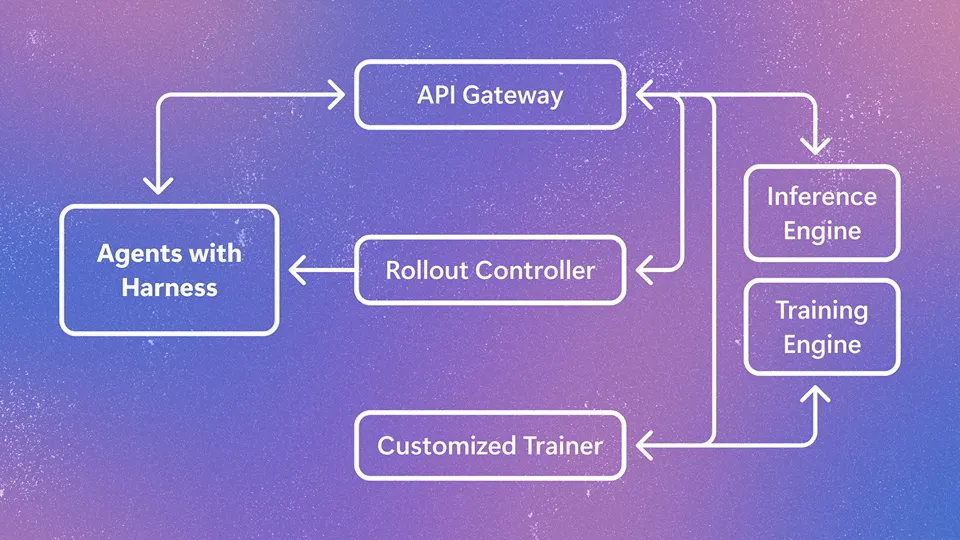
在系统设计中,Agent Lightning v1.0 将简洁性作为其首要原则。整个框架的代码量约为 3,500 行,包含三个核心组件:API Gateway、Rollout Controller 和 Customized Trainer(图 2)。
API Gateway 负责存储 rollouts、模型和事件,并充当兼容 OpenAI 的 LLM proxy。它将 harness 发出的每一次模型调用与其对应的 rollout 关联起来,并记录训练所需的 prompts、responses 和 log probabilities。Rollout Controller 负责启动和管理 agent 执行,既可作为本地进程运行,也可作为标准的 Kubernetes jobs 运行,从而将 agent 执行与 trainer 分离开来。Customized Trainer 基于 verl 构建,负责创建 rollouts、等待其完成、收集样本,并通过 sample adapter 组装最终的训练样本。因此,对于现有的 agent harness,通常只需将模型 endpoint 指向 Agent Lightning proxy,即可快速接入 RL 训练。

图 2. Agent Lightning v1.0 系统架构图,展示了 API gateway、rollout controller 和 customized trainer。
Collocated async RL
不同 agent 的 rollout 时间差异巨大。同步 RL 需要等待批次中最慢的 agent 完成,导致 GPU 空闲;而完全异步 RL 虽然提高了利用率,但需要为 rollout 和训练分别配置独立的 GPU 池。为此,Agent Lightning v1.0 引入了 Collocated Async RL,允许 rollout 和模型更新共享同一组 GPU。
当系统收集到足够多的 rollout 后,更新过程随即开始:API Gateway 暂停接收新请求,并等待正在处理的请求完成;待更新完成后,rollout 恢复进行。整个状态转换过程对外部 agent harness 完全透明。实验表明,该方法在端到端速度上相比同步 RL 实现了约 2 倍的加速,同时使用的 GPU 数量少于传统异步 RL(图 3)。

图 3. 同步 RL、异步 RL 与 Collocated Async RL 的对比。Collocated Async RL 在占用更少 GPU 的同时提升了利用率。
在 Kubernetes 上运行 agents
收集足够多的 rollout 意味着需要同时运行大量 agents,这会消耗大量的 CPU、内存和计算资源。其他 Harnessed Agentic RL 框架通常将这些 agents 托管在 Modal Sandbox 或 E2B 等商业沙箱服务上,随着规模扩大,成本迅速攀升。相比之下,Agent Lightning v1.0 将 agents 作为标准的 Kubernetes jobs 运行,复用现有的自管理集群、云 Kubernetes 或本地基础设施(图 4)。这种方式更高效地利用了现有计算资源,降低了大规模 rollout 的成本,并使整个流水线保持开源和可复现。

图 4. Agent Lightning v1.0 中的 Rollout Controller 提供原生 Kubernetes 支持,可直接将 agents 作为标准 Kubernetes jobs 运行。
6,000 个训练样本,性能提升 14.6 分
为验证该方法,研究人员基于 SWE-smith、mini-SWE-agent 和 Qwen3.5-9B 构建了完整流程,涵盖数据清洗、环境构建、奖励黑客(reward-hacking)防护措施以及强化学习(RL)训练。训练集包含约 6,000 个样本,无需大规模算力支持。仅通过 RL 训练,Qwen3.5-9B 在 SWE-bench Verified 上的表现就从 41.8% 提升至 56.4%,提高了 14.6 个百分点。
编码智能体实验进一步证实了此前对两大挑战的分析:优势计算与损失归一化。与样本级处理相比,结合 rollout 级优势与 rollout 级归一化的方法实现了更高的验证奖励,并在训练过程中保持了更稳定的策略熵(见图 5)。
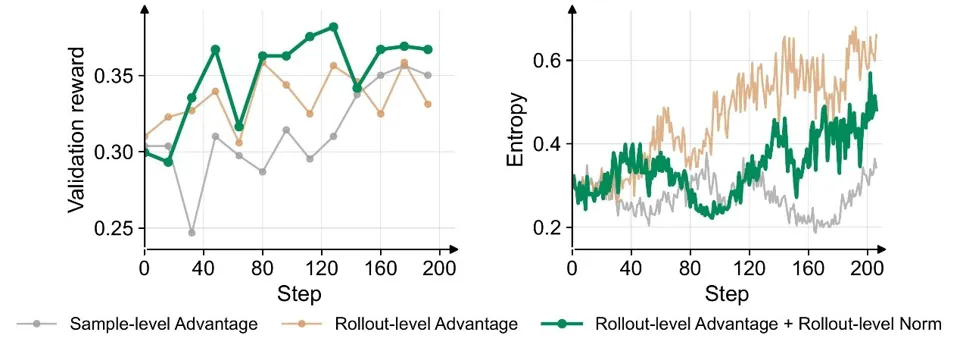
图 5. Qwen3.5-9B 在 SWE-smith 验证集上的通过率与策略熵。技术报告 GitHub 项目 在新标签页中打开
文章 Agent Lightning v1.0:一个仅 3,500 行代码的轻量级 Agentic RL 框架,用于在真实 Harness 环境中训练智能体 首发于 Microsoft Research。