Hugging Face Blog · 2026/10/8 08:00:00
Hugging Face 推出 ML Intern:自动蒸馏生成 0.8B 轻量模型,16 美元成本实现 CPU 端高效推理
Hugging Face 发布 AI 助手工具 ML Intern,用户可通过自然语言描述需求,自动完成从数据标注到模型蒸馏的全流程。该工具成功将 Qwen-Image 2.1 的 9B 提示词重写器蒸馏为 0.8B 版本,在保持 99.7% 有效输出率的同时,将内存需求降至可运行于 CPU 的水平,且总计算成本仅为 16 美元。这一案例展示了自动化模型定制在降低边缘部署门槛方面的巨大潜力。
报道全文原始报道全文
本文目录8 个章节
那个不存在的模型,于是你自己造了一个
发布于 2026 年 10 月 8 日 在 GitHub 上更新 点赞 - yuvraj sharma ysharma Abubakar Abid abidlabs
上周,我想要一个随 Qwen-Image 2.1 发布的 prompt rewriter 的小型版本。官方版本是一个 9B 参数的模型,需要约 20 GB 内存,并且在写出单个段落之前要处理数千个 token。在 Hub 上,我只找到了该 9B 模型的压缩副本。因此,我向 ML Intern 描述了我的需求,第二天我就拥有了一个可在 CPU 上运行的 0.8B 版本。它返回有效输出的概率为 99.7%,且使用的 token 数量约为教师模型的四分之一。整个项目的计算成本(包括让 9B 模型对 8,797 个示例请求进行标注)仅为 16 美元。
在接下来的几天里,我用同样的方法又制作了五个模型。每一个都始于 HuggingChat 中开启 ML-intern 模式的一条消息,并最终作为公开模型发布在 Hub 上,其评估结果也包含在模型卡片中。ML-intern 负责规划工作,在花费任何资源之前先向我询问预算,在执行正式任务前运行小规模测试,然后在 Hugging Face 硬件上进行训练、评估和发布。
我如何向 ML Intern 发送提示词
第一条消息是我投入精力的重点。对于下文分享的 citrus 模型,我的第一个提示词大约有 450 字。到了第 6 个项目时,提示词长度接近 2,000 字,因为每个项目都让我学到了希望应用到下一个项目中的经验。所有七个提示词均原样发布在 GitHub 上的 yvrjsharma/ml-intern-prompts 仓库中。
提示词以一句话概括想法及动机开头。随后明确列出具体组件:数据集、基础模型、训练脚本。任何我已经核实过的内容都会放在标题为“已验证事实,请勿重新推导”的部分下,这样智能体就能将预算用于实际工作,而不是重新发现我已知的信息。例如,在相机角度 LoRA 项目中,该部分列出了哪个 trainer 刚刚添加了对透明图像的支持,以及哪些未解决的 GitHub issue 使得回退 trainer 存在风险。
提示词中的两行内容至关重要。第一行要求在训练前建立基线。例如,柑橘病害提示词中写道:“同时报告基础模型在相同指标上的零样本得分(zero-shot score),以便我们观察训练带来的提升。”如果没有这一要求,你只会得到一个训练后的模型,却无从知晓它是否优于初始状态。第二行是附带检查项的冒烟测试(smoke test)。对于图像 LoRA 任务,我要求先进行 50 步训练,然后检查保存的权重是否确实发生了变化,再决定是否投入完整训练的成本。
在提示词的末尾,我会列出预期的交付成果并限制成本。我定义了模型卡(model card)中应包含的内容,并加入类似这样的指令:“总花费上限设为 12 美元,超出前需征得我的同意。”由于 ML-intern 每个任务的初始预算为零美元,且在执行付费作业前需要获得许可,因此该支出限额会被严格执行。如果你未指定预算,代理会根据项目规模提供几种方案供你选择。
1. 一个懂你领域的模型
通用视觉模型可以描述一片发黄的柑橘叶。然而,要判断这是螨虫问题还是缺镁症,并提供生物及非生物防治方法来治疗植株,则非常困难。利用 Claude,我从托管于 Hub 上 Project-AgML 组织的三个来源合并构建了一个训练数据集。生成的 citrus-disease-vlm-instruct 数据集包含 3,017 张标注图像,涵盖 21 种不同的害虫、疾病、营养缺乏症及治疗方法。ML-intern 使用这些样本对 Qwen3.5-2B 进行了微调,并确保事先对基础模型进行了基准测试(benchmark)。
在 335 张测试照片上,基础模型正确识别问题的比例仅为 14.9%。在单块 A10G GPU 上经过两个 epoch 的训练后,微调模型的准确率提升至 52.8%。计算成本约为 1.90 美元。
2. 一个能绘制你角色的模型
图像模型熟知众多角色。但采用 Hugging Face 品牌资产扁平风格绘制的 Huggy,并不在其中。我要求 ML-Intern 基于 FLUX.2 klein base 4B 训练一个 LoRA,使用了来自 Chunte/huggy_for_training 数据集的 84 张带标注绘图。
该智能体每 100 步保存一次检查点,并用每个检查点生成同一组提示词,这使得选择最佳模型变得容易。第 200 步是 Huggy 首次完全 符合预期风格 的时刻。从第 500 步开始,Huggy 的风格开始渗入那些与 Huggy 毫无关系的提示词中!训练好的 LoRA 在蒸馏后的 klein 模型上仅需 4 步即可生效。计算成本约为 7.60 美元。
查看:模型 · 数据集 · Huggy 生成器应用
3. 掌握新技巧的模型
- 相机角度 LoRA 是早期 Qwen-Image 模型社区中最受欢迎的附加组件之一。你可以给模型一张物体图片,并要求它展示从左侧 45 度角观看的效果。在 Qwen-Image 2.1 模型发布几天后,我发现还没有人制作此类 LoRA,因此我指派 ML-intern 来构建它。
ML-intern 使用 CPU 任务(成本仅几分钱),将 Google Scanned Objects 中的 1,030 个扫描家居物品以每个物品 24 个角度进行渲染,生成了 24,722 张透明背景图像。随后,它确定了 461 个物品用于训练,保留 40 个用于测试,并均匀分布在 23 种相机指令下生成了 1,844 对训练前后对比图。
训练在一个 A100 GPU 上运行了 2,000 步,耗时约 90 分钟(约 3.75 美元)。整个项目耗时约半天,共执行了 48 个任务,其中包括因缺少包或路径错误而失败并由 ML-Intern 重新提交的任务。总计算成本约为 16 美元。
- Doodle-in LoRA 是另一个很酷的想法。上传一张带有品红色涂鸦的照片,并添加一个简短的提示词来命名某个物体。LoRA 会将涂鸦替换为该物体,同时保持原始的光照和构图一致性。
此前并不存在相关数据集,因此我的提示词描述了如何构建这样一个数据集。从 Open Images 中的真实照片开始,使用 LaMa 修复模型移除其中一个物体,并在原物体位置绘制涂鸦。未经修改的照片作为目标图像。ML-intern 在 CPU 沙箱中编写并测试了配对生成脚本,随后将其作为 GPU 任务运行,在此过程中记录了每张源照片的作者和许可证信息。最终构建了 6,042 个训练对和一个包含 160 对的测试集,其中 40 个测试对来自完全未参与训练的 23 个物体类别。
在训练前,它分别测量了基础模型单独运行以及结合 Viggle turbo LoRA 时的表现,并验证了批量运行编辑能产生完全相同的图像,从而降低了评估成本。训练在单张 A100 上运行了 2,000 步,耗时 1 小时 38 分钟(约 4 美元),并通过在 48 个测试对上比较保存的检查点,选定了第 500 步。
与 Viggle turbo LoRA 配合使用,仅需 6 步推理,该 LoRA 表现非常出色。67.5% 的物体被准确检测在其绘制位置,每次编辑耗时 4.7 秒。来自 23 个未见类别的物体落地可靠性与其他类别相当(65.0% 对比 64.2%)。整个项目耗时略超一天,共执行了 59 个任务。总计算成本约为 24 美元。
查看:模型 · 数据集 · Doodle-in 应用
4. 适配你设备的模型
- 本文开头提到的 Pocket Rewriter 就是第一个例子。ML-intern 首先通过 Inference Providers 使用小型指令模型生成了 8,797 条简短的图像请求提示,遵循我在提示词中设定的混合比例:包括照片、海报、标志、信息图等,其中约三分之一要求精确引用文本,且许多为非英语语言。随后,9B 教师模型在单张 A100 上于 2 小时 37 分钟内(约 6.50 美元)重写了所有这些提示。经过质量过滤后,筛选出 1,840 个样本用于训练数据集。
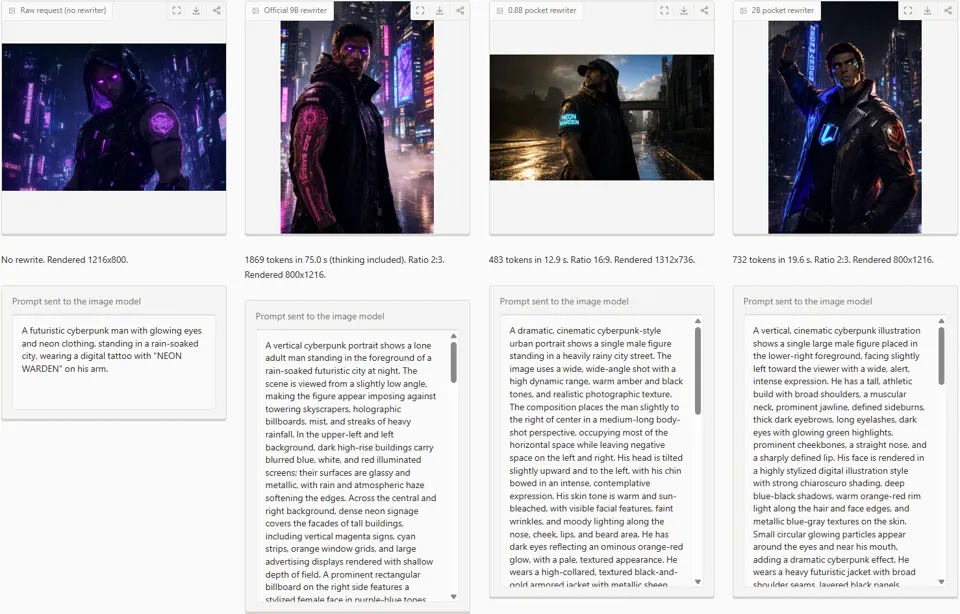
训练 0.8B 和 2B 学生模型在 A10G 上分别耗时 12 分钟和 18 分钟(两者总费用为 0.75 美元)。0.8B 模型还提供了一个 812 MB 的 GGUF 文件,以便在 CPU 上运行。整个项目耗时约 11 小时,共执行了 24 个任务。总算力成本约为 16 美元。
查看:Pocket rewriter 0.8B Student · 2B Student · Dataset · Pocket Studio App · Compare the teacher-student in Rewriter Arena
- Agate-Preview-002-4step 是第二个案例。Logolabs' Agate Preview 002 是一个拥有 2.6 亿参数的文本生成图像模型,足够小巧以在浏览器中运行,但它需要 50 步并带有引导机制,这意味着每张图像需要进行 100 次网络前向传播。我请求 ML-intern 将其蒸馏至仅需 4 次前向传播!
这经历了两次训练运行。第一次运行将 155,000 张训练图像缓存为 latent 表示,将引导机制烘焙进模型中,然后在 A100 GPU 上将步数分阶段从 16 步减少到 8 步,再到 4 步。在相同的 4 步设置下,4 步学生模型在 GenEval 和 FID 指标上均优于教师模型,随后 ML-intern 将其导出为 ONNX 格式以支持浏览器运行。这次运行耗时约 13 小时,成本为 22 美元。
我进行了第二次训练运行,要求 ML-Intern 进一步优化这个 4 步学生模型。它使用 16 步的教师模型生成了额外的 24,000 对图像,并用这些数据对 4 步学生模型进行了约一小时的微调。GenEval 分数从 0.509 提升至 0.536,而教师模型在 50 步下的分数为 0.563,我们仅用 4 步(四分之一的算力)就达到了接近的效果。ML-intern 重新导出了浏览器版本。第二次运行耗时约 8 小时。两次运行的总算力成本约为 37 美元。
查看:Agate 4-step model · Dataset · Run Agate in your browser · Agate 4-step LIVE
成本明细
| 模型 | 基础模型 | 计算成本 |
|---|---|---|
| Citrus Doctor | Qwen3.5-2B | 1.90 美元 |
| Huggy LoRA | FLUX.2 klein base 4B | 7.60 美元 |
| Pocket rewriter(0.8B 和 2B) | Qwen3.5-0.8B 和 2B | 16.05 美元 |
| Viewpoint Orbit LoRA | Qwen-Image 2.1 | 16 美元 |
| Doodle-in LoRA | Qwen-Image 2.1 | 24.30 美元 |
| Agate 4-step(两次运行) | Agate Preview 002 | 37 美元 |
| 总计 | 约 103 美元 |
以上为每个会话报告的 GPU 和 CPU 作业费用。
打造属于你的模型
ML-intern 已集成至 HuggingChat。开启 ML-intern 模式并粘贴提示词即可使用。如果你需要一个起点,可以免费复制我的示例提示词。从一个你希望存在的模型和一个你拥有或能描述的数据集开始。设定一个较小的预算,要求提供基线模型和冒烟测试,并在提高预算上限之前仔细阅读返回的结果。
如果你用它做出了什么成果,请在 X 上分享并标记 @Gradio 和 @HuggingFace。我们非常乐意看到那些别人不会想到为你构建的、由你亲手打造的模型。