Qwen3.5-LiveTranslate Launches with 60-Language Support and Voice Cloning
The Qwen team released Qwen3.5-LiveTranslate-Flash, a multimodal simultaneous interpretation model built on Qwen3.5-Omni. It expands language coverage to 60 languages (with voice output for 29), achieves an end-to-end latency of 2.8 seconds per word via new 'Readable Unit' streaming technology, and introduces real-time voice cloning and hotword enhancement for improved accuracy in professional scenarios.
Related Entities
Full Report
Contents15 sections
Qwen3.5-LiveTranslate-Flash 是 Qwen 家族最新的同声传译模型,基于 Qwen3.5-Omni 构建。它提供实时、多模态翻译能力,不仅能够听懂并翻译语音,还能看见并理解视觉上下文,从而产出更准确的译文。与前代模型 Qwen3-LiveTranslate 相比,Qwen3.5-LiveTranslate-Flash 在语言覆盖范围、翻译延迟、声音克隆和术语处理等方面均有重大升级,非常适用于跨国会议、直播本地化、在线课堂和商务谈判等场景。
核心亮点#
- 多语种覆盖升级:能听懂和翻译60种语言,其中29种可以实现语音输出。 输入音频和输出文本语种从 18 个大幅提升至 60 个,输出音频语向从 10 个提升至 29 个,覆盖更多国家与区域的语言互译组合,满足跨境会议、直播出海、在线课堂、商务谈判等多语同传需求。
- 超低延迟:可读单元技术驱动,更快出字、更快出声。 引入全新的可读单元(Readable Unit)实时翻译技术,在保证译文可读性与语义一致性的同时实现更激进的流式输出。端到端字均延迟降低到 2.8 秒,适用于直播、连麦、发布会等对时延极敏感的场景。
- 实时音色克隆:一句开声,即刻"用你的声音同传"。 同传过程中自动复刻说话人的音色特征,让译文语音在不同语言间保持"同一个人"的声音质感与表现力,提升沉浸感与身份一致性,对主播、嘉宾、主持人尤为关键。
- 热词增强:专有名词与行业术语"说对、写对、翻对"。 内置热词(Hotword)能力,对人名、地名、品牌名、产品型号、行业术语进行优先识别与翻译,可按场景动态配置与实时更新,显著降低术语误译风险,适合技术发布会、医疗/法律/金融会议、企业内训等专业场景。
性能表现#
我们在离线和实时(流式)两种设置下对 Qwen3.5-LiveTranslate-Flash 进行了评测。
离线翻译#
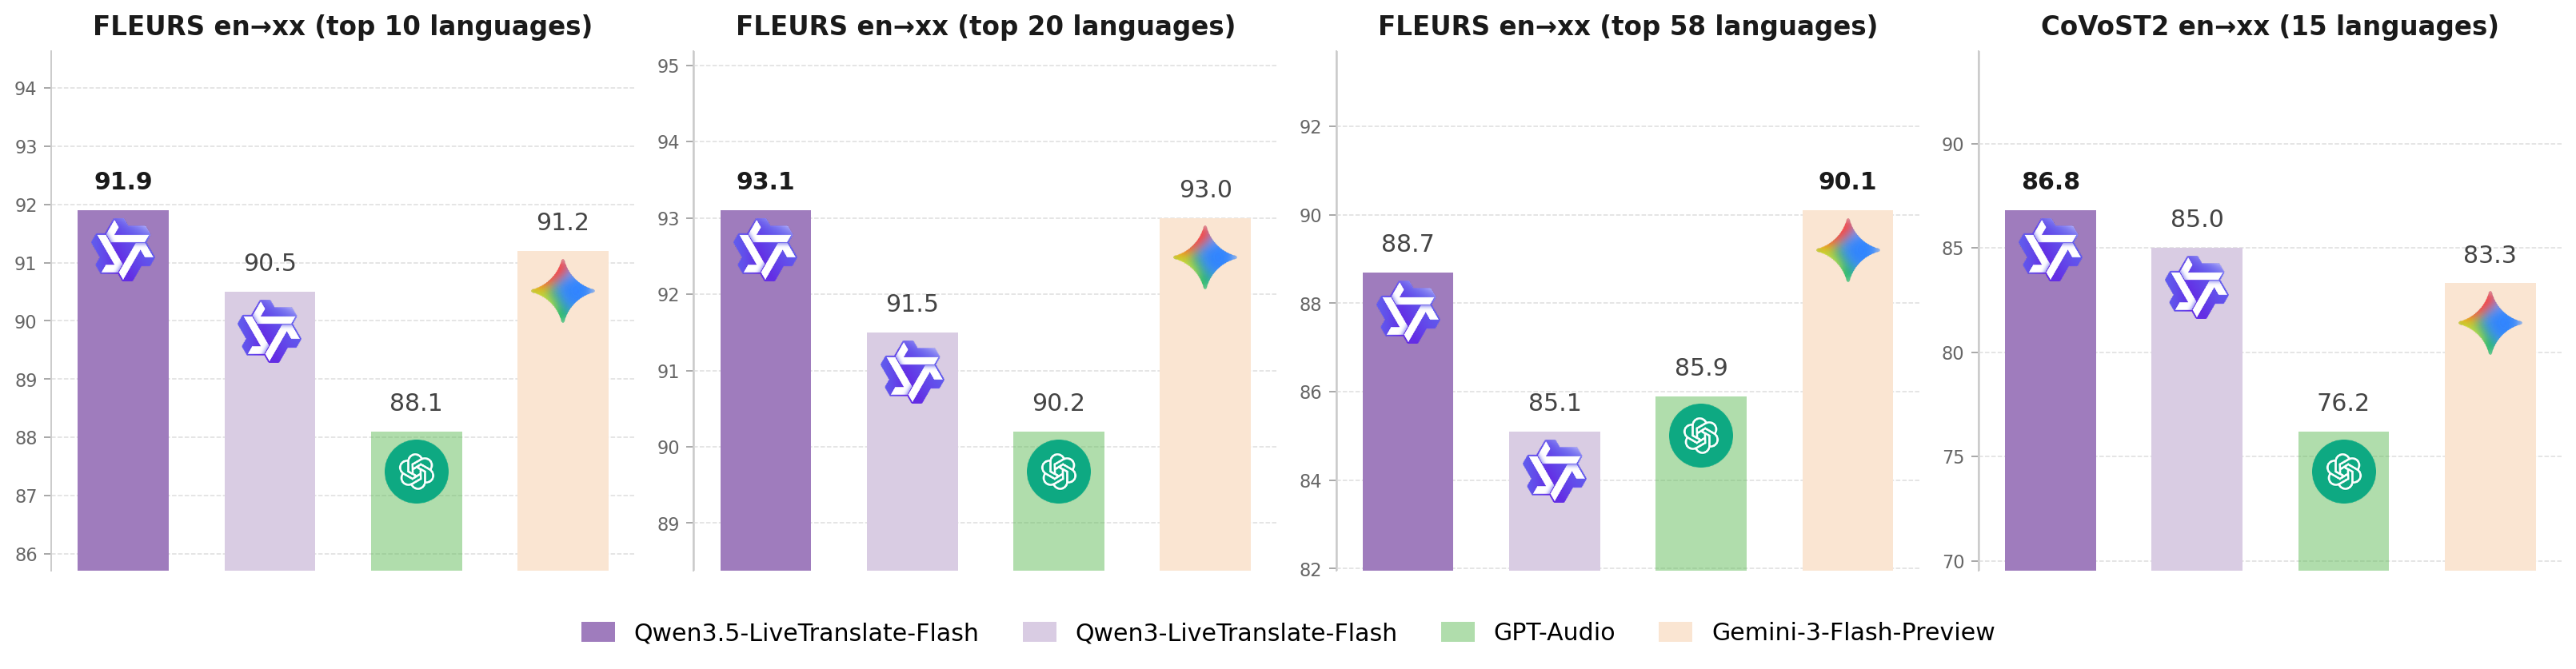
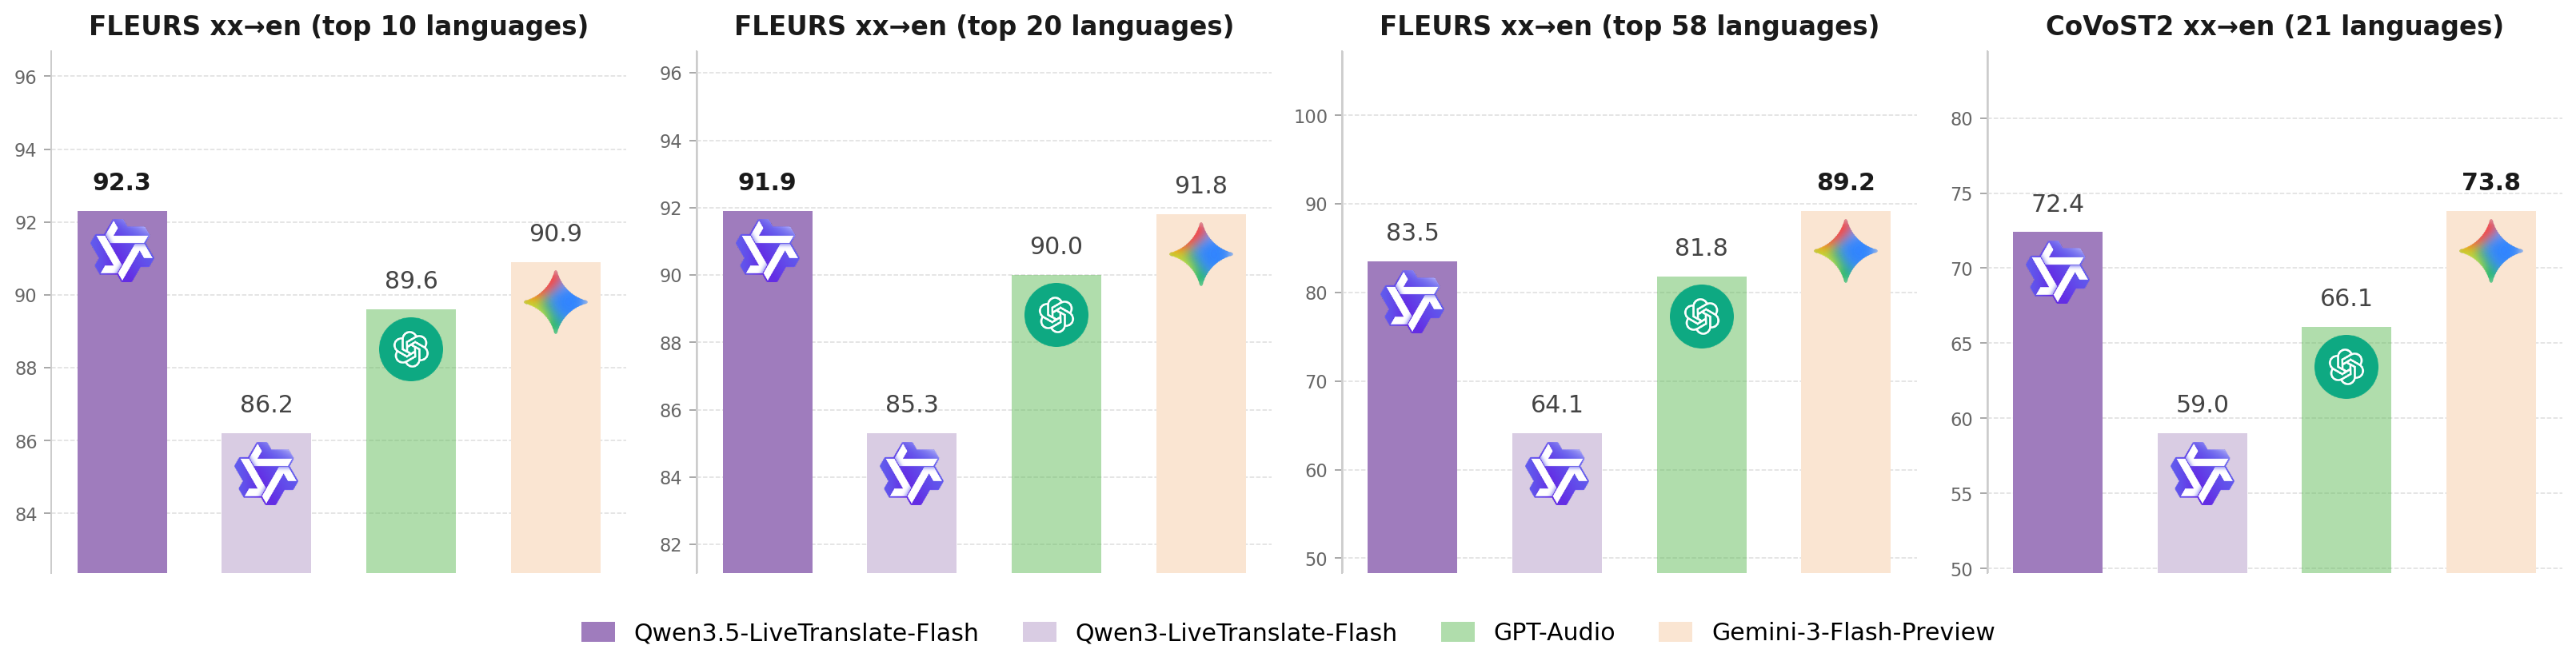
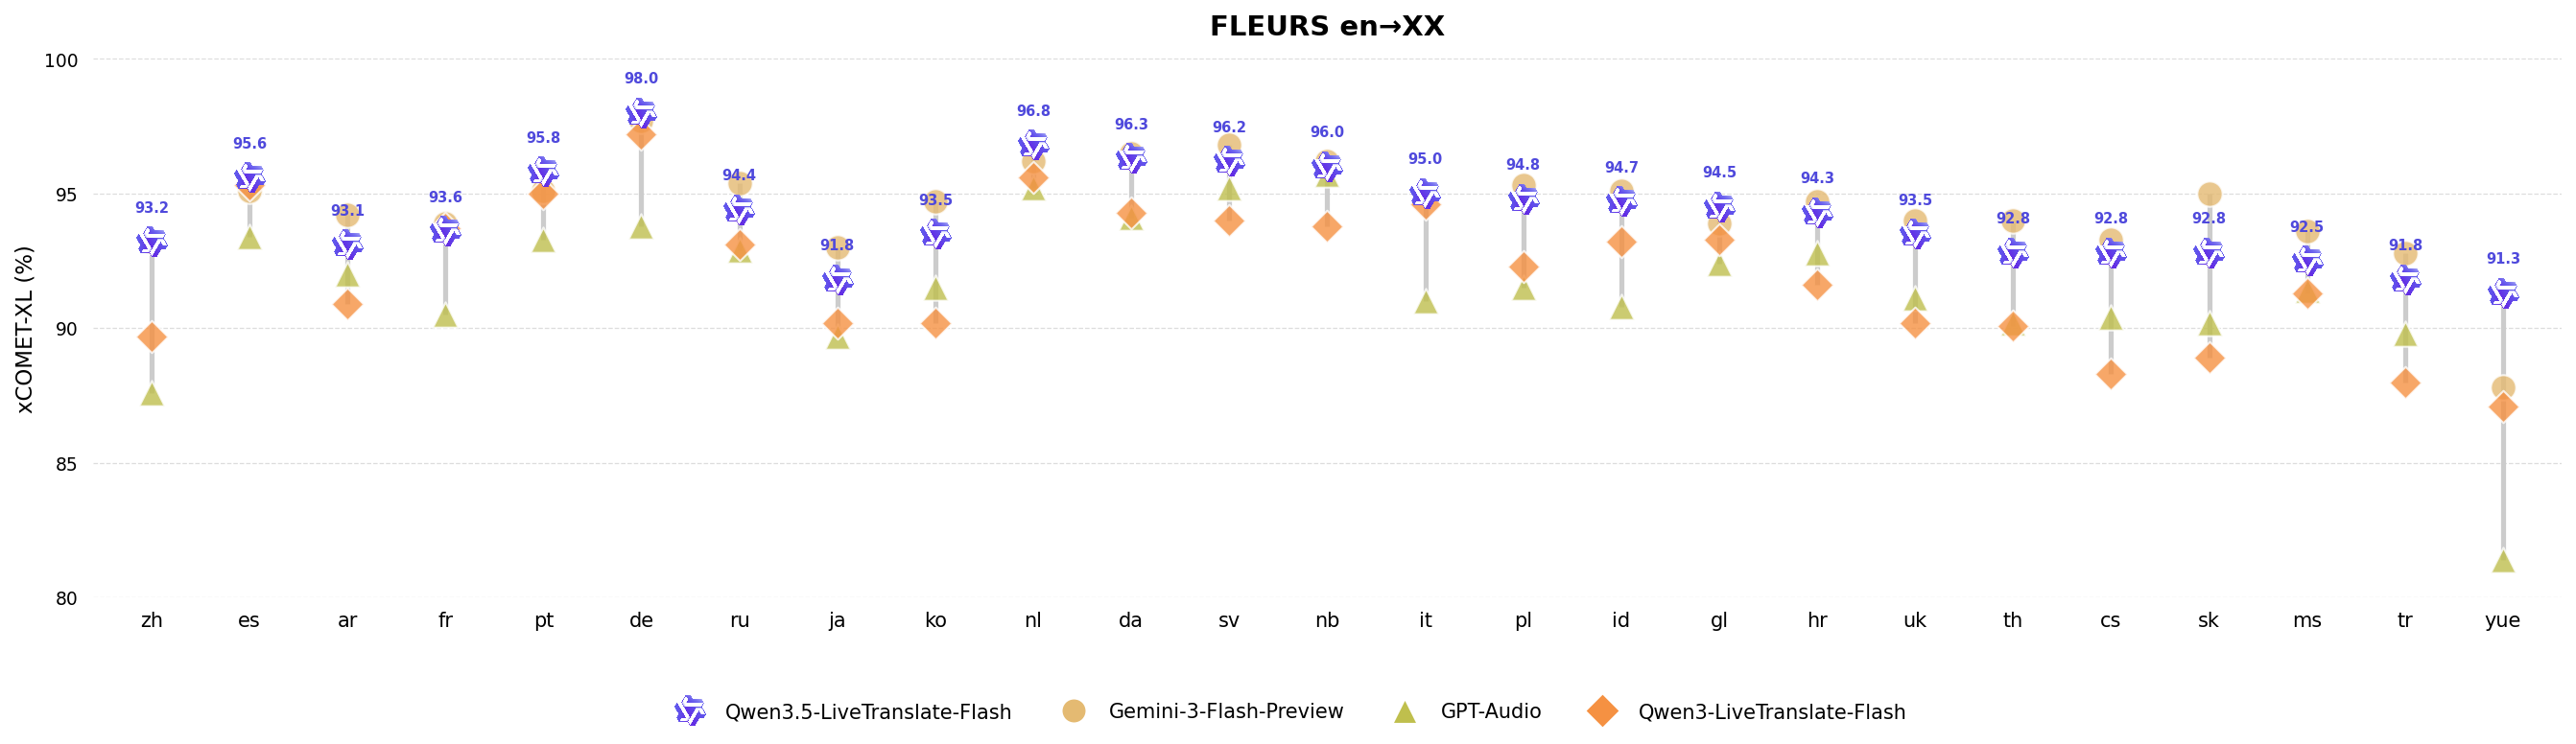
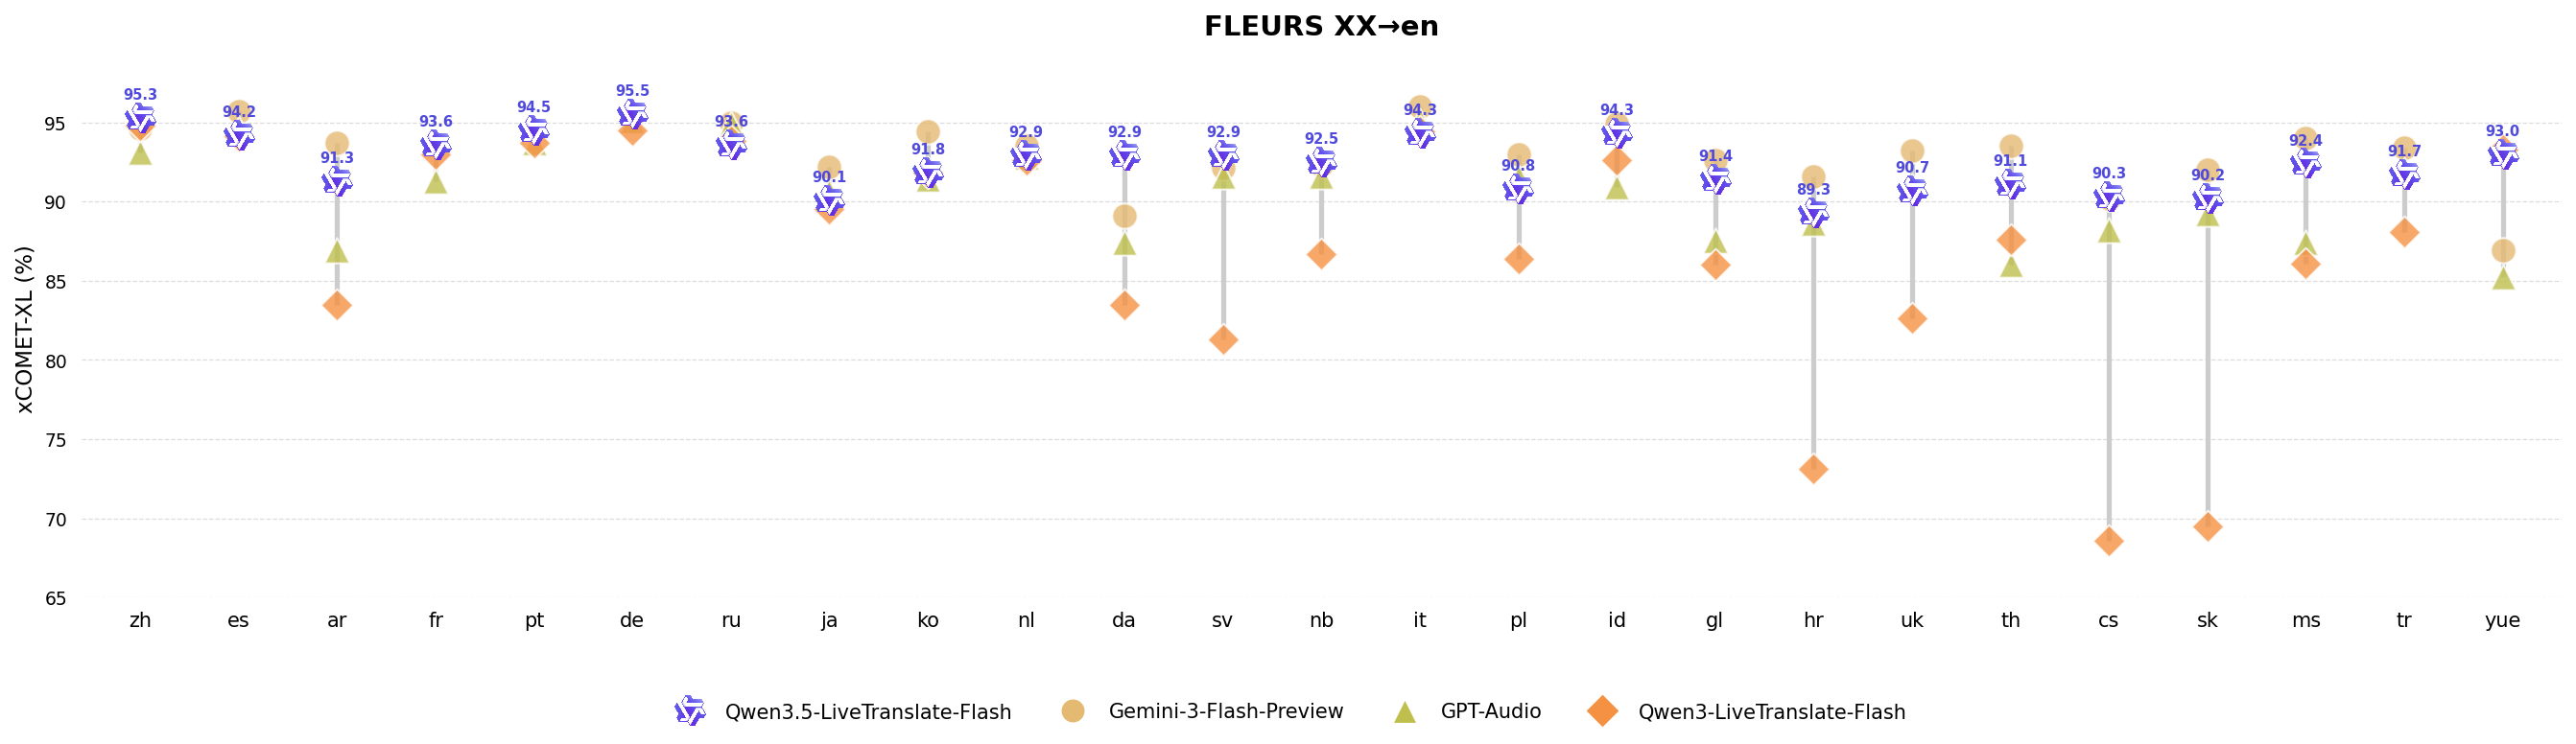
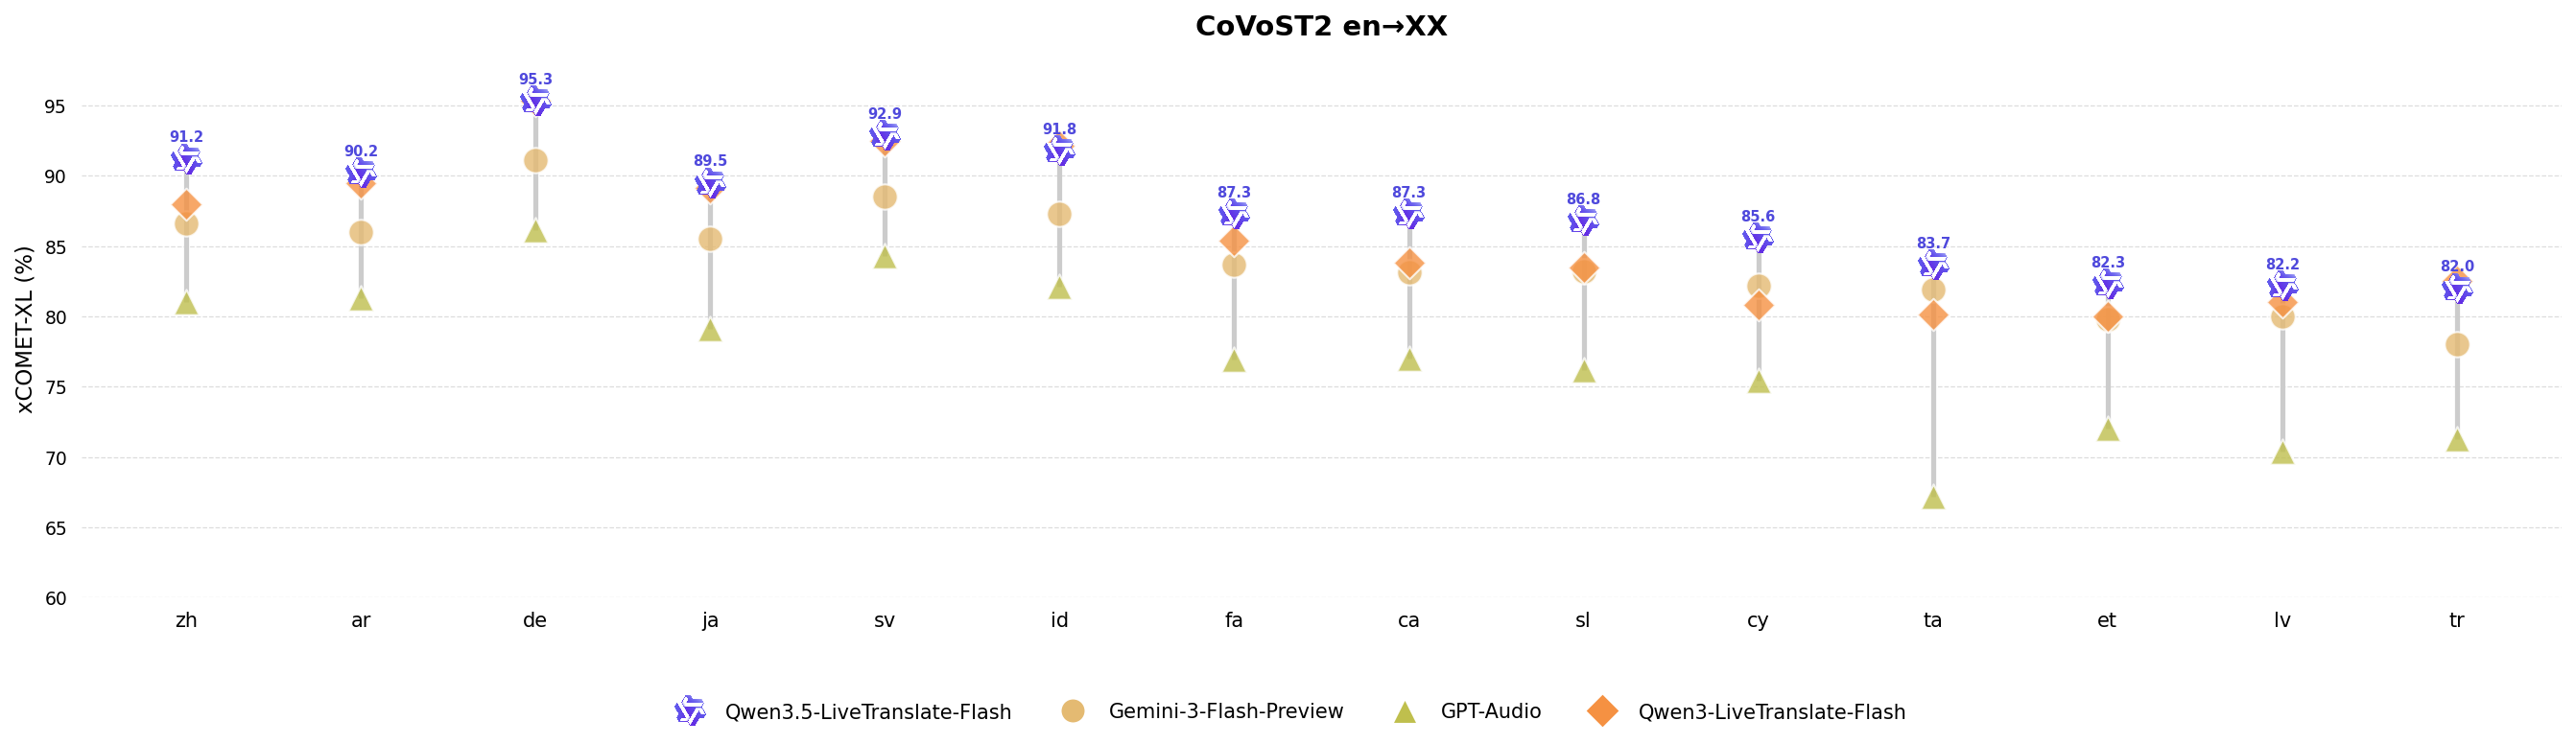
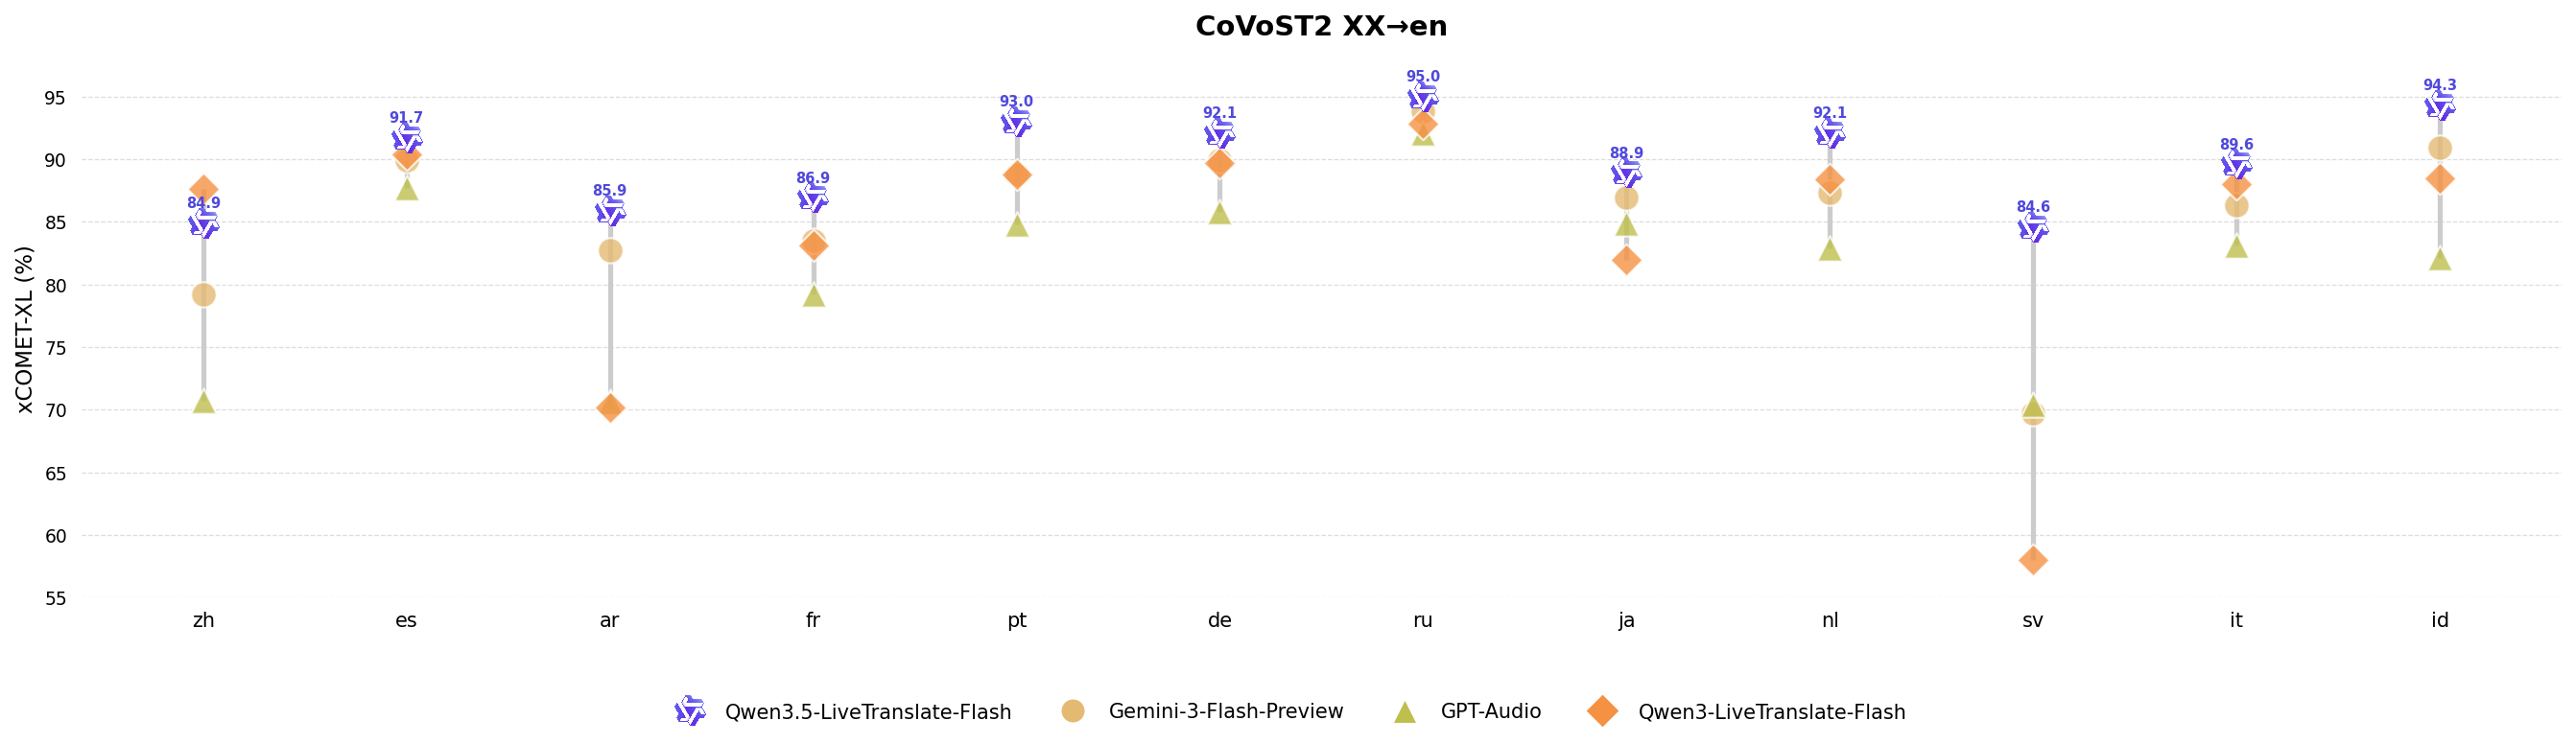
在公开多语言语音翻译基准(FLEURS、CoVoST2)上,Qwen3.5-LiveTranslate-Flash 翻译准确率优于当前主流语音大模型,显著优于前代 Qwen3-LiveTranslate-Flash,在语言覆盖和翻译质量上均实现突破。
总览 英语 → X Next
总览 X → 英语 Next
FLEURS 英语 → X Next
FLEURS X → 英语 Next
CoVoST2 英语 → X Next
CoVoST2 X → 英语 Next
实时翻译#
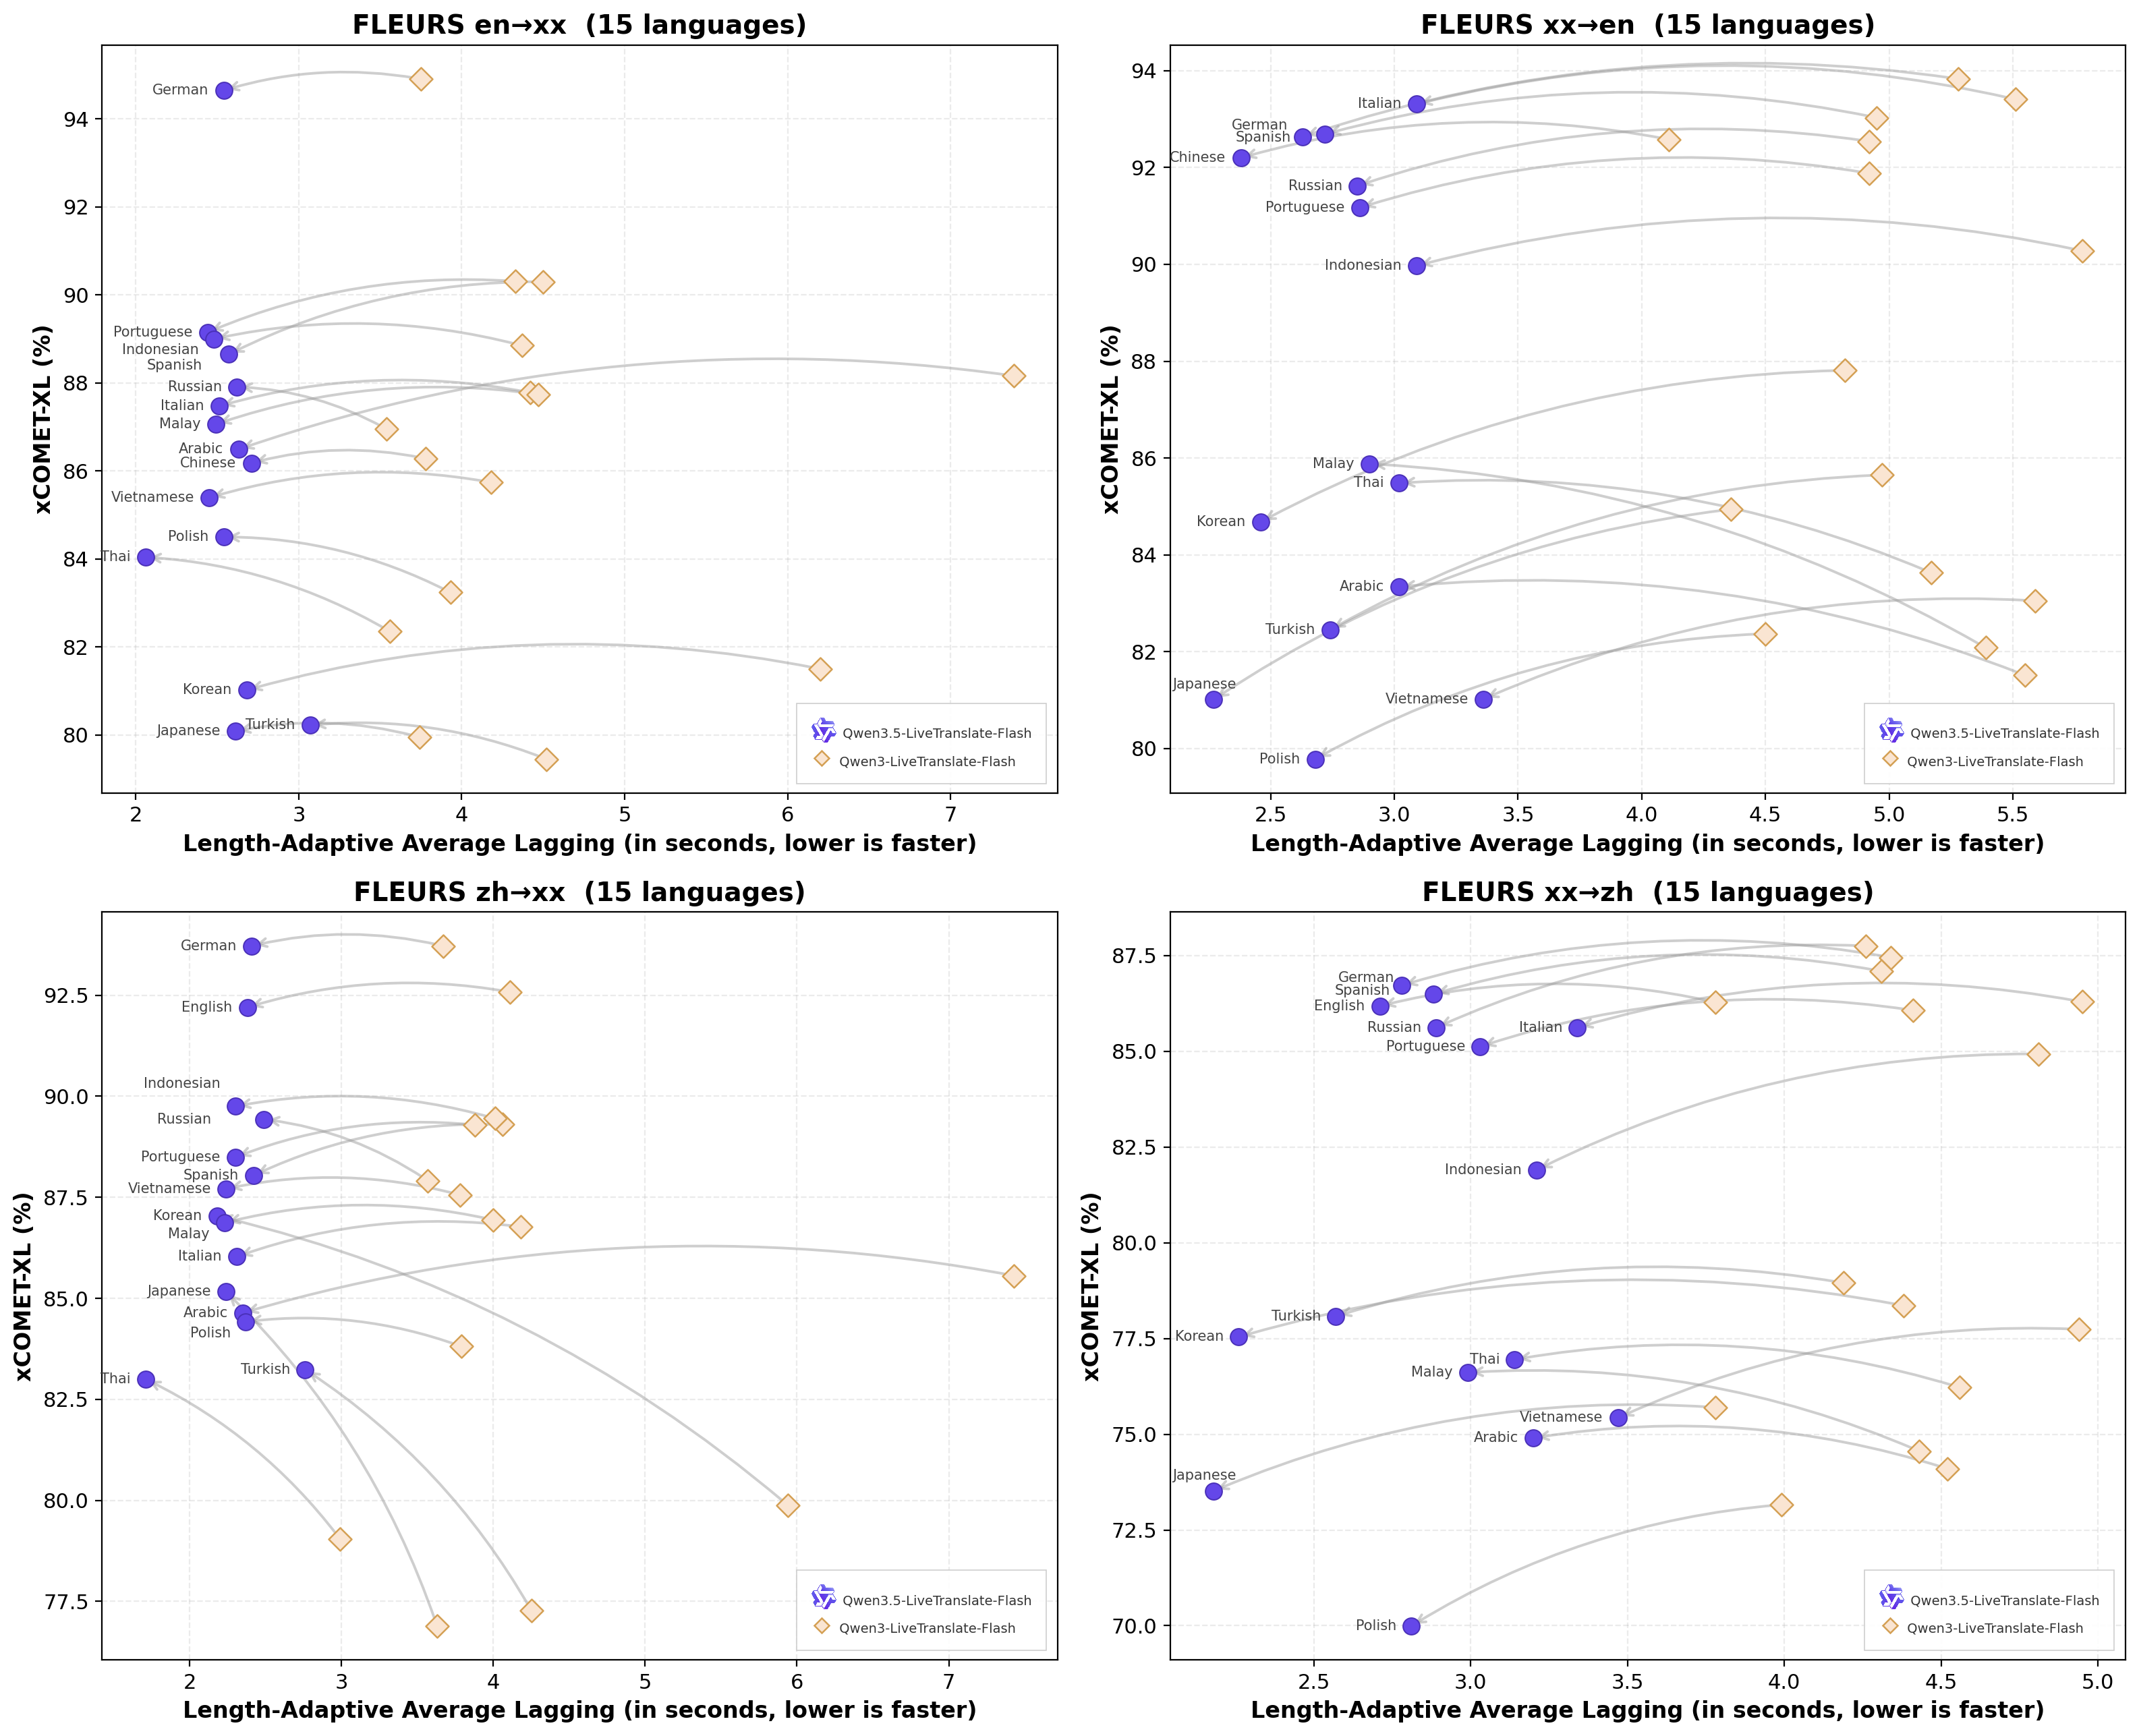
凭借可读单元流式策略,Qwen3.5-LiveTranslate-Flash 相比 Qwen3-LiveTranslate-Flash 将首字延迟降低 3.45 秒、字均延迟降低 1.88 秒,最终实现端到端字均延迟 2.8 秒,翻译质量几乎无损。
总览 Next
模型架构#
Qwen3.5-LiveTranslate 是基于 Qwen3.5-Omni Thinker-Talker 架构打造的翻译大模型。其中,Thinker 负责接收交错编排的视觉与音频输入,并生成文本译文;Talker 则基于译文文本和源音频输入,完成跨语言音色复刻的语音合成。面向实时同声传译场景,我们采用 chunk-wise 流式输入机制,并引入可读单元标签来控制语音合成粒度,从而有效降低同传时延。同时,借助动态跨语言音色克隆技术,模型能够在实时翻译过程中尽可能保留说话人的原始音色特征。
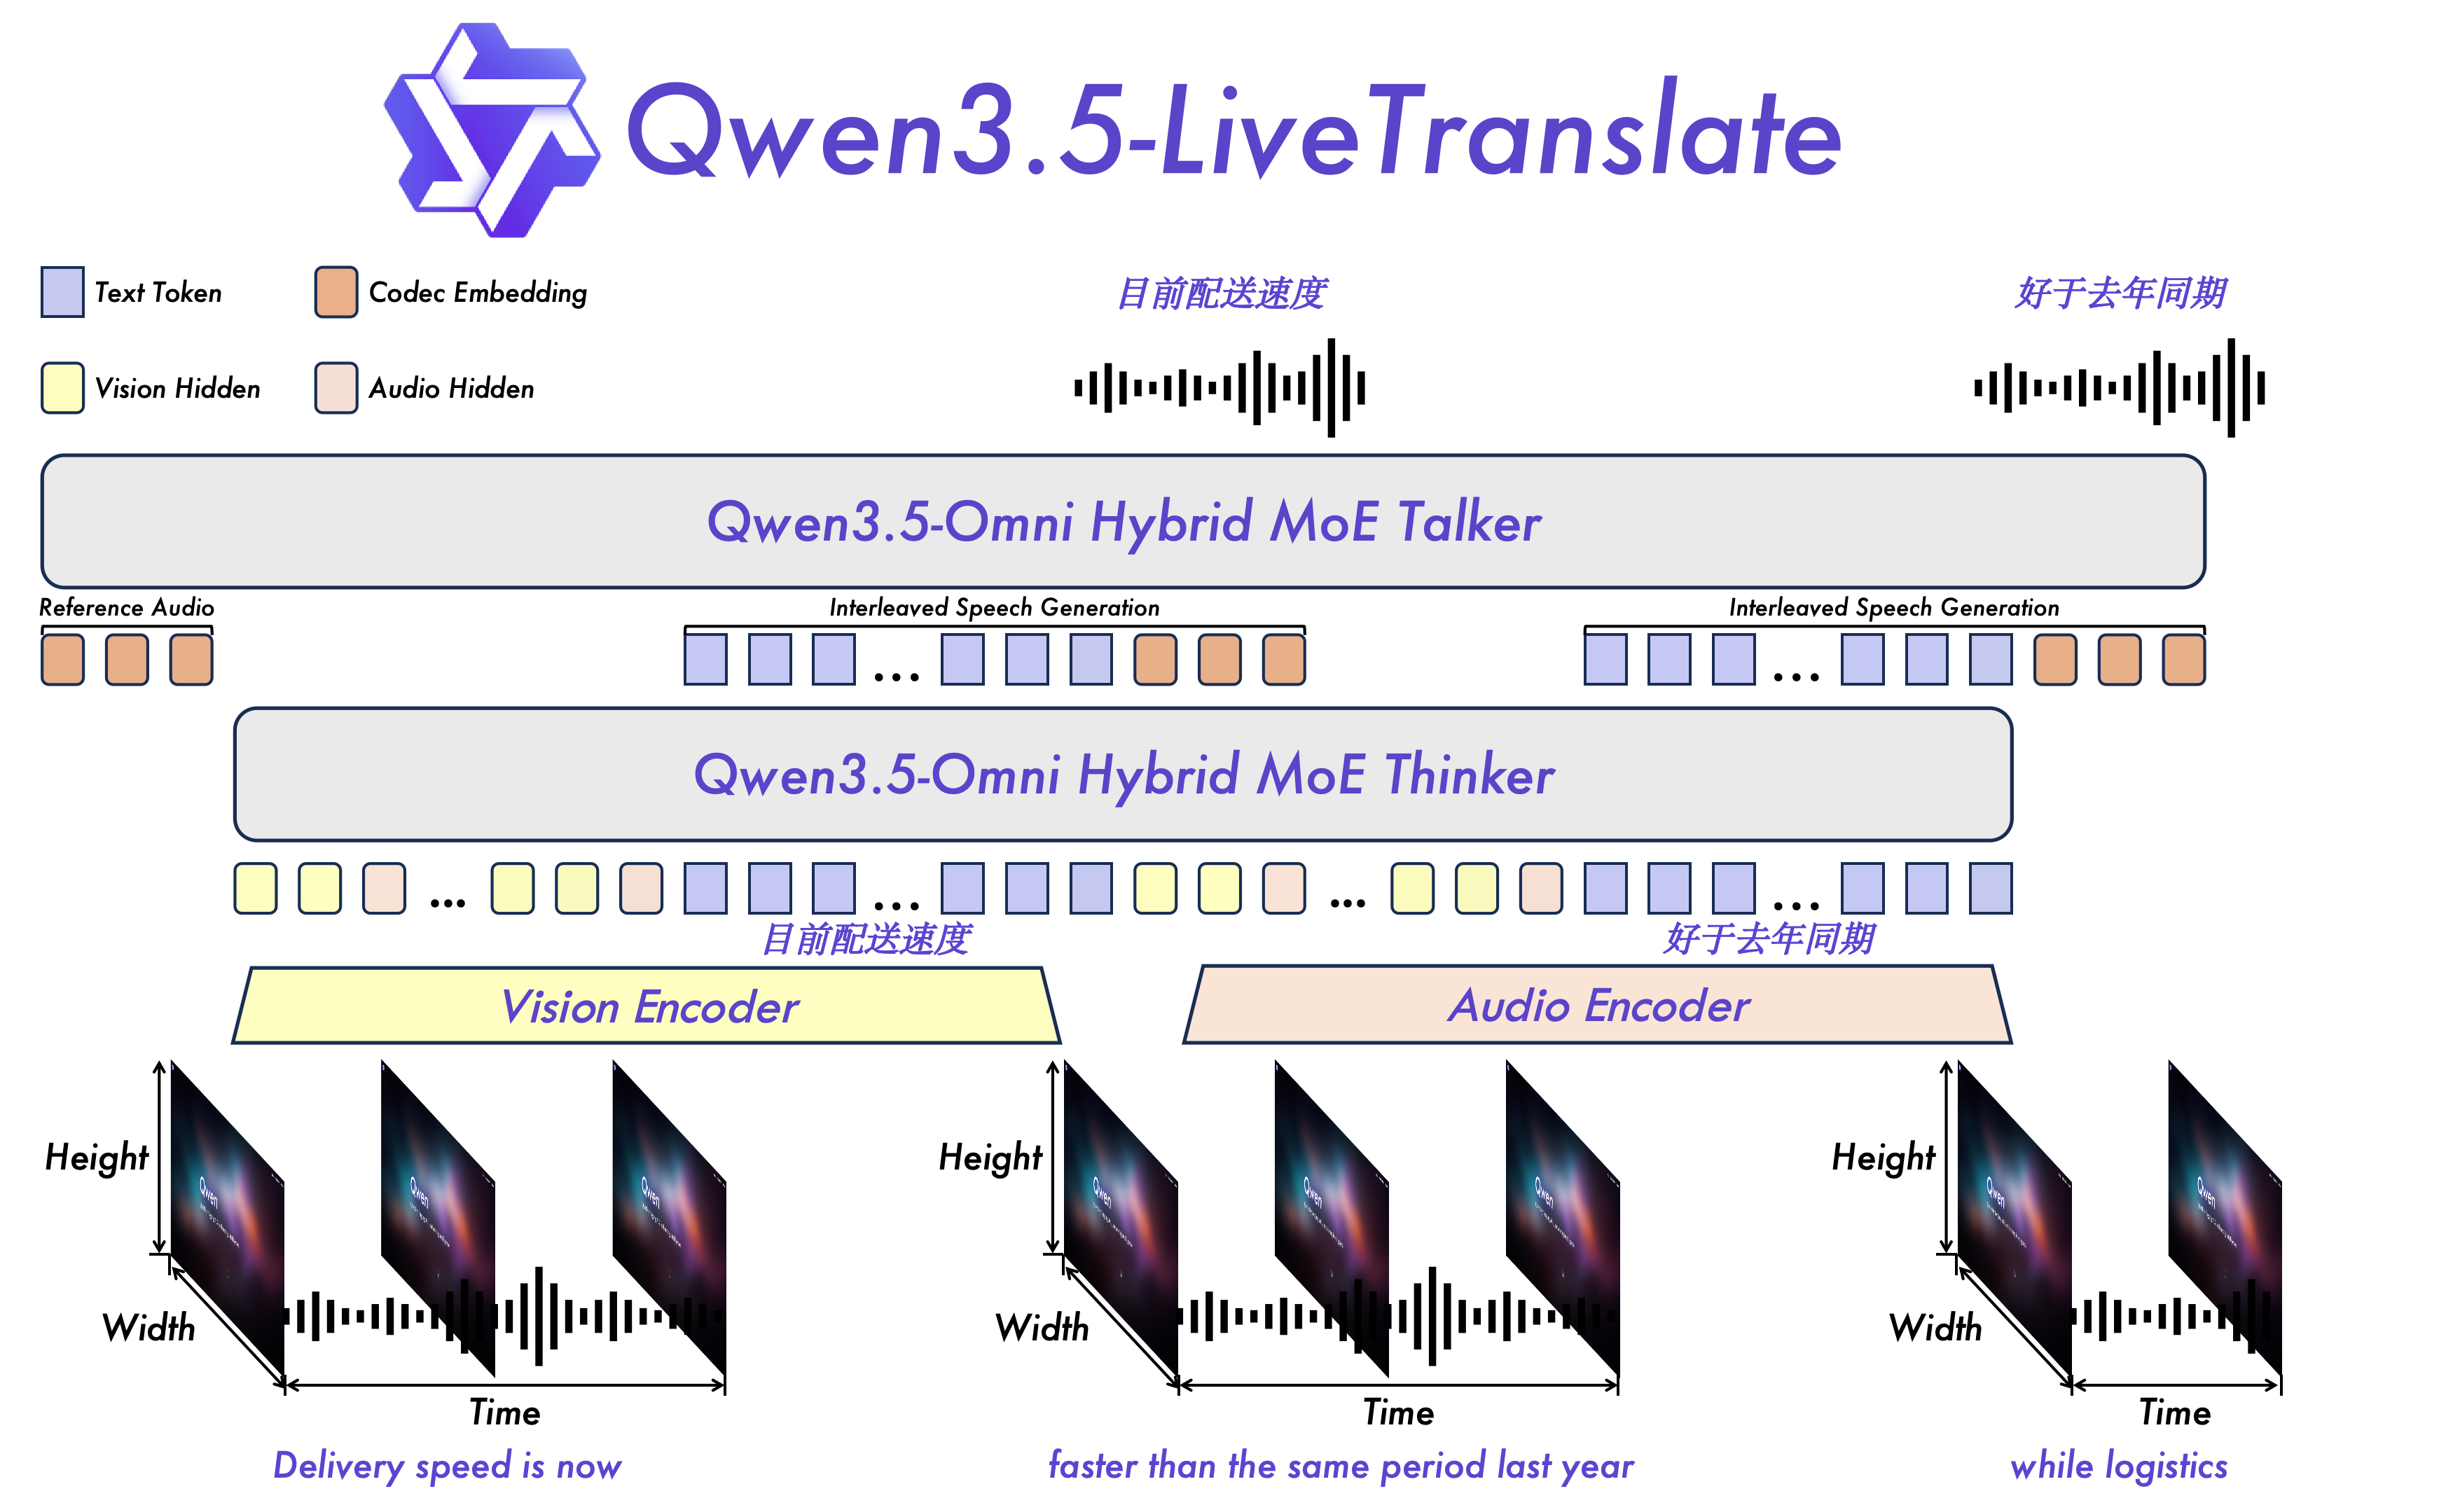
Qwen3.5-LiveTranslate 模型架构概览
更多支持的语言#
与 Qwen3-LiveTranslate 相比,Qwen3.5-LiveTranslate 大幅扩展了语言覆盖范围。输入音频和输出文本支持从 18 种增长至 60 种语言,输出音频支持从 10 种增长至 29 种语言,为全球场景提供了更广泛的跨语言翻译组合。
| Qwen3-LiveTranslate | Qwen3.5-LiveTranslate | |
|---|---|---|
| 输入模态 | 音频 / 视频 | 音频 / 视频 |
| 推理模式 | 离线 / 流式 | 离线 / 流式 |
| 声音克隆 | ✗ | ✓(3 种模式:预注册/克隆一次/实时克隆) |
| 热词 | 最多 1,000 个 | 最多 1,000 个 |
| 输入音频语言 & 输出文本语言 | 18 种语言 中文、英语、俄语、法语、德语、葡萄牙语、西班牙语、意大利语、印度尼西亚语、韩语、日语、越南语、泰语、阿拉伯语、粤语、印地语、希腊语、土耳其语 | 60 种语言 南非荷兰语、阿拉伯语、阿斯图里亚斯语、阿塞拜疆语、巴斯克语、白俄罗斯语、孟加拉语、波斯尼亚语、保加利亚语、粤语、加泰罗尼亚语、宿务语、中文、克罗地亚语、捷克语、丹麦语、荷兰语、英语、世界语、爱沙尼亚语、菲律宾语、芬兰语、法语、加利西亚语、格鲁吉亚语、德语、希腊语、希伯来语、印地语、匈牙利语、冰岛语、印度尼西亚语、国际语、意大利语、日语、爪哇语、卡纳达语、哈萨克语、韩语、吉尔吉斯语、林加拉语、拉脱维亚语、立陶宛语、马其顿语、马来语、马拉雅拉姆语、马耳他语、毛利语、马拉地语、蒙古语、书面挪威语、新挪威语、奥里亚语、波斯语、波兰语、葡萄牙语、旁遮普语、罗马尼亚语、俄语、塞尔维亚语、斯洛伐克语、斯洛文尼亚语、西班牙语、斯瓦希里语、瑞典语、塔吉克语、泰米尔语、泰卢固语、泰语、土耳其语、乌克兰语、乌尔都语、维吾尔语、越南语 |
| 输出音频语言 | 10 种语言 中文、英语、法语、德语、俄语、意大利语、西班牙语、葡萄牙语、日语、韩语 | 29 种语言 中文、英语、德语、意大利语、葡萄牙语、西班牙语、日语、韩语、法语、俄语、泰语、印度尼西亚语、阿拉伯语、越南语、土耳其语、芬兰语、波兰语、印地语、荷兰语、捷克语、乌尔都语、菲律宾语、瑞典语、丹麦语、希伯来语、冰岛语、马来语、挪威语、波斯语 |
🎬 精彩演示#
跨国会议#
多语言商务会议场景,与会者使用不同语言发言并在句中自由切换。Qwen3.5-LiveTranslate 从容应对语言混说、多样口音和专业术语,实时输出流畅自然的翻译,全程无缝衔接。
出境旅游#
搭载千问AI眼镜的真实出境旅游场景:一位中国游客在泰国当地餐厅点餐。模型在端侧实时完成泰语到中文的翻译,结合菜单上的视觉信息与对话语音,输出准确且贴合语境的翻译——让跨语言交流在旅途中变得轻松自如。
直播场景#
电商直播翻译场景。Qwen3.5-LiveTranslate 精准翻译商品规格与数字信息,确保产品参数在跨语言传达中准确无误。
文言文翻译#
《三国演义》文言文旁白片段。Qwen3.5-LiveTranslate 能够准确理解并翻译古典文言文,将其转化为流畅的现代英语,展现了模型在日常口语之外处理文学性、历史性语言的能力。
视觉消歧#
Qwen3.5-LiveTranslate 利用视觉上下文来解决翻译中的歧义问题。当某个词或短语存在多种可能的含义时,模型会借助所见内容——屏幕文字、物体或场景信息——选择正确的语义,输出既准确又贴合上下文的翻译。
通过 DashScope API 使用 Qwen3.5-LiveTranslate#
import os
import time
import base64
import asyncio
import json
import websockets
import pyaudio
import queue
import threading
import traceback

class LiveTranslateClient:
    """与 DashScope 实时翻译服务交互的客户端:采集麦克风音频、发送至服务端、接收并播放译文。"""

def __init__(self, api_key: str, target_language: str = "en", *, audio_enabled: bool = True):
        if not api_key:
            raise ValueError("API key cannot be empty.")

self.api_key = api_key
        self.target_language = target_language
        self.audio_enabled = audio_enabled
        self.ws = None
        self.api_url = "wss://dashscope.aliyuncs.com/api-ws/v1/realtime?model=qwen3.5-livetranslate-flash-realtime"

# 音频输入参数(麦克风采集)
        self.input_rate = 16000
        self.input_chunk = 1600
        self.input_format = pyaudio.paInt16
        self.input_channels = 1

# 音频输出参数(本地播放)
        self.output_rate = 24000
        self.output_chunk = 2400
        self.output_format = pyaudio.paInt16
        self.output_channels = 1

# 运行状态与播放资源
        self.is_connected = False
        self.audio_player_thread = None
        self.audio_playback_queue = queue.Queue()
        self.pyaudio_instance = pyaudio.PyAudio()

async def connect(self):
        """与翻译服务建立 WebSocket 连接。"""
        headers = {"Authorization": f"Bearer {self.api_key}"}
        try:
            self.ws = await websockets.connect(self.api_url, additional_headers=headers)
            self.is_connected = True
            print(f"成功连接到服务端: {self.api_url}")
            await self.configure_session()
        except Exception as e:
            print(f"连接失败: {e}")
            self.is_connected = False
            raise

async def configure_session(self):
        """配置翻译会话:目标语言、音频格式与可选能力。"""
        config = {
            "event_id": f"event_{int(time.time() * 1000)}",
            "type": "session.update",
            "session": {
                # modalities 决定服务端返回内容的形式:
                #   ["text", "audio"] —— 同时返回译文文本和合成语音(推荐)
                #   ["text"]          —— 仅返回译文文本
                "modalities": ["text", "audio"] if self.audio_enabled else ["text"],
                "input_audio_format": "pcm",
                "output_audio_format": "pcm",
                # input_audio_transcription:开启源语言识别(ASR)。
                # 将 model 设为 'qwen3-asr-flash-realtime',可在翻译的同时拿到原文识别结果。
                # "input_audio_transcription": {
                #     "model": "qwen3-asr-flash-realtime",
                #     "language": "zh"  # 指定源语言;缺省为 'en'
                # },
                "translation": {
                    "language": self.target_language,
                    # corpus:注入热词,对专有名词、行业术语等可显著提升识别与翻译准确率。
                    # "corpus": {
                    #     "phrases": {
                    #         "人工智能": "Artificial Intelligence",
                    #         "机器学习": "Machine Learning"
                    #     }
                    # }
                }
            }
        }
        print(f"发送会话配置: {json.dumps(config, indent=2, ensure_ascii=False)}")
        await self.ws.send(json.dumps(config))

async def send_audio_chunk(self, audio_data: bytes):
        """将一块音频数据进行 base64 编码后发送至服务端。"""
        if not self.is_connected:
            return

event = {
            "event_id": f"event_{int(time.time() * 1000)}",
            "type": "input_audio_buffer.append",
            "audio": base64.b64encode(audio_data).decode()
        }
        await self.ws.send(json.dumps(event))

async def send_image_frame(self, image_bytes: bytes, *, event_id: str | None = None):
        """将一帧图像发送至服务端,作为视觉上下文辅助翻译。"""
        if not self.is_connected:
            return
        if not image_bytes:
            raise ValueError("image_bytes 不能为空")

image_b64 = base64.b64encode(image_bytes).decode()
        event = {
            "event_id": event_id or f"event_{int(time.time() * 1000)}",
            "type": "input_image_buffer.append",
            "image": image_b64,
        }
        await self.ws.send(json.dumps(event))

def _audio_player_task(self):
        """后台线程任务:从播放队列读取 PCM 数据,写入扬声器输出流。"""
        stream = self.pyaudio_instance.open(
            format=self.output_format,
            channels=self.output_channels,
            rate=self.output_rate,
            output=True,
            frames_per_buffer=self.output_chunk,
        )
        try:
            while self.is_connected or not self.audio_playback_queue.empty():
                try:
                    audio_chunk = self.audio_playback_queue.get(timeout=0.1)
                    if audio_chunk is None:  # 收到结束信号,退出播放循环
                        break
                    stream.write(audio_chunk)
                    self.audio_playback_queue.task_done()
                except queue.Empty:
                    continue
        finally:
            stream.stop_stream()
            stream.close()

def start_audio_player(self):
        """启动后台音频播放线程(仅在启用音频输出时生效)。"""
        if not self.audio_enabled:
            return
        if self.audio_player_thread is None or not self.audio_player_thread.is_alive():
            self.audio_player_thread = threading.Thread(target=self._audio_player_task, daemon=True)
            self.audio_player_thread.start()

async def handle_server_messages(self, on_text_received):
        """持续接收并分发服务端推送的事件消息。"""
        try:
            async for message in self.ws:
                event = json.loads(message)
                event_type = event.get("type")
                if event_type == "response.audio.delta" and self.audio_enabled:
                    audio_b64 = event.get("delta", "")
                    if audio_b64:
                        audio_data = base64.b64decode(audio_b64)
                        self.audio_playback_queue.put(audio_data)

elif event_type == "response.done":
                    print("\n[INFO] 一轮响应完成。")
                    usage = event.get("response", {}).get("usage", {})
                    if usage:
                        print(f"[INFO] Token 使用情况: {json.dumps(usage, indent=2, ensure_ascii=False)}")
                # 接收源语言识别结果(需先启用 input_audio_transcription.model)
                # elif event_type == "conversation.item.input_audio_transcription.text":
                #     stash = event.get("stash", "")  # 流式中间结果,尚未稳定
                #     print(f"[识别中] {stash}")
                # elif event_type == "conversation.item.input_audio_transcription.completed":
                #     transcript = event.get("transcript", "")  # 一段语音的最终识别文本
                #     print(f"[源语言] {transcript}")
                # 语音+文本模式下,译文文本随合成语音一同返回,字段名为 transcript
                elif event_type == "response.audio_transcript.done":
                    print("\n[INFO] 翻译文本完成。")
                    text = event.get("transcript", "")
                    if text:
                        print(f"[INFO] 翻译文本: {text}")
                # 仅文本模式下,译文文本通过 response.text.done 返回,字段名为 text
                elif event_type == "response.text.done":
                    print("\n[INFO] 翻译文本完成。")
                    text = event.get("text", "")
                    if text:
                        print(f"[INFO] 翻译文本: {text}")

except websockets.exceptions.ConnectionClosed as e:
            print(f"[WARNING] 连接已关闭: {e}")
            self.is_connected = False
        except Exception as e:
            print(f"[ERROR] 消息处理时发生未知错误: {e}")
            traceback.print_exc()
            self.is_connected = False

async def start_microphone_streaming(self):
        """持续从麦克风采集音频,并实时流式发送至服务端。"""
        stream = self.pyaudio_instance.open(
            format=self.input_format,
            channels=self.input_channels,
            rate=self.input_rate,
            input=True,
            frames_per_buffer=self.input_chunk
        )
        print("麦克风已启动,请开始说话...")
        try:
            while self.is_connected:
                audio_chunk = await asyncio.get_event_loop().run_in_executor(
                    None, stream.read, self.input_chunk
                )
                await self.send_audio_chunk(audio_chunk)
        finally:
            stream.stop_stream()
            stream.close()

async def close(self):
        """优雅关闭 WebSocket 连接,并释放音频相关资源。"""
        self.is_connected = False
        if self.ws:
            await self.ws.close()
            print("WebSocket 连接已关闭。")

if self.audio_player_thread:
            self.audio_playback_queue.put(None)  # 通知播放线程退出
            self.audio_player_thread.join(timeout=1)
            print("音频播放线程已停止。")

self.pyaudio_instance.terminate()
        print("PyAudio 实例已释放。")

def print_banner():
    print("=" * 60)
    print("  基于千问 qwen3.5-livetranslate-flash-realtime")
    print("=" * 60 + "\n")

def get_user_config():
    """通过命令行交互收集运行参数:输出模式与目标语言。"""
    print("请选择模式:")
    print("1. 语音+文本 [默认] | 2. 仅文本")
    mode_choice = input("请输入选项 (直接回车选择语音+文本): ").strip()
    audio_enabled = (mode_choice != "2")

if audio_enabled:
        lang_map = {
            "1": "en", "2": "zh", "3": "ru", "4": "fr", "5": "de", "6": "pt",
            "7": "es", "8": "it", "9": "ko", "10": "ja", "11": "yue"
        }
        print("请选择翻译目标语言 (音频+文本 模式):")
        print("1. 英语 | 2. 中文 | 3. 俄语 | 4. 法语 | 5. 德语 | 6. 葡萄牙语 | 7. 西班牙语 | 8. 意大利语 | 9. 韩语 | 10. 日语 | 11. 粤语")
    else:
        lang_map = {
            "1": "en", "2": "zh", "3": "ru", "4": "fr", "5": "de", "6": "pt", "7": "es", "8": "it",
            "9": "id", "10": "ko", "11": "ja", "12": "vi", "13": "th", "14": "ar",
            "15": "yue", "16": "hi", "17": "el", "18": "tr"
        }
        print("请选择翻译目标语言 (仅文本 模式):")
        print("1. 英语 | 2. 中文 | 3. 俄语 | 4. 法语 | 5. 德语 | 6. 葡萄牙语 | 7. 西班牙语 | 8. 意大利语 | 9. 印尼语 | 10. 韩语 | 11. 日语 | 12. 越南语 | 13. 泰语 | 14. 阿拉伯语 | 15. 粤语 | 16. 印地语 | 17. 希腊语 | 18. 土耳其语")

choice = input("请输入选项 (默认取第一个): ").strip()
    target_language = lang_map.get(choice, next(iter(lang_map.values())))

return target_language, audio_enabled

async def main():
    """程序主入口:完成连接与会话配置,并启动实时翻译循环。"""
    print_banner()

api_key = os.environ.get("DASHSCOPE_API_KEY")
    if not api_key:
        print("[ERROR] 请设置环境变量 DASHSCOPE_API_KEY")
        print("  例如: export DASHSCOPE_API_KEY='your_api_key_here'")
        return

target_language, audio_enabled = get_user_config()
    print("\n配置完成:")
    print(f"  - 目标语言: {target_language}")
    if not audio_enabled:
        print("  - 输出模式: 仅文本")

client = LiveTranslateClient(api_key=api_key, target_language=target_language, audio_enabled=audio_enabled)

# 翻译文本到达时的回调:按字流式打印到终端
    def on_translation_text(text):
        print(text, end="", flush=True)

try:
        print("正在连接到翻译服务...")
        await client.connect()

# 启动音频播放线程(仅当启用音频输出时实际工作)
        client.start_audio_player()

print("\n" + "-" * 60)
        print("连接成功!请对着麦克风说话。")
        print("程序将实时翻译您的语音并播放结果。按 Ctrl+C 退出。")
        print("-" * 60 + "\n")

# 并发执行:处理服务端消息 + 上传麦克风音频
        message_handler = asyncio.create_task(client.handle_server_messages(on_translation_text))
        tasks = [message_handler]
        # 麦克风采集是翻译的输入源,无论是否输出语音都必须开启
        microphone_streamer = asyncio.create_task(client.start_microphone_streaming())
        tasks.append(microphone_streamer)

await asyncio.gather(*tasks)

except KeyboardInterrupt:
        print("\n\n用户中断,正在退出...")
    except Exception as e:
        print(f"\n发生严重错误: {e}")
    finally:
        print("\n正在清理资源...")
        await client.close()
        print("程序已退出。")

if __name__ == "__main__":
asyncio.run(main())未来方向#
我们仍将持续探索多模态翻译方向的能力边界,并重点推进以下几个方向:
- 更低的延迟:进一步压缩同传的整体时延,不断逼近实时翻译的体验极限,让高质量同传真正做到“所说即所得”。
- 更多语言与方言支持:持续扩展输入与输出语言的覆盖范围,支持更多小语种、区域方言及跨地域表达方式,让实时翻译服务于更广泛的人群与场景。
- 更长的上下文与更强的一致性:在长时间会议、多轮对话等复杂场景中,更稳定地保持术语、人名及上下文信息的全局一致,提升翻译的连贯性与专业性。
- 更高保真的音色复刻:在保留说话人个性化声音特征的同时,更自然地还原环境音与现场氛围,提升语音交互的真实感。
- 更丰富的交互模式:支持多语种、多方言混合表达、说话人分离,以及手势、口型、表情等多模态信号的联合建模,进一步拓展实时翻译在人机交互中的应用边界。
Citation#
如果您认为 Qwen3.5-LiveTranslate 对您的研究或工作有所帮助,欢迎引用以下文章:
@misc{qwen35livetranslateblog,
    title = {Qwen3.5-LiveTranslate: From Sound to Sight, From Word to Right},
    url = {https://qwen.ai/blog?id=qwen3.5-livetranslate},
    author = {Qwen Team},
    month = {May},
    year = {2026}
}