Lev Loops Instead of Tokens to Scale Reasoning Depth
Researchers from Lehigh University, UBC and the Vector Institute propose Lev, a decision model that scales reasoning depth through recurrent loops rather than generated reasoning tokens, keeping simple requests at tens of milliseconds while giving hard ones more compute. It reports up to 13% accuracy gains on decision tasks, with code, models and datasets released openly.
Related Entities
Full Report
新智元报道
设想一个客服系统,每秒涌进成百上千条用户请求。
每一条都要先过一个「分诊台」:这是退款、查物流,还是投诉?要不要转人工?该调哪个工具?
这类问题有一个共同点:答案就在给定的几个选项里。
为此,业界有了专门的决策模型,例如Jev和开源的Kev。它们读入请求和候选项,一次前向就给出每个选项的概率,几十毫秒就能返回,不生成任何文本。
可问题也随之而来。
「我要退款」和「上个月买的东西换过一次货,这次又坏了,能不能直接退、运费谁出」,在决策模型眼里花的是同样多的计算。
简单的请求被「过度服务」,复杂的请求又没法多想一会儿。
让模型先写一段推理再作答?可以,但每一条请求都要为推理文本付费,哪怕它只是一句「我要退款」。
有没有一种模型,简单题像小模型一样快,难题又能像大模型一样多想?
为了回答这个问题,来自Lehigh University、University of British Columbia和Vector Institute的研究团队提出了Lev:一个用循环而不是token来加深思考的决策模型。
论文链接:https://arxiv.org/abs/2610.20951
代码链接:https://github.com/OpenLAIR/lev
模型与数据集:https://huggingface.co/collections/songdj/lev
Lev逐圈作答:例1第1圈就选中正确答案B,停止器判定可以停下;例2第1圈选4,到第4圈改选正确答案6。(来源:按项目主页记录的逐圈读数重绘,回放实验数据,不是实时推理)
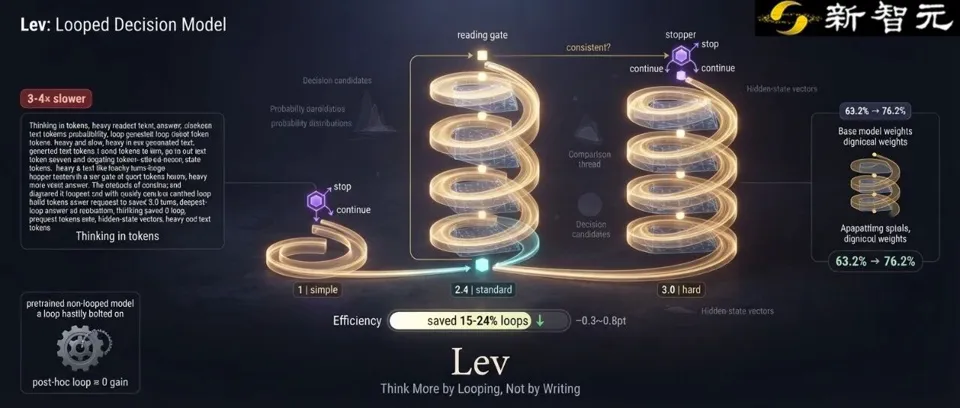
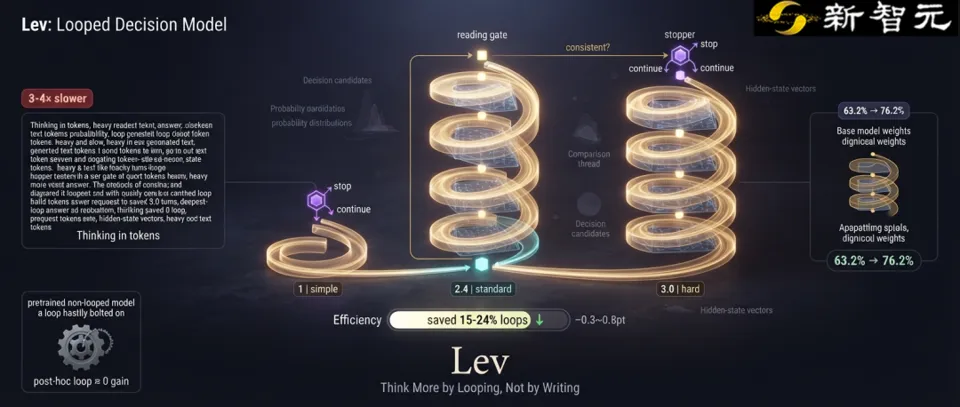
论文图1:按需深度的Lev-2.6B在JevBench简单、标准、难题上分别用的圈数,以及准确率与延迟。
Lev的核心思路可以概括为一句话:同一组网络层反复运行,每运行一圈就读出一次答案。
作者把这种计算方式称为System 1.5:它保留了System 1「直接给出决定」的接口,又能像System 2一样在难题上多花计算,只是这些计算发生在隐藏状态里,而不是写成文字。
结果很直观:
- 在JevBench的231道公开题上,同一个Lev-2.6B checkpoint从一圈的63.2%提升到四圈的76.2%,增加13.0个百分点;
- 停止器看不到题目难度,却在简单、标准、难题上平均分别用了1.2、2.4、3.0圈;
- 按需深度在离线统计中少算15%到24%的环路计算,准确率损失不到1个点;
- 在50ms以内的延迟区间,Lev-1.4B和Lev-3B比同延迟的非循环模型和级联高5.4到8.8个点(单张H200、一次一个请求实测)。
额外的算力,只在少数题上有用
Lev的出发点来自一组逐题对比。
作者取来两个公开决策模型Kev-0.8B和Kev-4B。两者训练数据源相同,在JevBench 231道公开题上,大模型多答对了28道。
这28道,全部来自标准题和难题。简单题两个模型都已经全对。
而两个模型结果不同的题只有42道,大模型却在全部231道题上都多花了计算。
如果用小模型的置信度挑出它最没把握的一半,交给大模型,准确率几乎就能追平大模型全量作答。
结论:额外的计算只在少数题上有回报,而一次便宜的初读就能找到它们。
论文图2:(a)Kev-0.8B与Kev-4B的逐题结果;(b)只把最没把握的一半交给大模型的效果;(c)生成推理与单次读出的对比;(d)给普通预训练模型加装循环后的准确率变化。
那么现有的三种「加算力」方案为什么不够?
- 级联:Kev-0.8B的中位延迟已经是79ms,Kev-4B是108ms。被转交的题要从头再读一遍,比直接用大模型还慢,还得多部署一个模型。
- 生成推理文本:在同一个26B底座的两个开源Jev式服务上,打开思考让难题准确率提高9到13个点,但难题中位耗时变成三到四倍。
- 给预训练模型加装循环:作者在Qwen3.5-0.8B上把中间8层接成带门控的循环,准确率变化不到半个点,门控始终接近零,循环相当于没开。
最后一条尤为关键。它说明循环最好在预训练时就学会,而不是在决策训练中临时补上。
Lev的三个关键设计
最近,循环Transformer再度受到业界关注。基于上面的判断,Lev选择了原生循环语言模型作为底座:字节Seed的Ouro(1.4B、2.6B,循环4圈)和Nanbeige4.2-3B(循环2圈)。
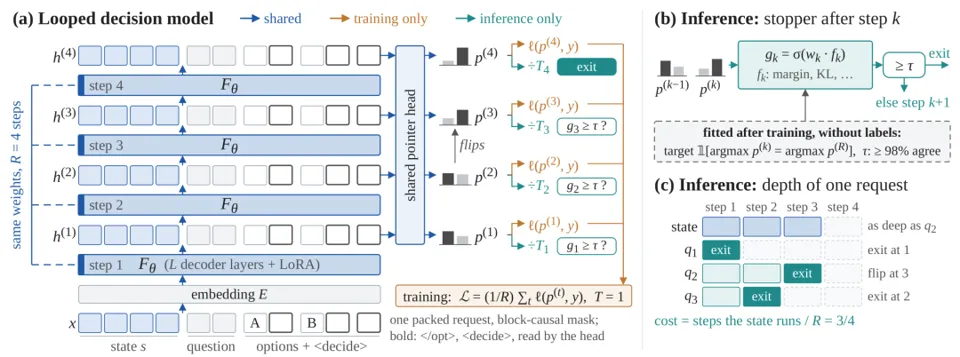
论文图3:Lev的整体结构。同一组解码层循环运行,共享的pointer head每圈读一次选项;停止器决定每道题在哪一圈退出。
设计一:每一圈都读出答案。
请求和所有候选项被打包成一条序列。同一组解码层重复运行,每一圈之后,同一个pointer head读取各选项和<decide>位置的隐藏状态,输出一次选项概率。
设计二:所有圈联合训练。
pointer head和LoRA适配器在各圈之间共享,损失****对所有圈取平均。于是第1圈、第2圈、第4圈都是能独立使用的决策模型。
用k圈服务时只算前k圈;需要多想一圈时,从上一圈的隐藏状态继续算,请求不必重新读一遍。
设计三:停止器预测「与最深一圈是否一致」。
常见的早退规则是「置信度够高就停」。但作者发现,浅层读出在新数据上严重过度自信:Lev-2.6B在第一圈停下的题目,在校准集上94.8%正确,换到新数据源上只有78.9%,置信度却几乎相同。
而且,置信度分不出「再算一圈就能改对」的错误,AUROC只有0.46到0.61。
所以Lev的停止器换了目标:不预测「当前答案对不对」,而是预测「当前答案和最深一圈一不一样」。
这个目标的「标准答案」就是模型自己的最深输出,拟合停止器和挑选阈值都不需要人工标注。部署方可以直接用自家业务的无标签请求来校准。
实验结果
一份权重,多个工作点
作者用完全相同的31,329条训练数据和配方,训练了三个Lev模型,以及Qwen3-1.7B、Qwen3.5-2B、Qwen3.5-4B三个非循环对照。评测包括三个调优集、两个held-out测试集(其中LevBench由作者自建,在任何模型读取之前就已冻结)和JevBench的231道公开题。
结论一:深度越深越准,收益递减。
Lev-2.6B在JevBench上一圈到四圈依次为63.2%、71.0%、75.3%、76.2%;在held-out平均上依次为51.3%、62.0%、64.8%、65.7%。大部分收益来自第一个额外的圈,第四圈最多再加1个点。
离训练数据越远,深度越有用:训练数据源上提升约7个点,更陌生的测试集上提升9.0到19.5个点。
结论二:提升集中在难题上。
从一圈到四圈,Lev-2.6B在111道难题上净多答对19道,在72道标准题上净多答对10道。难题里29道被改对、10道被改错。
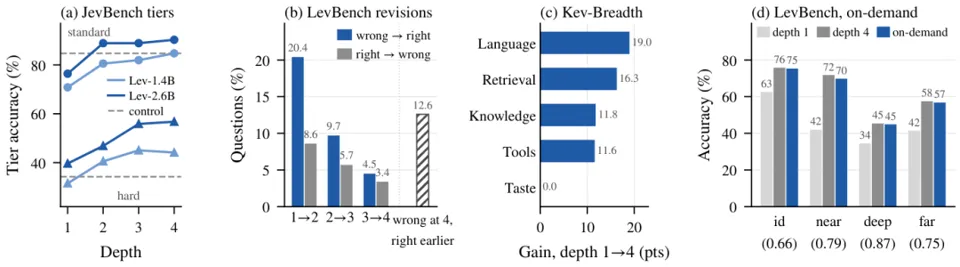
论文图5:深度在哪里起作用,包括JevBench各难度档、相邻两圈之间的修改,以及各应用领域的提升。
不同任务受益不同:在Kev-Breadth上,深度让语言理解类任务提高19.0个点,在幽默和颜色偏好这类「品味」任务上则没有收益。作者推测,额外的圈提供了组合多个事实所需的串行计算。
结论三:按需深度少算15%到24%,准确率几乎不掉。
在两个held-out测试集上,停止器只用了最深一圈76%到85%的计算,准确率损失0.3到0.8个点。在配方和停止器全部定下后只读一次的锁定测试上,损失最多1.0个点。
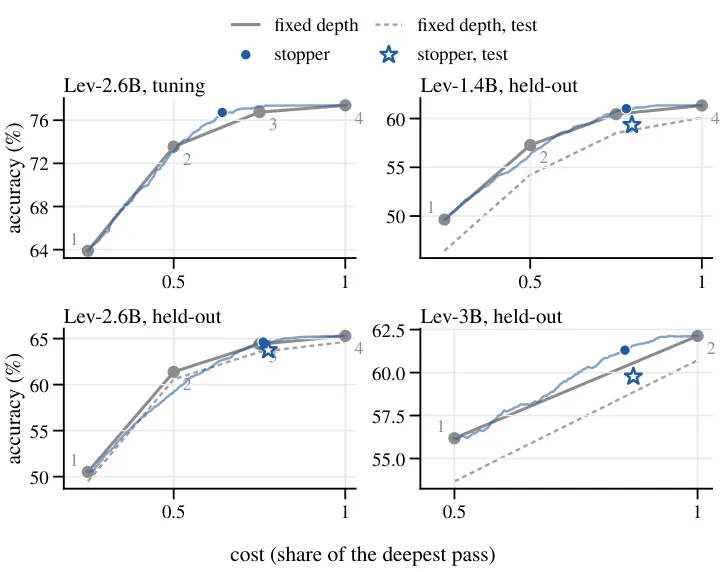
论文图6:准确率与计算成本。灰色为固定深度及其前沿,蓝线为停止器,星号为锁定测试。
结论四:关键在于用目标流量校准。
只要像停止器一样在无标签目标请求上、以「与最深答案一致」为准则来选阈值,一个简单的最高概率阈值就能与停止器相差不到0.2个点。每折500道无标签题就够用。
结论五:低延迟区间优势明显。
在39到46ms的延迟下,按需的Lev-1.4B和Lev-3B比同延迟唯一可用的级联高7.0到8.8个点,比最好的非循环方案高5.4到7.5个点。
论文图10:LevBench锁定测试上的准确率与平均延迟,星号为按需深度的Lev,数字为它与最好的非循环方案的差距。
作者在论文中对结果的适用范围交代得相当清楚:
- 与同等成本的固定深度相比,按需深度优势不大:Lev-2.6B在held-out上只高0.2个点,Lev-3B高1.0个点;锁定测试上Lev-2.6B与固定深度前沿持平。
- 「少算」是离线统计:节省的是环路计算量,转化为线上吞吐或延迟,需要服务端支持不同深度请求的打包调度。
- 优势在延迟,不在计算量:按浮点运算量算,每个Lev模型都与非循环方案持平或更差,因为每一圈都要跑完整个底座。部分延迟优势也来自非循环方案在22到79ms之间的空档。
- 延迟测量条件:单张H200、bf16、一次一个请求,所有系统都没有使用融合算子、图捕获或状态缓存。
- 多想也会改错:在LevBench上,第一个额外的圈改对20.4%的题,也改错8.6%;有12.6%的题浅层答对、最深一圈答错。
总结与展望
Lev给出的启示是:原生循环底座可以把「想多深」从一个训练时的常量,变成服务时按题选择的设置。同一个决策模型,可以针对每一道题在延迟和准确率之间做取舍,而不是针对每一次部署。
作者提出了两个后续方向:
- 设计新的停止目标,救回「浅层答对、深层答错」的题目,从而超过最深一圈的准确率;
- 在更大的循环底座上检验,难题上的收益是否会随规模继续增长。
目前,论文、代码、三个模型和三个数据集均已公开。数据集是按来源再分发条款筛选后的子集,无法托管的来源附有重建说明。
团队介绍
- 宋定杰(DingjieSong,共同第一作者):Lehigh University 博士生。
- Zhiling Yan(共同第一作者):Lehigh University 博士生。
- Yuxuan Zhang:University of British Columbia 博士生,Vector Institute。
- Lichao Sun(通讯作者):Lehigh University 助理教授
参考资料:
https://arxiv.org/abs/2610.20951
https://openlair.github.io/lev/
秒追ASI
⭐点赞、转发、在看一键三连⭐
点亮星标,锁定新智元极速推送!