EchoChat Proposes Three-Stage Cognitive Framework for Empathetic Voice Dialogue
EchoChat decomposes empathetic voice dialogue into perception, Theory of Mind reasoning, and response generation, using a unified optimization framework to mitigate error propagation. The study aims to enhance AI's ability to move from superficial warmth to nuanced understanding and appropriate responses by integrating acoustic cues with contextual inference.
Full Report
将共情语音对话建模为包含感知、心理状态推理和回复生成的结构化认知过程。
一句 “我懂你” 背后,AI 究竟需要理解什么?
“没事,你忙吧。”
如果只看文字,这句话似乎是在告诉对方:不用担心。但在真实对话中,同样的几个字,可以说得轻松自然,也可以伴随着压低的声音、迟疑的停顿,或一声叹息。这些细微的差别,会改变我们对说话人状态的理解,也会影响接下来应该如何回应。
当语音大模型越来越擅长聊天和安慰,它能否从 “说得温暖”,走向 “理解得细腻、回应得贴切”?
EchoChat 围绕这一问题展开研究,将共情语音对话建模为包含感知、心智理论(Theory of Mind) 推理和回复生成的结构化认知过程,并通过统一的优化框架,让模型的回应建立在对声音与情境的逐步理解之上。
论文链接:https://arxiv.org/html/2610.04826v1
一、从声音到回应,共情需要经过哪些步骤?
在说出 “我懂你” 之前,AI 究竟理解了什么?
在日常交流中,合适的回应往往来自一连串判断:对方的声音呈现出哪些声学特征,反映了怎样的情绪及其强度?结合对话情境,对方可能持有怎样的信念、意图与心理需求?我们又该如何选择回应的内容、语气与情感表达?
仅仅识别情绪类别,还不足以回答这些问题。同样是 “难过”,哽咽抽泣与淡淡的忧郁,需要不同的回应。缺乏对这些差异及其背后需求的理解,再温暖的安慰也可能不够贴切。
EchoChat 将共情从理解到回应明确拆分为三个相互关联的环节:
- 感知:从语音中识别情绪及相关声学线索,为后续推理提供依据。
- 心智理论推理:结合声音中的情绪线索与对话情境,推断说话人的信念、意图及潜在心理需求,并制定合适的共情策略。
- 语音回复生成:生成内容恰当、语气与情感表达贴合用户需求的支持性语音回应。
然而,这种多阶段推理也面临 “一步错,步步错” 的挑战:前一环节的误判可能影响后续判断,并最终导致不恰当的回应。如何通过一套统一、可推广的训练方法,让模型在各阶段获得有针对性的反馈,并减少错误的逐步传递,是 EchoChat 希望解决的核心问题之一。
为此,EchoChat 从声学信息的利用和多阶段优化两个方面入手。
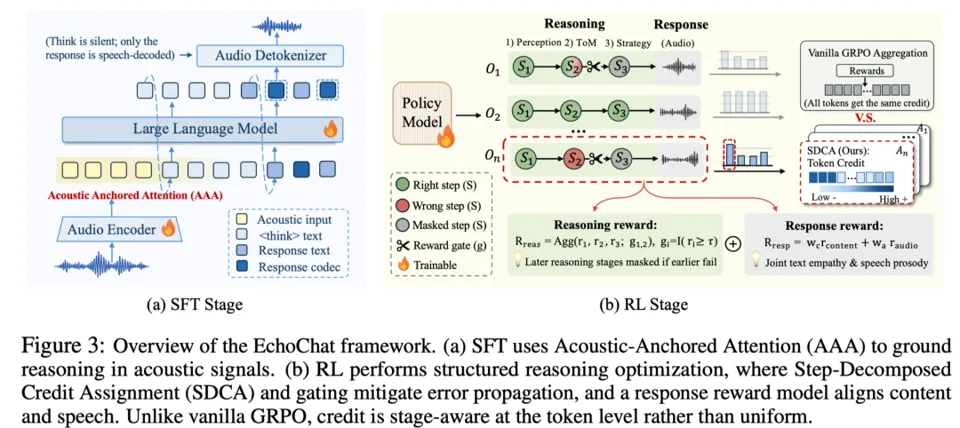
(1)让理解扎根于声音:
语音里的信息远不止转写出来的文字。语调、节奏、停顿和声音强弱,都可能为理解情绪提供线索,尤其是在字面表达与说话方式并不一致时。
EchoChat 在监督微调(SFT)阶段引入 Acoustic-Anchored Attention(AAA),强化模型理解过程与声学信息之间的联系。
它关注的问题很直接:当模型分析用户的情绪和状态时,这些判断是否有来自声音的依据?对共情语音对话而言,充分利用这些依据,是后续心理状态推理和回应生成的重要基础。
(2)让训练关注出错的环节:
共情推理的各个环节并非彼此独立。当一条回复不够合适,问题可能出现在不同位置:模型可能听错了情绪,也可能正确识别了情绪却误解了需求,或者前面的理解合理,但最终选择了不恰当的回应。
如果训练反馈只停留在最终回复的好坏,就难以精确区分这些情况。
为此,EchoChat 在强化学习(RL)阶段引入 Step-Decomposed Credit Assignment(SDCA)。它不仅为不同阶段提供有针对性的训练反馈,还通过门控机制(gating),让后续阶段的奖励受到前序阶段表现的约束,避免模型仅凭表面合理的推理或回应获得奖励。
这使训练能够进一步关注:一条回复为什么不合适,应该从哪个步骤开始改进?
二、如何学习和评估这样的能力?
为提升语音大模型的共情能力,研究团队构建了 EchoDialogue-400K,一个涵盖多种语言风格、多样化对话场景与细粒度情感表达的共情对话数据集。
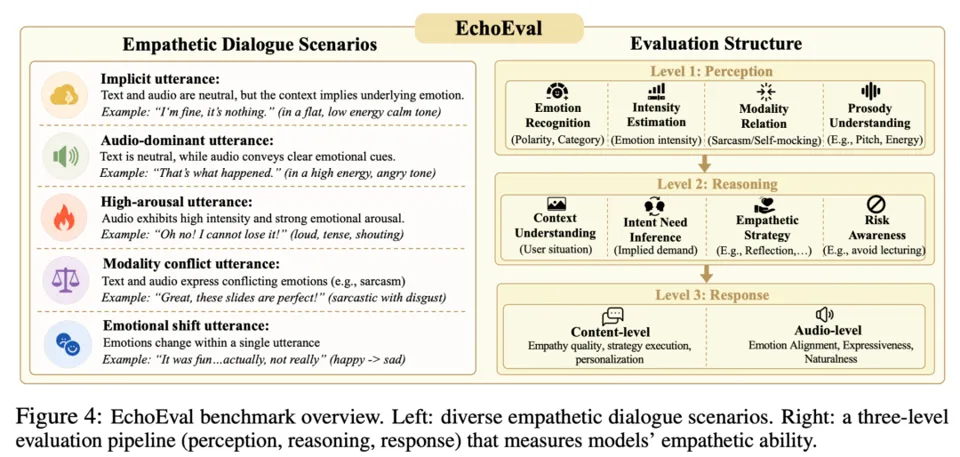
与此同时,研究团队提出了由真人录制语音、心理学专家标注的评测基准 EchoEval,从多个维度考察模型的共情能力。
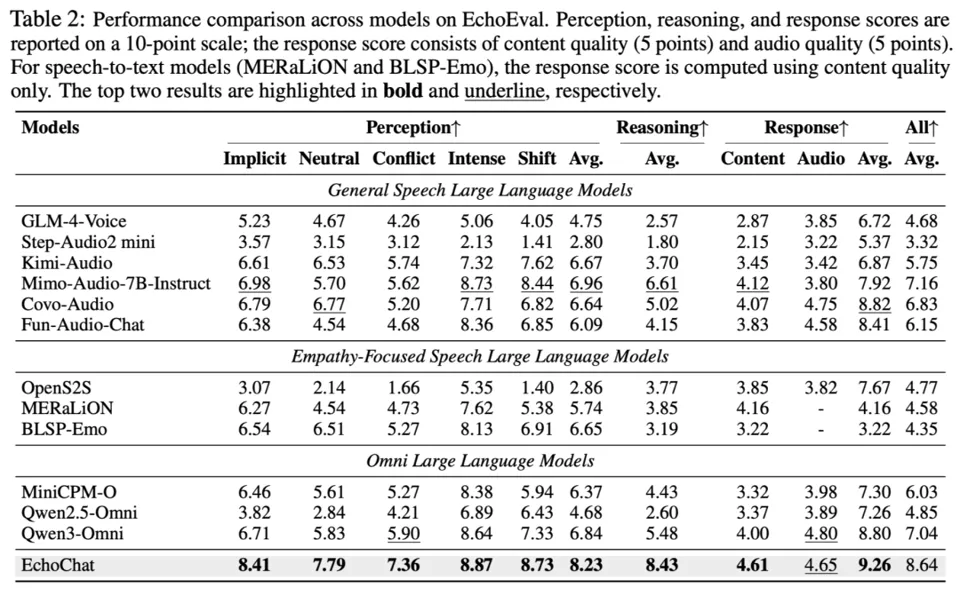
EchoChat 在感知、推理和回应对齐方面取得了领先表现。这样的评估视角,也让 “共情能力” 成为一个可以进一步拆解、分析和改进的研究问题。
一句 “我懂你” 很短,但支撑它的理解过程并不简单。
EchoChat 探索的是:如何让语音大模型更充分地利用声音中的线索,更有依据地推断用户的状态与需求,并将这些理解落实到回应之中。
三、EchoChat 表现如何?
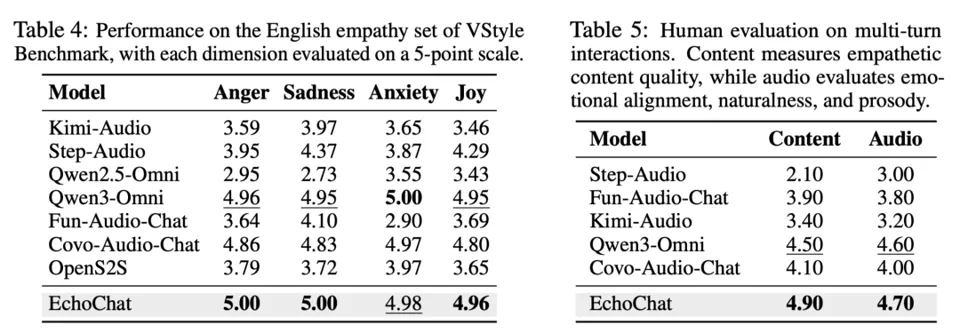
实验表明,EchoChat 在情绪感知、心理状态推理和回应对齐三个维度均取得了领先表现。这些结果支持了论文的核心思路:将共情拆解为相互关联的认知步骤,有助于模型形成更有依据的理解,并生成更贴合用户状态与需求的回应。
多维度评测也让我们能够进一步审视一句 “我懂你”:模型是否捕捉到了声音中的细腻声学线索?对用户心理状态的推断是否合理?最终回应是否与前面的理解一致?这些环节共同构成了衡量共情能力的依据。
结语:让 “我懂你” 有据可依
一句恰当的回应,始于对声音的倾听,也依赖对情境和需求的理解。EchoChat 将情绪感知、心智理论推理与语音回复生成纳入统一的训练框架,让复杂的多阶段共情过程实现协同优化。
当 AI 说出 “我懂你”,我们期待它能够听见话语中的情绪,理解尚未说出口的需求,并给予恰如其分的回应。
作者简介
本文第一作者王丁冬,香港中文大学博士生,研究方向为语音大模型的理解、推理与交互,导师 Helen Meng 教授。本文在微软刘树杰博士和 Jinyu Li 博士的共同指导下完成。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:[email protected]