InfoQ 中文 · 10/22/2026, 19:37:36
Ant Digital Launches LingDT-Decision-1.0 for High-Frequency Structured Tasks
Ant Digital released LingDT-Decision-1.0 (4B/27B), a lightweight model specialized for structured decision-making. By utilizing native multi-choice and sequential decision mechanisms, it reduces token consumption by over 90% and speeds up response times by 10x in scenarios like intelligent customer service. The model outperforms Microsoft's counterparts on 23 open-source benchmarks, aiming to decouple high-frequency judgment tasks from general LLMs to optimize cost and latency.
SOURCE COVERAGEFull Original Report
Contents3 sections
LingDT-Decision-1.0是蚂蚁数科发布的专用于结构化决策任务的轻量级决策模型,提供4B/27B双版本,已在DTMaaS平台开放限时免费体验。
支持原生多选与按序决策;Token消耗降低超90%,响应提速10倍;27B版在23项开源基准中同参数准确率最高。
适合AI平台工程师、决策系统架构师、产业AI解决方案开发者阅读。
10 月 22 日,蚂蚁数科发布决策模型 LingDT-Decision-1.0,提供 4B 和 27B 两个参数规模版本,主要面向智能客服、安全风控、金融等企业应用场景。与侧重文本生成的通用大语言模型不同,该模型主要处理意图识别、任务分类、工具选择及风险判断等结构化决策任务,目前已上线蚂蚁数科 DTMaaS 平台,开发者可限时免费体验。
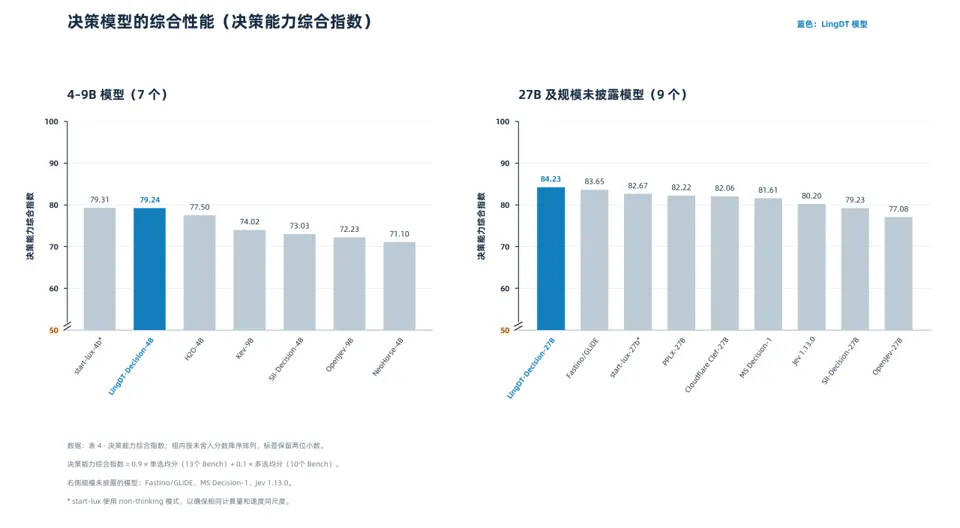
根据蚂蚁数科公布的测试结果,在部分企业业务场景中,LingDT-Decision-1.0 相比所选通用大语言模型,Token 消耗降低超过 90%,任务处理速度最高提升约 10 倍。在覆盖 23 项开源基准的评测中,其 27B 版本的综合评分超过了 Microsoft-Decision-1、Jev 1.13.0 及 Fastino/GLiDE 等决策模型。
减少文本生成环节,面向高频决策任务优化
在企业业务系统中,并非所有 AI 任务都需要生成完整的自然语言回答。大量实际需求是对输入信息进行识别、分类,再根据判断结果执行后续操作。
例如,在智能客服场景中,当用户提出“订单三天还没发货,请尽快处理”时,系统首先需要判断用户意图是催单、退款还是投诉,随后确定工单优先级、处理部门以及是否需要人工介入。这类任务通常具有明确的候选选项,更看重判断准确率、处理时延和调用成本。
通用大语言模型同样能够处理这些任务,但在一些实现方式中,需要先生成文本或结构化答案,再由业务系统解析和校验。对于调用频率较高、选项相对固定的业务,这一过程可能增加 Token 消耗和处理时间。
LingDT-Decision-1.0 采用了不同的处理思路,将部分需要生成答案再解析的任务,转变为在预设候选选项中直接进行判断,从而减少不必要的文本生成及后处理环节。
蚂蚁数科披露,目前该模型已在智能客服、安全风控及金融应用等业务中开展测试。其中,在数据标注场景中,相比 DS-V4-flash,LingDT-Decision-1.0 的 Token 消耗降低约 97%,任务处理速度提升约 10 倍。在智能客服场景中,相比 Qwen-3.7-flash,Token 消耗降低约 90%,处理速度提升约 1 倍,风险识别准确率由 76%提高至 89%。
金融应用方面,测试覆盖意图识别、工具调用和幻觉检测等任务。
蚂蚁数科数据显示,模型在相关任务中的处理速度提升约 5 倍,工具组合完全匹配率提高约 2.6 倍,幻觉召回率由 44%提升至 70%。
支持多选和按序决策,处理复合业务需求
除常见的单选、分类和评级任务外,LingDT-Decision-1.0 还增加了原生多选和按序决策能力,用于处理包含多个目标或存在执行依赖关系的业务请求。
以智能客服为例,假设用户提出:“我要退款、关闭续费、补开发票,但不要注销账号。”
对于只支持单一意图分类的系统而言,如果将整段请求归入退款类别,就可能遗漏关闭续费和补开发票等其他需求。
LingDT-Decision-1.0 的多选能力允许同一请求同时匹配多个候选结果,使系统能够识别复合意图,并为后续工具调用提供判断依据。
按序决策则进一步处理任务之间的依赖关系。针对上述请求,系统不仅需要识别多个操作,还需要判断哪些任务可以独立执行,哪些任务必须等待前置条件满足。例如,退款前需要完成订单核验,发票处理可能需要参考退款结果,而关闭自动续费可能不依赖退款流程。
这一功能采用有向无环图(DAG)的任务依赖关系表示方式,主要面向多步骤决策场景。
不过,识别任务依赖关系并不等于模型能够独立完成全部业务操作。对于涉及资金、账户权限及风险控制的任务,仍需要与企业现有业务规则、权限系统及执行工具配合。
23 项开源基准测试,27B 版本综合评分超过多款决策模型
在模型能力评测方面,蚂蚁数科公布了 LingDT-Decision-1.0 与其他决策模型的对比结果。
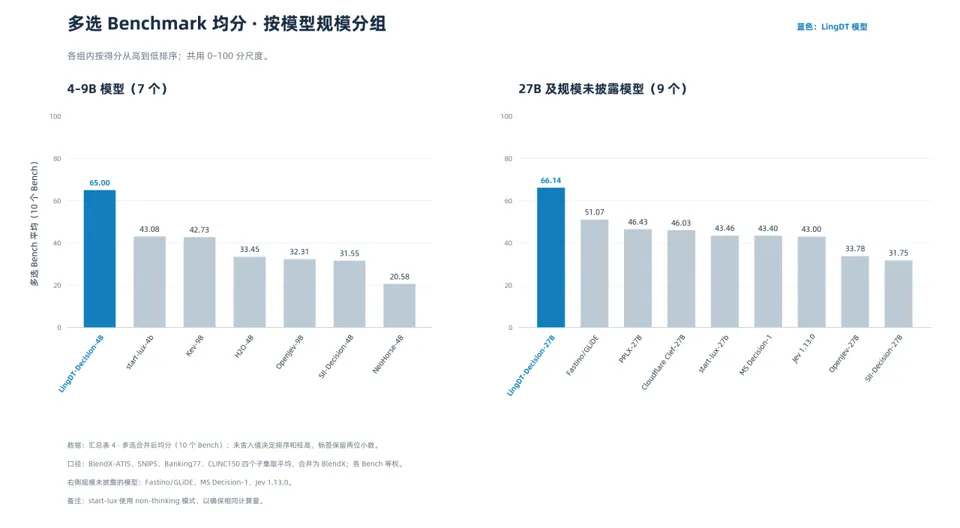
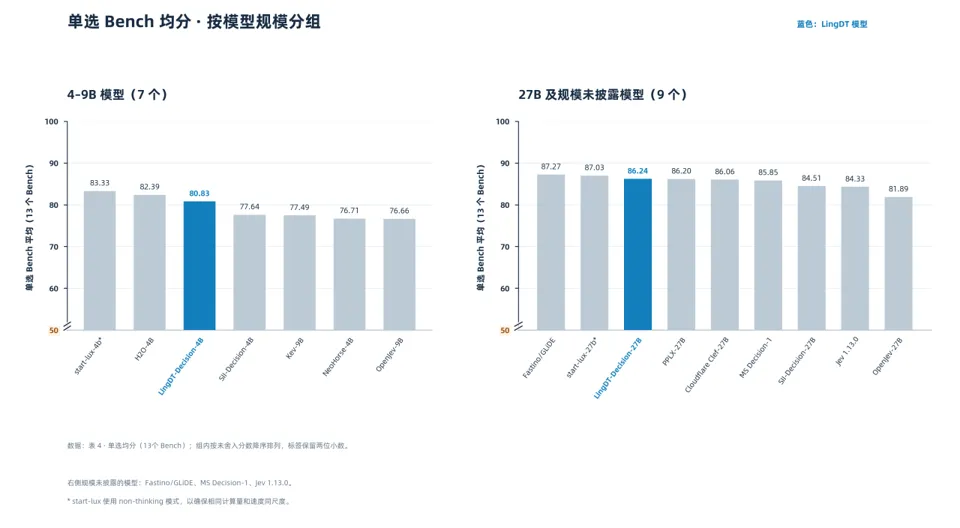
据其介绍,相关评测覆盖 23 项开源基准,采用单选评分占 90%、多选评分占 10%的加权方式计算综合成绩。在这一评测设置下,LingDT-Decision-1.0 的 27B 版本综合评分位居参评模型首位,高于 Microsoft-Decision-1、Jev 1.13.0 及 Fastino/GLiDE 等模型。
具体而言,在多选任务测试中,LingDT-Decision-1.0 的 4B 和 27B 版本准确率均超过包括 Microsoft-Decision-1、Jev 1.13.0 及 Star-lux 在内的 16 款参评决策模型。单选任务方面,该模型也取得了相对靠前的成绩。
近期,面向固定选项判断的决策模型开始受到关注。微软 Microsoft-Decision-1、Jev 等模型均采用了与通用文本生成不同的技术路线,尝试通过直接判断候选结果来降低部分决策任务的时延和调用成本。
这类模型与通用大语言模型并不完全构成替代关系。前者侧重解决候选范围明确、结果能够结构化表达的任务,后者则适用于开放式问答、复杂内容生成和需要灵活推理的场景。
对于企业而言,决策模型的潜在价值在于将部分高频、重复性的判断任务从通用大语言模型中分离出来,减少生成式处理的开销。但在真实生产环境中,除了分类准确率,还需要考察模型对模糊请求、异常输入、错误选项及业务规则变化的适应能力。
但无论如何,LingDT-Decision-1.0 的发布,还是为企业高频决策任务提供了新的模型选择。