Google's Android Bench Update: Gemini 4 Argon Lags Behind Claude and GPT in Coding
Google updated its Android Bench leaderboard, adding reasoning level annotations and new models. Claude Sonnet 5.5 leads with the highest pass rate, while GPT-6.1 Sol offers high completion rates at significantly lower costs. In contrast, Google's own Gemini 4 Argon performed poorly, ranking fifth and lagging behind competitors.
Full Report
IT之家 10 月 28 日消息,谷歌更新了用于评估 AI 模型安卓编程辅助能力的 Android Bench 榜单,Gemini 4 Argon 的成绩大幅落后于最新版 Claude 与 GPT 系列模型。
Android Bench 于今年年初推出,方便安卓开发者快速对照谷歌的这套测试标准,挑选最适合安卓代码开发辅助的 AI 模型。测试会考量安卓开发特有的使用场景以及安卓开发的最佳实践。谷歌在持续开展测试、纳入新模型排名的同时,还把平均调用成本纳入基准指标,方便开发者结合自身需求做选择。
在 10 月 26 日的这次更新中,谷歌新增标注了每个模型所采用的推理等级,同时补充了多款模型的测试结果,包括 OpenAI 的 GPT-6 Sol、GPT-6.1 Sol、Claude Sonnet 5、Claude Sonnet 5.5,以及谷歌自家的 Gemini 4 Argon。
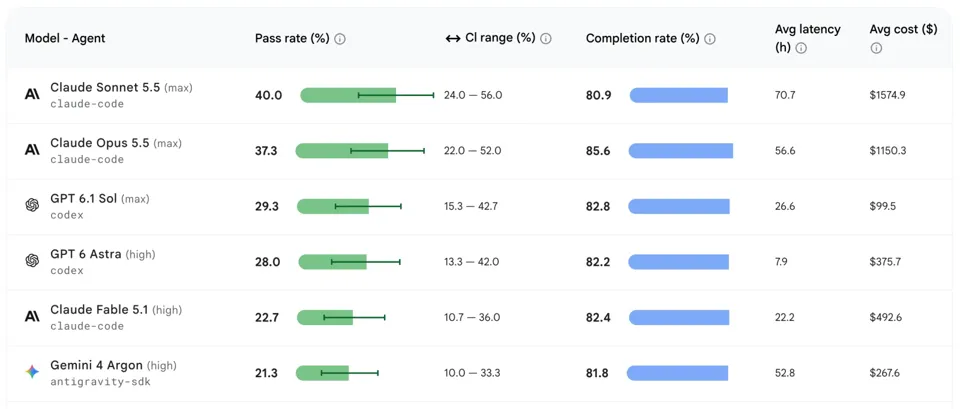
目前榜单第一名是 Claude Sonnet 5.5,通过率 40%,完成率 80.9%。10 月初加入榜单的 Claude Opus 5.5 位列第二。
OpenAI 的 GPT-6.1 Sol 可能是此次最值得关注的新增模型,通过率 29.3%,完成率 82.8%,但调用成本仅 99.50 美元(IT之家注:现汇率约合 664.8 元人民币);相比之下,排名第一的 Claude 调用成本高达 1,574.90 美元(现汇率约合 10,522 元人民币)。
而谷歌自家的 Gemini 4 Argon 首秀表现平平,排在第五位,明显落后于其他前沿模型,甚至不及 Claude Fable 5.1,通过率仅有 21.3%,完成率 81.8%,平均调用成本 267.70 美元(现汇率约合 1,789 元人民币)。
谷歌官宣 Gemini 4 Argon 之后不久,就有内部消息称该模型“难以处理部分编程任务”,不过谷歌依旧认可其能力。