机器之心 (微信公众号) · 10/16/2026, 11:23:00
Nanjing Startup Launches Framework for Low-Cost Collective Model Intelligence
SinapisAI released a technical report proposing 'Collective Model Intelligence' and launched the Mio 1.0 Lite system. By profiling capabilities of numerous models and enabling dynamic coordination, it achieved top average scores across nine benchmarks with the lowest cost, validating models as a fourth growth factor beyond compute, algorithms, and data.
SOURCE COVERAGEFull Original Report
模型群体智能(Collective Model Intelligence)。
机器之心发布
过去数十年,AI 能力的提升沿着三个方向不断加码:更大的算力、更好的算法、更多的数据。大模型时代尤其如此,更大的集群、更多的参数、海量的语料,造就了一个又一个能力超群的单体模型。
当超级个体足够多时,一个更大的想象空间随之打开。如果让这些模型在被充分了解的前提下,彼此连通、互相协作,会不会迸发出超越任何单个个体的智能?“十五五” 规划纲要在强调算力、算法、数据高效供给的同时,也明确提出 “鼓励多模态、智能体、具身智能、群体智能等技术创新”。沿着这个方向看,算力、算法、数据之外的第四要素,或许正是模型本身。
本周,今年刚成立的南大系初创公司南芥智能(SinapisAI)发布技术报告《Toward Collective Model Intelligence: Characterizing and Coordinating Models》。这是这家公司技术底座的第一次公开,系统介绍了其围绕海量模型协作构建的技术框架与初步实验结果:面向不断扩大的模型宇宙,为模型建立可量化的能力画像,再由 Mio(Models in One)结合任务需求与资源预算进行模型选择与协作。
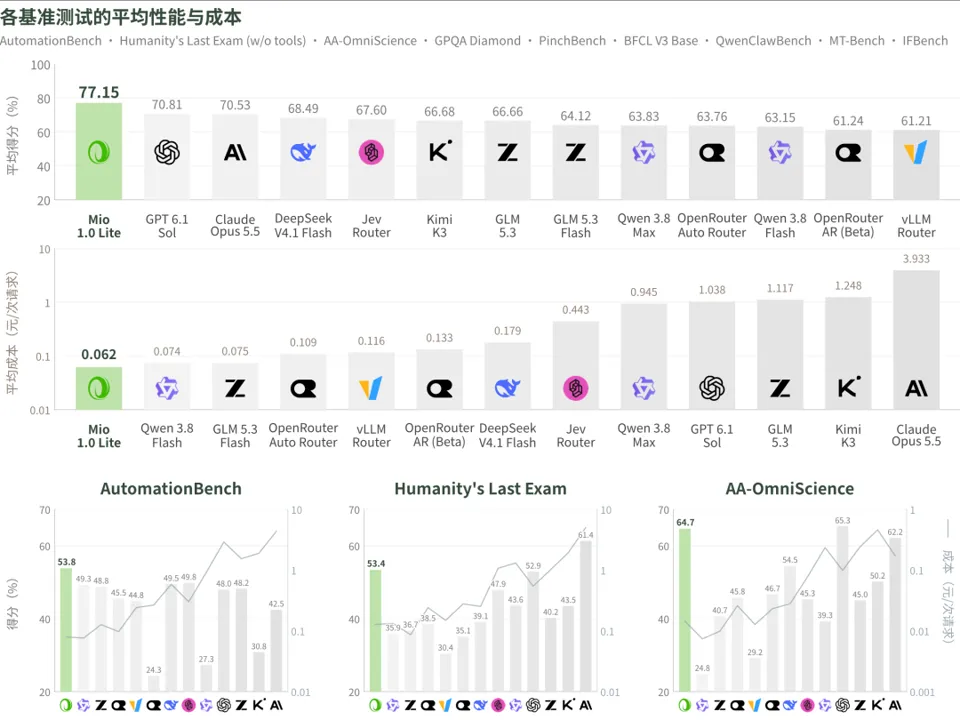
在本次九项基准的比较中,Mio 1.0 Lite 的平均得分最高、平均每请求费用最低。
报告给出了首份公开评测结果:Mio 1.0 Lite 与多个单体模型、路由方案进行比较,在九个公开 benchmark 上同时拿下平均分第一(77.15/100)和平均成本最低(每请求 0.06 元),在其中五个数据集上取得了最高分数,与分数次高的对手相比,成本减少 73.7%~97.5%。
南芥智能是南京大学人工智能学院的技术孵化企业,联合创始人孙腾中(CEO)、刘建东(CTO)等核心创始成员来自该学院 LAMDA 实验室,多位创始成员师从周志华院士。10 月 8 日,其产品平台 SinapisAI 刚刚开启公测,已收录 484 个模型。
模型:智能增长的第四要素
模型之所以能成为新的增长要素,源于两个同时发生的变化。其一,模型正在从一次性交付的技术产品,变成可以积累、复用、流通的资源,全球每周都有新模型诞生,即使技术同源,不同开发者训出的模型,也会长出不同的技能树;其二,单体模型继续变强的边际成本越来越高。海量模型各有所长,其互补与协作所蕴藏的增量,几乎还未被开采。
用报告结论部分的话说,一个模型的价值,取决于它在集体中的角色。一个平均分并不亮眼的专家模型,也可能补上其他模型缺少的能力。
这条路并非凭空而来。2016 年,中国科学院院士、南京大学副校长周志华提出 “学件(Learnware)” 范式,主张模型加规约、入库共享、按需复用。海量模型协作,正是这一范式在大模型时代的延伸。
在报告中,这条思路有一个正式的名称,模型群体智能(Collective Model Intelligence)。报告关注能力层面的协同,理解并协调各方独立开发模型的互补能力,以此改善任务效果与资源效率。
这条路也直接回应了 “十五五” 规划的两处部署。一处是鼓励群体智能等技术创新。在这座模型宇宙里,系统设计支持新模型注册、能力刻画和候选池审查,并据此更新可用模型集合,模型得以自由接入、动态退出,为模型能力的组织与按需调用提供基础。另一处是推进算力资源的集约化、绿色化发展。复用已经训练好的模型能力,有望减少部分重复训练与资源投入。
技术内核:看懂模型、选对模型、调得动模型
这套系统由四个技术主体构成,环环相扣。
看懂模型(Model Eval):要挑模型,先得懂模型,但对每个模型逐题进行全量评测,成本高昂。Model Eval 结合查询级响应建模与跨领域预测,利用历史评测信息和有限的新增观测,构建模型能力画像。
在覆盖 25 个模型、18 个 benchmark、逾 2.5 万条 query 的查询层实验中,系统估计模型在各 benchmark 上的平均得分,其平均分数估计误差低于 IRT、PSN-IRT 等对比方法。另一项覆盖 35 个模型、32 个领域的实验则单独评估跨领域预测,以已测领域的准确分数为锚点,预测模型在未测领域的表现。
选对模型(Mio):它将模型能力证据与当前任务状态结合,先筛出满足接口、模态和预算等约束的候选,再比较预期任务表现,并在表现接近的模型中,选择成本与延迟更合适的方案。
报告提出的候选池维护机制是动态的,随新模型接入、能力证据与服务条件变化持续调整。组池时,它评估方向性替换损失,也就是换掉一个模型之后,看它在具体请求上的独有优势是否有人接班。只有留下的模型在领域覆盖、替换损失和服务兼容性上都接得住,一个模型才会被移出候选池,平均分未必突出、却能补足短板的专家模型因此被保留下来。
调得动模型(Mos):选定模型之后,还有一个常被忽视的问题:相同型号的模型常有多个来源,不同服务商的端点在价格、限流、排队时延、生成速度和可用性上差异巨大,且随时会发生变化。
模型服务系统 Mos 综合端点健康、可用容量、费用与预计延迟,为已选模型安排执行来源,并在失败类型与响应进度允许时,进行有条件的重试和同模型端点切换。配套的模型分发网络在预热共享缓存下,将模型文件读取速度最高提升 23.3 倍(不含缓存预热、参数传入 GPU 与推理环节),提高了自管理部署中的模型文件分发效率。
装下这一切(Model Space):底层的模型仓库为每个模型建立版本化身份,让 484 个模型可以被动态地接入、更新与退出,能力画像随版本刷新。
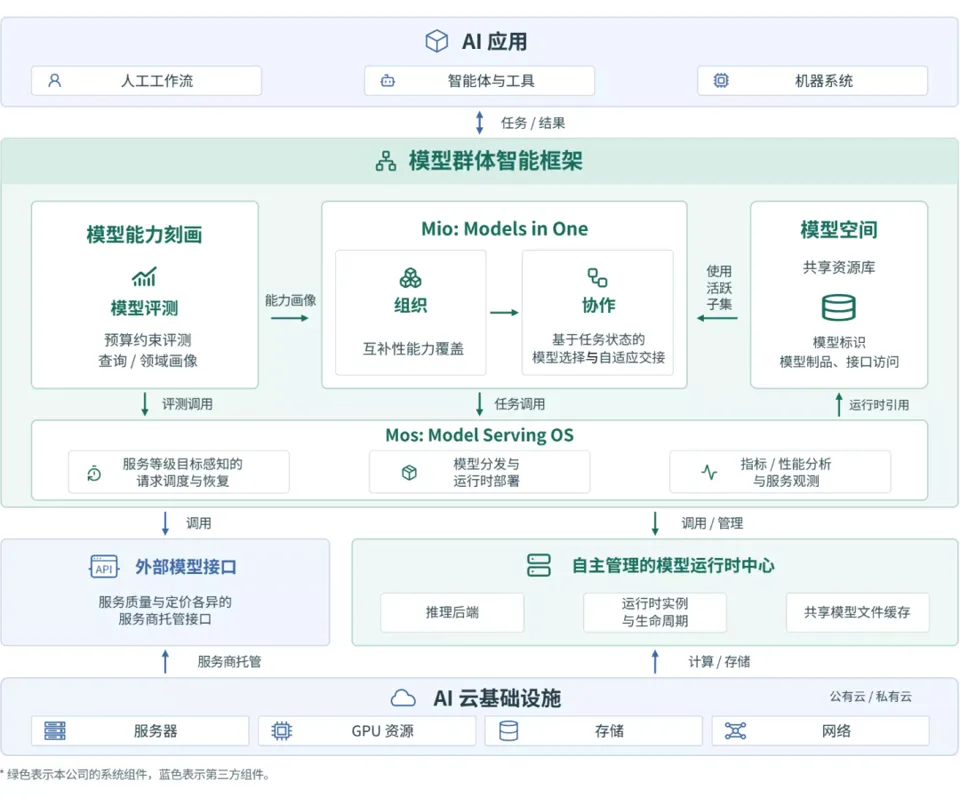
模型群体智能架构设计
实战检验:平均分第一,成本最低
根据报告,Mio 1.0 Lite 与 8 个国内外顶级模型以及 4 个路由服务在 9 个公开 benchmark 上同场竞技,成绩亮眼:Mio 九项平均分 77.15/100,全场最高;平均每请求成本 0.06 元,全场最低。对比分数最高的对手 GPT 6.1 Sol ,高 6.35 分,成本低 94.0%;对比成本最低的对手 Qwen 3.8 Flash ,高 14.00 分,成本更低 16.4%。具体表现如下:
- AutomationBench(Agent 执行):53.83%,全场第一,比第二名 Jev Router 高 4.00 个百分点;
- BFCL V3 Base Multi-Turn(函数调用):77.50%,全场第一,比第二名 Opus 5.5 高 11.50 个百分点,成本仅为后者的 2.7%;
- GPQA Diamond(科学推理):95.96%,全场第一,比第二名 Kimi K3 高 2.46 个百分点;
- Humanity’s Last Exam(无工具推理):53.38%,第二名,与第一名 Opus 5.5 相差 7.97 个百分点,成本低 97.5%;
- AA-OmniScience(事实知识):64.67%,第二名,与第一名 GPT 6.1 Sol 相差 0.67 个百分点,成本低 85.3%;
- PinchBench(Agent 执行):96.27%,全场第一,比第二名 GLM 5.3 高 0.23 个百分点;
- QwenClawBench(Agent 执行):69.38%,第二名,与第一名 Qwen 3.8 Max 相差 0.43 个百分点,成本低 95.1%;
- IFBench(指令遵循):92.00%,全场第一,比第二名 Qwen 3.8 Max 高 9.20 个百分点,成本低 91.6%;
- MT-Bench(多轮对话):9.138/10,第三名,与第一名 GPT 6.1 Sol 相差 0.223 分,成本低 89.7%;
报告同样标注了边界:在 HLE 等高难度任务上,不计成本的旗舰模型仍有质量优势。Mio 的定位是寻求更好的质量、成本与覆盖均衡。团队还构建了 RobustRouteBench 鲁棒性基准,在通用文本、多模态和中文三类场景的 18,982 条最终测试请求上,离线评估 Mio 请求级选择器在固定模型池中的选择鲁棒性,并避免开发集同源请求进入最终测试。
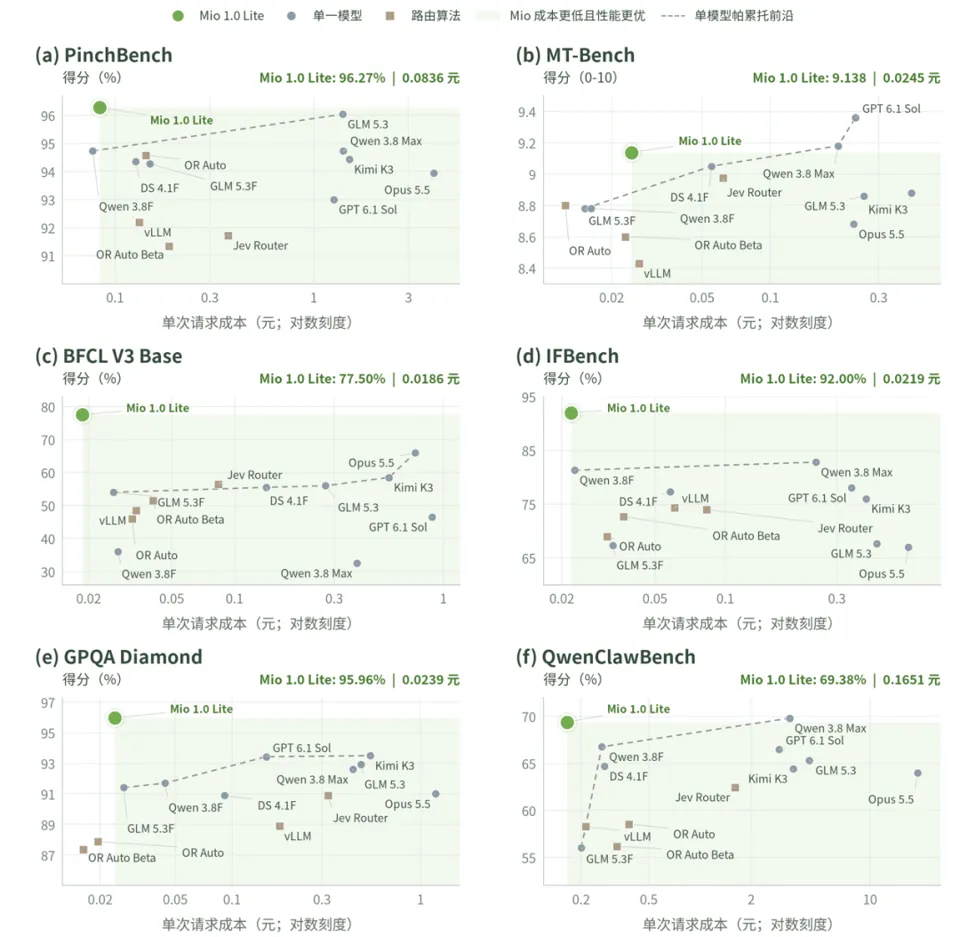
与单模型 / 路由算法相比,Mio 1.0 Lite 兼具性能与成本优势
商业逻辑:淘金热里,“卖水人” 正在被定价
淘金热中,最确定的生意往往是卖水。这份报告发布的时机值得玩味:过去几个月,Stripe 宣布同意收购 AI 模型网关和路由平台 OpenRouter,英伟达宣布以 129 亿美元收购开放模型开发者社区 Hugging Face。一边是模型与应用之间的路由入口,一边是最大的模型仓库,资本已经开始为连接供给与需求的 “卖水人” 单独定价。
这层生意拆开看,是三个递进的环节。仓库解决被发现,路由解决被选择,协作解决被组合,南芥智能的布局正与此对应:模型广场提供模型发现入口,Mio 承接按任务的模型选择与协作,底层系统则提供能力刻画和执行支持。
此前,公司已完成由南京市创新投资集团、鼎信资本等机构参与的近亿元首轮融资。值得一提的是,南芥智能不自研通用大模型、不与模型厂商竞争,这种中立性本身就是稀缺的资产。
值得称道的是报告的克制。报告明确指出,系统集成的整体收益、以及 “集体智能随经验持续进化” 的愿景,仍待进一步验证。按照报告的设想,这条进化路径是递归式的,系统用集体的能力诊断自身弱点、修正自身机制、再验证改动,目标是让每一轮循环同时改善任务表现与系统的自我改进能力。这不是终结 Scaling Law 的故事,而是一个更朴素的判断,当单个模型的能力增长边际递减,组织已有模型的能力,本身就是一条崭新的进步曲线。
集体智能的愿景很宏大,但南芥智能给自己的定位很具体。谈到长远想做什么,南芥智能 CEO 孙腾中用了一个类比:“电力改变世界的关键,不仅在于造出更大的发电设施,更在于建成电网,让每一度电都能被安全、高效地送到需要它的地方,智能亦是如此。我们不生产模型,我们要做的是模型时代的电网,让每一种模型能力都被看见、被调度,送到最需要它的任务上。”
模型宇宙还在膨胀。算力、算法、数据之后,模型究竟能不能成为智能增长的第四要素?这座宇宙里最先回答这个问题的人,也可能最先兑现它的红利。
南芥智能的产品平台 SinapisAI 现已开启公测,访问 https://sinapis.ai 即可体验。技术报告全文,点击阅读原文或复制链接查看:https://github.com/SinapisAI/collective-model-intelligence
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:[email protected]