Qwen3.8-LiveTranslate Launches: New Architecture Cuts Latency to 2.3s
The Qwen team released Qwen3.8-LiveTranslate, reducing average latency (LAAL) in real-time interpretation from 2.8s to 2.3s via a new Interleave audio-text architecture. Building on support for 60 languages, the model introduces real-time speaker diarization, synchronized source-target output, and long-context disambiguation to enhance accuracy and voice cloning stability in multi-speaker scenarios.
Related Entities
Full Report
Contents10 sections
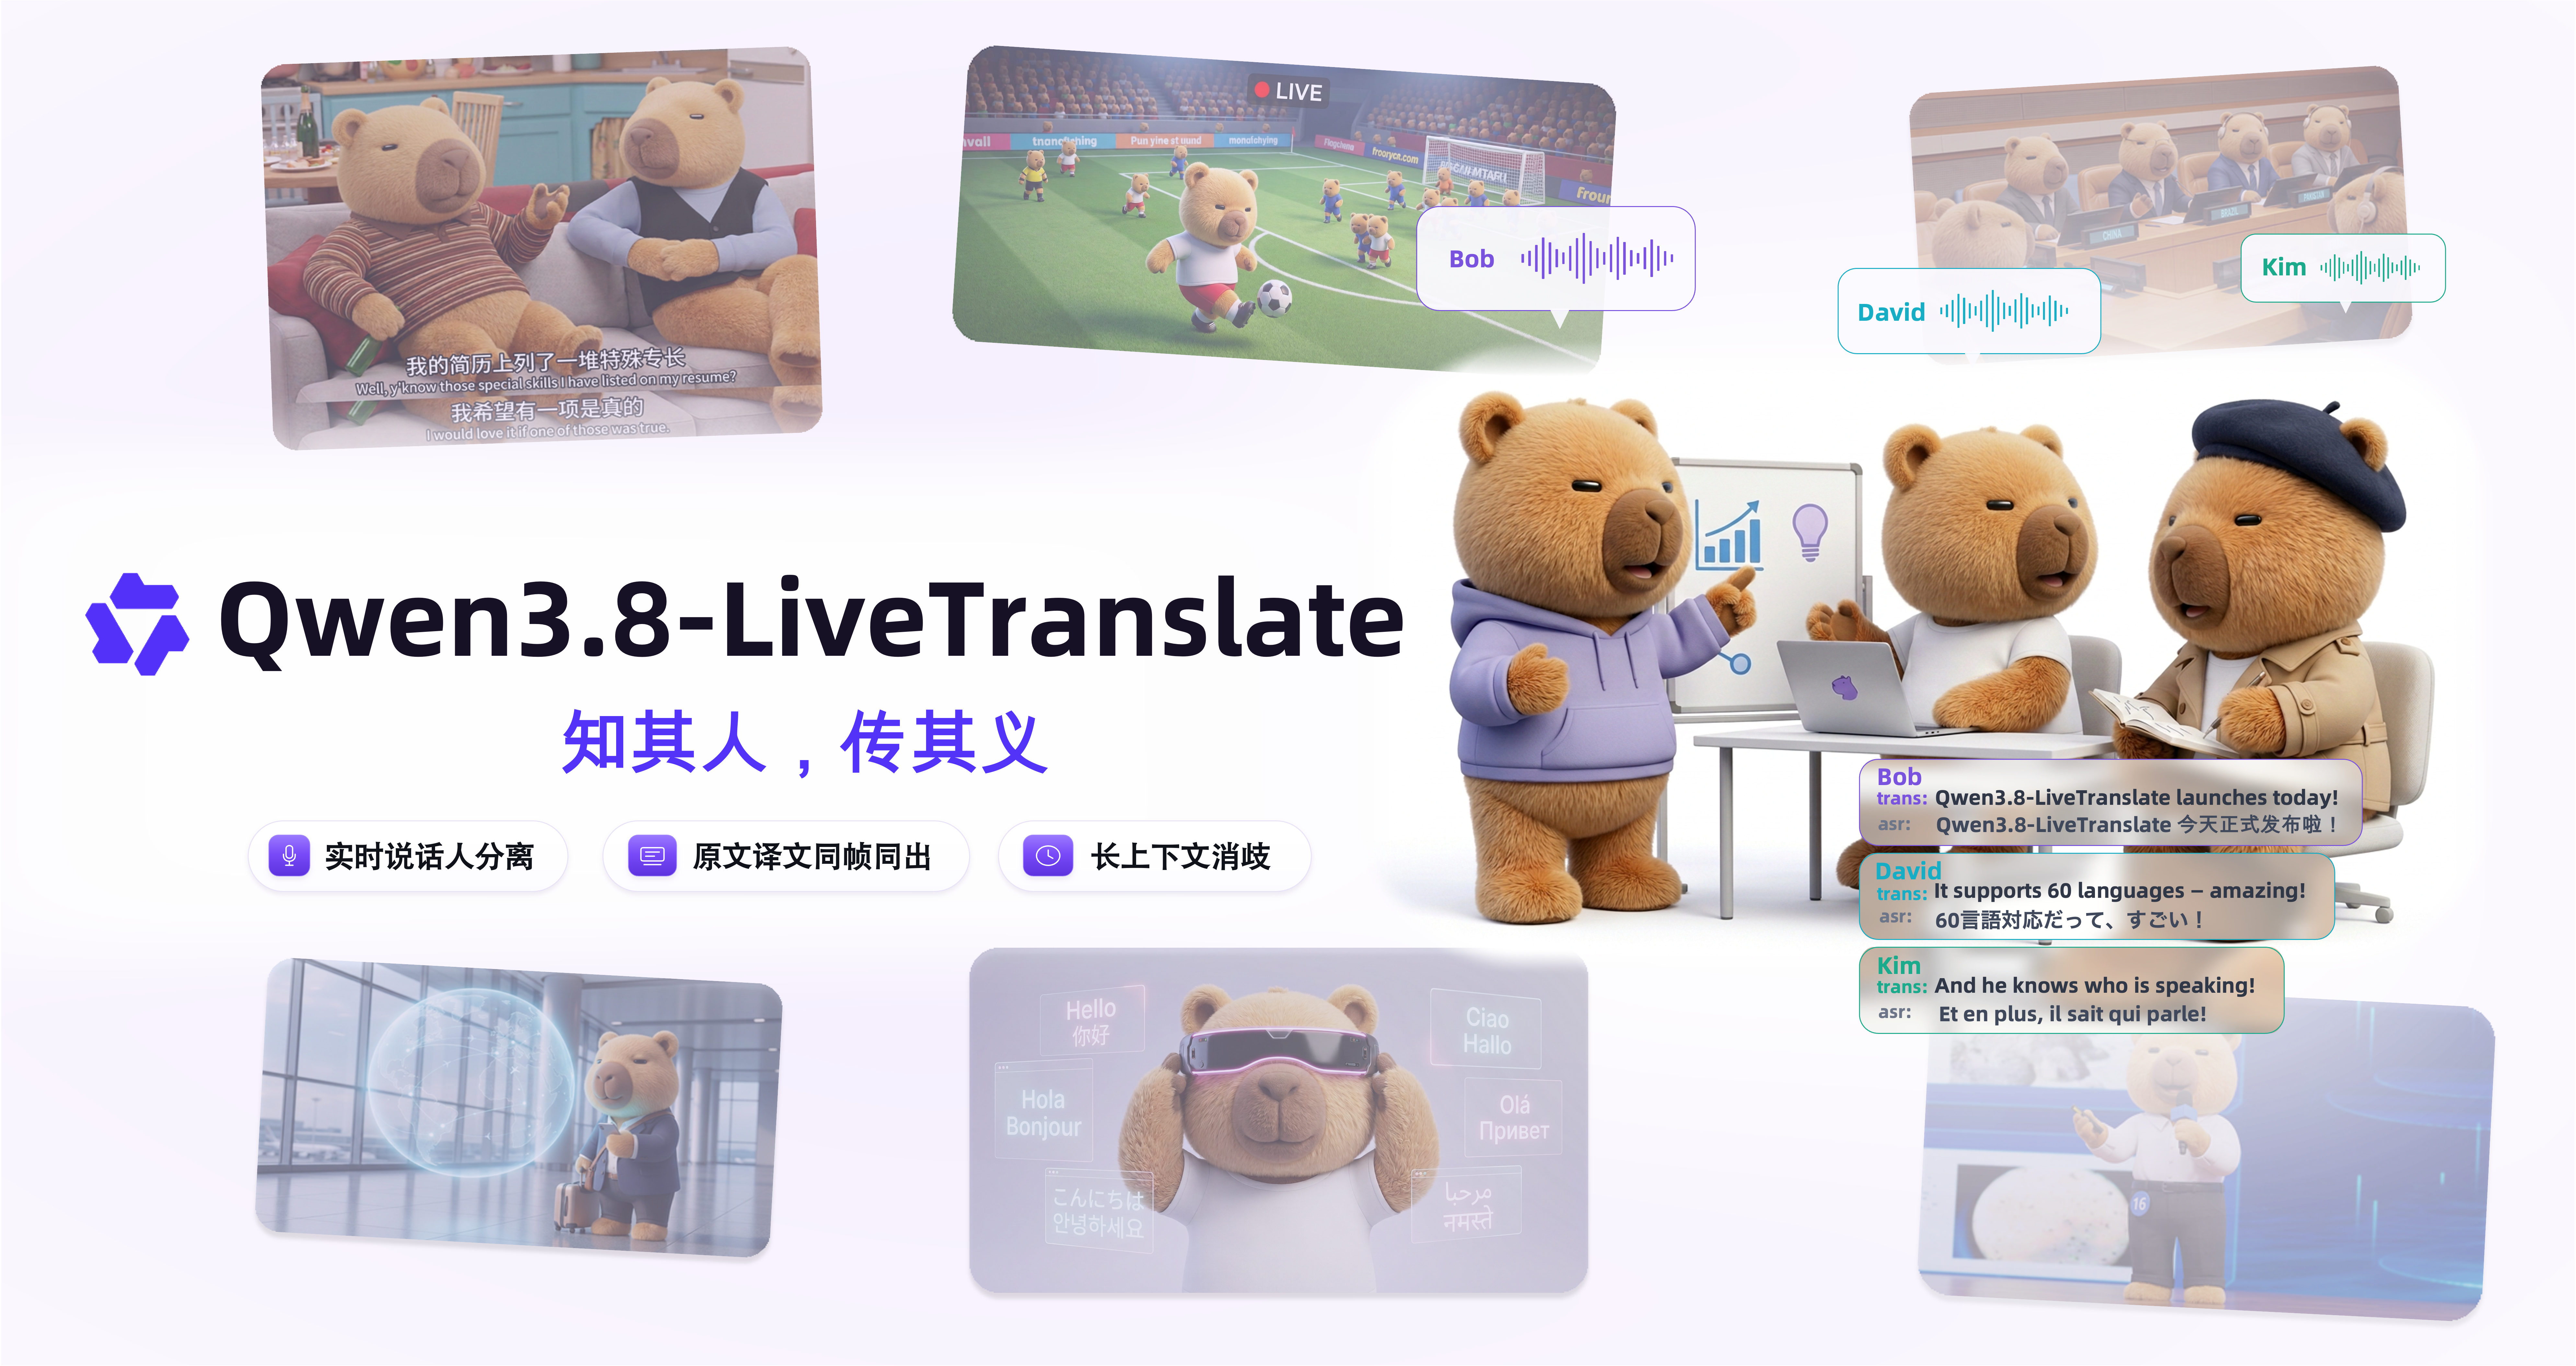
同传不只是翻译得快,更要听得清、译得准。Qwen3.8-LiveTranslate 以 Interleave 架构重构实时同传,忠实度、流畅度、简洁度全面提升,字均延迟(LAAL)从 2.8 秒降至 2.3 秒。我们希望同传不只传递语言、也能保留交流中人物与上下文信息,因此,在支持 60 种语言的基础上,Qwen3.8-LiveTranslate 新增三项能力让同传更广泛的应用于真实场景中:实时说话人分离,每句话归属清晰,音色复刻更稳定;原文译文同帧同出,双语同屏;长上下文消歧,联系前文读懂当下,人名术语翻译更精准。
核心亮点#
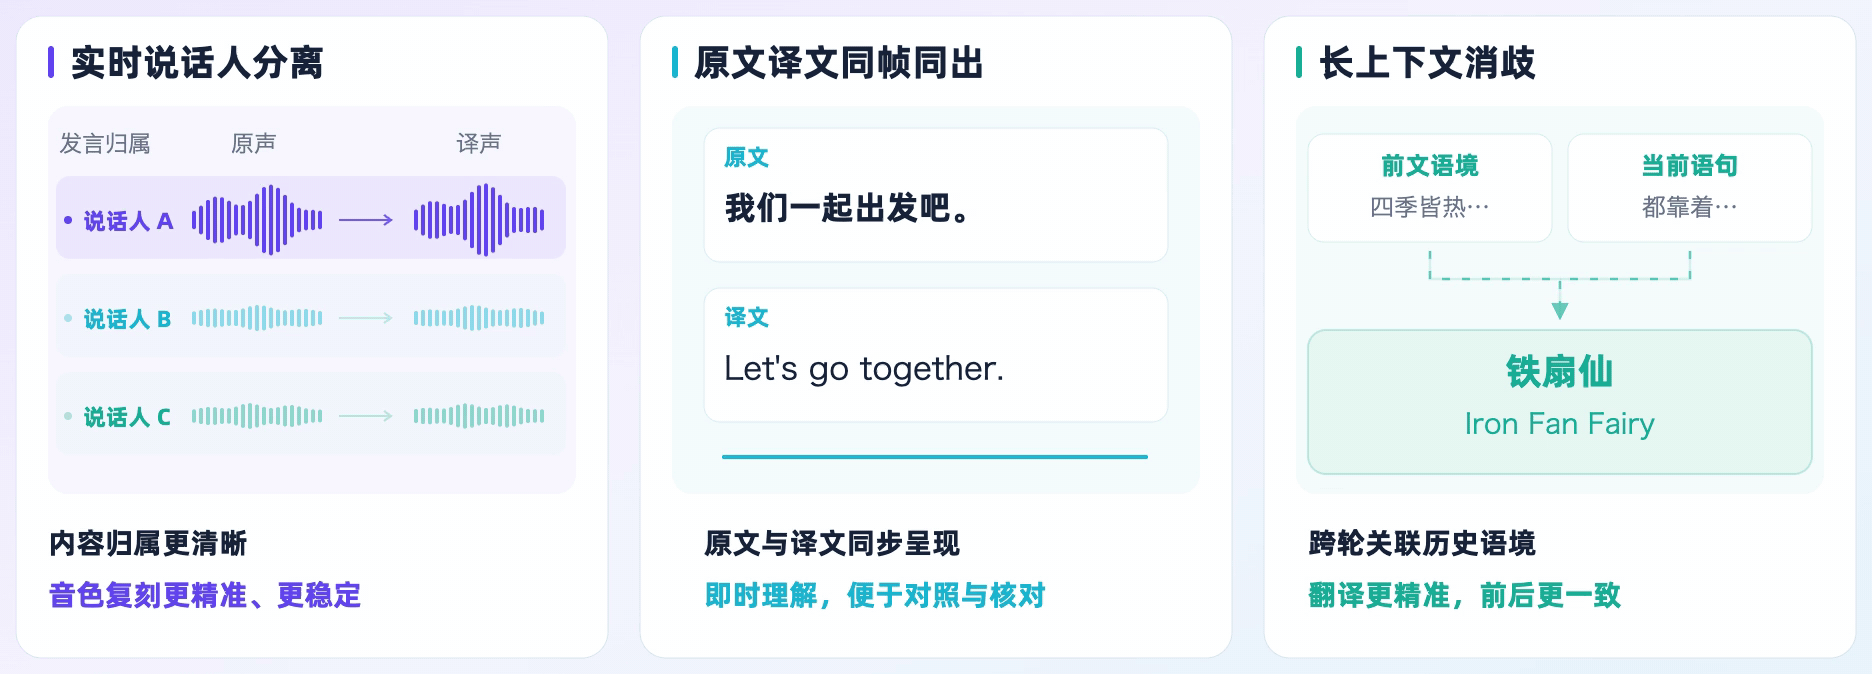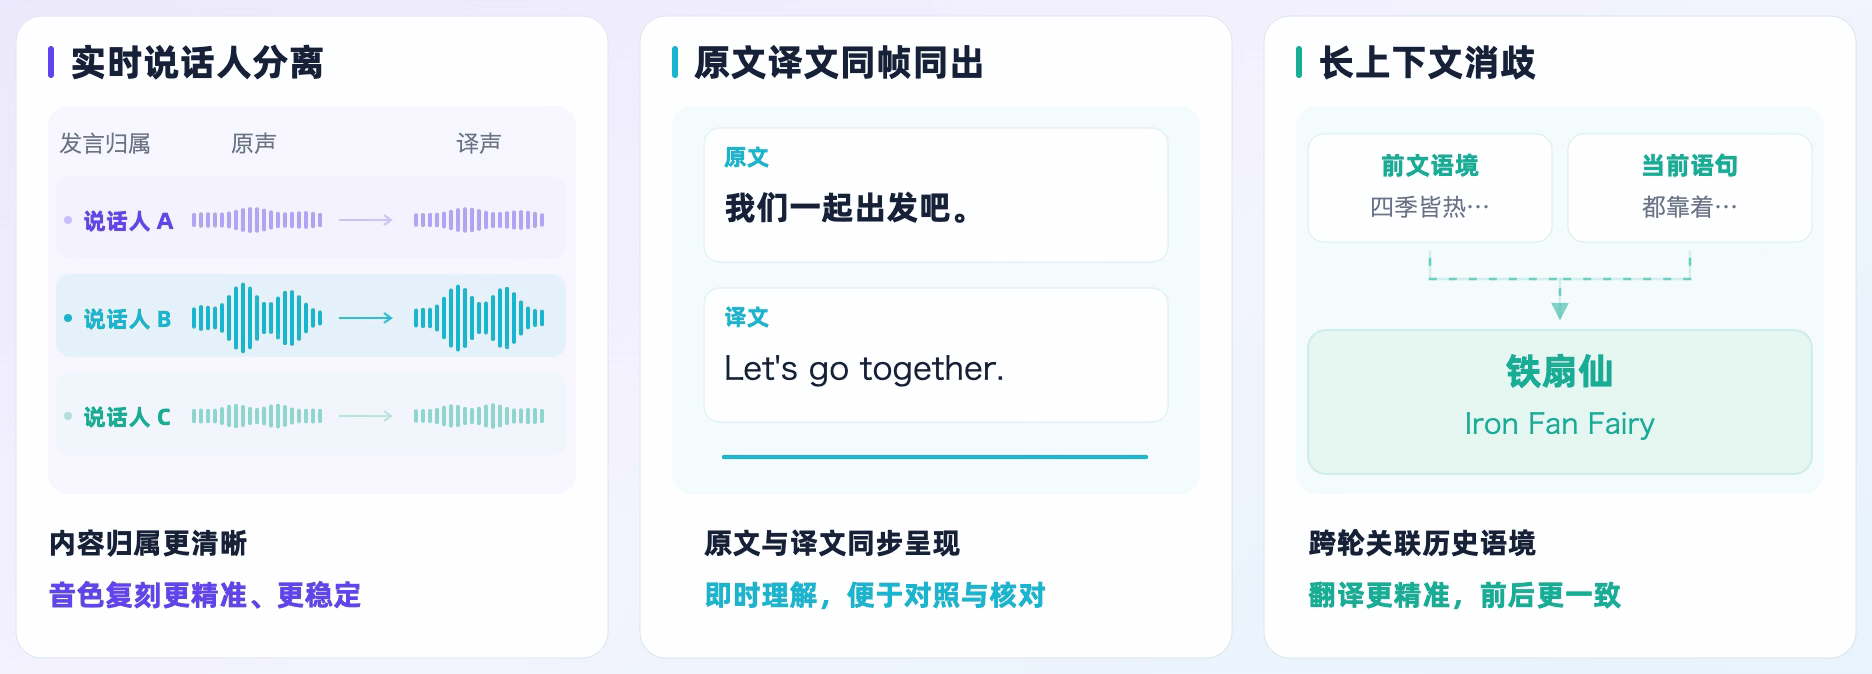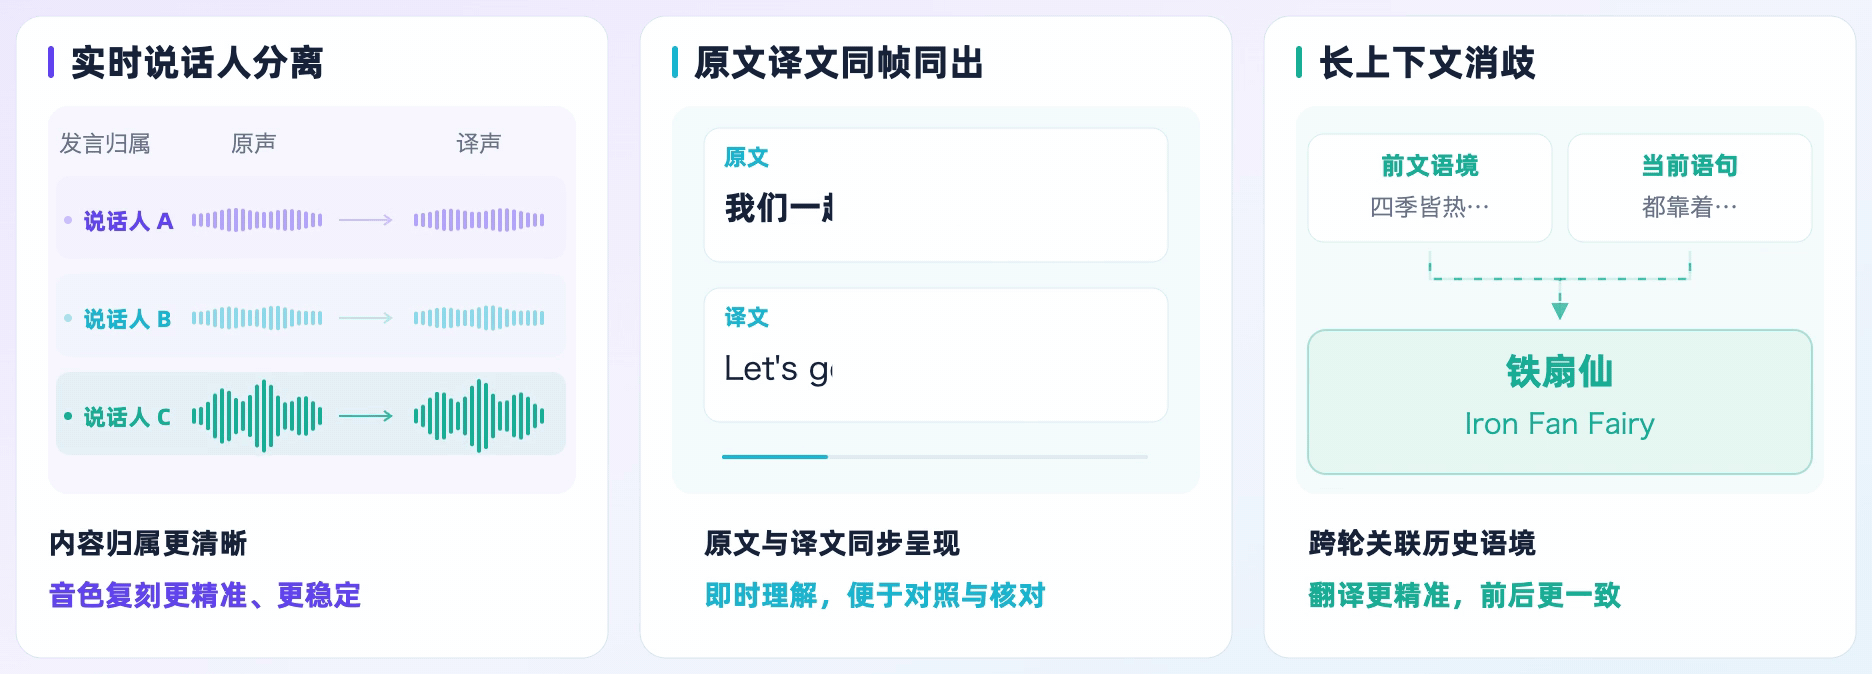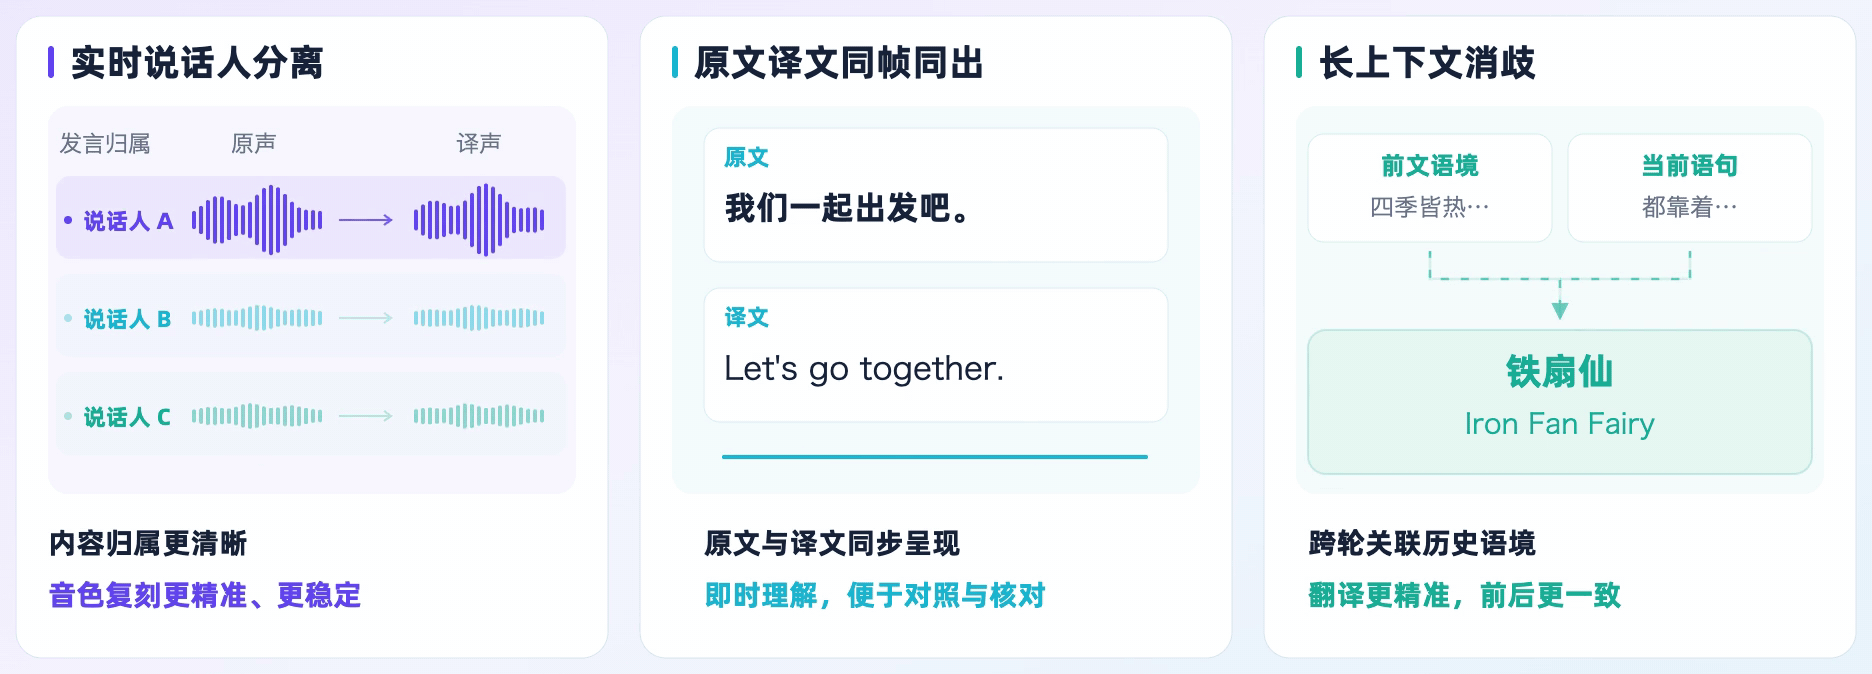
- Interleave 架构:音频与文本交织,更高质量、更低延迟。 本代模型将同传重构为音频-文本交织的单流形式,已听音频和已出译文均可缓存复用,翻译质量相比上代显著提升,字均延迟(LAAL)从上一代的 2.8 秒降至 2.3 秒。
- 实时说话人分离:内容归属更清晰,音色复刻更稳定。 在多人交替发言时,区分不同说话人及其发言内容,并帮助译文语音更准确、稳定地保留发言人的音色。
- 原文译文同帧同出:原文与译文同步呈现。 在同传中双语对齐,兼顾即时理解与原文核对,为字幕展示、内容整理、检索等后续功能提供基础,应用空间更广泛。
- 长上下文消歧:跨轮关联历史语境,翻译更精准。 结合前文和历史语境,缓解复杂场景专有名词、指代等问题带来的歧义,保持表达的一致性。
模型架构#
Qwen3.8-LiveTranslate 采用基于 Hybrid MoE 的 Thinker–Talker 双模块设计,通过 Interleave 方式衔接流式理解、文本输出与语音生成。其中,Thinker 把视频、音频、原文与译文编排进同一条因果序列,按时序交替排列、端到端产出,让理解与翻译在单一序列内完成;Talker 再结合译文和源音频,把译文合成为保留原说话人音色的译文语音。
模型效果#
多说话人长音频能力#
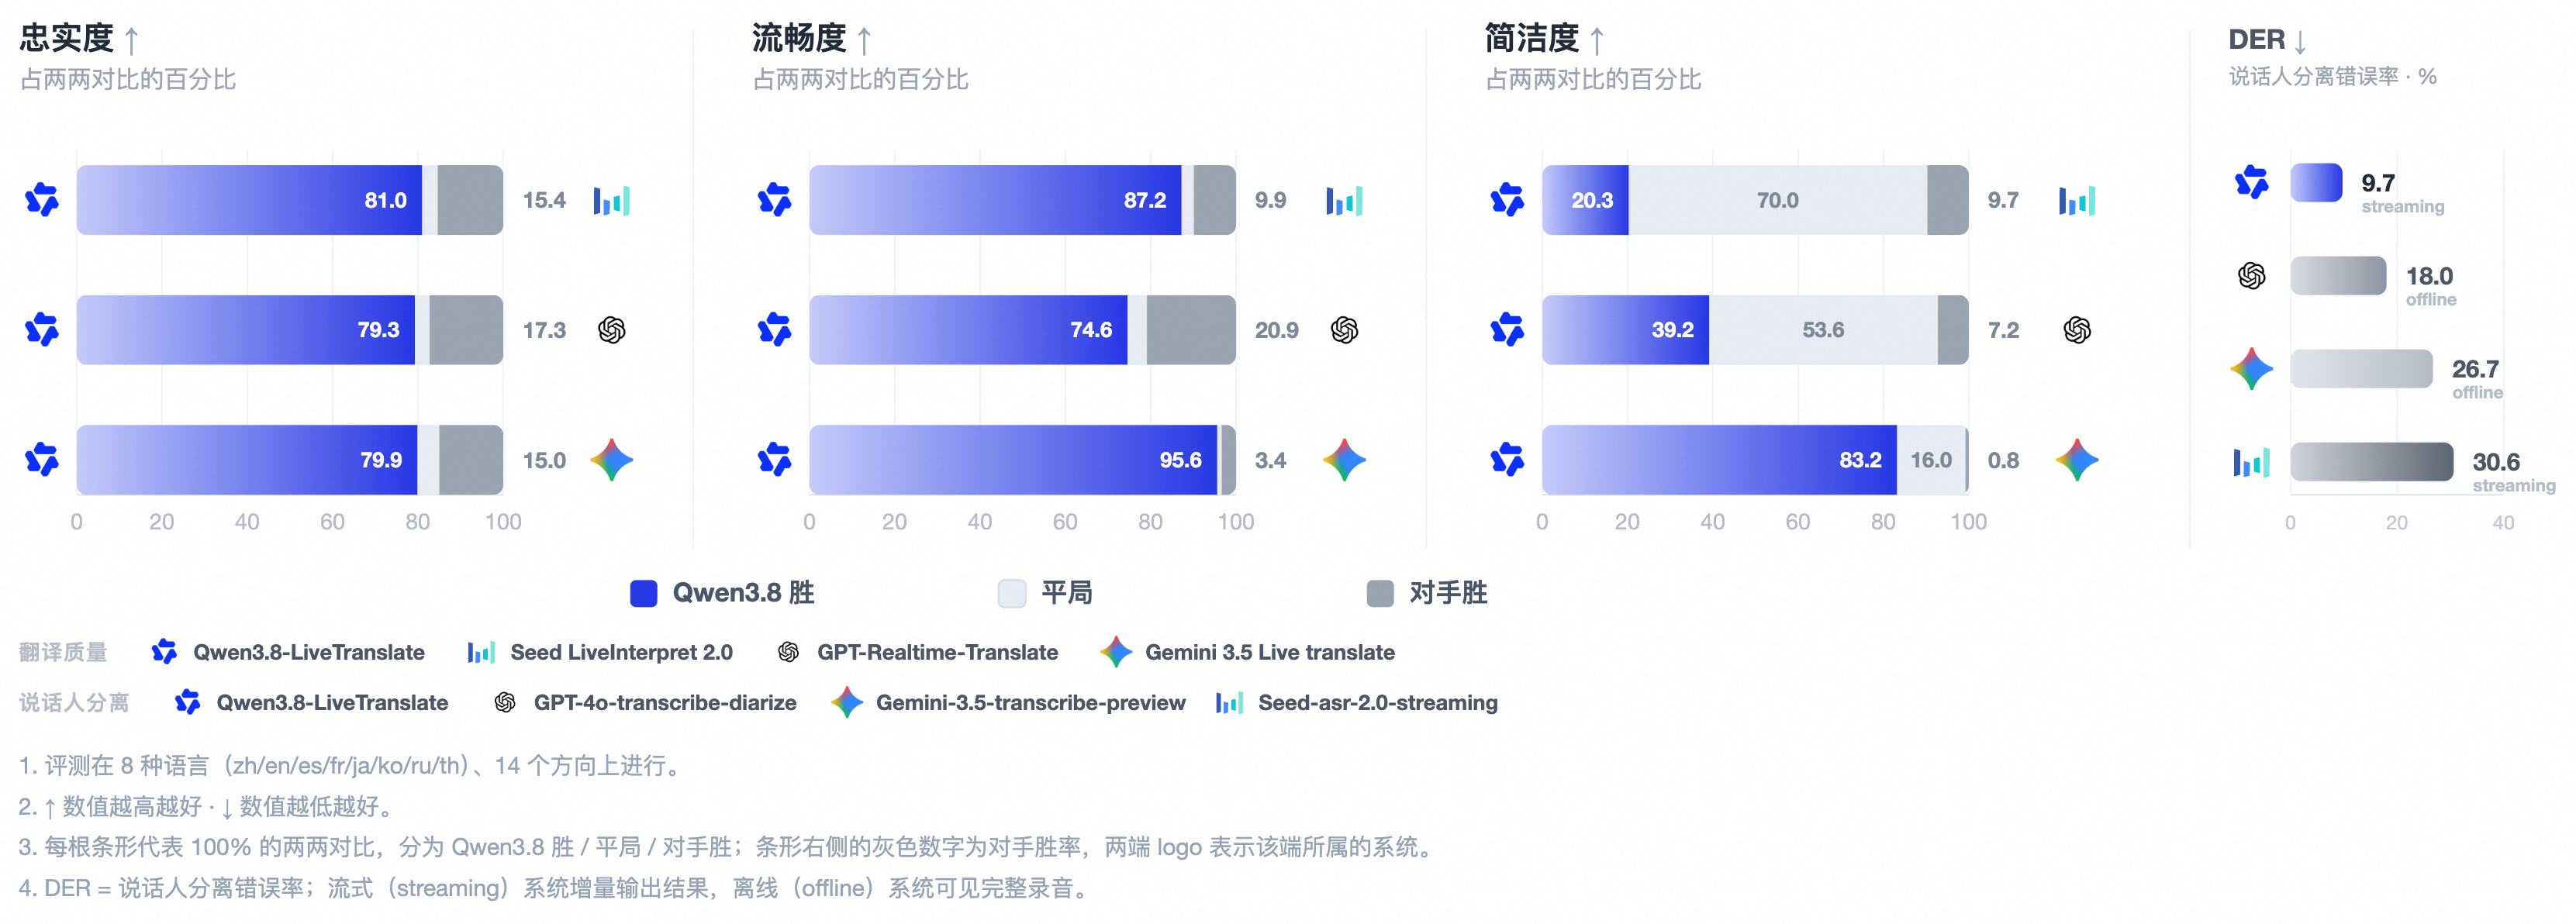
在覆盖 14 个语向的多说话人长音频评测集 Omnilingua-MSpeaker 上,Qwen3.8-LiveTranslate 在翻译的忠实度、流畅度、简洁度以及说话人识别的错误率 DER(Diarization Error Rate,说话人分离错误率)四个维度上均优于目前行业主流实时同传系统。
多语言效果#
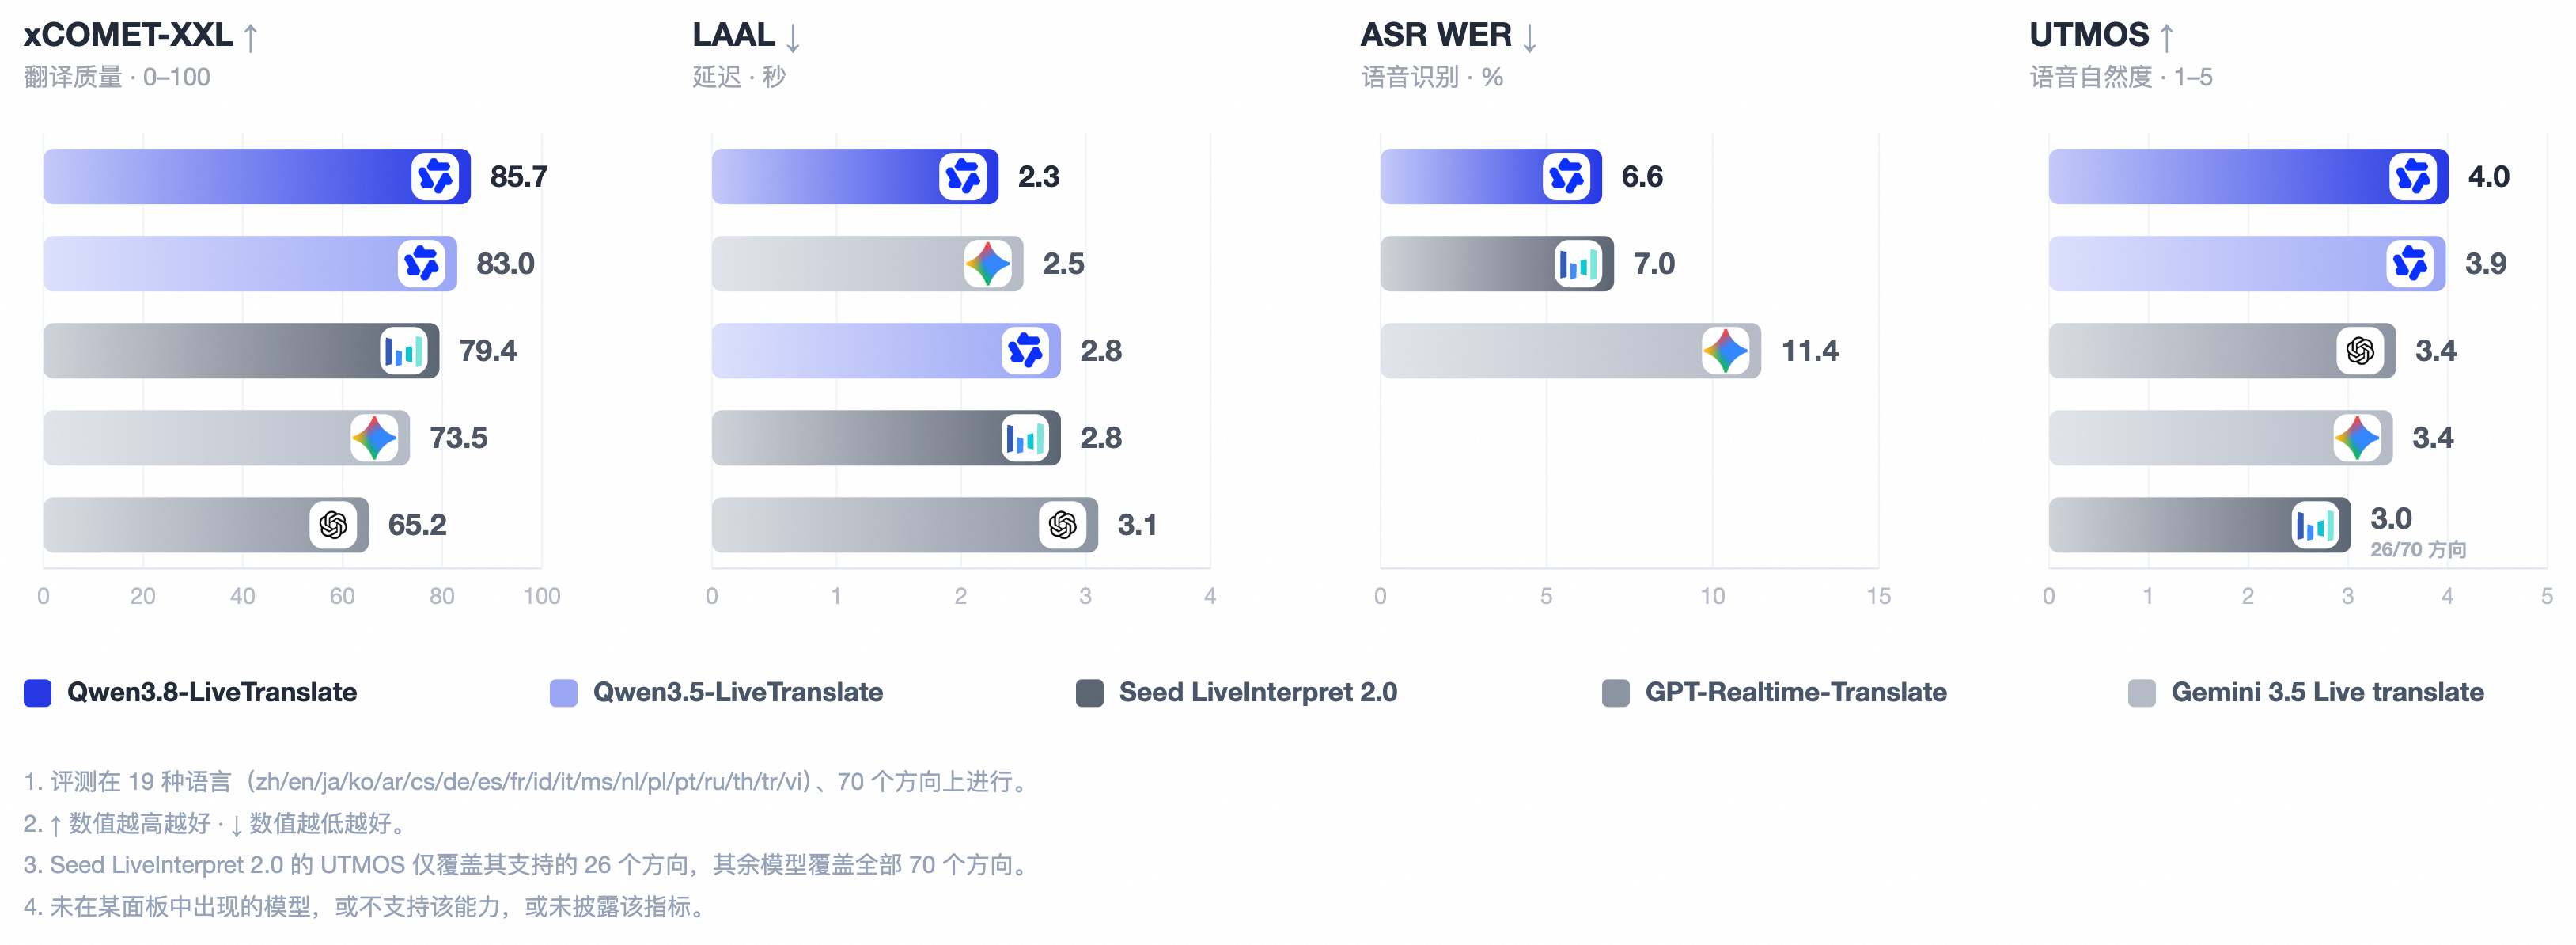
我们在公开 FLEURS 音频测试集上评测了 70 个语向的实时同传表现。Qwen3.8-LiveTranslate 在翻译质量、字均延迟、语音识别准确率以及语音合成质量四个维度上领先于上一代以及当前主流实时同传系统。
🎬 精彩演示#
下面通过《西游记》中的两段对话和一组同音词示例,展示说话人归属与音色克隆、双语同步输出,以及上下文和视觉信息对翻译消歧的帮助。
支持的语种#
| 类别 | 支持语种 |
|---|---|
| 输入音频 & 输出文本语言 | 60 种语言 中文、英语、德语、意大利语、葡萄牙语、西班牙语、日语、韩语、法语、俄语、泰语、印度尼西亚语、阿拉伯语、越南语、土耳其语、芬兰语、波兰语、印地语、荷兰语、捷克语、乌尔都语、菲律宾语、瑞典语、丹麦语、希伯来语、冰岛语、马来语、挪威语、波斯语、南非荷兰语、阿斯图里亚斯语、阿塞拜疆语、白俄罗斯语、孟加拉语、波斯尼亚语、保加利亚语、粤语、加泰罗尼亚语、宿务语、克罗地亚语、爱沙尼亚语、加利西亚语、古吉拉特语、希腊语、匈牙利语、爪哇语、卡纳达语、哈萨克语、柯尔克孜语、拉脱维亚语、马其顿语、马拉雅拉姆语、马拉地语、旁遮普语、罗马尼亚语、斯洛伐克语、斯洛文尼亚语、斯瓦希里语、塔吉克语、乌克兰语 |
| 输出音频语言 | 29 种语言 中文、英语、德语、意大利语、葡萄牙语、西班牙语、日语、韩语、法语、俄语、泰语、印度尼西亚语、阿拉伯语、越南语、土耳其语、芬兰语、波兰语、印地语、荷兰语、捷克语、乌尔都语、菲律宾语、瑞典语、丹麦语、希伯来语、冰岛语、马来语、挪威语、波斯语 |
通过 DashScope API 使用 Qwen3.8-LiveTranslate#
下面是一个完整的实时同传客户端示例:采集麦克风音频、流式发送至服务端,并接收并播放译文。本代新增的说话人分离与原文译文同步输出能力均通过会话配置开启,服务端在返回译文的同时给出说话人标识与源语言原文,无需额外调用 ASR 接口。
import os
import time
import base64
import asyncio
import json
import websockets
import pyaudio
import queue
import threading
import traceback

class LiveTranslateClient:
    """与 DashScope 实时翻译服务交互的客户端:采集麦克风音频、发送至服务端、接收并播放译文。"""

def __init__(self, api_key: str, workspace_id: str, target_language: str = "en", *, audio_enabled: bool = True):
        if not api_key:
            raise ValueError("API key cannot be empty.")
        if not workspace_id:
            raise ValueError("Workspace ID cannot be empty.")

self.api_key = api_key
        self.workspace_id = workspace_id
        self.target_language = target_language
        self.audio_enabled = audio_enabled
        self.ws = None
        # 华北 2(北京)地域接入地址;{workspace_id} 为百炼业务空间 ID,其它地域 URL 不同
        self.api_url = (
            f"wss://{workspace_id}.cn-beijing.maas.aliyuncs.com"
            "/api-ws/v1/realtime?model=qwen3.8-livetranslate-flash-realtime"
        )

# 音频输入参数(麦克风采集)
        self.input_rate = 16000
        self.input_chunk = 1600
        self.input_format = pyaudio.paInt16
        self.input_channels = 1

# 音频输出参数(本地播放)
        self.output_rate = 24000
        self.output_chunk = 2400
        self.output_format = pyaudio.paInt16
        self.output_channels = 1

# 运行状态与播放资源
        self.is_connected = False
        self.audio_player_thread = None
        self.audio_playback_queue = queue.Queue()
        self.pyaudio_instance = pyaudio.PyAudio()
        self.session_finished_event = asyncio.Event()

async def connect(self):
        """与翻译服务建立 WebSocket 连接。"""
        headers = {"Authorization": f"Bearer {self.api_key}"}
        try:
            self.ws = await websockets.connect(self.api_url, additional_headers=headers)
            self.is_connected = True
            print(f"成功连接到服务端: {self.api_url}")
            await self.configure_session()
        except Exception as e:
            print(f"连接失败: {e}")
            self.is_connected = False
            raise

async def configure_session(self):
        """配置翻译会话:目标语言、音频格式与可选能力。"""
        config = {
            "event_id": f"event_{int(time.time() * 1000)}",
            "type": "session.update",
            "session": {
                # output_modalities 决定服务端返回内容的形式:
                #   ["text", "audio"] —— 同时返回译文文本和合成语音(推荐)
                #   ["text"]          —— 仅返回译文文本
                "output_modalities": ["text", "audio"] if self.audio_enabled else ["text"],
                "input_audio_format": "pcm",
                "output_audio_format": "pcm",
                # input_audio_transcription:开启源语言识别(ASR)。
                # 将 model 设为 'qwen3-asr-flash-realtime',可在翻译的同时拿到原文识别结果。
                # "input_audio_transcription": {
                #     "model": "qwen3-asr-flash-realtime",
                #     "language": "zh"  # 指定源语言;缺省为 'en'
                # },
                "translation": {
                    "language": self.target_language,
                    # corpus:注入热词,对专有名词、行业术语等可显著提升识别与翻译准确率。
                    # "corpus": {
                    #     "phrases": {
                    #         "人工智能": "Artificial Intelligence",
                    #         "机器学习": "Machine Learning"
                    #     }
                    # }
                }
            }
        }
        print(f"发送会话配置: {json.dumps(config, indent=2, ensure_ascii=False)}")
        await self.ws.send(json.dumps(config))

async def send_audio_chunk(self, audio_data: bytes):
        """将一块音频数据进行 base64 编码后发送至服务端。"""
        if not self.is_connected:
            return

event = {
            "event_id": f"event_{int(time.time() * 1000)}",
            "type": "input_audio_buffer.append",
            "audio": base64.b64encode(audio_data).decode()
        }
        await self.ws.send(json.dumps(event))

async def send_image_frame(self, image_bytes: bytes, *, event_id: str | None = None):
        """将一帧图像发送至服务端,作为视觉上下文辅助翻译。"""
        if not self.is_connected:
            return
        if not image_bytes:
            raise ValueError("image_bytes 不能为空")

image_b64 = base64.b64encode(image_bytes).decode()
        event = {
            "event_id": event_id or f"event_{int(time.time() * 1000)}",
            "type": "input_image_buffer.append",
            "image": image_b64,
        }
        await self.ws.send(json.dumps(event))

def _audio_player_task(self):
        """后台线程任务:从播放队列读取 PCM 数据,写入扬声器输出流。"""
        stream = self.pyaudio_instance.open(
            format=self.output_format,
            channels=self.output_channels,
            rate=self.output_rate,
            output=True,
            frames_per_buffer=self.output_chunk,
        )
        try:
            while self.is_connected or not self.audio_playback_queue.empty():
                try:
                    audio_chunk = self.audio_playback_queue.get(timeout=0.1)
                    if audio_chunk is None:  # 收到结束信号,退出播放循环
                        break
                    stream.write(audio_chunk)
                    self.audio_playback_queue.task_done()
                except queue.Empty:
                    continue
        finally:
            stream.stop_stream()
            stream.close()

def start_audio_player(self):
        """启动后台音频播放线程(仅在启用音频输出时生效)。"""
        if not self.audio_enabled:
            return
        if self.audio_player_thread is None or not self.audio_player_thread.is_alive():
            self.audio_player_thread = threading.Thread(target=self._audio_player_task, daemon=True)
            self.audio_player_thread.start()

async def handle_server_messages(self, on_text_received):
        """持续接收并分发服务端推送的事件消息。"""
        try:
            async for message in self.ws:
                event = json.loads(message)
                event_type = event.get("type")
                if event_type == "response.audio.delta" and self.audio_enabled:
                    audio_b64 = event.get("delta", "")
                    if audio_b64:
                        audio_data = base64.b64decode(audio_b64)
                        self.audio_playback_queue.put(audio_data)

# 语音+文本模式下,译文文本随合成语音流式返回,通过 response.audio_transcript.delta 累加
                elif event_type == "response.audio_transcript.delta":
                    on_text_received(event.get("delta", ""))
                # 仅文本模式下,译文文本通过 response.text.delta 流式返回
                elif event_type == "response.text.delta":
                    on_text_received(event.get("delta", ""))

elif event_type == "response.done":
                    print("\n[INFO] 一轮响应完成。")
                    usage = event.get("response", {}).get("usage", {})
                    if usage:
                        print(f"[INFO] Token 使用情况: {json.dumps(usage, indent=2, ensure_ascii=False)}")
                # 收到 session.finished 表示服务端已处理完 session.finish 请求
                elif event_type == "session.finished":
                    print("\n[INFO] 会话已结束。")
                    self.session_finished_event.set()
                # 接收源语言识别结果(需先启用 input_audio_transcription.model)
                # elif event_type == "conversation.item.input_audio_transcription.delta":
                #     print(event.get("delta", ""), end="", flush=True)  # 流式识别增量
                # elif event_type == "conversation.item.input_audio_transcription.completed":
                #     transcript = event.get("transcript", "")  # 一段语音的最终识别文本
                #     print(f"[源语言] {transcript}")

except websockets.exceptions.ConnectionClosed as e:
            print(f"[WARNING] 连接已关闭: {e}")
            self.is_connected = False
        except Exception as e:
            print(f"[ERROR] 消息处理时发生未知错误: {e}")
            traceback.print_exc()
            self.is_connected = False

async def start_microphone_streaming(self):
        """持续从麦克风采集音频,并实时流式发送至服务端。"""
        stream = self.pyaudio_instance.open(
            format=self.input_format,
            channels=self.input_channels,
            rate=self.input_rate,
            input=True,
            frames_per_buffer=self.input_chunk
        )
        print("麦克风已启动,请开始说话...")
        try:
            while self.is_connected:
                audio_chunk = await asyncio.get_event_loop().run_in_executor(
                    None, stream.read, self.input_chunk
                )
                await self.send_audio_chunk(audio_chunk)
        finally:
            stream.stop_stream()
            stream.close()

async def close(self):
        """优雅关闭 WebSocket 连接,并释放音频相关资源。"""
        # 发送 session.finish 并等待 session.finished,确保最后一段语音的翻译不丢失
        if self.is_connected and self.ws:
            finish_event = {
                "event_id": f"event_{int(time.time() * 1000)}",
                "type": "session.finish",
            }
            await self.ws.send(json.dumps(finish_event))
            print("已发送 session.finish,等待服务端完成处理...")
            try:
                await asyncio.wait_for(self.session_finished_event.wait(), timeout=15)
                print("服务端已完成处理。")
            except asyncio.TimeoutError:
                print("等待 session.finished 超时。")

self.is_connected = False
        if self.ws:
            await self.ws.close()
            print("WebSocket 连接已关闭。")

if self.audio_player_thread:
            self.audio_playback_queue.put(None)  # 通知播放线程退出
            self.audio_player_thread.join(timeout=1)
            print("音频播放线程已停止。")

self.pyaudio_instance.terminate()
        print("PyAudio 实例已释放。")

def print_banner():
    print("=" * 60)
    print("  基于千问 qwen3.8-livetranslate-flash-realtime")
    print("=" * 60 + "\n")

def get_user_config():
    """通过命令行交互收集运行参数:输出模式与目标语言。"""
    print("请选择模式:")
    print("1. 语音+文本 [默认] | 2. 仅文本")
    mode_choice = input("请输入选项 (直接回车选择语音+文本): ").strip()
    audio_enabled = (mode_choice != "2")

if audio_enabled:
        lang_map = {
            "1": "en", "2": "zh", "3": "ru", "4": "fr", "5": "de", "6": "pt",
            "7": "es", "8": "it", "9": "ko", "10": "ja", "11": "yue"
        }
        print("请选择翻译目标语言 (音频+文本 模式):")
        print("1. 英语 | 2. 中文 | 3. 俄语 | 4. 法语 | 5. 德语 | 6. 葡萄牙语 | 7. 西班牙语 | 8. 意大利语 | 9. 韩语 | 10. 日语 | 11. 粤语")
    else:
        lang_map = {
            "1": "en", "2": "zh", "3": "ru", "4": "fr", "5": "de", "6": "pt", "7": "es", "8": "it",
            "9": "id", "10": "ko", "11": "ja", "12": "vi", "13": "th", "14": "ar",
            "15": "yue", "16": "hi", "17": "el", "18": "tr"
        }
        print("请选择翻译目标语言 (仅文本 模式):")
        print("1. 英语 | 2. 中文 | 3. 俄语 | 4. 法语 | 5. 德语 | 6. 葡萄牙语 | 7. 西班牙语 | 8. 意大利语 | 9. 印尼语 | 10. 韩语 | 11. 日语 | 12. 越南语 | 13. 泰语 | 14. 阿拉伯语 | 15. 粤语 | 16. 印地语 | 17. 希腊语 | 18. 土耳其语")

choice = input("请输入选项 (默认取第一个): ").strip()
    target_language = lang_map.get(choice, next(iter(lang_map.values())))

return target_language, audio_enabled

async def main():
    """程序主入口:完成连接与会话配置,并启动实时翻译循环。"""
    print_banner()

api_key = os.environ.get("DASHSCOPE_API_KEY")
    if not api_key:
        print("[ERROR] 请设置环境变量 DASHSCOPE_API_KEY")
        print("  例如: export DASHSCOPE_API_KEY='your_api_key_here'")
        return

workspace_id = os.environ.get("DASHSCOPE_WORKSPACE_ID")
    if not workspace_id:
        print("[ERROR] 请设置环境变量 DASHSCOPE_WORKSPACE_ID(百炼业务空间 ID)")
        print("  例如: export DASHSCOPE_WORKSPACE_ID='your_workspace_id_here'")
        return

target_language, audio_enabled = get_user_config()
    print("\n配置完成:")
    print(f"  - 目标语言: {target_language}")
    if not audio_enabled:
        print("  - 输出模式: 仅文本")

client = LiveTranslateClient(api_key=api_key, workspace_id=workspace_id, target_language=target_language, audio_enabled=audio_enabled)

# 翻译文本到达时的回调:按字流式打印到终端
    def on_translation_text(text):
        print(text, end="", flush=True)

try:
        print("正在连接到翻译服务...")
        await client.connect()

# 启动音频播放线程(仅当启用音频输出时实际工作)
        client.start_audio_player()

print("\n" + "-" * 60)
        print("连接成功!请对着麦克风说话。")
        print("程序将实时翻译您的语音并播放结果。按 Ctrl+C 退出。")
        print("-" * 60 + "\n")

# 并发执行:处理服务端消息 + 上传麦克风音频
        message_handler = asyncio.create_task(client.handle_server_messages(on_translation_text))
        tasks = [message_handler]
        # 麦克风采集是翻译的输入源,无论是否输出语音都必须开启
        microphone_streamer = asyncio.create_task(client.start_microphone_streaming())
        tasks.append(microphone_streamer)

await asyncio.gather(*tasks)

except KeyboardInterrupt:
        print("\n\n用户中断,正在退出...")
    except Exception as e:
        print(f"\n发生严重错误: {e}")
    finally:
        print("\n正在清理资源...")
        await client.close()
        print("程序已退出。")

if __name__ == "__main__":
asyncio.run(main())未来方向#
同声传译远未抵达终点。围绕「听得更全、传得更真、用得更广」,我们把目光投向以下几个方向:
- 逼近同传延迟极限:持续压缩端到端时延,把「听到」与「译出」之间的间隔推向极限。
- 跨会话的长期记忆:跨会话记忆延续到同一项目、同一群人的下一次交流,越用越好。
- 覆盖更多语种:持续把覆盖语种延伸到更多长尾语种与区域方言,让实时同传服务世界上每一个人。
Citation#
如果您认为 Qwen3.8-LiveTranslate 对您的研究或工作有所帮助,欢迎引用以下文章:
@misc{qwen38livetranslateblog,
    title = {Qwen3.8-LiveTranslate: Names the speaker. Carries the meaning.},
    url = {https://qwen.ai/blog?id=qwen3.8-livetranslate},
    author = {Qwen Team},
    month = {September},
    year = {2026}
}