Nanjing University Team Unveils TestPrism Benchmark Exposing Overstated Test Generation Quality
A team led by Jiaheng Liu at Nanjing University introduces TestPrism, a test-generation benchmark arguing that the prevailing single-reference evaluation systematically overstates Coding Agent test quality. TestPrism spans 300 test tasks from 17 sources and 3,000 candidate implementations, each task paired with a validated panel of correct and buggy implementations, and scores with a Joint Success Function (JSF) that requires tests to pass every correct implementation while rejecting every faulty one. Under this stricter criterion, Coding Agents fail collectively far more often than prior evaluations suggested, with reported pass rates inflated roughly twofold.
Related Entities
Full Report
Contents14 sections
新智元报道

Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
测试的地位也随之变化:它不仅是软件质量的保障,还越来越多地充当Agent自我验证的依据、代码评审的证据,甚至强化学习中的奖励信号。
测试写得好不好,直接决定了这些下游环节能否信任它的判断。
那么,怎样才算一份好的测试?
目前主流的测试生成Benchmark通常采用单一参考评测(Single Reference Evaluation):生成的测试只要在原始代码上失败、在一份标准答案(Gold Solution)上通过,就被视为成功。
问题在于,同一个需求往往存在多种正确实现,也存在许多看似合理却暗含缺陷的错误实现。
一份测试可能恰好「认得」标准答案,却放过了真正有Bug的代码;也可能把标准答案的实现细节当成需求本身,把其他完全正确的写法拒之门外。只看一份参考答案,测试质量很可能被高估。
近日,南京大学刘佳恒老师团队提出了新的测试生成Benchmark TestPrism,包含来自17个来源的300个测试任务和3000个候选实现,每个任务都配有经过验证的正确与错误实现面板,并以Joint Success Function(JSF)作为核心指标:测试必须在原始代码上失败、接受所有正确实现、拒绝所有错误实现。
研究发现:在14种Coding Agent配置中,最强配置的JSF只有28.00%,而它在单一参考评测下的成功率达到59.67%——超过一半通过参考答案的测试,换一批实现就不再可靠。
研究进一步对286条失败轨迹进行专家标注,归纳出3大类、7种测试生成错误机制,并提出TestHelix框架,通过异构合成、同伴交叉验证与递归自我改进,在相同推理预算下将JSF提升11.67至12.00个百分点。
论文:https://doi.org/10.48550/arXiv.2610.12289
研究数据与代码:https://github.com/TestPrism/TestPrism
测试评测缺了什么?
测试生成评测并不是新问题。
已有Benchmark覆盖了不同粒度的任务:TestGenEval、CLOVER和MultiFileTest关注函数、文件或多文件级别的测试编写,SWT Bench和TDD Bench Verified则把测试生成带到真实代码仓库,要求测试复现GitHub Issue中描述的问题。
它们普遍沿用一种成功标准:测试在修复前失败(Fail),在参考修复后通过(Pass),即所谓的Fail-to-Pass。
这一标准简洁、可执行,但隐含了一个假设:只要测试能区分「修复前」和「参考修复后」两个状态,它就足以判断任意实现是否正确。现实中,这个假设很难成立。
一方面,测试可能遗漏关键输入或只做了很弱的断言,参考答案能通过,有缺陷的实现同样能通过;
另一方面,测试可能过度依赖参考答案的具体写法,比如固定的内部函数名、输出格式或中间状态,导致其他同样满足需求的实现被误判为错误。
OmniCode、SWE Mutation等工作开始引入实现变体,但主要考察测试能否拒绝错误变体,仍然缺少对「接受正确替代实现」这一侧的系统评测。
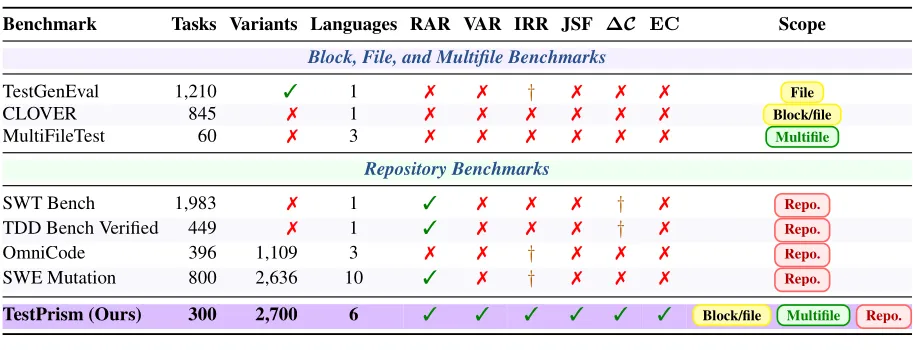
表1|现有测试生成Benchmark的评测范围与评测目标对比(原论文Table 1)
因此,论文提出的核心问题是:How robust is the evaluation of generated tests to variation across implementations?
也就是,当实现方式发生变化时,对测试质量的评价还站得住吗?一份可靠的测试,应当像棱镜一样把同一需求下的不同实现区分开来:对正确实现保持宽容,对错误实现保持敏感。
为每个任务配备一组正确与错误实现
为了回答这个问题,研究团队构建了TestPrism。与只提供一份参考答案不同,TestPrism为每个测试任务配备了一个候选实现面板(Candidate Panel):1份参考实现、4份正确的替代实现,以及5份错误实现。生成测试时,面板对Agent完全隐藏;评测时,测试需要在原始代码和面板中的每一份实现上分别执行。
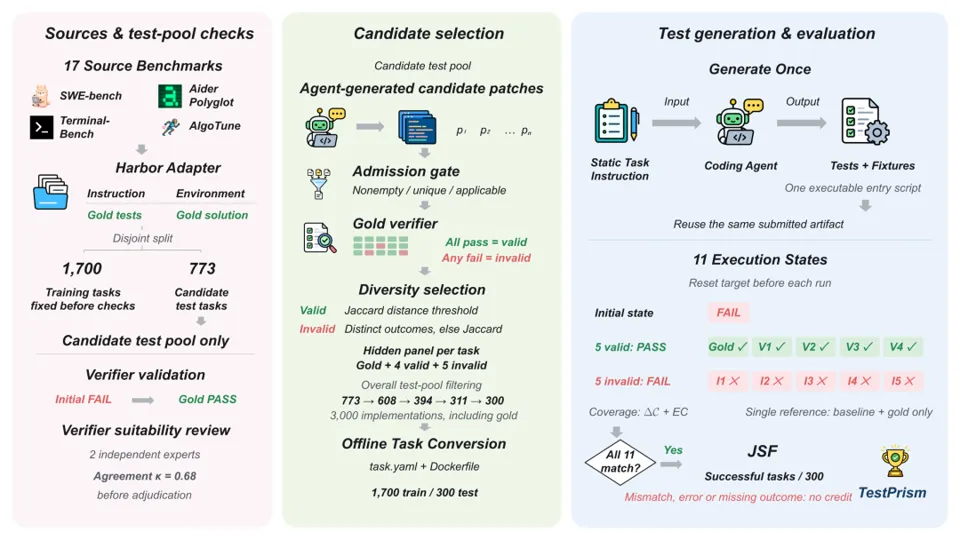
图1|TestPrism的构建与评测流程(原论文Fig.1)
整个构建过程分为四步。
第一步:任务筛选与适配
研究团队从17个公开Benchmark中收集任务,包括广泛使用的SWE-bench系列和Terminal-Bench系列,以及SWE PolyBench、SWE rebench、EvoEval、USACO、AlgoTune等,覆盖仓库维护、函数规格演化、竞赛编程与数值优化等场景。入选来源都需要具备可追溯的测试来源和有据可查的验证流程。
随后,适配器将不同来源的任务统一转换为Harbor的任务格式,同时保留原始需求、初始代码状态、验证器、参考实现、依赖、服务与执行限制。
第二步:任务选择
团队使用三个指标筛选任务:参考实现的有效代码行数(Solution Size)、测试函数或检查项的数量(Test Count),以及每个被修改文件对应的测试数量(Test Density)。
筛选阈值根据每个来源自身的分布校准,并通过来源配额平衡代表性。最终TestPrism共包含2000个任务,其中1700个划为训练集,用于后文TestHelix的策略优化;300个作为测试集,训练集与测试集互不重叠。
第三步:候选实现生成与验证
在生成候选实现之前,团队首先对每个任务的原有验证器进行复核:它必须在初始状态下失败、在参考实现上通过。
两位具有开发经验的专家独立评估任务需求与验证器,检查是否存在对参考实现的过拟合或覆盖缺口,意见不一致时讨论澄清,仍存疑的任务直接剔除(Cohen's κ = 0.68)。
候选实现本身由不同的Coding Agent和不同能力的模型实际求解任务得到。与传统变异测试(Mutation Testing)人为注入缺陷不同,这种方式能够同时捕获真实存在的替代解法,以及Agent在解题过程中自然产生的错误。
团队移除空提交、完全重复和无法应用的补丁后,在干净环境中运行原有验证器:所有检查都通过的标记为正确实现,任意一项检查失败的标记为错误实现。这些标签在后续评测中保持固定。
第四步:多样性过滤与任务转换
如果4份正确实现只是参考答案的轻微改写,面板就失去了意义。
因此,团队对正确实现组要求满足平均AST距离标准;对错误实现组,未通过的检查项集合不同即视为多样,集合相同时还需额外满足AST Jaccard距离检查。面板通过反复生成与替换,直到两组同时满足多样性要求。
最后,测试生成适配器将每个编程任务转换为一份测试编写契约:Agent需要根据原始需求,在指定目录中提交测试、Fixture和一个可执行的入口脚本。
数据概览
TestPrism测试集的300个任务覆盖Python、JavaScript/TypeScript、Java、C/C++和Go等六种语言,来自67个代码仓库和项目,包含3000个带标签的候选实现。
任务被划分为6大类、34个子类:Bug修复(167个)、程序与算法(53个)、性能优化(28个)、功能扩展(20个)、项目与工作流(19个),以及重构与迁移(13个)。
图2|TestPrism测试集的任务分类(原论文Fig.7)
评测指标
从单一参考到联合成功
在此基础上,TestPrism定义了一组互补的评测指标:
- Reference Acceptance Rate(RAR):测试在原始代码上失败、在参考实现上通过的任务比例,即传统的单一参考评测;
- Valid Acceptance Rate(VAR):测试接受4份正确替代实现的平均比例;
- Invalid Rejection Rate(IRR):测试拒绝5份错误实现的平均比例;
- H:VAR与IRR的调和平均,衡量两者是否平衡;
- Change Coverage与Entry Coverage:分别沿用SWT Bench和TestExplora的定义,衡量测试覆盖了多少参考修改代码与相关入口代码。
核心指标Joint Success Function(JSF)则要求测试同时满足三个条件:在原始代码上失败、接受面板中所有正确实现、拒绝面板中所有错误实现。如果把面板缩减为只有参考实现,JSF就退化为RAR。
换言之,单一参考评测只是JSF最宽松的一个特例,JSF永远不会超过RAR,二者之间的差距,正是那些通过参考答案、却经不起更多实现检验的测试所占的比例。
RQ1
前沿Coding Agent能写出可靠的测试吗?
第一个研究问题是:当前Coding Agent生成的测试,能否稳定区分正确与错误实现?
研究团队评测了来自六个模型家族的14种Coding Agent配置,主表报告每个家族中JSF最高的配置,并优先使用各模型的原生Coding Agent,以反映模型训练与Agent框架之间的紧密耦合。
表2|各模型家族最佳配置在TestPrism上的表现(原论文Table2)
通过参考答案,不等于测试可靠
结果显示,可靠的测试生成仍远未解决。表现最好的Claude Fable 5.1在单一参考评测下成功率为59.67%,但JSF只有28.00%;Kimi K3、Qwen3.8 Max和GPT 5.6 sol -max的RAR都在54%至57%之间,JSF却只有23%至25%;
DeepSeek V4 Pro和GLM 5.3的JSF更是只有13.33%和11.33%。对所有模型而言,相当一部分在传统评测中被判为成功的测试,一旦面对更多实现就会出错。
接受正确实现,往往比拒绝错误实现更难
进一步拆分来看,六个配置中有五个的IRR高于VAR,说明当前Agent写出的测试更常犯的错误是过严:把参考实现的具体写法当成了需求,误伤了其他合法实现。
GLM5.3是一个典型例子:它的IRR达到86.33%,在所有配置中最高,但VAR只有50.33%,JSF也最低。
Qwen3.8 Max则恰好相反,VAR最高(77.00%),IRR却只有66.00%。这说明只擅长拒绝错误实现并不够,可靠的测试必须同时兼顾宽容与敏感,在全部14种配置中,VAR与IRR的调和平均H与JSF同样呈现正相关。
覆盖率很重要,但不是全部
覆盖率同样与JSF高度相关:在全部14种配置中,Change Coverage和Entry Coverage与JSF的Pearson相关系数分别达到0.91和0.96。但覆盖到相关代码,只是测试正确判断它的前提——测试执行了某段逻辑,并不意味着它的断言能够正确判断这段逻辑的行为。
RQ1的核心发现是:前沿模型距离可靠的测试生成仍有很大差距,接受正确实现与拒绝错误实现暴露了互补的弱点,二者的平衡与覆盖率共同影响联合成功率。
RQ2
候选实现越多、越多样,测试越难蒙混过关?
第二个研究问题关注候选面板本身:如果向面板中逐步加入更多、更多样的实现,测试的成功率会如何变化?
研究团队随机抽取50个任务,沿用相同的构建流程,将每个任务的面板从10份实现扩展到15份:1份参考实现、7份额外正确实现和7份额外错误实现。
在保持测试不变的前提下,从只含参考实现的面板出发,按三种方式逐步加入实现:只加正确实现、只加错误实现,以及二者交替加入。
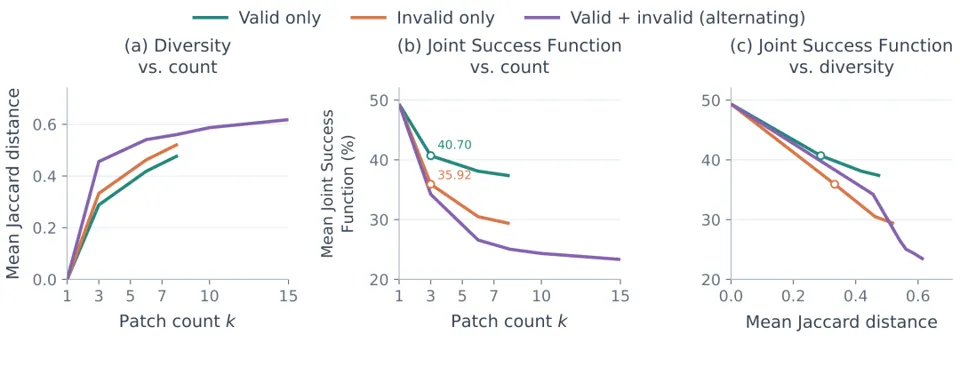
图3|三种实现添加方式下JSF与候选多样性的变化(原论文Fig.3)
结果显示,平均JSF从只有参考实现时的49.33%开始持续下降:加入5份正确实现后降至38.10%,加入5份错误实现后降至30.49%,交替加入9份实现后降至24.33%;当所有实现全部加入时,三种方式的终点分别为37.33%、29.33%和23.33%。
测试本身没有任何改变,变化的只是面板对它提出的要求——更多正确实现检验测试是否过严,更多错误实现检验测试是否过松。
这说明JSF并不是一个静态分数,而是一种随面板变化的动态可靠性度量:面板包含哪些实现与包含多少实现同样重要。单一参考评测作为只有一份实现的特例,是最弱的检验,也是扩展面板成功率的上界。RQ2的核心发现是:多样的候选实现能够暴露小面板无法发现的测试错误。
RQ3
Agent生成的测试究竟错在哪里?
前两个研究问题揭示了测试「不可靠」的程度,但没有回答它们为什么不可靠。
为此,研究团队从六个模型家族的最佳配置中各抽取50条JSF为零的失败轨迹,排除14条超时轨迹后,由两位专家独立标注全部286条轨迹(Cohen's κ= 0.81),存在分歧时引入第三位专家共同讨论确定。
标注时,专家会检查任务需求、提交的测试、在原始代码和参考实现上的执行结果、在各候选实现上的结果以及对应的补丁证据。最终形成3大类、7种具体错误机制。
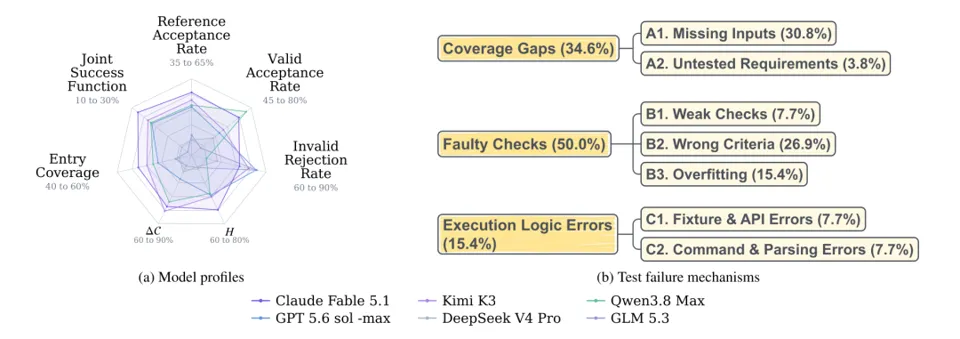
图4|各模型的指标画像(a)与286条失败轨迹中的错误机制分布(b)(原论文Fig.4)
覆盖缺口:测到了功能,却漏掉了关键输入
覆盖缺口(Coverage Gaps)占全部失败的34.6%,包括遗漏输入(Missing Inputs,30.8%)和未测试的需求(Untested Requirements,3.8%)。前者是最常见的单项错误之一:测试执行了某个操作,却没有覆盖能够暴露缺陷的输入组合。
例如,在一个扑克牌型判断任务中,生成的测试从未比较A作为最小牌的顺子与三条的大小,于是一个把这种顺子错判为「高牌」的错误实现顺利通过了测试。
错误检查:执行到了,却判断错了
错误检查(Faulty Checks)是占比最大的类别,达到50.0%,包括检查过弱(Weak Checks,7.7%)、判断标准错误(Wrong Criteria,26.9%)和过拟合(Overfitting,15.4%)。
这一类别说明,测试即使运行到了相关行为,也不一定能正确判断它。过拟合对应的正是RQ1中观察到的「过严」问题:测试把参考实现的偶然细节当成了需求本身。
例如,在一个括号解析任务中,测试确实构造了包含不匹配括号的输入,却只检查了输出结果的数量,没有检查具体内容,导致一个丢弃了合法分组的错误实现被接受。
值得注意的是,扑克牌和括号解析这两个案例中的测试都在原始代码上失败、在参考实现上通过——在单一参考评测下,它们都会被判为成功。只有加入额外的错误实现后,这些遗漏的输入组合和过弱的断言才被暴露出来。
执行逻辑错误:测试自己先跑不通
执行逻辑错误(Execution Logic Errors)占15.4%,包括Fixture与API使用错误(7.7%),以及命令执行与输出解析错误(7.7%)。
例如,在一个EvoEval任务中,测试将被测函数存储在测试类上,再通过self调用它,结果意外绑定了一个额外参数,导致测试甚至在参考实现上也会失败。这类问题会直接拉低测试的整体可靠性,但与前两类不同,它们在单一参考评测下同样会被发现,并不构成单一参考评测的「盲区」。
RQ3的核心发现是:测试失败源于遗漏相关行为、误判实现正确性,或者测试自身执行失败;其中遗漏输入组合与过弱断言能够通过参考答案的检验,只有在更多错误实现面前才会暴露。
RQ4
如何让测试在不同实现之间泛化?
针对上述问题,研究团队提出了TestHelix。它的出发点很直接:既然只对照一份实现无法发现测试的问题,那就在生成阶段主动构造多份实现,让测试接受多方检验。
图5|TestHelix框架(原论文Fig.2)
异构合成:让不同Agent各自给出一组测试与修复
TestHelix为多个相互隔离的Coding Agent分配不同的探索策略,每个Agent只根据公开的任务需求,独立编写一份测试T和一份修复P。每一对测试与修复都需要满足内部一致性:测试必须在原始代码上可复现地失败,并在自己的修复上通过。Agent借助本地执行反馈不断修正,直到满足条件或预算耗尽。
同伴交叉验证:用别人的修复检验自己的测试
只在自己的修复上通过,仍可能是自洽的错误。因此,TestHelix让每份测试在其他Agent的修复上交叉执行,以暴露过于严格的测试或不完整的修复。
同时,一个看不到任何修复代码的独立评审Agent会根据公开需求逐条审查断言,每一项阻断性意见都必须有公开需求作为依据。
经过评审确认的反例被用于修正测试与修复;当几份不同的合格修复都能通过已认可的测试时,系统还会借鉴差分测试的思路,主动寻找能够区分它们的输入。最后,相互兼容的测试被合并,并在全新环境中再次验证。
递归自我改进:从训练任务中学习更好的测试生成策略
TestHelix从一份基础策略出发,借助AutoSaddler进行反思式演化:选择一个父策略,诊断它的执行轨迹,提出修订,再在相同任务上比较父子策略的表现,并把可复用的经验沉淀下来供后续轮次使用。
优化在TestPrism训练集中的600个任务上进行,与测试集完全隔离,且从不接触隐藏的候选面板。值得一提的是,优化目标使用的是信号更密集的RAR而非更严格的JSF,因为后者往往难以奖励渐进式的策略改进;而对多实现区分能力的要求,则交给异构合成与同伴交叉验证来承担。
优化得到的策略被冻结后,直接用于GPT 5.6 sol和Kimi K3两个模型。
实验结果
研究团队在GPT 5.6 sol和Kimi K3上比较了五种TestHelix配置,并以各自的原生Coding Agent(Codex和Kimi Code)作为对照。同一模型组内的所有配置使用相同的基础模型和工具,并共享相同的单任务推理预算上限。
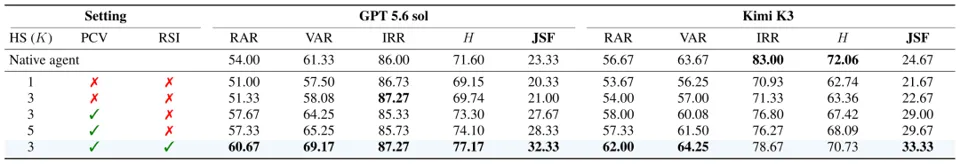
表3|TestHelix消融实验与原生Coding Agent对比(原论文Table3)
结果显示,只生成三组测试与修复、再随机提交一份,相比单组生成最多只提升1个百分点;在同样三组的基础上启用完整的同伴交叉验证,JSF则提升6个百分点以上,GPT5.6 sol从21.00%提升至27.67%,Kimi K3从22.67%提升至29.00%。如果把组数从3增加到5,只额外带来0.67个百分点;而在三组配置上引入递归自我改进,则进一步带来4.33至4.67个百分点的提升。
最终配置在两个模型上分别达到32.33%和33.33%的JSF,相比单组生成提升11.67至12.00个百分点,也比各自的原生Coding Agent高出8.67至9.00个百分点。在固定的推理预算下,改进「如何生成和检验测试」带来的收益,明显高于单纯把预算分配给更多的Agent。
RQ4的核心发现是:异构合成帮助测试在不同实现之间泛化——同伴交叉验证利用多样的修复检验和修正测试,递归自我改进则在任务之间沉淀测试生成策略,两者在消融实验中都贡献了明确的收益。
下一步是什么?
随着Coding Agent越来越多地依赖测试来验证自己的工作,测试质量的评价标准也需要随之提高。
这项研究表明,单一参考评测会系统性地高估测试质量:一份测试能够区分修复前后的两个状态,并不意味着它能正确判断同一需求下的其他实现。即使是最强的前沿模型,在面对多份正确与错误实现时,联合成功率也不到三成。
研究同时揭示了问题的两面性。测试既可能过松,遗漏关键输入或只做表面检查,从而放过有缺陷的实现;也可能过严,把参考实现的偶然细节当作需求,从而误伤合法实现。
前者容易在单一参考评测中隐藏,后者则在单一参考评测中根本无从发现。只有当评测同时考察接受与拒绝两个方向,测试的真实可靠性才能被看清。
从评测角度看,TestPrism提供了一种更贴近实际的检验方式:用一组经过验证、具有多样性的实现来检验测试,而不是只依赖一份标准答案。
从方法角度看,TestHelix说明提升测试可靠性未必需要更强的基础模型,让多个Agent相互提供反例、相互检验结论,再把有效的经验沉淀为策略,同样能带来显著收益。
当然,论文也指出,TestPrism每个任务只包含10份候选实现,正确与错误实现的等比例配置并不代表真实分布,基于AST的多样性度量也无法保证语义层面的完全覆盖。将评测扩展到不断演化的需求、更广泛的实现空间和更多执行环境,仍是未来值得探索的方向。
参考资料:
https://doi.org/10.48550/arXiv.2610.12289
秒追ASI
⭐点赞、转发、在看一键三连⭐
点亮星标,锁定新智元极速推送!