新智元 (微信公众号) · 10/11/2026, 12:25:00
MIT's HugAgent Study Reveals Long Interviews Improve AI Persona Accuracy but Fail Generalization in New Contexts
MIT and collaborators introduce the HugAgent framework to empirically evaluate LLMs' ability to simulate real individuals based on interview data. The study finds that while longer interviews significantly improve model accuracy in reflecting current views, predictive performance does not scale with context novelty, revealing that current 'digital twin' techniques rely more on static profiling than dynamic cognitive modeling.
SOURCE COVERAGEFull Original Report

只要和一个人聊得足够久,大模型就能成为他的「数字分身」吗?
从虚拟用户、合成受访者,到个性化AI Agent,一条越来越流行的技术路线是:先通过访谈、问卷和个人资料了解一个真实的人,再让大模型扮演这个人,预测他在没见过的问题上会如何回答。
但这里有一个更难的问题:AI****即使已经学会了你现在怎么想,换一个此前没问过的新情境,它还能不能继续答得像你?
为检验这一点,麻省理工等机构研究者提出HugAgent,让大模型基于真实参与者的访谈,预测他们在全民医疗、公共监控和住房增密等新情境下的回答。研究覆盖54名参与者、1,742个评测项,并测试了GPT、Claude、Gemini、DeepSeek、Llama、Qwen等模型。相关论文入选EMNLP 2026 Main Oral。
论文链接:https://arxiv.org/abs/2510.15144
代码链接:https://github.com/jajamoa/HugAgent
研究发现,个人访谈确实能够帮助模型更准确地模拟一个具体的人。但一个更值得注意的现象是:和一个人聊得更久,AI会更清楚他现在怎么想,却不一定更知道条件变化后他会怎么回答。
这也让「数字分身」面临一个更基础的问题:AI****到底是在建立一个关于你的模型,还是只是在建立一份越来越详细的个人画像?
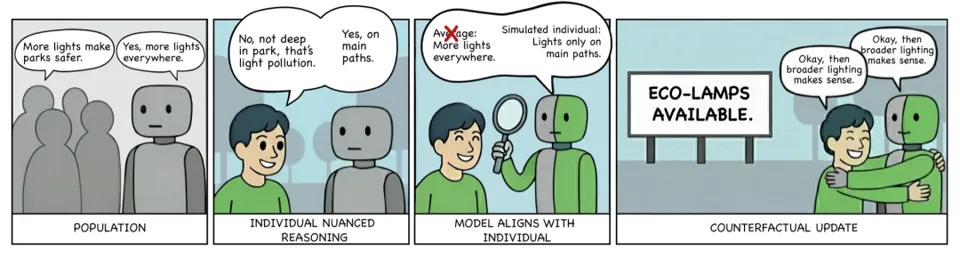
从「像一个普通人」到「像这个具体的人」。HugAgent进一步追问:条件发生变化后,AI还能继续代表这个人吗?
为什么需要HugAgent
从「像人」到「像这个人」
过去几年,用大模型模拟人类已经逐渐成为一条真正的研究路线。研究者让LLM扮演消费者、选民和实验参与者,更进一步,也开始尝试模拟真实存在的某一个人:通过长时间访谈、问卷和个人资料建立「数字分身」,再让AI在之后的新问题中继续代表本人。
这条路线听起来很自然。一个人告诉AI的信息越多,AI就越了解他,似乎也就应该越能预测他的回答。
但这里有一个关键的跳跃:
描述一个人,与预测一个人,并不是同一件事。
假设一个人在访谈中表示,自己支持全民医疗,但同时担心成本、效率和个人选择。模型也许已经能够准确判断他现在的立场。
可如果条件变了呢?
如果新的方案每年能为他的家庭节省3000美元,或者私人保险仍然可以保留,他还会做出同样的选择吗?
这时,模型要做的已经不只是记住「他支持全民医疗」,而是从过去的表达中判断他真正看重什么,以及不同条件发生变化后,他会如何重新权衡。
这正是HugAgent想检验的问题:
如果我们通过采访建立了足够丰富的 persona,它能不能预测这个人在采访之外会怎么回答?
这是从「像人」走向「像这个人」之后,一个绕不开的问题。
HugAgent不仅记录答案
还要把「为什么」问出来
要检验AI能不能模拟「某一个人」,首先得知道这个人自己到底怎么想。
HugAgent因此没有从公开人物资料或网络文本出发,而是重新招募真实参与者。团队选择了三个在美国存在明显分歧、同时又涉及真实价值取舍的话题:全民医疗、公共监控,以及住房增密,也就是放宽部分分区限制,允许建设更高、更密的住宅。从120多位招募者中经过质量筛选,最终保留了54名参与者。
第一步:问卷,记下「现在的你」。
参与者首先填写人口统计信息,再对不同议题给出1到10分的支持度。与此同时,他们还需要评价一系列理由对自己立场的影响有多大。
比如,同样反对住房增密,一个人可能最担心社区风貌和房产价值,另一个人则可能主要在意交通、租金或住房供给。最终的「支持还是反对」只是一个答案,真正区分不同人的,往往是答案背后的理由以及这些理由各自有多重要。
这些信息共同构成了一个人当下的 belief state(信念状态),也就是他现在持有什么立场,以及支撑这些立场的理由。
第二步:改变条件,记录「如果……会怎样」。
接下来,问卷开始改变其中一个条件。
如果住房增密以后,当地租金下降10%到15%?如果全民医疗每年能为一个家庭节省3000美元?如果公共监控的录像只保存48小时?
参与者需要在每个新的假设情境下重新给出自己的立场,并再次评价相关理由的重要程度。
这样,研究团队不仅知道一个人「现在怎么想」,也记录下了当某个条件发生变化以后,他自己会如何重新回答。前后两种状态之间的变化,就构成了HugAgent想要预测的 belief update(信念更新)。
更重要的是,这些答案来自参与者本人。之后模型参加考试时,并不会直接看到目标情境下的正确答案。
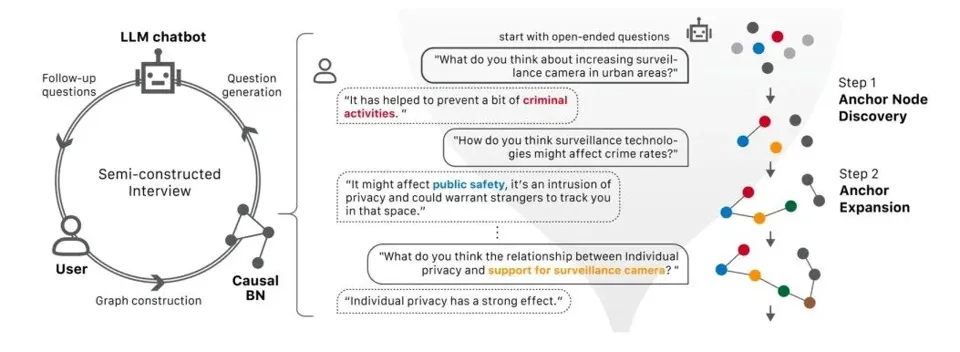
图注: TraceYourThinking的访谈过程。系统从开放式问题出发,根据参与者的回答动态构建因果信念图,并自动生成下一轮追问,逐步了解一个人的观点、理由和不同因素之间的关系。
第三步:think-aloud访谈,把「为什么」慢慢问出来。
只记录问卷答案还不够。
参与者随后通过团队开源的聊天机器人TraceYourThinking接受半结构化的think-aloud(口述思考)访谈,可以打字,也可以直接用语音,一边思考一边把自己的判断理由说出来。
这并不是一套从头到尾固定不变的问题清单。
机器人会根据参与者前面说过的话,动态整理这个人的「因果信念图」:他提到了哪些因素,这些因素会让立场往什么方向变化,影响有多强。基于这些信息,系统再自动生成下一轮 follow-up question,继续追问还没有说清楚、存在矛盾,或者值得进一步展开的地方。
比如,一个人说自己担心某项政策带来的成本,机器人可以继续问:如果成本下降,这会在多大程度上改变你的态度?如果他说「这个我也不太确定」,系统也会把这种不确定性继续追问下去。
「我拿不准」本身也是信息。
它可能意味着这个人的立场并不牢固,也可能意味着两种价值正在相互拉扯。相比一个简单的1到10分,think-aloud访谈留下的是更丰富的线索:这个人在意什么,为什么在意,哪些判断很确定,哪些地方还在犹豫。
最终,模型拿到的是关于这个人的背景信息和这段访谈,而不是目标情境下本人真正给出的答案。
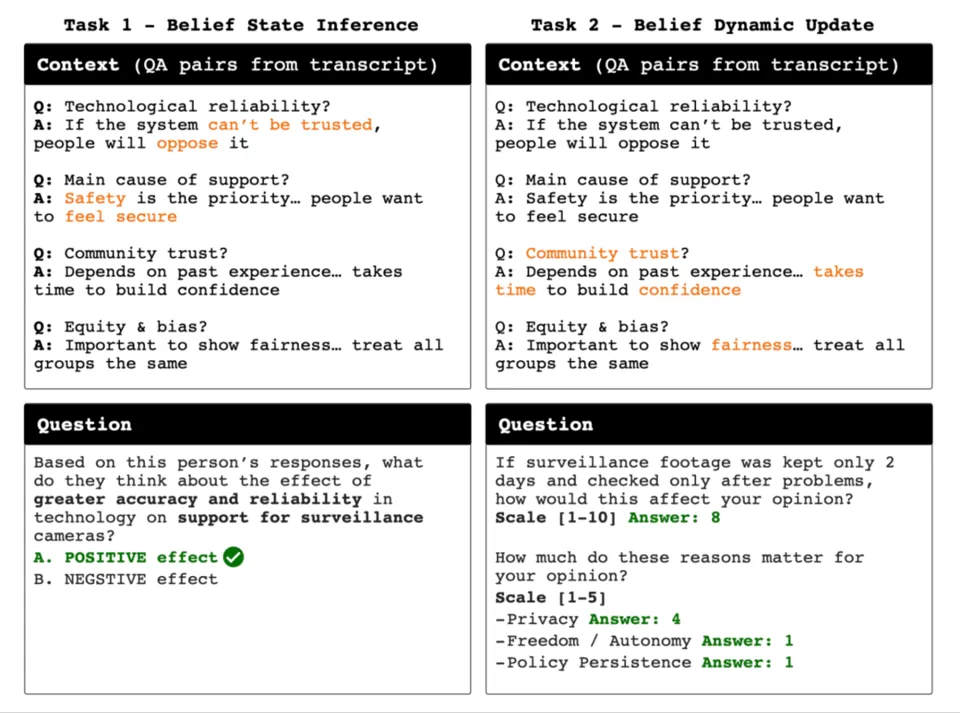
图注: HugAgent的两类评测任务。Belief State Inference根据访谈推断一个人当前的信念;Belief Dynamics Update则加入新的假设情境,预测同一个人的立场和理由会如何变化。
HugAgent再把这些材料变成两类考试。
第一类是Belief State Inference,共356题,测试模型能不能从访谈中推断这个人当前没有直接说出的信念。
第二类是Belief Dynamics Update,共1386题,测试在给出一个新的假设情境后,模型能不能预测这个人的新立场和理由权重。
整个benchmark一共包含1742个评测项。
为了给任务设定一个经验上限,团队在14天后邀请部分参与者重新回答同样的问题。参与者与两周前自己的回答一致性,在两类任务上分别为84.84%和85.66%,这被用作后续模型比较的 ceiling(经验上限)。
到这里,一个原本很抽象的问题终于变得可以直接测量:
如果和一个人聊得越来越多,他的「数字分身」会不会也越来越会预测他?
核心结果:读懂「现在的你」容易,条件变了就难了
HugAgent最直观的结果,是模型在两类任务上的表现拉开了明显差距。
在Belief State Inference(信念状态推断)中,表现最好的方法准确率达到77.56%,GPT-4o为74.66%。参与者在14天后重新回答相同问题时,自我一致性为84.84%,论文将其作为这一任务的经验ceiling。
到了Belief Dynamics Update(信念动态更新),最好的Claude Sonnet 4.5达到68.61%,LLaMA 3.3 70B为 67.57%,GPT-4o为63.11%;对应的经验ceiling则为85.66%。
也就是说,在各自的评测设置下,大模型已经比较擅长从访谈中恢复一个人「现在怎么想」,但面对一个此前没有回答过的新情境时,距离参与者本人的回答还有更明显的差距。
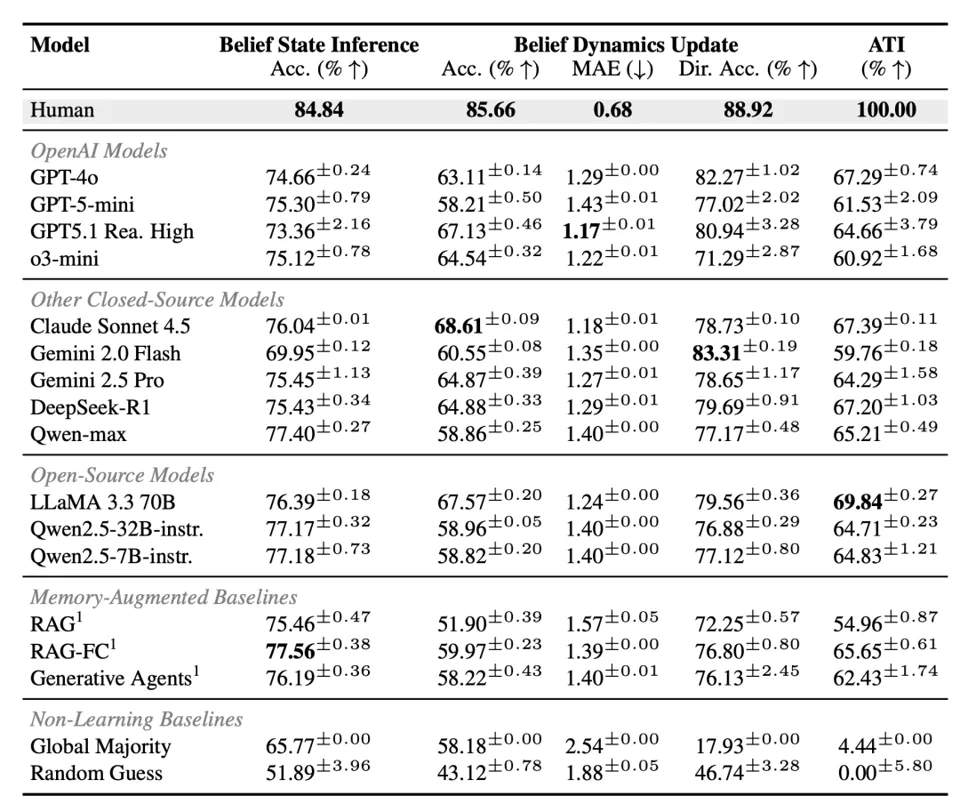
图注: 不同模型在两类HugAgent任务上的整体表现。相比推断一个人当前的信念,模型在预测新情境下的回答时,与参与者自身的一致性上限之间仍有更明显的差距。
不过,这并不意味着新情境下的回答根本无法从访谈中预测。
以GPT-4o为例,如果不提供个人访谈,只依赖人口统计等信息,Belief Dynamics Update准确率只有 39.83%;加入这个人的完整访谈后,提高到63.11%。
Qwen2.5-32B也出现了类似的变化,从32.12% 提高到58.96%。
也就是说,访谈并不只是给模型增加了一段更长的上下文。这个人自己说过的话,确实包含了预测他之后如何回答的个体信息。
进一步的cross-person实验也得到相似结果:如果把本人访谈换成另一个人的,GPT-4o在更新任务上的准确率下降到39.30%,几乎回到没有本人访谈的水平。
图注: 没有个人访谈与加入完整本人访谈后的表现对比。个人访谈明显提高了模型对具体参与者的预测能力。
既然访谈有用,一个很自然的想法是:那就多聊一点。
如果数字分身主要是一个信息量的问题,那么5轮访谈应该不如10轮,10轮又应该不如完整访谈。
但HugAgent没有看到这样一个稳定的关系。
以Qwen2.5-32B为例,随着访谈内容增加,Belief State Inference的准确率从68.84%上升到73.02%,最终达到77.17%。
但Belief Dynamics Update并没有同步提高,反而从61.79%变为60.73%,完整访谈下为58.96%。
这并不是说采访没有用。前面的实验已经说明,从「不认识这个人」到拥有本人的访谈,差别很明显。
真正值得注意的是:
从没有个人信息到有个人信息很重要,但继续把关于一个人的材料越堆越多,并不会自动换来更准确的新情境预测。
不同访谈长度下的模型表现。更多上下文能提供更多当前信念的线索,但对新情境回答的预测没有出现同样稳定的提升。
再往下拆,模型究竟难在哪里,也能看到一些线索。
预测一个人的变化,其实可以粗略拆成两个问题:他会不会变,以及如果变,会往哪个方向变。
至少在医疗领域,GPT-4o一旦判断某个人的态度会发生变化,对变化方向的判断准确率达到88.89%;但判断这个人究竟会不会发生变化,准确率只有49.36%。
这说明,模型往往知道新信息会把态度往哪个方向推,更困难的可能是另一个问题:
什么样的变化,才真的足以让这个人改主意?
一个可能的原因是,访谈比较容易暴露一个人在意哪些因素,以及这些因素大致会把立场往什么方向推动;但一个人究竟在什么位置有多大的「改变阈值」,从已有表达里要更难判断。
数字分身真正的考验
看完这些结果,HugAgent留下来的,并不只是一张GPT、Claude、Gemini的模型排行榜。更重要的是,它把「数字分身」研究里一个很容易被跳过的问题摆到了台面上:
一个模型对你的过去复现得很像,并不能自动证明它能够代表你的未来回答。
这一区别对于human simulation尤其重要。
如果AI只是被用来总结一个人的既有观点,那么一份足够详细的persona也许已经很好用。但越来越多的应用想做的远不止这些。研究者希望用合成参与者测试尚未发布的政策,希望用AI消费者判断一个新产品会得到怎样的反应,也希望让personalized agent替用户处理过去从未遇到过的新选择。
这些用途都有一个共同前提:
模型必须能够从已经观察到的个人信息,外推到没有直接问过的情境。
也正是在这里,数字分身真正的考验才开始。
复述已知观点只是起点。数字分身真正的价值,是在问题变了、条件变了之后,依然能够代表这个人。
如果一个模型只能把采访里已经出现过的观点复现得越来越像,那么它更接近一份非常详细的个人档案。真正困难的是:当条件改变,一个陌生的选择第一次出现,它还能不能沿着这个人的理由和权衡继续往下走。
HugAgent的结果说明,这一步不能被默认成立。
个人访谈确实提供了有价值的个体信息,但更多访谈并不会稳定地转化成对未见情境更准确的预测。未来构建数字分身时,问题可能不只是「还要收集多少数据」,还包括:
究竟需要知道一个人的什么,才能预测他在一个从未回答过的问题上会怎么判断?
当然,HugAgent目前测到的,仍然是假设情境下的自我报告,而不是真实世界中长期发生的行为和观点变化。它回答的是:根据一个人的访谈和既有回答,能不能预测他面对一个此前没见过的假设情境时会怎么回答?而模型与100%之间的差距,也不能全部解释成模型能力不足。人的回答本身存在波动,一些假设问题也未必能从已有信息中推出唯一答案。
所以,最后留下的问题可能比某个具体的benchmark分数更基础:
我们应该用什么证据,才能相信一个AI真的足以「代表」某个人?
是它能复述这个人的观点?
是它能回答几道没见过的问卷?
还是只有当环境和条件改变之后,它依然能够做出和本人相似的权衡,我们才应该开始称它为一个可靠的数字分身?
大模型正在越来越擅长保存我们的偏好、语言和经历。
但从一份详细的「关于我的档案」,走到一个真正能够在陌生情境中代表「我」的模型,中间可能还有相当长的一段距离。
采访一个人,也许已经足以让AI越来越像他。
但「像他」,和「能够代表他」,仍然是两件不同的事。
参考资料:
https://arxiv.org/abs/2510.15144
秒追ASI
⭐点赞、转发、在看一键三连⭐
点亮星标,锁定新智元极速推送!