Qwen3.5-Omni 发布:原生全模态,支持 10 小时音频输入
阿里通义千问团队发布新一代原生全模态大模型 Qwen3.5-Omni,采用 Hybrid-Attention MoE 架构,实现文本、图像、音频及视频的统一理解与生成。该模型支持 256k 长上下文,可处理超过 10 小时的音频和 400 秒的 720P 视频输入,并在多语言语音识别(113 种)与生成(36 种)上显著增强。在 Plus 版本中,模型于 215 项子任务/Benchmark 中取得 SOTA 成绩,标志着从拼接式多模态向原生统一架构的重大跨越。
报道正文
本文目录15 个章节

QWEN CHAT Hugging Face Offline Demo Hugging Face Realtime Demo ModelScope Offline Demo ModelScope Realtime Demo
Qwen3.5-Omni 是 Qwen 最新一代全模态大模型,支持文本、图片、音频、音视频理解。结构上,Qwen3.5-Omni 的 Thinker 与 Talker 均采用 Hybrid-Attention MoE 架构。Qwen3.5-Omni 系列包含 Plus、Flash、Light 三种尺寸的 Instruct 版本,支持 256k 长上下文,模型支持超过 10 小时的音频输入及超过 400 秒的 720P(1 FPS)音视频输入。模型在海量文本、视觉以及超过 1 亿小时的音视频数据上进行原生多模态预训练,该模型展现出卓越的全模态感知与生成能力。相比 Qwen3-Omni,Qwen3.5-Omni 多语言能力大大增强,能够支持 113 种语种和方言的语音识别和 36 种语种和方言的语音生成。目前可通过 Offline API 和 Realtime API 进行体验。
离线(Offline)
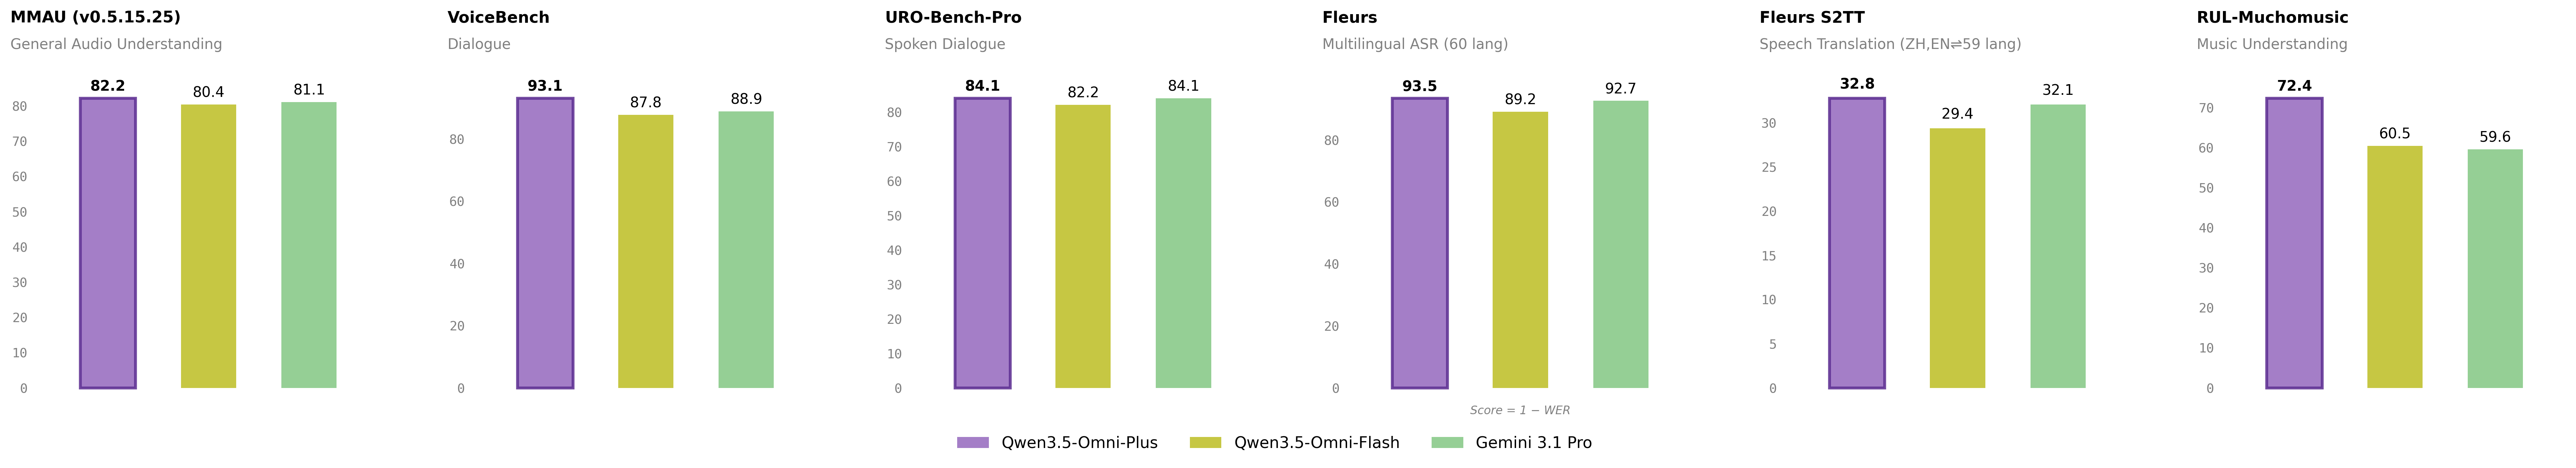
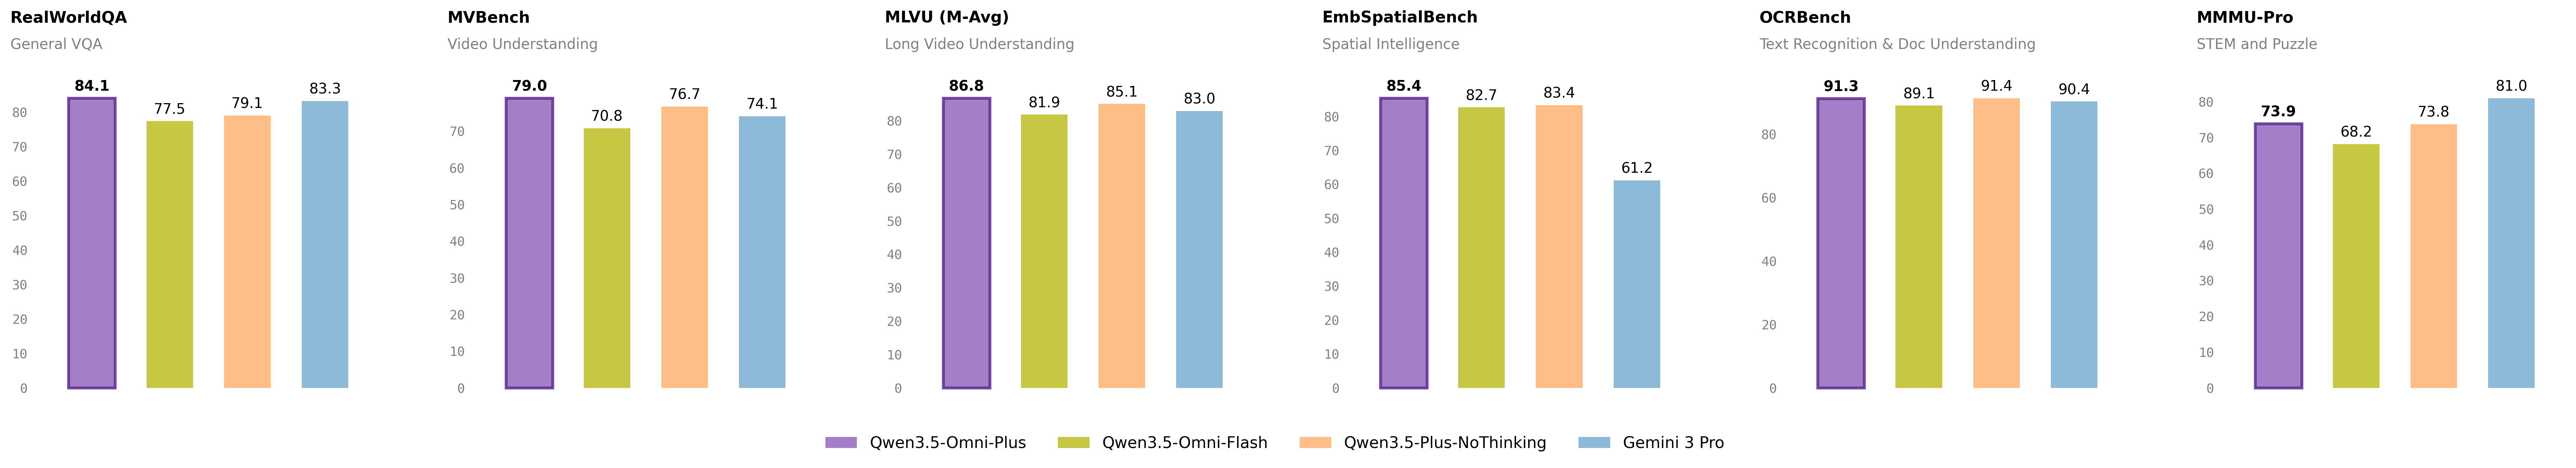
Qwen3.5-Omni-Plus 在音频/音视频的理解、推理和交互任务上共取得了 215 项子任务/Benchmark 的 SOTA 成绩,涵盖 3 个音视频 Benchmark、5 个音频 Benchmark、8 个 ASR Benchmark、156 个面向语种的 S2TT 任务和 43 个面向语种的 ASR 任务。其中,通用音频理解/推理/识别/翻译/对话全面超越 Gemini-3.1 Pro,音视频理解能力总体达到 Gemini-3.1 Pro 水平,同时视觉/文本能力达到同尺寸 Qwen3.5 模型效果。Qwen3.5-Omni-Plus 的一个强大的 feature 是音视频 caption 能力,可以生成可控的、详细的、结构化的音视频 caption,并生成剧本级细粒度描述,包括自动切片、时间戳打标和人物与音频关系的详细介绍。除此以外,通过原生多模态 Scaling,我们观察到了全模态模型涌现出了可以根据音视频指令直接进行 coding 的能力,我们称之为 Audio-Visual Vibe Coding,以上功能可以在 Offline API 上进行体验。我们强烈地建议用户阅读 Demo Section。
实时(Realtime)
除了强大的基座能力,更进一步地,我们着重加强了 Qwen3.5-Omni 的交互能力。第一,我们支持了语义打断,基于 Omni 开发了自动识别 turn-taking 意图的能力,避免附和和无意义背景音打断,该能力在 API 中已原生支持;第二,我们原生支持了 WebSearch 和复杂 Function Call 的调用能力,模型可以自主判断是否需要拉起 WebSearch 来回应用户的即时问题;第三,我们支持了端到端的语音控制和对话,让模型可以像人一样遵循指令,对声音的大小、语速、情绪等进行自由控制;第四,Qwen3.5-Omni 支持音色克隆,用户上传音色来定制 AI Assistant 音色,以上功能可以在 Realtime API 上进行体验。用户也可以自行更改 system prompt,来改变口语化、身份等信息,从而改变模型的行为;第五,针对流式语音交互中由于文本与语音 Token 编码效率差异导致的语音不稳定性,如漏读、误读或数字发音模糊等问题,我们提出了 ARIA(自适应速率交错对齐,Adaptive Rate Interleave Alignment)技术,动态对齐文本与语音单元,在保证实时性的前提下,显著提升了语音合成的自然度与鲁棒性。我们强烈地建议用户阅读 Demo Section 体验模型的最新效果。
模型效果#
Audio-Visual Next

Audio Next
Visual Next
Text Next
Speech Generation Next
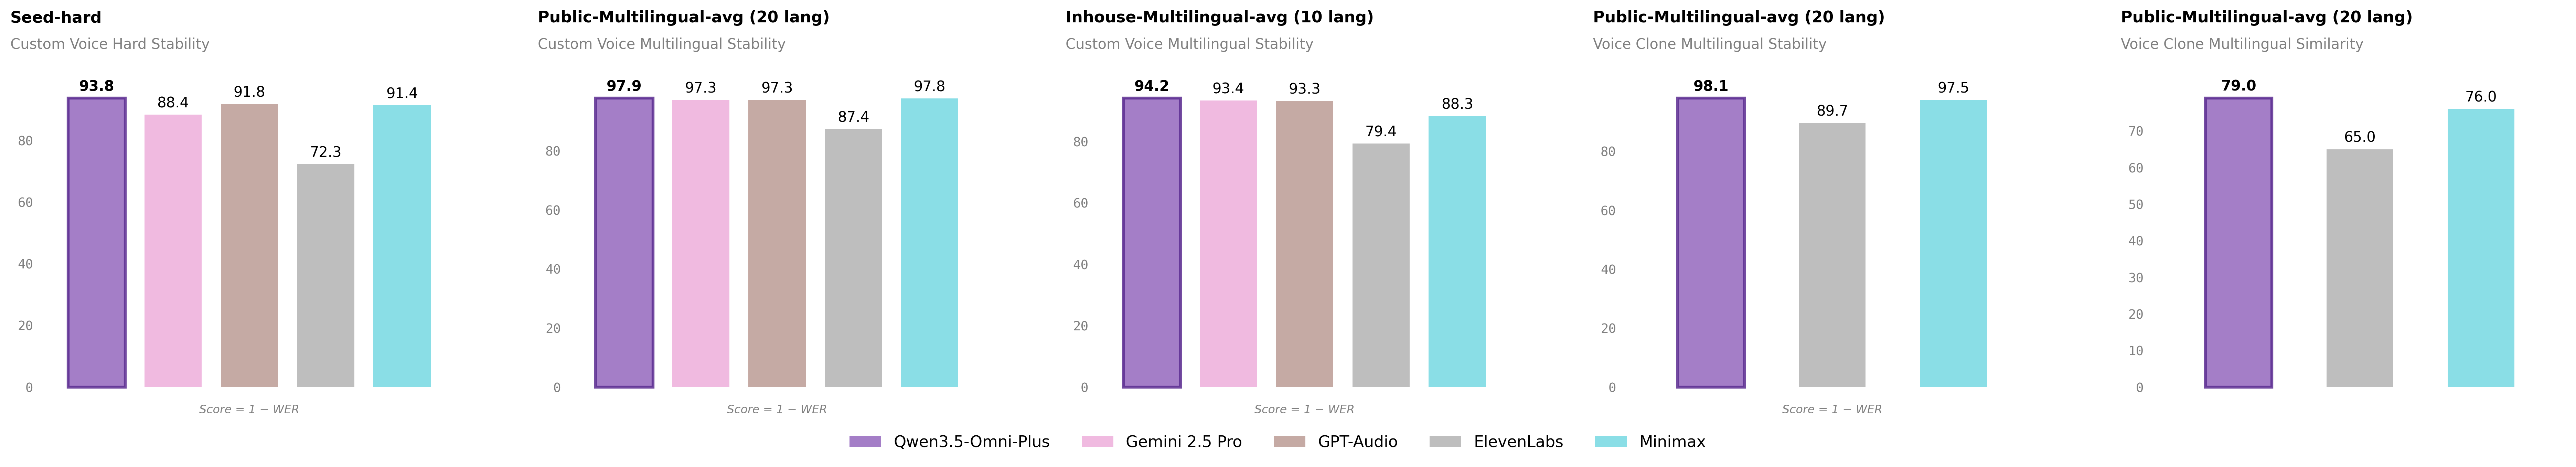
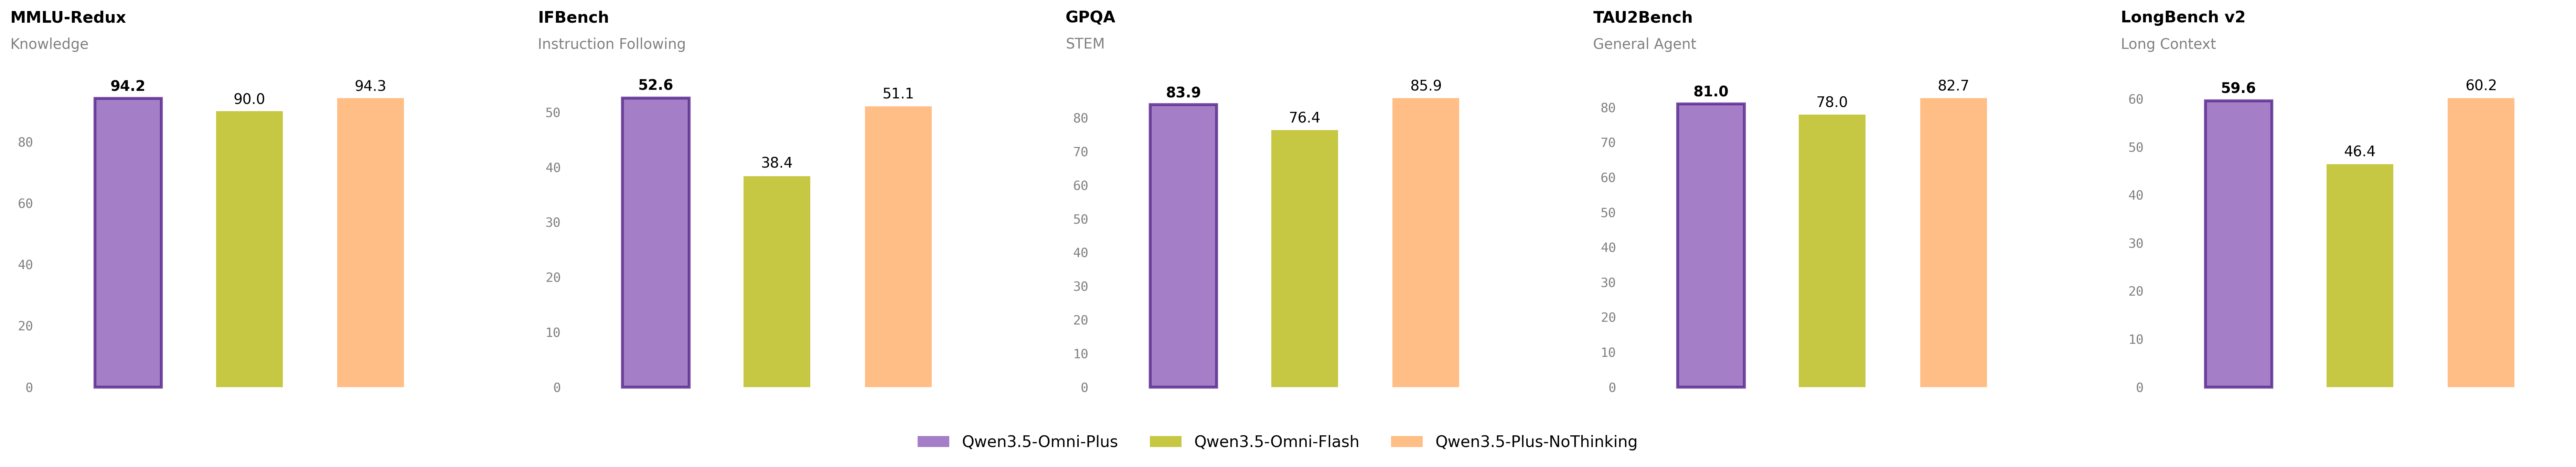
下面我们在多种评估任务与模态下,对 Qwen3.5-Omni 与前沿模型进行全面对比评估。
音视频#
| Gemini-3.1 Pro | Qwen3.5-Omni-Flash | Qwen3.5-Omni-Plus | |
|---|---|---|---|
| Text Query QA | |||
| DailyOmni | 82.7 | 81.8 | 84.6 |
| WorldSense | 65.5 | 57.9 | 62.8 |
| AVUT | 85.6 | 81.4 | 85.0 |
| AV-SpeakerBench | 75.1 | 65.2 | 71.3 |
| VideoMME (with audio) | 89.0 | 79.3 | 83.7 |
| Audio Query QA | |||
| QualcommInteractive | 66.2 | 66.3 | 68.5 |
| Caption | |||
| Omni-Cloze | 57.2 | 63.0 | 64.8 |
| Agent (tool use) | |||
| OmniGAIA | 68.9 | 33.9 | 57.2 |
- VideoMME (with audio): We evaluate our model with use_audio_in_video=True.
- OmniGAIA:We evaluate our model without a thinking prompt and without <answer> formatting. All results are evaluated using deepseek-v3.2-thinking.
音频#
| Gemini-3.1-Pro | Qwen3.5-Omni-Flash | Qwen3.5-Omni-Plus | |
|---|---|---|---|
| Audio Understanding | |||
| MMAU | 81.1 | 80.4 | 82.2 |
| MMAR | 83.7 | 74.0 | 80.0 |
| MMSU | 81.3 | 72.2 | 82.8 |
| RUL-MuchoMusic | 59.6 | 60.5 | 72.4 |
| SongFormBench-HarmonixSet(acc|hr.5f|hr3f) | 75.6 | 46.8 | 77.9 | 80.6 | 67.8 | 83.4 | 81.1 | 72.9 | 85.3 |
| SongFormBench-CN(acc|hr.5f|hr3f) | 78.1 | 43.2 | 71.9 | 86.7 | 66.4 | 84.6 | 87.1 | 65.7 | 84.2 |
| Dialogue | |||
| VoiceBench | 88.9 | 87.8 | 93.1 |
| URO-Bench-Pro(U|R|O) | 69.1 | 84.0 | 99.2 | 64.1 | 83.8 | 98.7 | 66.3 | 86.3 | 99.8 |
| SpeechRole | 124.2 | 119.8 | 123.5 |
| WildSpeech-Bench | 76.3 | 72.2 | 75.4 |
| S2TT | |||
| Fleursxx⇄zh (top59) | 29.5 | 26.9 | 30.2 |
| Fleursxx⇄en (top59) | 34.6 | 32.0 | 35.4 |
| Fleursxx⇄zh/en (top59) | 32.1 | 29.4 | 32.8 |
| ASR | |||
| Fleurs(top60) | 7.32 | 10.75 | 6.55 |
| CV15(zh|yue|zh-tw) | 8.59 | 13.40 | 6.78 | 4.25 | 3.45 | 2.68 | 3.46 | 1.95 | 2.27 |
| CV15(en) | 8.73 | 5.90 | 4.83 |
| Librispeech(clean|other) | 3.36 | 4.41 | 1.30 | 2.43 | 1.11 | 2.23 |
| Wenetspeech(net|meeting) | 11.53 | 14.21 | 4.41 | 5.51 | 4.30 | 5.84 |
| Kespeech | 23.67 | 4.47 | 3.46 |
| MIR-1K(vocal-only) | 8.76 | 4.94 | 4.56 |
| Opencpop | 6.83 | 1.11 | 1.49 |
- SongFormBench: We use a unified prompt defining an SRT-like output timestamp format and a closed vocabulary for evaluation. The vocabulary follows the 'SongForm-HX-8Class' specified in the official codebase.
- URO-Bench-Pro: We use the pro track of URO-Bench and denote the three evaluation dimensions as follows: U for Understanding, R for Reasoning, and O for Oral Conversation. We use GenStyle-en, GenStyle-zh, Multilingual tasks for oral dimension.
- ASR performance is evaluated using WER/CER, where lower values indicate better performance.
- Fleurs: The top59 languages are English, Chinese, Cantonese, Korean, Japanese, Vietnamese, Thai, Malay, German, Russian, Italian, French, Spanish, Portuguese, Dutch, Indonesian, Turkish, Arabic, Polish, Hindi, Urdu, Filipino, Persian, Czech, Greek, Swedish, Hebrew, Danish, Finnish, Norwegian, Icelandic, Bengali, Punjabi, Javanese, Marathi, Swahili, Ukrainian, Gujarati, Kannada, Azerbaijani, Malayalam, Cebuano, Romanian, Hungarian, Bulgarian, Belarusian, Catalan, Tamil, Croatian, Bosnian, Slovak, Galician, Kyrgyz, Macedonian, Slovenian, Latvian, Estonian, and Asturian; compared with the top60 list, Afrikaans is excluded because the Fleurs S2TT test set does not cover this language.
- MIR-1K: Transcription is converted into Simplified Chinese.
视觉#
| Qwen3.5-Plus-NoThinking | Qwen3.5-Omni-Flash | Qwen3.5-Omni-Plus | |
|---|---|---|---|
| STEM and Puzzle | |||
| MMMU | 81.0 | 76.9 | 80.1 |
| MMMU-Pro | 73.8 | 68.2 | 73.9 |
| MathVision | 73.6 | 65.4 | 73.0 |
| Mathvista (mini) | 86.9 | 82.9 | 86.1 |
| DynaMath | 84.2 | 79.3 | 83.8 |
| ZEROBench | 6 | 1 | 5 |
| ZEROBench_sub | 31.1 | 26.0 | 34.4 |
| General VQA | |||
| RealWorldQA | 79.1 | 77.5 | 84.1 |
| MMStar | 80.3 | 75.7 | 79.4 |
| MMBenchEN-DEV-v1.1 | 93.8 | 88.8 | 92.8 |
| SimpleVQA | 66.1 | 54.4 | 65.3 |
| Text Recognition and Document Understanding | |||
| CharXiv (RQ) | 74.2 | 64.4 | 72.5 |
| CC-OCR | 83.0 | 80.8 | 83.4 |
| AI2D_TEST | 92.1 | 89.0 | 91.2 |
| MMLongBench-Doc | 59.7 | 53.6 | 57.5 |
| OCRBench | 91.4 | 89.1 | 91.3 |
| Spatial Intelligence | |||
| ERQA | 53.8 | 50.0 | 54.8 |
| CountBench | 95.1 | 88.2 | 95.1 |
| RefCOCO(avg) | 95.2 | 92.6 | 95.0 |
| ODInW13 | 50.3 | 46.8 | 49.5 |
| EmbSpatialBench | 83.4 | 82.7 | 85.4 |
| Video Understanding | |||
| VideoMME(w/o sub.) | 81.0 | 77.0 | 81.9 |
| MLVU(M-Avg) | 85.1 | 81.9 | 86.8 |
| MVBench | 76.7 | 70.8 | 79.0 |
| LVBench | 68.6 | 65.7 | 71.2 |
| MMVU | 67.1 | 62.7 | 67.5 |
| MME-VideoOCR | 74.2 | 70.5 | 77.0 |
| Medical VQA | |||
| SLAKE | 82.8 | 73.1 | 84.7 |
| PMC-VQA | 62.4 | 58.7 | 62.7 |
| MedXpertQA-MM | 55.3 | 44.8 | 54.7 |
文本#
| Qwen3.5-Plus-NoThinking | Qwen3.5-Omni-Flash | Qwen3.5-Omni-Plus | |
|---|---|---|---|
| Knowledge | |||
| MMLU-Pro | 86.8 | 79.9 | 85.9 |
| MMLU-Redux | 94.3 | 90.0 | 94.2 |
| SuperGPQA | 67.4 | 54.9 | 66.4 |
| C-Eval | 92.3 | 86.0 | 92.0 |
| Instruction Following | |||
| IFEval | 89.7 | 85.2 | 89.7 |
| IFBench | 51.1 | 38.4 | 52.6 |
| Long Context | |||
| AA-LCR | 62.0 | 46.0 | 57.0 |
| LongBench v2 | 60.2 | 46.4 | 59.6 |
| STEM | |||
| GPQA | 85.9 | 76.4 | 83.9 |
| Reasoning | |||
| LiveCodeBench v6 | 67.1 | 56.6 | 65.6 |
| HMMT Nov 25 | 86.2 | 59.0 | 84.4 |
| IMOAnswerBench | 68.3 | 51.5 | 65.5 |
| General Agent | |||
| BFCL-V4 | 66.1 | 55.3 | 63.3 |
| TAU2Bench | 82.7 | 78.0 | 81.0 |
- Qwen3.5-Plus-NoThinking: we use Qwen3.5-Plus-NoThinking as the primary baseline, since all models here are evaluated in the same no-thinking setting.
- TAU2-Bench: we follow the official setup except for the airline domain, where all models are evaluated by applying the fixes proposed in the Claude Opus 4.5 system card.
语音生成#
| ElevenLabs | Gemini-2.5 Pro | GPT-Audio | Minimax | Qwen3.5-Omni-Plus | |
|---|---|---|---|---|---|
| Custom Voice Stability | |||||
| Seed-zh | 13.08 | 2.42 | 1.11 | 1.19 | 1.07 |
| Seed-en | 1.17 | 1.18 | 1.16 | 1.35 | 1.35 |
| Seed-hard | 27.70 | 11.57 | 8.19 | 8.62 | 6.24 |
| Public-Multilingual-avg (20 lang) | 12.62 | 2.72 | 2.65 | 2.16 | 2.06 |
| Inhouse-Multilingual-avg (9 lang) | 20.63 | 6.61 | 6.72 | 11.71 | 5.82 |
- Stability is measured by Word Error Rate (WER, ↓).
- "Public-Multilingual-avg" refers to the average performance on the public TTS-Multilingual-Test-Set, covering 20 languages.
- "Inhouse-Multilingual-avg" refers to the average performance on an internal multilingual test set built upon Fleurs, covering 9 languages.
- The performance is tested with the following APIs: ElevenLabs-Multilingual-V2 (9YHcvj6GT2YYXdXww), Gemini-2.5 Pro-Preview-TTS (Achernar), GPT-Audio-2025-08-28 (Alloy) and Minimax-Speech-2.8-HD (English_expressive_narrator) in March 2026.
| ElevenLabs | Minimax | Ground-Truth | Qwen3.5-Omni-Plus | |
|---|---|---|---|---|
| Voice Clone Stability | ||||
| Public-Multilingual-avg (20 lang) | 10.29 | 2.52 | - | 1.87 |
| Inhouse-Multilingual-avg (9 lang) | - | - | 9.68 | 7.04 |
| Voice Clone Similarity | ||||
| Public-Multilingual-avg (20 lang) | 0.65 | 0.76 | - | 0.79 |
| Inhouse-Multilingual-avg (9 lang) | - | - | - | 0.80 |
- Stability is measured by Word Error Rate (WER, ↓) and similarity is measured by Cosine Similarity (SIM, ↑).
- "Public-Multilingual-avg" refers to the average performance on the public TTS-Multilingual-Test-Set, covering 20 languages.
- "Inhouse-Multilingual-avg" refers to the average performance on an internal multilingual test set built upon Fleurs, covering 9 languages.
- Empty cells (-) indicate scores not yet available or not applicable.
模型架构#
Qwen3.5-Omni 延续采用 Thinker-Talker 架构,Thinker 通过 Vision Encoder 和 AuT 接受视觉和音频信号输入,音视频信号通过 interleave 交织并搭配 TMRoPE 编码位置信息。Thinker 负责处理全模态信号并输出文本,Talker 负责接收来自 Thinker 的多模态输入以及文本输出,进行 contextual 语音生成,语音表征通过 Qwen3-Omni 提出的 RVQ 编码来替代繁重的 DiT 运算。由于 chunk-wise 的流式输入设计和流式 Talker 设计,整个模型可以进行 realtime interaction。不同于上一代 Qwen3-Omni 的双轨 Talker 输入,Talker 在输入的组织方式上采用了 ARIA(自适应速率交错对齐,Adaptive Rate Interleave Alignment)来动态对齐文本与语音单元,然后进行交错排布,以避免由于文本与语音 Token 编码效率差异导致的语音不稳定性,如漏读、误读或数字发音模糊等问题。

Qwen3.5-Omni vs Qwen3-Omni#
| Qwen3-Omni | Qwen3.5-Omni | |
|---|---|---|
| 主干框架 | MoE | Hybrid-MoE |
| 支持序列 | 32k | 256k 音频:10个小时 音视频 (FPS=1):400秒 |
| Caption能力 | 音频 | 音视频 |
| 智能语义打断 | 无 | 支持 |
| WebSearch/Tool | 无 | 原生API支持 |
| 语音控制 | 无 | 支持 |
| 音色克隆 | 无 | 支持 |
| Talker | 双轨自回归 | Interleave |
| Text-Audio Tokenizer Rate | Fixed (1) | ARIA (Adaptive Rate Interleaved Alignment) |
| 语音识别 | - 11种多语言:中文、英语、德语、法语、意大利语、泰语、韩语、日语、俄语、西班牙语、葡萄牙语 - 8种方言:四川话、上海话、粤语、闽南语、陕西话、南京话、天津话、北京话 | - 74种多语言:南非语、阿拉伯语、阿斯图里亚斯语、阿塞拜疆语、巴斯克语、白俄罗斯语、孟加拉语、波斯尼亚语、保加利亚语、粤语、加泰罗尼亚语、宿务语、中文、克罗地亚语、捷克语、丹麦语、荷兰语、英语、世界语、爱沙尼亚语、菲律宾语、芬兰语、法语、加利西亚语、格鲁吉亚语、德语、希腊语、希伯来语、印地语、匈牙利语、冰岛语、印尼语、国际语、意大利语、日语、爪哇语、卡纳达语、哈萨克语、韩语、柯尔克孜语、林加拉语、拉脱维亚语、立陶宛语、马其顿语、马来语、马拉雅拉姆语、马耳他语、毛利语、马拉地语、蒙古语、挪威语(博克马尔)、新挪威语、奥里亚语、波斯语、波兰语、葡萄牙语、旁遮普语、罗马尼亚语、俄语、塞尔维亚语、斯洛伐克语、斯洛文尼亚语、西班牙语、斯瓦希里语、瑞典语、塔吉克语、泰米尔语、泰卢固语、泰语、土耳其语、乌克兰语、乌尔都语、维吾尔语、越南语 - 39种方言:东北话、贵州话、广东粤语、河南话、香港粤语、上海话、陕西话、天津话、台湾话、云南话、安徽话、福建话、甘肃话、广东普通话、湖北话、湖南话、江西话、山东话、山西话、四川话、广西话、海南话、重庆话、长沙话、杭州话、合肥话、银川话、郑州话、沈阳话、温州话、武汉话、昆明话、太原话、南昌话、济南话、兰州话、南京话、客家话、闽南语 |
| 语音合成 | - 29种多语言:中文、英语、德语、意大利语、葡萄牙语、西班牙语、日语、韩语、法语、俄语、泰语、印度尼西亚语、阿拉伯语、越南语、土耳其语、芬兰语、波兰语、印地语、荷兰语、捷克语、乌尔都语、他加禄语、瑞典语、丹麦语、希伯来语、冰岛语、马来语、挪威语、波斯语 - 7种方言:四川话、北京话、天津话、南京话、陕西话、粤语、闽南语 |
Demo#
通用音视频理解#
输入音视频(Audio-Visual Input),Qwen3.5-Omni-Plus 能够遵循指令生成细粒度、结构化、带时间戳的准确 Caption,以供用户进行音视频分析、分镜、审核等场景。
纪录片: 复杂场景 + 饮食 + 音效分析-Video Studio#
电影: 多人多镜头+复杂音效音视频分析#
游戏: 基于音视频判断是否包含暴力场景#
DemoUser
请对视频进行详尽的合规性分析。你的目标是作为一名专业的未成年人内容保护审核员,识别视频中所有可能对未成年人产生负面影响的内容。
### 核心分析要求:
1. **零容忍政策 (Zero-Tolerance Policy):** 在审核过程中,请以保护未成年人心理及生理健康为最高准则。如果某段内容在是否“适宜”上存在不确定性,请始终采取审慎态度,将其标记为不适宜内容。
2. **重点检测范围:**
  - **暴力与血腥:** 真实的流血、重伤、肢体残缺、武器使用、攻击性身体接触。
  - **危险行为:** 易被模仿的危险特技、无防护的冒险动作。
  - **言语与欺凌:** 针对个人的辱骂、霸凌、恐吓及歧视性言论。
  - **不当主题:** 成人化倾向、毒品/酒精滥用、引起极端恐惧的恐怖视觉或听觉刺激。

### 输出格式要求:
第一部分:合规预警摘要 (Compliance Alert Summary)
请提供一份表格,汇总所有被检测到的违规片段,以供快速查阅:
| 时间区间 | 违规类别 | 风险等级 | 违规理由描述 |
|---|---|---|---|
| xx - xx | 例如:暴力行为 | 高 | 例如:观察到真实且激烈的肢体冲突,包含头部打击。 |
第二部分:安全评估结论 (Summary of Safety Findings)
请基于全片内容提供最终评估结论,判断该视频是否适合未成年人观看。
- 必须引用最关键的时间节点。
- 详细说明整体风险画像(Risk Profile)。
- 解释为何判定其适合或不适合未成年人。
Qwen3.5-Omni-Plus

## 第一部分:合规预警摘要 (Compliance Alert Summary)[#](https://qwen.ai/blog?id=qwen3.5-omni#%E7%AC%AC%E4%B8%80%E9%83%A8%E5%88%86%E5%90%88%E8%A7%84%E9%A2%84%E8%AD%A6%E6%91%98%E8%A6%81-compliance-alert-summary)

| 时间区间 | 违规类别 | 风险等级 | 违规理由描述 |
| --- | --- | --- | --- |
| 01:29 - 01:48 | 暴力与血腥 | 高 | 角色被撕成两半,内脏与骨骼外露,伴随大量喷溅血液与痛苦惨叫。 |
| 02:29 - 02:46 | 暴力与血腥 | 高 | 角色被斩首并开膛破肚,内脏与血液大量喷溅,画面极度血腥。 |
| 03:17 - 03:38 | 暴力与血腥 | 高 | 角色被冰冻后碎裂成无数冰块,伴随血液飞溅与肢体断裂。 |
| 04:15 - 04:37 | 暴力与血腥 | 高 | 角色被灵魂撕裂,身体与灵魂分离,伴随蓝色能量撕裂与血液喷溅。 |
| 05:07 - 05:29 | 暴力与血腥 | 高 | 角色被炸弹炸成碎片,肢体与内脏四散,伴随大量血液与火焰。 |
| 05:58 - 06:24 | 暴力与血腥 | 高 | 角色被掏空内脏并扯下头颅,内脏与血液喷溅,画面极度残忍。 |
| 06:57 - 07:20 | 暴力与血腥 | 高 | 角色被直升机螺旋桨绞碎,肢体与内脏四散,伴随大量血液飞溅。 |

## 第二部分:安全评估结论 (Summary of Safety Findings)[#](https://qwen.ai/blog?id=qwen3.5-omni#%E7%AC%AC%E4%BA%8C%E9%83%A8%E5%88%86%E5%AE%89%E5%85%A8%E8%AF%84%E4%BC%B0%E7%BB%93%E8%AE%BA-summary-of-safety-findings)

该视频不适合未成年人观看。从01:29开始,视频连续展示了多段极端暴力与血腥的“终结技”场景,包括角色被撕成两半、斩首、冰冻碎裂、灵魂撕裂、炸弹炸碎、掏空内脏、被直升机绞碎等。这些画面包含大量真实感极强的血液喷溅、内脏外露、肢体残缺与痛苦惨叫,视觉冲击力极强,极易对未成年人造成心理创伤与恐惧。此外,视频中无明确年龄分级提示或内容警告,且暴力行为被设计为游戏机制的一部分,可能被误读为“可接受的娱乐行为”,存在模仿风险。根据零容忍政策,此类内容应被严格限制,建议仅对18岁以上成年观众开放,并需附加明确的内容警示。

#### 短视频: 生活短视频分析[#](https://qwen.ai/blog?id=qwen3.5-omni#%E7%9F%AD%E8%A7%86%E9%A2%91-%E7%94%9F%E6%B4%BB%E7%9F%AD%E8%A7%86%E9%A2%91%E5%88%86%E6%9E%90)

#### 推荐使用方式[#](https://qwen.ai/blog?id=qwen3.5-omni#%E6%8E%A8%E8%8D%90%E4%BD%BF%E7%94%A8%E6%96%B9%E5%BC%8F)

| 配置 | 最大像素 | 推荐视频时长 | 推荐使用 Prompt | 场景 |
| --- | --- | --- | --- | --- |
| 低成本 | 230,400 像素 | 60 分钟以下 | 50 个词以内的自定义 Prompt,视需求而定 | - 审核 |
| 简略 (精确度要求不高) | 921,600–2,073,600 像素 | 60 分钟以下 | 50 个词以内的自定义 Prompt,视需求而定 | - 长视频分段 - 大致内容提取 |
| 均衡 (通用音视频详细描述) | 921,600–2,073,600 像素 | 4 分钟以下 | [固定的结构化描述 Prompt](https://qwen.ai/blog?id=qwen3.5-omni#structured-prompt-va) | - 细粒度音视频描述打标 |
| 最佳 (生成最详细的描述) | 2,073,600 像素 | 2 分钟以下 | [固定的结构化描述 Prompt](https://qwen.ai/blog?id=qwen3.5-omni#structured-prompt-va) | - 多场景 - 多说话人 - 复杂场景 |
| 注:如果更长的音视频也想获得结构化的音视频细粒度描述,建议分段。 |  |  |  |  |

#### 固定的结构化描述 Prompt[#](https://qwen.ai/blog?id=qwen3.5-omni#%E5%9B%BA%E5%AE%9A%E7%9A%84%E7%BB%93%E6%9E%84%E5%8C%96%E6%8F%8F%E8%BF%B0-prompt)
Provide a detailed description of the video.
It should explicitly include three sections:
- A structured chronological storyline of every noticeable audio and visual details
- A structured list of all visible text. For each text element, include start timestamp, end timestamp, the exact text content, the appearance characteristics. If no text appears, explicitly state so.
- A structured speech-to-text transcription, include speaker(Corresponding to the character or voice‑over in Section 1, including their accent and tone), exact spoken content, start timestamp, end timestamp, and speaking state (prosody, emotion, and style). If no speech appears, explicitly state so.
Aside from these three required sections, you are free to organize any additional content in any way you find helpful. This additional content can include global information about the entire video or localized information about specific moments. You may choose the topic of this extra content freely.
Output Format:
## Storyline

<xx:xx.xxx> - <xx:xx.xxx>
<an unstructured long paragraph in natural language describing what happened during this period, blending both audio and video details.>

<xx:xx.xxx> - <xx:xx.xxx>
<an unstructured long paragraph in natural language describing what happened during this period, blending both audio and video details.>

<xx:xx.xxx> - <xx:xx.xxx>
<an unstructured long paragraph in natural language describing what happened during this period, blending both audio and video details.>

...

## Visible Text

<xx:xx.xxx> - <xx:xx.xxx>
“<element>”: <appearance>
“<element>”: <appearance>

<xx:xx.xxx> - <xx:xx.xxx>
“<element>”: <appearance>
“<element>”: <appearance>
“<element>”: <appearance>

<xx:xx.xxx> - <xx:xx.xxx>
“<element>”: <appearance>

...

## Speakers and Transcript

Speaker profiles:
<speaker> - <profile>
<speaker> - <profile>
<speaker> - <profile>
...

<xx:xx.xxx> - <xx:xx.xxx>
Speaker: <speaker>
State: <description>
Content: “<content>”

<xx:xx.xxx> - <xx:xx.xxx>
Speaker: <speaker>
State: <description>
Content: “<content>”

<xx:xx.xxx> - <xx:xx.xxx>
Speaker: <speaker>
State: <description>
Content: “<content>”

...

<paragraphs>

<paragraphs>

...
### 音视频 Vibe Coding[#](https://qwen.ai/blog?id=qwen3.5-omni#%E9%9F%B3%E8%A7%86%E9%A2%91-vibe-coding)

#### 贪吃蛇游戏[#](https://qwen.ai/blog?id=qwen3.5-omni#%E8%B4%AA%E5%90%83%E8%9B%87%E6%B8%B8%E6%88%8F)

DemoUserQwen3.5-Omni-PlusUserQwen3.5-Omni-Plus

#### 产品原型to代码 - Demo2Code[#](https://qwen.ai/blog?id=qwen3.5-omni#%E4%BA%A7%E5%93%81%E5%8E%9F%E5%9E%8Bto%E4%BB%A3%E7%A0%81---demo2code)

DemoUserQwen3.5-Omni-PlusUserQwen3.5-Omni-Plus

### 音视频对话[#](https://qwen.ai/blog?id=qwen3.5-omni#%E9%9F%B3%E8%A7%86%E9%A2%91%E5%AF%B9%E8%AF%9D)

#### 出行规划-天气/酒店查询 Websearch/Tool[#](https://qwen.ai/blog?id=qwen3.5-omni#%E5%87%BA%E8%A1%8C%E8%A7%84%E5%88%92-%E5%A4%A9%E6%B0%94%E9%85%92%E5%BA%97%E6%9F%A5%E8%AF%A2-websearchtool)

Demo

#### 音色克隆[#](https://qwen.ai/blog?id=qwen3.5-omni#%E9%9F%B3%E8%89%B2%E5%85%8B%E9%9A%86)

Demo

#### 多轮对话与智能打断[#](https://qwen.ai/blog?id=qwen3.5-omni#%E5%A4%9A%E8%BD%AE%E5%AF%B9%E8%AF%9D%E4%B8%8E%E6%99%BA%E8%83%BD%E6%89%93%E6%96%AD)

Demo

#### 自由控制对话声音的风格/情绪与音量[#](https://qwen.ai/blog?id=qwen3.5-omni#%E8%87%AA%E7%94%B1%E6%8E%A7%E5%88%B6%E5%AF%B9%E8%AF%9D%E5%A3%B0%E9%9F%B3%E7%9A%84%E9%A3%8E%E6%A0%BC%E6%83%85%E7%BB%AA%E4%B8%8E%E9%9F%B3%E9%87%8F)

Demo

### 通用音频理解[#](https://qwen.ai/blog?id=qwen3.5-omni#%E9%80%9A%E7%94%A8%E9%9F%B3%E9%A2%91%E7%90%86%E8%A7%A3)

#### 多方言Rap理解[#](https://qwen.ai/blog?id=qwen3.5-omni#%E5%A4%9A%E6%96%B9%E8%A8%80rap%E7%90%86%E8%A7%A3)

DemoUser
给出不同方言歌手的声音特征、演唱时的情绪状态、以及对应的完整歌词
Qwen3.5-Omni-Plus

这段音频由多位来自中国不同地区的歌手用各自的方言进行说唱,展现了中国方言的丰富多样性。以下是每位歌手的声音特征、情绪状态及对应歌词的详细描述:

---

### 1. 粤语 (广州话)[#](https://qwen.ai/blog?id=qwen3.5-omni#1-%E7%B2%A4%E8%AF%AD-%E5%B9%BF%E5%B7%9E%E8%AF%9D)

**声音特征**:

这位男歌手的声音清晰且富有节奏感,带有典型的粤语九声六调的韵律,咬字干脆利落。他的声线属于中音区,听起来自信且充满活力,有一种街头巷尾的亲切感。

**情绪状态**:

情绪高昂、自豪且轻松。他在描绘家乡广州的日常生活和美食时,流露出深深的热爱和作为本地人的自豪感,整体氛围欢快、热闹。

**对应歌词**:

> 廣州,食在廣州,帶你遊轉廣州塔

> 我屋企樓下,仲有廣州電車搭

> 穿過越秀,帶你到轉天河

> 三五知己,我哋扎翻半隻燒鵝

> 我哋踢住拖,哼住歌,麻將館等自摸

> 贏咗錢搞邊科,珠江邊靚女多

> 帶佢去食田螺,嚟多份炒牛河

> 最驚係飲大咗,到最尾食白果

---

### 2. 普通话 (北京口音)[#](https://qwen.ai/blog?id=qwen3.5-omni#2-%E6%99%AE%E9%80%9A%E8%AF%9D-%E5%8C%97%E4%BA%AC%E5%8F%A3%E9%9F%B3)

**声音特征**:

这位女歌手的声音清脆、明亮,带有明显的北京“儿化音”特色,吐字清晰且节奏感强。她的声音中透着一股“京味儿”的飒爽和利落。

**情绪状态**:

自信、大气且充满文化底蕴。她以一种叙述者的姿态,历数北京的历史地标和文化符号,情绪中带着对古都的骄傲和深厚的归属感。

**对应歌词**:

> 来自四九城的孩子,天生就流着帝王血

> 盘龙聚气历经朝野,我相信你也能了解

> 北京是北海公园的白塔,故宫的琉璃瓦

> 是马连道的茉莉花,和鼓楼后海的酒吧

> 北京是永远不会消失的宣武和崇文

> 是陶然亭滑雪时你摔过的屁股墩儿

> 是周末西单图书大厦爱看书的黄昏

> 是每个胡同里光膀子穿片儿懒老炮儿的魂

---

### 3. 杭州话 (吴语)[#](https://qwen.ai/blog?id=qwen3.5-omni#3-%E6%9D%AD%E5%B7%9E%E8%AF%9D-%E5%90%B4%E8%AF%AD)

**声音特征**:

这位男歌手的声音较为柔和,带有吴语特有的软糯和温婉。他的语调起伏平缓,节奏轻快,给人一种娓娓道来的感觉。

**情绪状态**:

悠闲、惬意且充满生活气息。他描绘了杭州的慢生活和城市变迁,情绪中带着对家乡的眷恋和对现代发展的感慨,整体感觉舒适而亲切。

**对应歌词**:

> 杭州话,听听看,我们格文化,包括家门口的儿化音

> 像花开在西湖边,不搞文化调查,只有我们搞得懂

> 你们都不懂,三不搭门,格儿,老儿,粉儿,伢儿,这外人分得清?

> 出发,变化快,地铁交通发达,据说要去看看

> 包容新马泰,看十三太,为城市骄傲,性格直给

> 感情你只为过桥,而且味道不一样,你不来嘞

---

### 4. 河南话 (中原官话)[#](https://qwen.ai/blog?id=qwen3.5-omni#4-%E6%B2%B3%E5%8D%97%E8%AF%9D-%E4%B8%AD%E5%8E%9F%E5%AE%98%E8%AF%9D)

**声音特征**:

这位男歌手的声音浑厚、有力,带有河南方言特有的直爽和硬朗。他的发音字正腔圆,节奏感强,充满了力量感。

**情绪状态**:

豪迈、自信且略带调侃。他以一种“中原老大哥”的姿态,讲述河南的历史文化和人文性格,情绪中带着对家乡的自豪和对刻板印象的幽默反击。

**对应歌词**:

> 东西南北转了一大圈,又回到了正中间

> 逐鹿中原,你聊点啥?

> 行了,没法弄,省吃俭用都白拼尽

> 俺这的哥们绝对一个比一个压得活

> 这嗓门都太大了,听不清了说的啥

> 别搁那嘟囔一身白毛衣,还说人家是妖怪

> 不中咱俩掰扯掰扯,好好都给你招待喽

> 还是那句话,哥们还不是恁哥

> 咋着?二七中原金水,管着恁哥有这魔力

---

### 5. 天津话[#](https://qwen.ai/blog?id=qwen3.5-omni#5-%E5%A4%A9%E6%B4%A5%E8%AF%9D)

**声音特征**:

这位男歌手的声音极具辨识度,带有天津话特有的“哏儿”和幽默感。他的语调夸张,节奏明快,像是在说相声一样,充满了表演性。

**情绪状态**:

幽默、风趣且自信。他以一种“逗你玩”的心态,展示天津的曲艺文化和生活情趣,情绪轻松愉快,充满了欢乐的氛围。

**对应歌词**:

> 这是天津卫,TDC都包袱的饶舌

> 你们嘴里的punchline,离不开十三道的大哲

> 辙板辙韵配合,这可不是外婆

> 在茶馆里听相声,大悲寺院里头拜佛

> Crossover把你晃倒,拍照要用广角

> 天上飞的麻雀虽小,我们叫它家雀

> 给你下盘虾饺,酱子就着嘎巴菜

> 妈妈叫你倒霉孩子,是在表达她的爱

---

### 6. 武汉话 (西南官话)[#](https://qwen.ai/blog?id=qwen3.5-omni#6-%E6%AD%A6%E6%B1%89%E8%AF%9D-%E8%A5%BF%E5%8D%97%E5%AE%98%E8%AF%9D)

**声音特征**:

这位男歌手的声音粗犷、直接,带有武汉话特有的“冲”劲和江湖气。他的发音短促有力,节奏感强,给人一种豪爽的感觉。

**情绪状态**:

豪迈、直率且充满江湖义气。他以一种“江湖大佬”的姿态,讲述武汉的码头文化和性格,情绪中带着对家乡的热爱和对“江湖”精神的推崇。

**对应歌词**:

> 在同一片天空下,黄色的皮肤

> 是江湖养育了我,而我荣誉了江湖

> 讲是规矩,习是礼,我们谈的就是情义

> 你可以把话说大,但你不能把你说过的话当放屁

> 中国玩Hip Hop的年龄,八零都比你大

> 不怕你把案子办大,就怕你办不大个慢慢

> 长江后浪推前浪,哥哥来给你做一个榜样

> 你是哪里的,就说哪里的话,莫在这里扎板

---

### 7. 维吾尔语 (新疆)[#](https://qwen.ai/blog?id=qwen3.5-omni#7-%E7%BB%B4%E5%90%BE%E5%B0%94%E8%AF%AD-%E6%96%B0%E7%96%86)

**声音特征**:

这位男歌手的声音充满异域风情,带有维吾尔语独特的韵律和节奏。他的声线高亢有力,充满激情,给人一种热情奔放的感觉。

**情绪状态**:

热情、自豪且充满活力。他以一种“家乡代言人”的姿态,展示新疆的自然风光和人文特色,情绪中带着对家乡的深深热爱和自豪。

**对应歌词**:

> 从喀什到和田,从阿克苏到库尔勒

> 从伊犁到阿勒泰,从吐鲁番到哈密

> 我们新疆好地方,天山南北好风光

> 葡萄沟的葡萄,哈密瓜的甜

> 我们新疆好儿女,勤劳勇敢又善良

> 我们新疆好文化,丰富多彩又灿烂

> 我们新疆好未来,充满希望又光明

> 我们新疆好儿女,团结一心向前进

---

### 8. 山西话 (晋语)[#](https://qwen.ai/blog?id=qwen3.5-omni#8-%E5%B1%B1%E8%A5%BF%E8%AF%9D-%E6%99%8B%E8%AF%AD)

**声音特征**:

这位男歌手的声音朴实、厚重,带有山西话特有的古拙和沉稳。他的发音字正腔圆,节奏感强,给人一种踏实的感觉。

**情绪状态**:

朴实、真诚且充满历史感。他以一种“历史见证者”的姿态,讲述山西的悠久历史和文化,情绪中带着对家乡的热爱和对历史的敬畏。

**对应歌词**:

> 来自龙城山西太原,建城两千五百年

> 山西除了煤矿和面,还有一个武则天

> 太原后生说话从来都是很硬

> 五和尚佛经有声,你吭气,互相帮助

> 北方人说话都比较实在,撇开话从不多说

> 就像我们这的风和,没事了你可以来太原找伙计耍一耍

> 伙计带你去看看什么叫做闹他

---

### 9. 云南话 (西南官话)[#](https://qwen.ai/blog?id=qwen3.5-omni#9-%E4%BA%91%E5%8D%97%E8%AF%9D-%E8%A5%BF%E5%8D%97%E5%AE%98%E8%AF%9D)

**声音特征**:

这位女歌手的声音柔和、悠扬,带有云南话特有的温婉和柔美。她的语调轻快,节奏感强,给人一种清新自然的感觉。

**情绪状态**:

轻松、愉悦且充满自然气息。他以一种“自然之子”的姿态,描绘云南的美丽风光和多彩民族,情绪中带着对家乡的热爱和对自然的向往。

**对应歌词**:

> 来到中国南端的美云南,逛这里只会让你觉得时间短

> 不间断美女让你看,走心一轮的小鹿乱撞

> 美丽的风景都不是幻想,快点充足电量

> 吃滇式宝的晚霞,能有七彩之度

> 各种民族民风,你要干嘛跟我记住

> 从各种列车下路,再到满腹的诗书

> 从过桥的米线,再吃到野生的菌菇

---

### 10. 河北话 (冀鲁官话)[#](https://qwen.ai/blog?id=qwen3.5-omni#10-%E6%B2%B3%E5%8C%97%E8%AF%9D-%E5%86%80%E9%B2%81%E5%AE%98%E8%AF%9D)

**声音特征**:

这位男歌手的声音朴实、直接,带有河北话特有的直爽和豪迈。他的发音字正腔圆,节奏感强,给人一种踏实的感觉。

**情绪状态**:

朴实、真诚且充满乡土气息。他以一种“家乡代言人”的姿态,讲述河北的风土人情和生活趣事,情绪中带着对家乡的热爱和对生活的热情。

**对应歌词**:

> 关于唐山,听我给你叙一叙

> 0315的代号,你可得记一记

> 今儿后生上哪啊?上沈家和酒家

> 中了,快别说了,赶紧走了

> 吃个烧饼吃个够,别对板栗说声no

> 醋溜疙瘩来一盘,22度你喝个够

> 多么大的苦难,我都没喊过疼

> 我是废墟中成长,涅槃的凤凰城

---

### 11. 四川话 (西南官话)[#](https://qwen.ai/blog?id=qwen3.5-omni#11-%E5%9B%9B%E5%B7%9D%E8%AF%9D-%E8%A5%BF%E5%8D%97%E5%AE%98%E8%AF%9D)

**声音特征**:

这位男歌手的声音慵懒、随性,带有四川话特有的“巴适”和悠闲。他的语调轻快,节奏感强,给人一种轻松自在的感觉。

**情绪状态**:

轻松、惬意且充满生活情趣。他以一种“生活家”的姿态,描绘四川的美食文化和生活态度,情绪中带着对家乡的热爱和对生活的享受。

**对应歌词**:

> 天空把能力不断的展现

> 铸造了成绩,逼着你不断攀山

> 四川的方言特别的罕见

> 来成都去吃冰粉,再去吃个燃面

> 这条宽窄巷子是你的白天

> 突然到疯子,别去装憨厚

> 你过了这个村,看到朋友也得走到脚后跟

> 像无极,蹦蹦跳跳,要帅到歌声响起

> 毛肚,鸭肠,黄喉,你要当一个,小学生

---

### 12. 东北话 (东北官话)[#](https://qwen.ai/blog?id=qwen3.5-omni#12-%E4%B8%9C%E5%8C%97%E8%AF%9D-%E4%B8%9C%E5%8C%97%E5%AE%98%E8%AF%9D)

**声音特征**:

这位男歌手的声音豪爽、直接,带有东北话特有的“大碴子味”和幽默感。他的发音字正腔圆,节奏感强,给人一种豪迈的感觉。

**情绪状态**:

豪迈、幽默且充满乡土气息。他以一种“东北老铁”的姿态,讲述东北的风土人情和生活趣事,情绪中带着对家乡的热爱和对生活的热情。

**对应歌词**:

> 走南闯北,咱哥们来自东北

> 景色优美,管它叫白山黑水

> 矿产资源,从东北直嘎供给

> 就完了,喝酒从来不讲勾兑

> 你长得好看,喝多我不知道咋办

> 去外地发展,说我有我的打算

> 精心打扮的你在一旁扒蒜

> 听说我要走,眼泪在眼圈打转

> 都得喝了,喝到全都多了

> 要是半梦半醒,我这手往哪搁呢

> 寻思啥呢?别偷偷摸摸的了

> 扶着我说,赶紧上我的车吧

#### BBC-音频理解[#](https://qwen.ai/blog?id=qwen3.5-omni#bbc-%E9%9F%B3%E9%A2%91%E7%90%86%E8%A7%A3)

#### 歌词字幕生成[#](https://qwen.ai/blog?id=qwen3.5-omni#%E6%AD%8C%E8%AF%8D%E5%AD%97%E5%B9%95%E7%94%9F%E6%88%90)

DemoUser
请你识别这首歌的歌词,并分句给出歌词的时间戳,格式样例如下:
[00:00,020 --> 00:00,085] When you walk through a storm, hold your head up high.
[00:00,085 --> 00:00,200] And don't be afraid of the dark.
[00:00,200 --> 00:01:02] At the end of the storm, there's a golden sky.
...
Qwen3.5-Omni-Plus

[00:00:12,680 –> 00:00:16,960] 猫线绕过树摇晃的月光

[00:00:18,400 –> 00:00:22,800] 暖气片哼着九八年排行

[00:00:24,160 –> 00:00:28,080] 时间拨开云雾般的热浪

[00:00:28,920 –> 00:00:33,000] 屏幕里的霓虹晒在鼻梁

[00:00:33,920 –> 00:00:35,600] 眼皮在摇晃

[00:00:35,800 –> 00:00:39,400] 玻璃窗画着整齐的音墙

[00:00:40,840 –> 00:00:45,080] 遥控器数羊数到第几趟

[00:00:46,960 –> 00:00:51,880] 弹幕游过发梢织成渔网

[00:00:52,080 –> 00:00:56,400] 捕捉着十二点不肯落的霜

[00:00:57,840 –> 00:01:02,800] 我们窝在年轮最柔软一墙

[00:01:03,600 –> 00:01:08,000] 呼吸被余温酿成蜂蜜糖

[00:01:09,360 –> 00:01:14,000] 沙发陷落成云絮的形状

[00:01:15,200 –> 00:01:32,400] 每个毛孔都晒着晴朗

[00:01:45,280 –> 00:01:49,240] 平板播放未完的远方

[00:01:51,080 –> 00:01:55,200] 字幕在瞳孔游出极光

[00:01:56,720 –> 00:02:00,480] 充电线圈成温顺的窝

[00:02:01,400 –> 00:02:05,800] 剧情在绒毛里慢慢结邦

[00:02:06,520 –> 00:02:08,040] 秒针在流放

[00:02:08,240 –> 00:02:12,000] 空调吐出棉花糖工厂

[00:02:13,320 –> 00:02:17,920] 睡衣印着褪色的风铃响

[00:02:19,560 –> 00:02:24,360] WiFi信号把星子点亮

[00:02:24,600 –> 00:02:29,200] 缓存整个冬天的童话几章

[00:02:30,400 –> 00:02:35,200] 我们窝在年轮最柔软一墙

[00:02:36,120 –> 00:02:40,680] 呼吸被余温酿成蜂蜜糖

[00:02:41,880 –> 00:02:46,600] 沙发陷落成云絮的形状

[00:02:47,720 –> 00:02:53,000] 每个毛孔都晒着晴朗

[00:02:54,240 –> 00:02:59,200] 冰箱的蝉声摇晃出波浪

[00:02:59,640 –> 00:03:04,600] 连咖啡也都长出嫩芽

[00:03:05,800 –> 00:03:10,400] 时光在毯纹里折叠翅膀

[00:03:10,720 –> 00:03:16,080] 冬昼的街灯在此刻融化

[00:03:16,720 –> 00:03:21,680] 我们窝在年轮最柔软一墙

[00:03:22,400 –> 00:03:27,000] 呼吸被余温酿成蜂蜜糖

[00:03:28,160 –> 00:03:33,200] 沙发陷落成云絮的形状

[00:03:34,000 –> 00:03:38,800] 每个毛孔都晒着晴朗

[00:04:09,000 –> 00:04:10,020](End)

#### 推荐使用方式[#](https://qwen.ai/blog?id=qwen3.5-omni#%E6%8E%A8%E8%8D%90%E4%BD%BF%E7%94%A8%E6%96%B9%E5%BC%8F-1)

| 配置 | 推荐音频时长 | 推荐使用 Prompt | 场景 |
| --- | --- | --- | --- |
| 低成本 | 60 分钟以下 | 50 个词以内的自定义 Prompt,视需求而定 | - 审核 |
| 简略 (精确度要求不高) | 60 分钟以下 | 50 个词以内的自定义 Prompt,视需求而定 | - 长音频分段 - 大致内容提取 |
| 均衡 (通用音频详细描述) | 2 分钟以下 | [固定的结构化描述 Prompt](https://qwen.ai/blog?id=qwen3.5-omni#structured-prompt-a) | - 细粒度音频描述打标 |
| 最佳 (生成最详细的描述) | 1 分钟以下 | [固定的结构化描述 Prompt](https://qwen.ai/blog?id=qwen3.5-omni#structured-prompt-a) | - 复杂声学场景 - 多说话人 |
| 注:如果更长的音频也想获得结构化的纯音频细粒度描述,建议分段打。 |  |  |  |

#### 固定的结构化描述 Prompt[#](https://qwen.ai/blog?id=qwen3.5-omni#%E5%9B%BA%E5%AE%9A%E7%9A%84%E7%BB%93%E6%9E%84%E5%8C%96%E6%8F%8F%E8%BF%B0-prompt-1)
Provide a detailed description of the audio.
It should explicitly include two sections:
- A structured chronological storyline of every noticeable audio details
- A structured speech-to-text transcription, include speaker(Corresponding to the character or voice‑over in Section 1, including their accent and tone), exact spoken content, start timestamp, end timestamp, and speaking state (prosody, emotion, and style). If no speech appears, explicitly state so.
Aside from these two required components, you are free to organize any additional content in any way you find helpful. This additional content can include global information about the entire audio or localized information about specific moments. You may choose the topic of this extra content freely.
Output Format:
## Storyline

<xx:xx.xxx> - <xx:xx.xxx>
<an unstructured long paragraph in natural language describing what happened during this period, blending both audio details.>

<xx:xx.xxx> - <xx:xx.xxx>
<an unstructured long paragraph in natural language describing what happened during this period, blending both audio details.>

<xx:xx.xxx> - <xx:xx.xxx>
<an unstructured long paragraph in natural language describing what happened during this period, blending both audio details.>

...

...

## Speakers and Transcript

Speaker profiles:
<speaker> - <profile>
<speaker> - <profile>
<speaker> - <profile>
...

<xx:xx.xxx> - <xx:xx.xxx>
Speaker: <speaker>
State: <description>
Content: “<content>”

<xx:xx.xxx> - <xx:xx.xxx>
Speaker: <speaker>
State: <description>
Content: “<content>”

<xx:xx.xxx> - <xx:xx.xxx>
Speaker: <speaker>
State: <description>
Content: “<content>”

...

<paragraphs>

<paragraphs>

...
## 开始使用 Qwen3.5-Omni[#](https://qwen.ai/blog?id=qwen3.5-omni#%E5%BC%80%E5%A7%8B%E4%BD%BF%E7%94%A8-qwen35-omni)

### 与 Qwen3.5-Omni 交互[#](https://qwen.ai/blog?id=qwen3.5-omni#%E4%B8%8E-qwen35-omni-%E4%BA%A4%E4%BA%92)

欢迎在 [Qwen Chat](https://chat.qwen.ai) 上使用 Qwen3.5-Omni。

### 阿里云百炼[#](https://qwen.ai/blog?id=qwen3.5-omni#%E9%98%BF%E9%87%8C%E4%BA%91%E7%99%BE%E7%82%BC)

用户也可以通过阿里云百炼调用我们的旗舰模型 Qwen3.5-Omni-Plus 进行体验。当前支持两种调用方式:**离线调用**和**实时调用**。

如需开启联网搜索能力,只需传入以下参数:

- `enable_search`:开启联网搜索

#### 离线调用[#](https://qwen.ai/blog?id=qwen3.5-omni#%E7%A6%BB%E7%BA%BF%E8%B0%83%E7%94%A8)

示例代码如下:
运行前的准备工作:
运行下列命令安装第三方依赖
pip install numpy soundfile openai
import os import base64 import soundfile as sf import numpy as np from openai import OpenAI
client = OpenAI( # 若没有配置环境变量,请用阿里云百炼API Key将下行替换为:api_key="sk-xxx", # 新加坡和北京地域的API Key不同。获取API Key:https://help.aliyun.com/zh/model-studio/get-api-key api_key=os.getenv("DASHSCOPE_API_KEY"), # 以下是北京地域base_url,如果使用新加坡地域的模型,需要将base_url替换为:https://dashscope-intl.aliyuncs.com/compatible-mode/v1 base_url="https://dashscope.aliyuncs.com/compatible-mode/v1", )
音视频分析
completion = client.chat.completions.create( model="qwen3.5-omni-plus", messages=[ { "role": "user", "content": [ { "type": "video_url", "video_url": { "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241115/cqqkru/1.mp4" }, }, {"type": "text", "text": "视频的内容是什么?"}, ], }, ], # 设置输出数据的模态,音视频分析场景下,建议直接返回文本结果 modalities=["text"], # stream 必须设置为 True,否则会报错 stream=True, stream_options={"include_usage": True}, )
print("模型回复:") for chunk in completion: # 处理文本部分 if chunk.choices and chunk.choices[0].delta.content: print(chunk.choices[0].delta.content, end="")
联网搜索
try: completion = client.chat.completions.create( model="qwen3.5-omni-plus", messages=[{ "role": "user", "content": "请查询今天的日期和星期,并告诉我今天有哪些重要节日" }], stream=True, stream_options={"include_usage": True}, # 开启联网搜索 extra_body={ "enable_search": True, "search_options": { # 联网搜索策略,仅支持配置为 agent "search_strategy": "agent" } } )
print("\n\n\n\n联网搜索模型回复(包含实时信息):")
for chunk in completion:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
print()
except Exception as e: print(f"请求失败: {e}")
#### 实时调用[#](https://qwen.ai/blog?id=qwen3.5-omni#%E5%AE%9E%E6%97%B6%E8%B0%83%E7%94%A8)

示例代码如下:
依赖:dashscope >= 1.23.9,pyaudio
import os import base64 import time import pyaudio from dashscope.audio.qwen_omni import MultiModality, AudioFormat,OmniRealtimeCallback,OmniRealtimeConversation import dashscope
配置参数:地址、API Key、音色、模型、模型角色
指定地域,设为cn表示中国内地(北京),设为intl表示国际(新加坡)
region = 'cn' base_domain = 'dashscope.aliyuncs.com' if region == 'cn' else 'dashscope-intl.aliyuncs.com' url = f'wss://{base_domain}/api-ws/v1/realtime'
配置 API Key,若没有设置环境变量,请用 API Key 将下行替换为 dashscope.api_key = "sk-xxx"
dashscope.api_key = os.getenv('DASHSCOPE_API_KEY')
指定音色
voice = 'Tina'
指定模型
model = 'qwen3.5-omni-plus-realtime'
指定模型角色
instructions = "你是个人助理小云,请用幽默风趣的方式回答用户的问题" class SimpleCallback(OmniRealtimeCallback): def init(self, pya): self.pya = pya self.out = None def on_open(self): # 初始化音频输出流 self.out = self.pya.open( format=pyaudio.paInt16, channels=1, rate=24000, output=True ) def on_event(self, response): if response['type'] == 'response.audio.delta': # 播放音频 self.out.write(base64.b64decode(response['delta'])) elif response['type'] == 'conversation.item.input_audio_transcription.completed': # 打印转录文本 print(f"[User] {response['transcript']}") elif response['type'] == 'response.audio_transcript.done': # 打印助手回复文本 print(f"[LLM] {response['transcript']}")
1. 初始化音频设备
pya = pyaudio.PyAudio()
2. 创建回调函数和会话
callback = SimpleCallback(pya) conv = OmniRealtimeConversation(model=model, callback=callback, url=url)
3. 建立连接并配置会话
conv.connect() conv.update_session(output_modalities=[MultiModality.AUDIO, MultiModality.TEXT], voice=voice, instructions=instructions, enable_search=True)
4. 初始化音频输入流
mic = pya.open(format=pyaudio.paInt16, channels=1, rate=16000, input=True)
5. 主循环处理音频输入
print("对话已开始,对着麦克风说话 (Ctrl+C 退出)...") try: while True: audio_data = mic.read(3200, exception_on_overflow=False) conv.append_audio(base64.b64encode(audio_data).decode()) time.sleep(0.01) except KeyboardInterrupt: # 清理资源 conv.close() mic.close() callback.out.close() pya.terminate() print("\n对话结束")
### Qwen3.5-Omni 音色列表[#](https://qwen.ai/blog?id=qwen3.5-omni#qwen35-omni-%E9%9F%B3%E8%89%B2%E5%88%97%E8%A1%A8)

中英主音色(5个发音人)

| 音色 | 语种 | 音色描述 | 合成文本 | 合成样例 |
| --- | --- | --- | --- | --- |
| 甜甜 Tina | 中文 | 我的声音像温热的奶茶,甜甜的、暖暖的,但解决问题可一点都不含糊哦! | 阳光晒得被子软软的,手边的茶还冒着热气,待办事项也一件件完成了。没有惊天动地,但每一件小事都稳稳当当,这样的日子,真的让人觉得,幸福就在此刻呀!接下来,我们一起把下一件小事也好好完成吧~ |  |
| 林欣宜 Cindy | 中文-台湾口音 | 台湾说话嗲嗲的小姐姐 | 对~因为我其实从小到大,嗯,没有太怎么去吃过这种类型的东西啊。真的,因为我小的时候,我跟你讲,我小时候其实是有养过小兔子。 |  |
| 清欢 Liora Mira | 中文 | 用声音织就烟火人间的温柔 | 对对,我第二次去的话,老师跟我说,欸,你进步很大啊,哈哈,所以我就觉得而且他说的我基本上我发现我配音中的气息也变强了。 |  |
| 知芝 Sunnybobi | 中文 | 大大咧咧的社恐邻家姑娘 | 我好像很少,就是除非说,这个地方我很想去,但是,一个人又不太方便的时候我会叫朋友。但大部分我都还是愿意自己一个人逛的,嗯,嗯毕竟比较i,对,哼哼。 |  |
| 林川野 Raymond | 中文 | 声音清亮,爱吃外卖的宅男 | 嗯,可以,纽约堡是吗?它是不是那种就是偏美式一点那种汉堡呀,啊。 |  |

中英场景音色 (19 个发音人)

| 应用场景 | 音色 | 语种 | 音色描述 | 合成文本 | 合成样例 |
| --- | --- | --- | --- | --- | --- |
| 情感陪伴-治愈温暖 | 晨煦 Ethan | 中文 | 标准普通话,带部分北方口音。阳光 温暖 活力 朝气 | 那应该是我现在吧,我觉得现在就非常幸福。 |  |
| 予安 Theo Calm | 中文 | 在静默处传递理解,在言语间疗愈人心。 | 呵,太好了。阳光升起的时候呀,葡萄会充满生机,我觉得你也会一样。你要记住啊,每个清晨都是新的开始,保持这份宁静的心,我呢会一直在这里,随时支持你。 |  |  |
| 苏瑶 Serena | 中文 | 温柔小姐姐 | 其实我真的有发现,我是一个特别善于观察别人情绪的人。 |  |  |
| 厚 Harvey | 英语 | 我的声音来自岁月沉淀——低沉、温和,带着一点咖啡与旧书的气息。 | Then by the end of the movie, when Dorothy clicks her heels and says, “There’s no place like home,” I got a little bit teary, I’ll admit. You know, I don’t even know why—I just, I just felt. |  |  |
| 四月 Maia | 中文 | 知性与温柔的碰撞 | 我呵,你怎么知道我挺会背诗的?你是不是对我有一些了解?我高中语文也不是特别好吧,大概也就是全年级前十吧。 |  |  |
| 情感陪伴-活力个性 | 江晨 Evan | 中文 | 男大学生,年下奶狗 | 哈喽,我是阿晨,姐姐今天累不累呀?有没有好好吃饭?哪怕只吃了一小口,也请对自己说一句辛苦了。生活常让你怀疑自己,但我想轻轻告诉你,那些你走过的路,扛下的事,都在证明你比想象中更强大。 |  |
| 小乔妹 Qiao | 中文-台湾口音 | 超关键!她不是普通可爱,而是表面甜妹,个性十足 | 什么嘛,你男朋友回来关我什么事啊?我的周末就不是周末,要不要我的约会也跟你换啊?哎,我告诉你,我这周末要去参加我阿妈的生日聚餐,这可是半年前就约好的。 |  |  |
| 茉兔 Momo | 中文 | 撒娇搞怪,逗你开心 | 我命令你们这些小男生,晚上早一点睡觉,听到没有。 |  |  |
| 伟伦 Wil | 中文 | 在深圳长大的港台腔小哥哥 | 对啊对啊,呃我们是骑那个就是,比较少人走的一条捷径路哦,哎就是那种小,有点像小巷子那种路。 |  |  |
| 台普-安琪 Angel | 中文 | 略带台式口音,她超甜的哦! | 屋顶很漂亮,所以在欧洲的话一定要抬头,不可以一直看手机,要抬头看屋顶,呃,上面有很多画,可是要注意小偷。可是我这整个过程中其实都呃没有遇到有人要偷我东西,当然我身上也没有钱,他没有东西可以偷。 |  |  |
| 角色扮演 | 东厂-李公公 Li Cassian | 中文 | 话中三分留白、七分察言观色 | 哎呦喂,你们这帮小崽子一天天的没别的事儿干,就是喜欢下棋。正好儿啊,杂家今儿个高兴儿,跟你们呀就说道说道这棋该怎么下。 |  |
| 温柔生活博主-舒然 Mia | 英语 | 以细腻声音,传递慢生活美学与日常治愈力量的生活艺术家 | Hey, friends, welcome back. I hope you're doing well today and that wherever you're watching from. You're feeling a little warm, a little calm. Maybe even holding your favorite drink. You know, something soft to settle into the day with. |  |  |
| 喜剧担当-阿逗 Joyner | 英语 | 搞笑、夸张、接地气 | Ah, come on, Frankie. That guy? Nah, he's probably just what, fainted from boredom or something. Watching that press go up and down all night. It's like what, watching paint dry, but you know, louder. Bet he saw his life flash before his eyes, right? |  |  |
| 金爷 Gold | 英语 | 西海岸黑人Rapper | This shit don’t make no sense, dawg. I’ve been tryna tell everybody that this whole AI shit — yo, they taking over the game. Soon enough, we go be dating robots. |  |  |
| 游戏动漫配音 | 卡捷琳娜 Katerina | 英语 | 御姐音色,韵律回味十足 | Hello, how are you today? I'm doing great. |  |
| 甜茶 Ryan | 英语 | 节奏拉满,戏感炸裂,真实与张力共舞 | You bet. Old misses Perkins down the lane makes Jasmine honey cakes. That'll make your toast curl with delight. Kids sneak blossoms into lemonade stands, 10 petals per cup for extra magic, they'll tell you, with grass stained grins. |  |  |
| 詹妮弗 Jennifer | 英语 | 品牌级、电影质感般美语女声 | Hi, my name is Jennifer. I've lived in China for like six years. Do I like China? Yeah, love to have hot pot, super love spicy food. What else? Oh I've been learning Chinese for a long time, was it hard to learn? Absolutely, probably the hardest thing that I've ever had to do, but little time, patience. What about you? Or are you finding learning Chinese good? |  |  |
| 艾登 Aiden | 英语 | 精通厨艺的美语大男孩 | When I have to work late into the night, the thing that really keeps me awake is definitely coffee like I'll get a coffee at around three pm something like that and that'll keep me pretty hyped up for most of the night if I have to work like extra late then yeah I'll do something like another coffee maybe um I don't know like with my dinner after dinner yeah after dinner coffee. |  |  |
| 敏儿 Mione | 英语 | 成熟,知性英国邻家妹妹 | So yeah, that’s my favorite hobby — I could probably go on for even longer, but, um, that’s my favorite hobby collecting Sunny Angels. There are so many more, to collect, and I can’t wait to build my collection, and, continue, persevering with this hobby. And, yeah, I really like collecting Sunny Angels. |  |  |

中文方言特色音色(8个发音人)

| 音色 | 语种 | 音色描述 | 合成文本 | 合成样例 |
| --- | --- | --- | --- | --- |
| 四川-晴儿 Sunny | 四川话 | 甜到你心里的川妹子 | 胖娃儿胖嘟嘟,骑马上成都,成都有好耍,胖娃儿骑白马,白马跳得高,胖娃儿耍关刀,关刀耍得远,胖娃儿吃汤圆。 |  |
| 北京-晓东 Dylan | 北京话 | 北京胡同里长大的少年 | 我们家那边后面有一个后山,就护城河那边儿。完了呢我们就在山上啊,就是其实也没什么,就是在土坡上跑来跑去,然后谁捡个那个嗯比较威风的棍儿,完了我们就就瞎打,呃要不就是什么掏个洞啊什么的。 |  |
| 四川-程川 Eric | 四川话 | 一个跳脱市井的四川成都男子 | 你龟儿子搞啥子名堂嘛,把事情弄成这个样子老子要被你气死了,我看到你这个样子我心头都冒火,毛焦火辣的气都不打一处来,你龟儿太过分了,把我的东西都搞坏了,还晓不晓得认错,硬是要把我整冒火你才安逸唆,莫再烦老子爬球开。 |  |
| 天津-李彼得 Peter | 天津话 | 天津相声,专业捧人 | 越线了啊,你心中纵有万千苦,不能往我们心窝儿杵,咱不朋友嘛。算了,把我这嘴皮子磨烂也给你们讲不明白。蝎了虎子掉面缸,听完你们光剩眨么眼儿了。我再说最后一次啊,我介不是走,是绝交,啊。他说我是小肚子拉口儿二波一,木鱼儿改梆子挨敲的货,面茶里煮元宵,混蛋沉底带砸锅。哼,从今儿起,咱就是天津大麻花啊,彻底掰了。 |  |
| 阿樸伯 Joseph Chen | 闽南话 | 我是 阿樸伯,本名陳志樸,南洋老華僑。 | 爱伫黄内底佫带小可青青,皮若是黄黄小可青青,表示会当买转去的,佫囥两三工来食拄仔好。 |  |
| 陕西-秦川 Marcus | 陕西话 | 面宽话短,心实声沉——老陕的味道。 | 诶,伙计,你说这人活成嘛了,一天到黑忙得跟钟楼底下的车一样,堵得心慌。诶,老板催报表吗?孙娃作业要签字吗?屋里老嫂子还嫌我不陪她逛骡马市。 |  |
| 南京-老李 Li | 南京话 | 骂骂咧咧的伯伯 | 哎!老头儿!让一下诶!没得长眼睛啊。你哪个?老十三的在这个叫魂啊!急着给投胎去呀。xxx这么叼宽的巷子你过不去啊我过你个吊啊你麻痹你把这马扎子摆到路中间这个巷子是你家开的呀 |  |
| 粤语-阿强 Rocky | 广东话 | 幽默风趣的阿强,在线陪聊 | 其实真系咁噶呵,即系人咧~即系我觉得系,即系都几贱格嘅动物嚟噶呵,即系冇嘢做嗰阵时咧。就话~唉死啦我成日都冇嘢做,咁边有钱啊咁。有嘢做嗰阵时咧又成日觉得,死啦啲嘢成日都做唔晒,喂大佬,好攰啊,点办啊? |  |

多语言音色(23个发音人)

| 音色 | 语种 | 音色描述 | 合成文本 | 合成样例 |
| --- | --- | --- | --- | --- |
| 素熙 Sohee | 韩语 | 温柔开朗,情绪丰富的韩国欧尼 | 친구들이 나한테 좀 그러더라, 선물에 내 성격이 좀 담겨 있대 그래서 차분하고 조용한 선물을 고르는 스타일이긴 한데 그게 내가 그 사람을 좀 진짜로 생각하고 있다는 방식이라서 내가 표현하는 방식 중의 하나인 것 같아. 결론은 이제 평소에 말해 줬던 작은 힌트를 기억을 해서 그 사람의 하루에 좀 스며들 수 있는 그런 선물. 그걸은 내가 가장 많이 고르는 스타일이지. |  |
| 莱恩 Lenn | 德语 | 理性是底色,叛逆藏在细节里——穿西装也听后朋克的德国青年。 | Das ist eine nette Überraschung! |  |
| 小野杏 Ono Anna | 日语 | 鬼灵精怪的青梅竹马 | おかしいな、内部でガチャガチャ音がしてる。あっ、もしかして救急トレイにA3とA4が混ざってる?あー、誰かが両面スキャナーの保護シートを剥がし忘れてます。これじゃ確認できないのも当然です。 |  |
| 索尼莎 Sonrisa | 西班牙语 | 热情开朗的拉美大姐 | Claro que sí, imagínate sentado en esas sillas verdes tan bonitas con un café recién hecho que huele a canela. Hasta los libros viejos de la estantería parecen sonreír cuando alguien los hojea y el tocadiscos está poniendo un vals que te hará mover los pies sin darte cuenta. Es como viajar en el tiempo pero con buen humor. |  |
| 博德加 Bodega | 西班牙语 | 热情的西班牙大叔 | Claro que sí, imagina caminar sobre esa alfombra de hojas doradas crujiente bajo tus pies mientras el olor a canela de la panadería te guía hacia las mesitas con mantel a cuadros hasta el viento parece tararear la melodía de la guitarra. |  |
| 埃米尔安 Emilien | 法语 | 浪漫的法国大哥哥 | Bien sûr, passons à des questions plus générales : pour toi, quelle était l'opportunité qui t'a conduit à t'impliquer dans l'industrie du doublage ? |  |
| 安德雷 Andre | 葡萄牙语 | 声音磁性,自然舒服、沉稳男生 | Ouvimos fazer compras no mercado local sim às vezes vou ao mercado local às vezes vou a supermercados maiores depende da compra que eu fazer depende onde estou às vezes quando viajo gosto de ir a mercados locais quer para ver que as pessoas dessa zona comem o que é que comem o que é que compram o que é que produzem não é que tipo de legumes que tipo de frutas aí vou aos mercados locais e normalmente no mercado local acho que a comida costuma ser mais saudável do que num supermercado. |  |
| 拉迪奥·戈尔 Radio Gol | 葡萄牙语 | 足球诗人Rádio Gol!今天我要用名字为你们解说足球。 | Ei você sentiu aquele cheiro de pão fresco parece que vem da padaria da esquina né? Tô com vontade de dar uma passada lá. |  |
| 阿列克 Alek | 俄语 | 一开口,是战斗民族的冷,也是毛呢大衣下的暖 | Конечно, знаешь, эти ржавые ворота как старый актер, который готов рассказать тысячу веселых историй. Вот например: раньше здесь кузнецы соревновались кто громче молотом стукнет, а детишки за орешками бегали, даже осенние листья тогда танцевали под музыку кузнечных мехов. |  |
| 阿力 Rizky | 印尼语 | 印尼的青年小伙,声线个性 | Nah. Waktu itu tuh ada teman yang ngedengar cara aku bacain iklan di radio, terus dia bilang eh suara lu kayaknya cocok banget deh buat jadi voice over talent. Mau nyoba enggak? Gitu. |  |
| 萝雅 Roya | 波斯语 | 热爱运动的女孩,拥有一颗自由的心。 | وَقْتی اَز دوچَرْخِهٔ ثابِت اِسْتِفادِه میکُنی، خِیلی فِشار رو رویِ مَفاصِلِت اِحْساس نِمیکُنی.فِشار کَمتَرِه، مَخْصوصاً بَرایِ کِسایی کِه زانو دَرْد دارَنْ یا تازِه میخوان وَرْزِش رو شُروع کُنَنْ |  |
| 阿尔达 Arda | 土耳其语 | 不高亢,也不低沉,干净利落中带着温润的气质 | Yeni bir bilgi öğrenirken araştırma mı yoksa deneyerek keşfetme mi dersek, aslında ben ikisinin karışımını seviyorum. Bir konuyu temel olarak araştırıp zemin oluşturduktan sonra mutlaka deneyerek öğrenmeyi tercih ediyorum. Çünkü sadece teorik bilgi insanın kafasında soyut kalıyor. Deneyince bilginin kıvrımlarını keşferiyorsun. |  |
| 阿幸 Hana | 越南语 | 爱狗狗的越南成熟姐姐 | Ừm, nếu hỏi tấm hình nào trong điện thoại gần đây nhất mà buồn cười nhất á thì chắc là tấm chụp con chó nhà mình, trời ơi, nó làm mình không nhịn được luôn ấy. |  |
| 多尔切 Dolce | 意大利语 | 慵懒的意大利大叔 | Ma dìgli altri cinque minuti, per favore dai sono ancora così assonnato. |  |
| 雅克 Jakub | 波兰语 | 波兰小镇文艺青年,声线磁性性感 | No wiesz, chodziło mi o ten most. O świcie jak mgła nad rzeką jeszcze jest, a kamienie po deszczu tak błyszczą. Stary Janek z piekarni mówił, że o tej porze wygląda jak z bajki. I chleb prosto z pieca pachnie najmocniej. |  |
| 海娜 Griet | 荷兰语 | 荷兰成熟又文艺的女性 | van alleen op straat zijn. En heel veel weiden rondom U, alles is rustig, alles is stil. En de dag lijkt zo eindeloos lang te duren of zo. Snap je, dat zo? |  |
| 艾莉卡 Eliška | 捷克语 | 每个单词都传递中欧的匠心与温度 | Emm... No, emm... já mám ráda černobílé fotky, protože tam není rušivá barva, jen čistý výraz, světlo a stín. A připadá mi to víc opravdový. |  |
| 玛丽娜 Marina | 希伯来语 | 一个在多元文化城市中长大的女孩。 | גדלתי במקום שיש בו המון המון תרבויות שונות, והמון שפות שונות. אז אתה לומד איך לתקשר עם אנשים בתרבות אחרת בצורה מאוד ברורה, די מהר. ואז כשעברתי לגור בקנדה, אז בכלל, בוונקובר יש פה כל כך הרבה תרבויות שונות. |  |
| 西芮 Siiri | 芬兰语 | 内敛温柔,语速舒缓如湖面微澜 | Se oli kokemuksena muutenkin se reissu jotenkin tosi semmonen emme ties silmiä avaava koska se on ympäristönä jotenkin niin erilainen kuitenkin Suomeen verrattuna että kun siellä on kuitenkin hiekkarantoja ja sitten jotenkin siellä oli niin semmonen rento meiininki ja sellaista juhlahumua ja sellaista erilaista emmä oo kai osaa selittää sitä kunnolla mutta se oli jotenkin niin toisenlainen maailma ja mä päätti jo silloin että mä joo jossain kohtaa muuttaa pois Suomesta että mun pitää päästä tällaiseen ympäristöön ja kyllä mä silloin tiesi jo heti että |  |
| 林恩 Ingrid | 挪威语 | 挪威乡村姑娘 | Og så bestemte jeg meg at nå er det på tide, nå må jeg bare prøve om jeg kan klare å få passe på høner, og noe som jeg hadde drømt om da, ikke sant? At du kan gå og plukke egg om morgenen. |  |
| 海娜 Sigga | 冰岛语 | 冰岛小镇的知性女青年 | Ef við getum orðað það þannig þannig menntaskóla árin eru vissulega mjög eftirminnileg og það sem gerðist líka í menntaskóla er að ég kynntist alveg dásamlegum vinkonum sem eru vinkonur mínar ennþá í dag og við erum tíu saman sem erum í svona sumar klúbbi og kynntust í menntaskóla og við höldum alltaf sambandi og höfum gert alveg síðan. Við bara byrjuðum að verða vinkonur í byrjun menntaskólans. |  |
| 雅娜 Bea | 菲律宾 | 爱喝咖啡的菲律宾甜甜小姐姐 | I'm ready! May kapi na ako,may tissue na rin in case matawa ako or maiyak.Go,go,go! Spill! |  |
| 思怡 Chloe | 马来语 | 马来西亚白领女生 | Lagi satu, aku cuba kenal bila waktu aku paling cergas. Bagi aku, jadi waktu tu aku kerahkan tenaga buat kerja paling susah. |  |

## 引用[#](https://qwen.ai/blog?id=qwen3.5-omni#%E5%BC%95%E7%94%A8)

如果 Qwen3.5-Omni 对你有所帮助,欢迎引用以下文章:
@misc{qwen35omniblog, title = {Qwen3.5-Omni: Scaling Up, Toward Native Omni-Modal AGI}, url = {https://qwen.ai/blog?id=qwen3.5-omni}, author = {Qwen Team}, month = {March}, year = {2026} }