Artificial Analysis 推出 VIALS-AA 视觉推理榜单,Gemini 4 领先
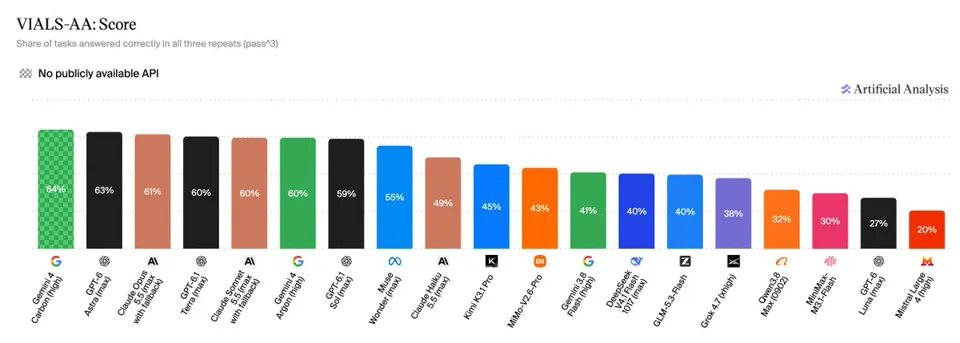
Artificial Analysis 基于 Handshake AI 的 VIALS 基准推出 VIALS-AA 榜单,用 161 项生命科学与生物技术视觉推理任务评测前沿模型。Gemini 4 Carbon 以 64% 的 pass^3 成绩微弱领先,GPT-6 Astra 与 Claude Opus 5.5 分别以 63% 和 61% 紧随其后,前三名仅差 3 分。评测还发现模型在部分任务上出现拒答,说明科学图像解读仍是前沿模型的明显短板。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-11-06 17
我们正式推出 VIALS-AA,这是 Handshake AI 的 VIALS 基准的排行榜,该基准用于评估生命科学与生物技术研究中的视觉推理能力
视觉产物是科学家分析实验并做出研究决策的核心依据,但正确解读这些产物对前沿模型而言仍是一项挑战。VIALS 的 161 项任务横跨八个领域,要求模型对凝胶印迹、流式细胞术图、质粒图谱和系统发育树等视觉产物进行推理。每项任务都要求模型解读一种视觉产物,并得出特定的科学结论。
我们通过在 Stirrup(我们的开源智能体运行框架)中为每项任务运行三次来评估模型,并配备代码执行和图像检查工具。GPT-6 Luna (medium) 将每个答案与参考答案进行评分,我们报告在三次重复中均被判定为正确的任务占比(pass^3)。
关键要点:
➤ 排名前三的模型仅相差 3 个百分点:来自 @GoogleDeepMind 的 Gemini 4 Carbon (high) 以 64% 的得分略微领先,紧随其后的是来自 @OpenAI 的 GPT-6 Astra (max),得分为 63%,以及来自 @AnthropicAI 的 Claude Opus 5.5 (max with fallback),得分为 61%
➤ Astra 和 Sol 在每任务成本远低于 Opus 和 Sonnet 的情况下,取得了与它们相近的得分:Claude Opus 5.5 (max with fallback) 平均每任务成本为 $1.64,约为 Sol(约 $0.056)的 29 倍。这一价格差异在很大程度上由轮次使用量驱动——GPT-6 Astra (max) 和 GPT-6.1 Sol (max) 平均每任务约 8 轮,而 Claude Opus 5.5 (max with fallback) 约为 27 轮,Claude Sonnet 5.5 (max with fallback) 约为 25 轮
➤ 开放权重模型落后最高分约 19 个百分点:Kimi K3.1 Pro 以 45% 的得分在 VIALS-AA 上领跑开放权重模型,略微领先于 MiMo-V2.6-Pro 的 43%
➤ 161 项任务中有 14 项在至少一个模型上出现了安全拒答:Claude Sonnet 5.5 (max with fallback) 在 6 项任务上拒答,为所有模型中最多的,且 14 项受影响任务中有一半出现了多个模型的拒答
感谢 @joinHandshakeAI 和 VIALS 的作者们创建了该基准,并与我们合作将其引入 Artificial Analysis!