LangChain Blog · 2026/10/14 00:11:23
LangChain 评测显示 GLM-5 与 MiniMax M2.7 在智能体核心任务上追平闭源前沿模型
LangChain 通过 Deep Agents 框架对开源权重大模型进行基准测试,结果显示 GLM-5 和 MiniMax M2.7 在文件操作、工具调用及指令遵循等核心智能体任务上的表现已接近甚至匹敌闭源前沿模型。这一突破意味着开发者可以在显著降低推理成本和延迟的前提下,将高性能开源模型作为闭源模型的替代或补充方案投入生产环境。
报道全文原始报道全文
本文目录12 个章节
核心要点
TL;DR: GLM-5 和 MiniMax M2.7 等开源模型在文件操作、工具调用和指令遵循等核心 Agent 任务上,已能媲美闭源前沿模型,且成本和延迟大幅降低。以下是我们的评估结果,以及如何在 Deep Agents 中开始使用这些模型。
过去几周,我们一直在通过 Deep Agents 框架对开源权重大语言模型(LLM)进行评估,初步结果表明,它们可以作为闭源前沿模型的替代方案或补充方案。GLM-5 (z.ai) 和 MiniMax M2.7 在文件操作、工具调用和指令遵循等核心 Agent 任务上的得分与闭源前沿模型相当。
如果你一直通过 SWE-Rebench 和 Terminal Bench 2.0 等大量公开基准测试关注开源模型的进展,这一结果并不令人意外。其工具调用可靠,指令遵循一致。对于在生产环境中部署 Agent 的开发者而言,开源模型现在提供的一致性和可预测性水平,使得真实世界的工作流程更加可行。
为什么选择开源模型
在探索开源模型时,开发者和客户通常关注几个关键因素:成本、延迟和任务性能。
理想情况下,我们希望为每项任务都使用推理能力最强的前沿模型。但在实践中,两个约束使这变得不可行:成本和延迟。在高吞吐量工作负载下,闭源前沿模型的成本可能高出 8–10 倍,而且对于用户期望的交互式产品响应时间来说,它们往往太慢。
| 模型 | 类型 | 输入 ($/百万 tokens) | 输出 ($/百万 tokens) |
|---|---|---|---|
| Claude Opus 4.6 (Anthropic) | 闭源 | $5.00 | $25.00 |
| Claude Sonnet 4.6 (Anthropic) | 闭源 | $3.00 | $15.00 |
| GPT-5.4 (OpenAI) | 闭源 | $2.50 | $15.00 |
| GLM-5 (Baseten) | 开源 | $0.95 | $3.15 |
| MiniMax M2.7 (OpenRouter) | 开源 | $0.30 | $1.20 |
为了更直观地理解定价差异:一个每天输出 1000 万 tokens 的应用程序,在 Opus 4.6 上的成本约为每天 12。这意味着每年约有 $87,000 的成本差异。
开源模型通常比闭源前沿模型更小,并且可以在专用推理基础设施上加速运行——像 Groq、Fireworks 和 Baseten 这样的提供商在延迟和吞吐量方面的优化远超大多数团队自行实现的能力。OpenRouter 数据显示,GLM-5 在 Baseten 上的平均延迟为 0.65 秒,吞吐量为每秒 70 个 token,而 Claude Opus 4.6 的对应数据分别为 2.56 秒和每秒 34 个 token。对于对延迟敏感的产品而言,这一差距很难通过工程手段弥补。
我们如何评估
我们在 How we build evals for Deep Agents 一文中深入介绍了我们的评估方法论。我们使用托管推理服务提供商来运行评估,但 Deep Agents 也可以通过 Ollama、vLLM 等工具完全在本地私有模型上运行。
对于开源模型,我们运行了七个评估类别:文件操作、工具使用、检索、对话、记忆、摘要以及“单元测试”。这些类别涵盖了检验基础能力的任务:模型能否可靠地调用工具、遵循结构化指令并操作文件?这些能力决定了模型是否能够在智能体框架中实际可用。
每个评估用例都定义了成功断言(用于确定正确性的硬性失败检查)和效率断言(用于衡量模型达成结果方式的软性检查)。我们报告四项指标:
- 正确性(Correctness) — 模型通过的测试比例:
passed / total。得分为 0.68 意味着 68% 的测试用例被正确解决。这是主要的质量信号。 - 解决率(Solve rate) — 准确率和速度的综合衡量指标。对于每个测试,我们计算
expected_steps / wall_clock_seconds;失败的测试贡献值为零。最终得分是所有测试的平均值。数值越高越好——既正确又快速完成任务的模型得分最高。 - 步数比率(Step ratio) — 在所有测试中聚合计算的、模型实际执行的智能体步骤数与预期步骤数的比值:
total_actual_steps / total_expected_steps。值为 1.0 表示模型使用了恰好预期的步骤数。高于 1.0 表示需要更多步骤(效率较低);低于 1.0 表示比最初预期的步骤更少。 - 工具调用比率(Tool call ratio) — 与步数比率概念相同,但统计的是单个工具调用次数而非步骤数。1.0 表示在预算内,高于 1.0 表示超出预算,低于 1.0 表示未用完预算。
步数比率和工具调用比率是效率指标。它们不影响测试是否通过,但揭示了模型以何种经济的方式得出答案。如果一个模型用 2 步而不是预期的 5 步解决了任务,那么它既正确又高效。
评估结果发现
这些是初步结果;我们正在积极维护并扩展我们的评估集。你可以在 我们的 GitHub 仓库 和 这个共享的 LangSmith 项目 中实时查看最近的运行情况。
开源模型
查看 CI 运行记录 (点击模型名称可查看单独的评估结果)
| Model | Correctness | Passed | Solve Rate | Step Ratio | Tool Call Ratio |
|---|---|---|---|---|---|
| baseten/GLM-5 | 0.64 | 94 of 138 | 1.17 | 1.02 | 1.06 |
| ollama.7 | 0.57 | 85 of 138 | 0.27 | 1.02 | 1.04 |
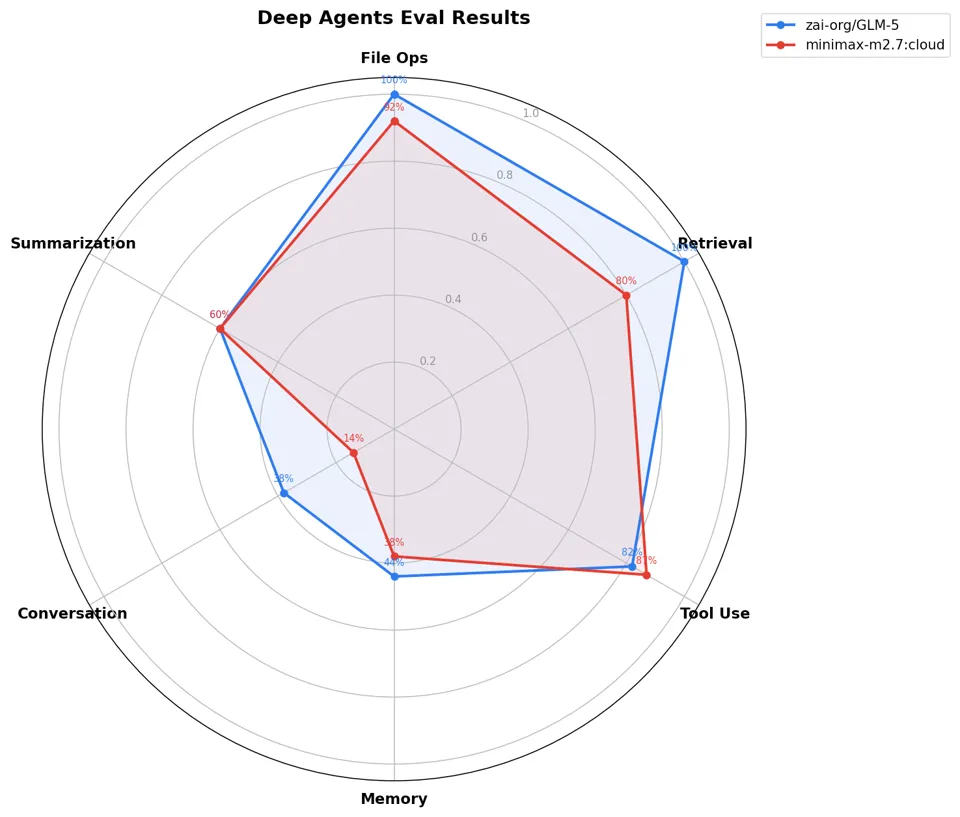
按类别划分的正确性:
| Model | Conversation | File Ops | Memory | Retrieval | Summarization | Tool Use | Unit Test |
|---|---|---|---|---|---|---|---|
| baseten/GLM-5 | 0.38 | 1 | 0.44 | 1 | 0.6 | 0.82 | 1 |
| ollama.7 | 0.14 | 0.92 | 0.38 | 0.8 | 0.6 | 0.87 | 0.92 |
前沿模型
查看 CI 运行记录(点击模型名称可查看单项评估结果)
| Model | Correctness | Passed | Solve Rate | Step Ratio | Tool Call Ratio |
|---|---|---|---|---|---|
| anthropic | 0.68 | 100 of 138 | 0.38 | 0.99 | 1.02 |
| google_genai.1-pro-preview | 0.65 | 96 of 138 | 0.26 | 0.99 | 1.01 |
| openai.4 | 0.61 | 91 of 138 | 0.61 | 1.05 | 1.15 |
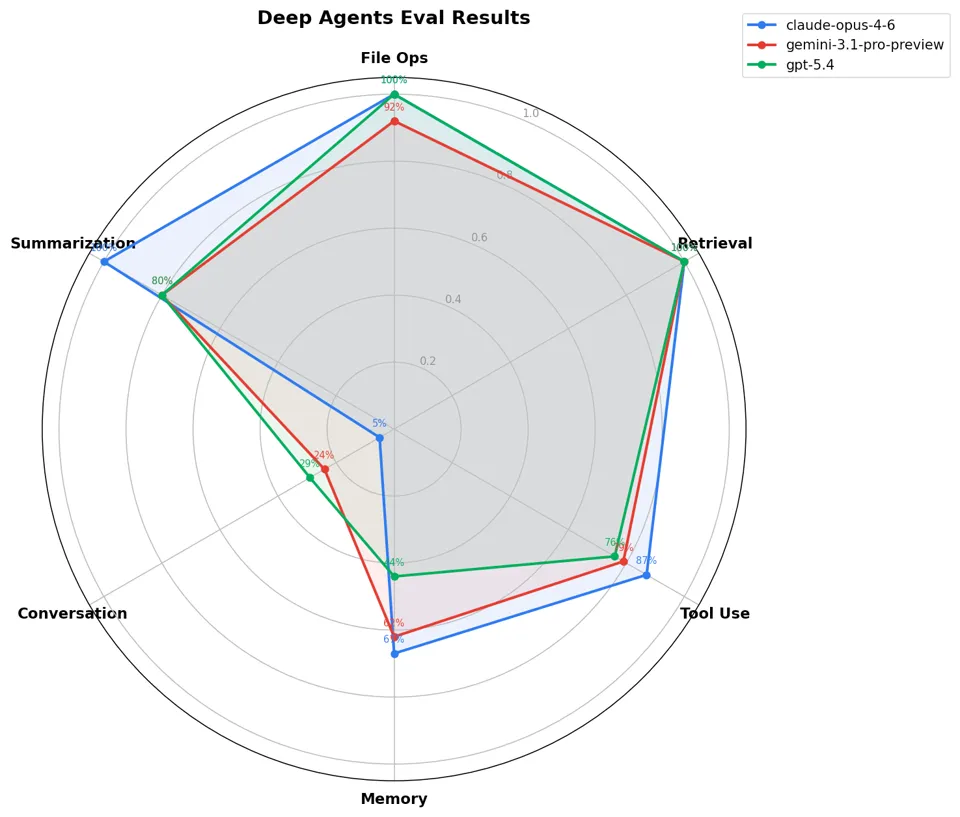
各分类正确率:
| Model | Conversation | File Ops | Memory | Retrieval | Summarization | Tool Use | Unit Test |
|---|---|---|---|---|---|---|---|
| anthropic | 0.05 | 1 | 0.67 | 1 | 1 | 0.87 | 1 |
| google_genai.1-pro-preview | 0.24 | 0.92 | 0.62 | 1 | 0.8 | 0.79 | 0.92 |
| openai.4 | 0.29 | 1 | 0.44 | 1 | 0.8 | 0.76 | 1 |
对于每个模型,我们采用提供商默认的 thinking level。对于 Gemini 3+,默认为 high对于 OpenAI,默认为 medium对于 Claude,默认不启用 extended thinking
DIY:在本地运行 Deep Agent 评估
我们的 CI 会在划分为多个组的 52 个模型上运行相同的评估套件——其中包括一个 open 组(包含 baseten:zai-org/GLM-5、ollama:minimax-m2.7:cloud、ollama:nemotron-3-super),该组会在每次评估工作流中运行。你可以指定任意模型组:
# Run evals against all open models
pytest tests/evals --model-group open

# Run against a specific model
pytest tests/evals --model baseten:zai-org/GLM-5
这使得在相同任务上使用相同评分标准,将开源模型彼此之间以及与闭源前沿模型进行对比变得非常直观。
在 Deep Agents SDK 中使用开源模型
切换到开源模型只需修改一行代码:
GLM-5:
# pip install langchain-baseten
from deepagents import create_deep_agent

agent = create_deep_agent(model="baseten:zai-org/GLM-5")
MiniMax M2.7:
# pip install langchain-openrouter
from deepagents import create_deep_agent

agent = create_deep_agent(model="openrouter:minimax/minimax-m2.7")
就这么简单。框架会自动处理其余部分——它会检测模型的上下文窗口大小,禁用不支持的模态,并在系统提示词中注入正确的身份信息,以便智能体了解其自身配置。
同一个开源模型通常可以通过多个提供商获取。选择符合你约束条件的那一个即可。例如,GLM-5 可以作为 baseten:zai-org/GLM-5、fireworks:fireworks/glm-5 或用于自托管的 ollama:glm-5 获取。相同的模型,相同的运行框架(harness),不同的基础设施。
LangChain 为最流行的开源模型提供商提供支持。我们在本次发布中测试过的提供商包括:Baseten、Fireworks、Groq、OpenRouter 和 Ollama(云端)。
针对模型的 Harness 层调整
与闭源前沿模型相比,开源模型具有不同的上下文窗口、不同的工具调用格式以及不同的失败模式。Deep Agents harness 吸收了这些差异,使你无需手动处理:
- 模型身份注入 — 系统提示词会在运行时根据模型的名称、提供商、上下文限制和支持的多模态能力进行修补。智能体清楚自己是什么以及能做什么。
- 上下文管理 — 压缩、卸载和摘要阈值会根据模型的实际上下文窗口进行调整,而不是使用硬编码的默认值。拥有 4K 上下文的模型会比拥有 1M 上下文的 Opus 采用更激进的压缩策略。
Deep Agents CLI
每个模型也可在 Deep Agents CLI 中使用。Deep Agents CLI 是我们的开源编码智能体,也是 Claude Code 的替代方案。
除了 Deep Agents SDK 中的所有功能外,CLI 还支持 运行时模型切换。我们引入了一个新的中间件 (ConfigurableModelMiddleware),以便在不重启智能体的情况下实现会话中途切换模型。这使得诸如使用前沿模型进行规划、使用开源模型执行的模式成为可能。
你可以使用 /model 斜杠命令在会话中途切换模型。这支持这样的模式:先使用前沿模型开始任务进行规划,然后切换到更便宜的开源模型进行执行。
下一步计划
一些我们很快要分享的内容:
- 记录特定开源模型系列的 harness 调优模式
- 测试多模型子智能体配置(例如:闭源前沿模型编排器 + 开源模型子智能体)
开源模型如今已适用于智能体。我们希望展示那些帮助我们设计优秀 harness 并构建针对性评估(evals)的设计模式,以衡量对你任务真正重要的指标。
Deep Agents 是开源项目。欢迎使用你偏好的开源模型进行尝试,并与我们一起构建出色的评估(evals)和智能体(agents)。

洞察智能体的真实行为
LangSmith 是我们的智能体工程平台,可帮助开发者调试每一个智能体决策、评估变更,并实现一键部署。