vLLM 迁移至 LibTorch 稳定 ABI 支持直接替换 torch 免重编译
vLLM 从 v0.33.0 起发布基于 LibTorch 稳定 ABI 的 CUDA wheel,使升级 LibTorch 时无需重新编译或重新链接 vLLM,可直接替换 torch wheel 并导入。该改动降低了 C++ 后端与 PyTorch 二进制接口的耦合,但官方提示兼容性仍受 Python API、最低 CUDA 版本与第三方依赖制约。
报道正文
本文目录13 个章节
将 vLLM 迁移至 LibTorch 稳定 ABI
引言
vLLM 高度依赖 PyTorch,其 C++ 后端会频繁调用 LibTorch。因此,即使 API 保持不变,LibTorch 二进制接口的变更也可能需要重新构建并重新链接 vLLM。如果我们能在不重新构建 vLLM 的情况下更新 LibTorch 呢?这正是 LibTorch 稳定 ABI 的用武之地。借助 LibTorch 稳定 ABI,更新 LibTorch 无需重新构建或更新 vLLM 即可继续使用。相反,我们可以替换 torch wheel,并将其直接导入我们的 vLLM 包中。自 v0.33.0 起,vLLM 发布 LibTorch ABI 稳定版 CUDA wheel。
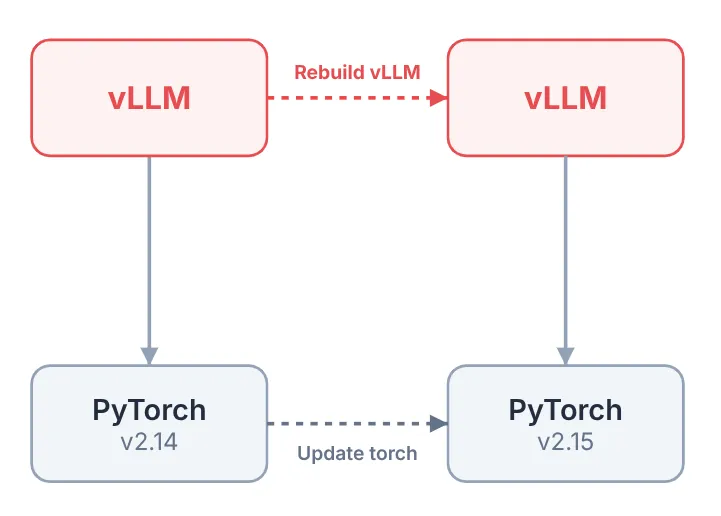
不稳定的导入
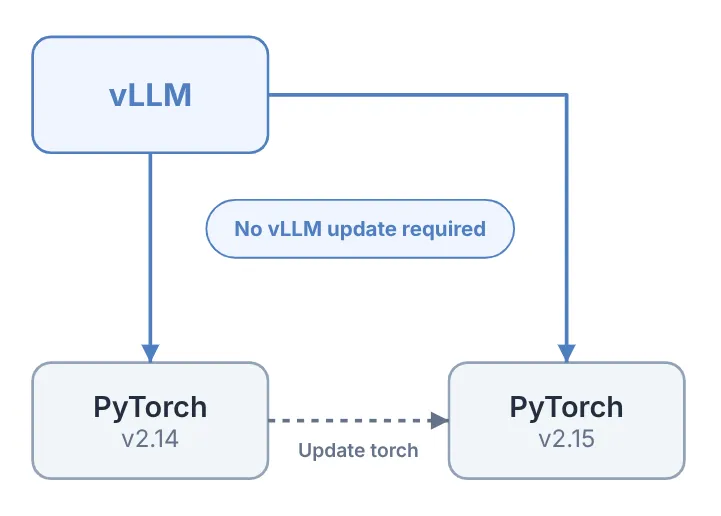
稳定的导入
左: 不稳定的 ABI——新的 torch 需要 vLLM 重新构建。右: 稳定的 ABI——vLLM 可以直接导入新的 torch。
注意:vLLM 与 PyTorch 之间的兼容性仍取决于其他因素,包括 Python API、GPU 相关要求(例如最低支持的 CUDA 版本)以及第三方依赖。LibTorch 稳定 ABI 解决了二进制兼容性问题,但并不能消除这些其他约束。
什么是 LibTorch 稳定 ABI?
应用程序二进制接口(ABI)定义了编译后的代码如何与库交互:函数如何被调用、数据如何布局以及符号如何命名。即使 API 在源代码中看起来相同,ABI 的变更也可能迫使扩展重新构建。稳定 ABI 在兼容版本之间保留一组受支持的二进制接口,因此使用这些接口的扩展无需重新构建即可继续工作。
PyTorch 的 LibTorch 稳定 ABI 分为三层:一个暴露选定 LibTorch API 的稳定 C shim、使该 shim 更易于使用的 C++ 封装,以及位于 torch::headeronly 中、不链接 libtorch.so 的 headeronly 工具。
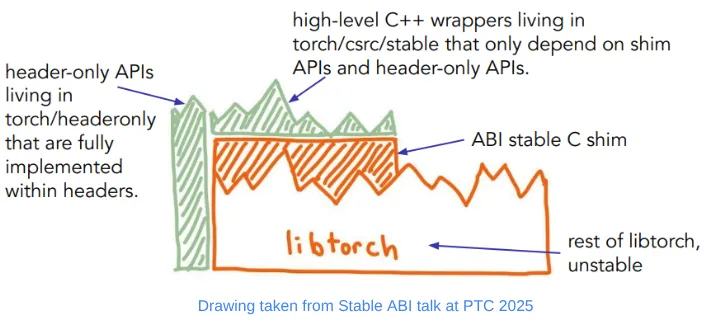
LibTorch 稳定版
为什么稳定 ABI 很重要
在稳定 ABI 之前,新的 PyTorch 版本可能要求重新构建 vLLM,从而延迟对新版本及其特性的支持。借助稳定 ABI,同一个 vLLM wheel 可以在兼容的 PyTorch 版本之间工作,让用户更早升级,并减少软件包分发者的重新构建工作。对于开发者而言,这意味着你可以更新并重新构建 PyTorch,然后在 vLLM 中测试这些变更,而无需重新构建 vLLM。
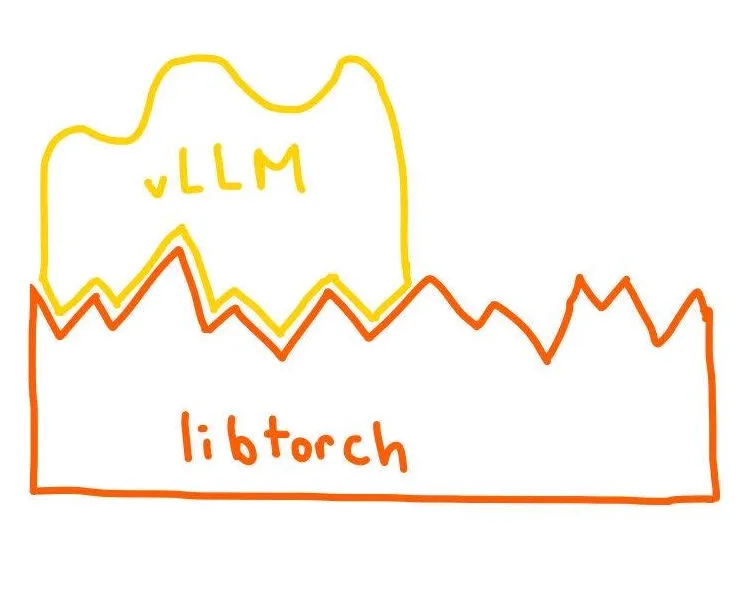
不稳定的 ABI 示意图
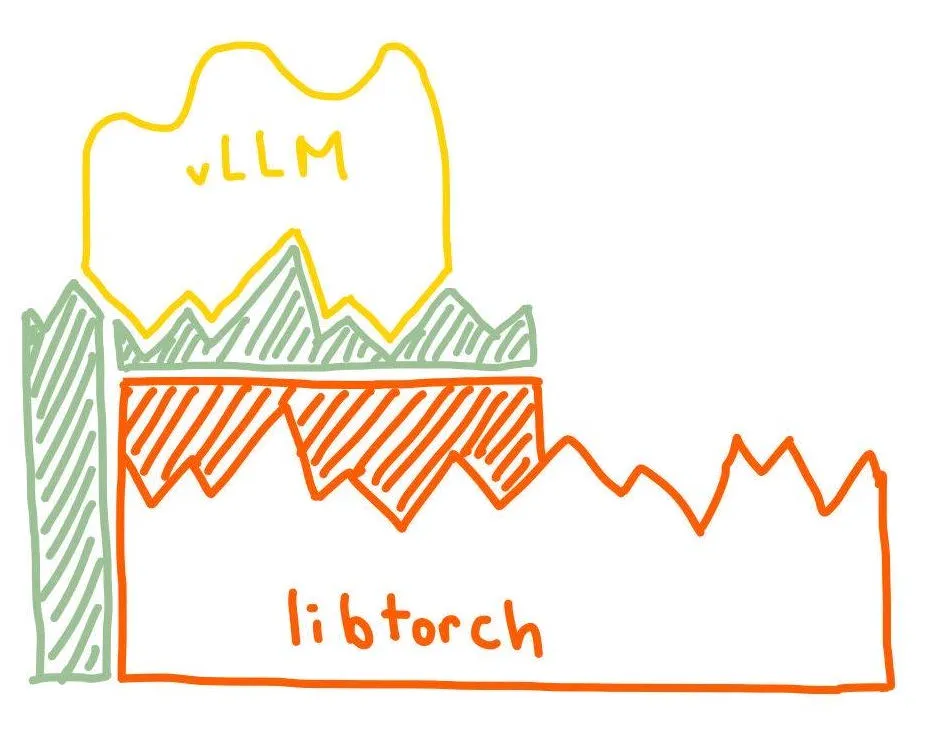
稳定的 ABI 示意图
左图: vLLM 需要随 LibTorch 的变化而变化。右图: vLLM 可以独立于 LibTorch 进行变更。
权衡取舍
LibTorch Stable ABI 只是整个 LibTorch 的一个有限子集。虽然许多常用算子已经可以通过 C shim 以及更高层的 C++ 便捷封装得到支持,但并非全部都能支持。例如,在迁移期间,is_pinned() 就没有对应的稳定等价实现。幸运的是,有一个通用的 torch_call_dispatcher C shim,允许我们以 ABI 稳定的方式通过 dispatcher 调用 ATen 算子!这让我们既能保持原有行为,又能实现 ABI 稳定性。这次迁移还帮助 PyTorch 了解了哪些 API 被广泛使用,并在 2.14 版本中新增了稳定的 C++ is_pinned() 方法。
之前:直接调用 LibTorch 方法
if (cpu_tensor.is_pinned())之后:ABI 稳定的 dispatcher 调用
std::array<StableIValue, 2> is_pinned_stack{
    torch::stable::detail::from(cpu_tensor),
    torch::stable::detail::from(std::nullopt)};
TORCH_ERROR_CODE_CHECK(torch_call_dispatcher(
    "aten::is_pinned", "", is_pinned_stack.data(), TORCH_ABI_VERSION));
if (torch::stable::detail::to<bool>(is_pinned_stack[0]))
第二个权衡是少量额外的宿主侧开销。稳定的 C shim 会带来类型转换开销,而对于某些依赖 torch_call_dispatcher 的封装,还会带来算子查找和装箱(boxing)开销。这种开销通常可以忽略不计,并且在 CUDA Graphs 下经过预热后就会消失,但在 eager 模式下反复启动非常快的 kernel 时可能会有影响。在迁移过程中,我们没有观察到明显的运行时性能回退。
将 vLLM 迁移到 Stable ABI
我们将向 Stable ABI 的迁移分解为一系列步骤:
- 评估现状
首先,我们评估了 vLLM 能否使用当时可用的稳定 API 完成迁移。我们盘点了其 PyTorch API 调用,识别出缺口,并规划了填补这些缺口所需的稳定 API。这项工作在最初的 RFC 中有所概述,该 RFC 旨在更新 vLLM 的 CUDA 构建以使用 LibTorch Stable ABI。
- 将 AutogradFunctions 和 meta 函数迁移到 Python
截至目前,LibTorch Stable ABI 尚不支持稳定的 SymInt,因此 meta 函数需要用 Python 而不是 C++ 编写。幸运的是,vLLM 的大部分 meta 函数本来就用 Python 实现,所以迁移少数非 Python 实现的函数相对简单,也让项目更加一致。同样,Stable ABI 并未暴露 PyTorch 的自动微分机制,因此 AutogradFunctions 也需要用 Python 编写。对于 vLLM 这样的推理引擎来说,这一点影响较小,但如果实现了反向函数,就需要用 Python 编写。
- 搭建必要的脚手架
由于 vLLM 是一个庞大的项目,仅 CUDA 构建就包含 175 个以上的 .cpp/.cu 源文件以及另外 120 多个头文件,一次性迁移所有内容会难以驾驭且难以审查。因此,我们创建了一个独立的 stable 库(参见首次迁移中的 CMakeLists.txt 更新 PR #31509),并以可管理的批次将内核迁移到这个库中。TORCH_TARGET_VERSION 构建标志有助于保持新库的 LibTorch ABI 稳定:如果新库包含了任何不稳定的 LibTorch 头文件,构建就会失败。
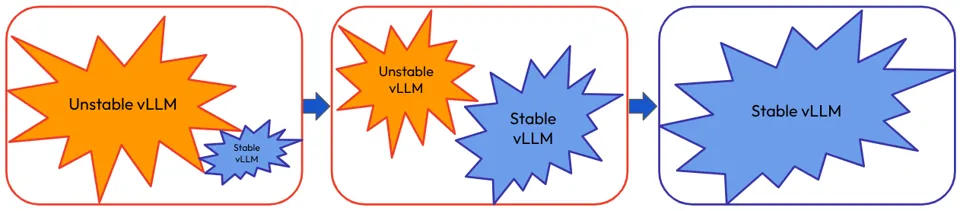
vLLM 从不稳定库迁移到稳定库
随着稳定库不断增长,不稳定库逐渐缩小直至消失。
- 确保通过 dispatcher 注册算子
截至目前,注册 LibTorch Stable 算子需要通过 STABLE_TORCH_LIBRARY 进行注册。如果你已经通过 TORCH_LIBRARY 注册算子(vLLM 正是如此),那么这一过程会非常熟悉。新的稳定注册方式最大的区别在于,实现需要用 TORCH_BOX 进行包装。这会生成一个适配器,将 C++ 数据类型装箱/拆箱为可以跨越 PyTorch Stable ABI 的通用 StableIValue 类型。
如果你的内核是通过其他机制(例如 pybind11)注册的,我们建议先将注册转换为 TORCH_LIBRARY,然后再通过 STABLE_TORCH_LIBRARY 注册(更多内容见下文 过程中的挑战 一节)。
- 将每个源文件迁移为使用稳定 API
一旦步骤 1–4 就绪,我们就可以将每个源文件迁移到稳定 API。我们引入的任何 PyTorch 头文件都应来自 C++ 稳定封装、仅头文件工具,或 C shim 本身:
torch/csrc/stabletorch/headeronlytorch/csrc/stable/c/shim.h(或torch/csrc/inductor/aoti_torch/c/shim.h)
源文件的改动大多是机械性的。例如:
torch::Tensor→torch::stable::Tensorat::kInt→torch::headeronly::ScalarType::Intt.view({...})→torch::stable::view(t, {...})
为帮助迁移源文件,我们为 AI agent 创建了技能,可将现有 API 映射到其稳定等价物,并标记常见错误,例如与迁移无关的改动。这些技能也支持前面的步骤(1–4)。它们在我们的工作中很有用,但我们尚未开发评估来衡量其有效性(见 abi-stable-skills)。
- 验证!
vLLM 被多个行业的数百万用户使用,我们不希望迁移中断他们的任何流程。因此,本列表中最重要的一步是验证迁移没有做出任何重大改动。这意味着运行适当的单元测试和性能测试,并逐行人工审查每个迁移 diff,以确保没有意外更新。
除了验证正确性,我们还需要验证新库确实具备 LibTorch ABI 稳定性。为此,我们使用 torch-abi-audit(感谢 Ralf Gommers!)。该工具检查 .so 文件,并对稳定和不稳定的 PyTorch 符号进行分类。如果没有不稳定符号,则该库具备 LibTorch ABI 稳定性。它还会报告提供所有所需稳定符号的最低 LibTorch 版本(例如 min-torch=2.11.0)。我们用它跟踪迁移进度并检查回归,现在还在 vLLM CI 中使用它,以确保 wheel 保持 LibTorch ABI 稳定。
torch-abi-audit vllm
Package: vllm
  Root: /workspaces/vllm_container/vllm/vllm
  Torch ABI:   UNSTABLE
  Min torch:   2.11.0
  CPython ABI: mixed
  Extensions:  10
  Bundled libs: 0
  -- extensions --
    [STABLE  ] [abi3-ok               ] _C_stable_libtorch.abi3.so  (stable_shim=88, unstable=0)  min-torch=2.11.0
    [UNSTABLE] [abi3-ok               ] _flashmla_C.abi3.so  (stable_shim=0, unstable=70)
    [UNSTABLE] [abi3-ok               ] _flashmla_extension_C.abi3.so  (stable_shim=0, unstable=68)
    [STABLE  ] [abi3-ok               ] _moe_C_stable_libtorch.abi3.so  (stable_shim=72, unstable=0)  min-torch=2.11.0
    [UNSTABLE] [abi3-ok               ] _qutlass_C.abi3.so  (stable_shim=0, unstable=59)
    [NO-TORCH] [abi3-ok               ] cumem_allocator.abi3.so
    [NO-TORCH] [abi3-ok               ] spinloop.abi3.so
    [UNSTABLE] [uses-private-api      ] third_party/deep_gemm/_C.cpython-312-x86_64-linux-gnu.so  (stable_shim=0, unstable=59)
    [UNSTABLE] [abi3-ok               ] vllm_flash_attn/_vllm_fa2_C.abi3.so  (stable_shim=0, unstable=85)
    [UNSTABLE] [abi3-ok               ] vllm_flash_attn/_vllm_fa3_C.abi3.so  (stable_shim=0, unstable=81)
依赖迁移之前的 torch-abi-audit
vLLM 构建依赖
仅迁移 vLLM 源码本身,并不能证明整个 vLLM wheel 具备 ABI 稳定性。要使该 wheel 完全稳定,其编译依赖也必须满足 LibTorch ABI 稳定。vLLM 目前有七个同样依赖 LibTorch 的依赖项。它们分别是:
| 依赖项 | 已在 vLLM Fork 上迁移 | 已在上游迁移 |
|---|---|---|
| FlashMLA | ✅ | ✅ |
| DeepGEMM | ✅ | 🚧 进行中 |
| FlashAttention-2 | ✅ | 🚧 PR 已提交,待稳定 |
| FlashAttention-3 | ✅ | ✅ |
| DeepSelect | ✅ | 🚧 进行中 |
| FlashKDA | ✅ | ❌ |
| QuTLASS | 不适用 | ✅ |
在树内 vLLM 代码完成迁移后,这些依赖项也逐一迁移到了 LibTorch Stable ABI,从而使整个 vLLM CUDA wheel 达到 LibTorch ABI Stable。
torch-abi-audit vllm
Package: vllm
  Root: /workspaces/vllm_container/vllm/vllm
  Torch ABI:   STABLE
  Min torch:   2.13.0
  CPython ABI: abi3
  Extensions:  13
  Bundled libs: 0
  -- extensions --
    [STABLE  ] [abi3-ok               ] _C_stable_libtorch.abi3.so  (stable_shim=88, unstable=0)  min-torch=2.11.0
    [STABLE  ] [abi3-ok               ] _deepselect_C.abi3.so  (stable_shim=40, unstable=0)  min-torch=2.10.0
    [STABLE  ] [abi3-ok               ] _flashkda_C.abi3.so  (stable_shim=43, unstable=0)  min-torch=2.11.0
    [STABLE  ] [abi3-ok               ] _flashmla_C.abi3.so  (stable_shim=66, unstable=0)  min-torch=2.11.0
    [STABLE  ] [abi3-ok               ] _flashmla_extension_C.abi3.so  (stable_shim=63, unstable=0)  min-torch=2.11.0
    [STABLE  ] [abi3-ok               ] _moe_C_stable_libtorch.abi3.so  (stable_shim=72, unstable=0)  min-torch=2.11.0
    [STABLE  ] [abi3-ok               ] _qutlass_C.abi3.so  (stable_shim=63, unstable=0)  min-torch=2.13.0
    [NO-TORCH] [abi3-ok               ] cumem_allocator.abi3.so
    [NO-TORCH] [abi3-ok               ] fs_io_C.abi3.so
    [NO-TORCH] [abi3-ok               ] spinloop.abi3.so
    [STABLE  ] [abi3-ok               ] third_party/deep_gemm/_C_extension.abi3.so  (stable_shim=85, unstable=0)  min-torch=2.11.0
    [STABLE  ] [abi3-ok               ] vllm_flash_attn/_vllm_fa2_C.abi3.so  (stable_shim=69, unstable=0)  min-torch=2.10.0
    [STABLE  ] [abi3-ok               ] vllm_flash_attn/_vllm_fa3_C.abi3.so  (stable_shim=63, unstable=0)  min-torch=2.10.0
依赖项迁移后的 torch-abi-audit
时间线
2025 年 10 月 15 日 RFC 开启,开始讨论迁移到 Stable ABI。RFC
2025 年 11 月 13 日 将 C++ meta 函数重写为 Python。PR #28595
2025 年 12 月 29 日 首个迁移 PR 开启:PR #31509
2026 年 3 月 19 日 首个迁移 PR 关闭。
2026 年 5 月 创建 abi-stable-skills
2026 年 6 月 又有 12+ 个 PR 被合并,使 vLLM 的树内代码达到 LibTorch ABI Stable。
2026 年 7 月 27–29 日 首批将 DeepGEMM 从 pybind11 迁移到 Stable ABI 的 PR 开启。
2026 年 7 月至 9 月 FlashMLA、QuTLASS、FlashAttention 2、FlashKDA、FlashAttention 3 和 DeepSelect 迁移至 Stable ABI。
2026 年 10 月 15 日 DeepGEMM 完成迁移;vLLM CUDA wheel 变为 LibTorch ABI Stable。
过程中的挑战
最大的挑战是跟上这个规模庞大且快速变化的项目。上游文件经常在我们的迁移补丁进行期间发生变化,因此我们不得不在补丁合并前更新它们。vLLM 的外部依赖也意味着需要跨项目协调,并为迁移构建支持。
DeepGEMM:迁移案例研究
DeepGEMM 集中体现了其中多项挑战。在我们的迁移进行期间,DeepGEMM 从版本 1 升级到版本 2,并新增了 DeepJIT——另一个依赖 LibTorch、同样需要迁移的项目。随后 vLLM 又从上游 deepseek-ai/DeepGEMM 仓库切换到自己的 vllm-project/DeepGEMM fork,要求我们在新 fork 上重新进行迁移。
这些上游变化只是挑战的一部分。由于 DeepGEMM 通过 pybind11 注册其算子,我们还需要在采用 Stable ABI 之前将其注册迁移到 TORCH_LIBRARY。例如,fp8_fp4_paged_mqa_logits 最初的绑定为:
m.def("fp8_fp4_paged_mqa_logits", &fp8_fp4_paged_mqa_logits,
      py::arg("q"), ...,
      py::arg("max_context_len"), ...);
其中 q 是 std::tuple<Tensor, std::optional<Tensor>>&,max_context_len 是 const int&。为使这些参数与 TORCH_LIBRARY 兼容,我们添加了一个包装函数,分别接收元组中的各个元素,并在其 C++ 签名中使用 int64_t:
static torch::Tensor fp8_fp4_paged_mqa_logits(
    const torch::Tensor& q, const c10::optional<torch::Tensor>& q_sf, ...
    const int64_t& max_context_len, ...) {
  return attention::fp8_fp4_paged_mqa_logits(
      std::make_tuple(q, q_sf), ...,
      static_cast<int>(max_context_len), ...);
}
现在可以通过 TORCH_LIBRARY 注册为:
TORCH_LIBRARY_FRAGMENT(deep_gemm, m) {
    m.def("fp8_fp4_paged_mqa_logits(Tensor q, Tensor? q_sf, ..., int max_context_len, ...) -> Tensor");
}

TORCH_LIBRARY_IMPL(deep_gemm, CUDA, m) {
    m.impl("fp8_fp4_paged_mqa_logits", TORCH_FN(fp8_fp4_paged_mqa_logits));
}
Python 接口在调用已注册的算子之前会先解包该元组:
def fp8_fp4_paged_mqa_logits(q, ..., max_context_len, ...):
    q_fp, q_sf = q[0], q[1]
    return _torch_ops.fp8_fp4_paged_mqa_logits(
        q_fp, q_sf, ..., max_context_len, ...)
这样一来,注册就可以使用 TORCH_LIBRARY,而无需更改面向用户的 API。
在 DeepGEMM 迁移到 TORCH_LIBRARY 之后,Stable ABI 迁移遵循了与其他迁移类似的过程。我们替换了其不稳定的 API,并更新了算子注册:
STABLE_TORCH_LIBRARY_FRAGMENT(deep_gemm, m) {
    m.def("fp8_fp4_paged_mqa_logits(Tensor q, Tensor? q_sf, ..., int max_context_len, ...) -> Tensor");
}

STABLE_TORCH_LIBRARY_IMPL(deep_gemm, CUDA, m) {
    m.impl("fp8_fp4_paged_mqa_logits", TORCH_BOX(fp8_fp4_paged_mqa_logits));
}
由于 DeepGEMM 是 vLLM 最后一个需要迁移的构建依赖项,完成这项工作后,整个 vLLM wheel 的 LibTorch ABI 就实现了 Stable!
在较新 PyTorch 上的示例运行
# stable_abi_demo.py
import os

os.environ.setdefault("VLLM_USE_FLASHINFER_SAMPLER", "0")

import torch
import vllm
from vllm import LLM, SamplingParams

print(f"PyTorch runtime: {torch.__version__}")
print(f"vLLM: {vllm.__version__}")

llm = LLM(
    model="HuggingFaceTB/SmolLM2-135M-Instruct",
    max_model_len=128,
    gpu_memory_utilization=0.1,
    enforce_eager=True,
)
outputs = llm.generate(
    ["The capital of France is"],
    SamplingParams(temperature=0, max_tokens=8),
)
print(outputs[0].outputs[0].text)
使用 PyTorch 2.14.1 构建 vLLM 并运行该演示:
> python stable_abi_demo.py

PyTorch runtime: 2.14.1+cu132
vLLM: 0.1.dev24716+gcb95d994f.d20261105
Paris. Paris is a city known for
将 PyTorch wheel 更新到 torch==2.15.0:
uv pip install torch==2.15.0 \无需重新构建 vLLM,重新运行演示:
> python stable_abi_demo.py

PyTorch runtime: 2.15.0+cu132
vLLM: 0.1.dev24716+gcb95d994f.d20261105
Paris. Paris is a city known for
注:为清晰起见,上述输出中省略了常规的 vLLM 初始化日志、进度条以及无关的弃用警告。
未来工作
既然 vLLM 的 CUDA 构建已经采用 LibTorch Stable ABI,我们的下一步是让 vLLM 的所有构建都实现 ABI 稳定,包括 CPU 和 ROCm 构建。这些迁移的规模小于 CUDA 迁移,但对 vLLM 生态仍然很重要。ROCm 构建与 CUDA 构建共享许多源文件:hipify 会将 .cu 文件转换为 .hip 文件,因此这些文件已经使用了 LibTorch Stable ABI。只剩下少数 ROCm 专属文件需要迁移。
我们还在扩展稳定 API 的范围,使 vLLM 及其依赖项不再需要包装层。随着 API 范围的扩大,我们也将更新 PyTorch 的上游测试,以确保这些 API 保持 LibTorch ABI 稳定。
致谢主要贡献者
- vLLM 社区: Shengqi Chen(主要协调人)、Jiangyun Zhu(DeepSelect fork 迁移)、Thien Tran(FlashKDA fork 迁移)、Roberto L. Castro(上游 QuTLASS 迁移)、Kaichao You(路线图),以及所有审阅我们 PR 并提供建议的维护者。
- PyTorch 社区: Jane Xu(项目负责人,fork 和上游的 FlashMLA 迁移,abi-stable-skills 项目)、Chris Leonard(主要迁移工作)、Mikayla Gawarecki(树内源码的早期迁移工作)、Ralf Gommers(torch-abi-audit 项目)。
- DeepSeek: Chenggang Zhao、Yichen Yan、Shengyu Liu。