Anthropic 发布 Fable 5.2 与 Mythos 5.2 登顶智能指数
Anthropic 在 IPO 前夕发布两款旗舰模型 Claude Fable 5.2 与 Mythos 5.2,主打高难度技术任务。Fable 5.2 以 65 分登顶 Artificial Analysis 智能指数 v5,领先 Gemini 4 Carbon 五分、较前代 Fable 5.1 提升 15 分;在低算力档位仍以 62 分全面领先且 token 消耗更低。Anthropic 称训练中刻意抑制了可能直接加速 AI 研发的能力。
报道正文
本文目录6 个章节
Claude Fable 5.2 与 Mythos 5.2 在 IPO 前夕巩固了 Anthropic 的 AI 领先地位
[Matthias Bastian](https://the-decoder.com/author/matthias-bastian/) [查看 Matthias Bastian 的 LinkedIn 个人资料](https://www.linkedin.com/in/matthias-bastian-128b71b1/) 2026年11月9日 
Anthropic
要点
-
Anthropic 正在发布 Claude Fable 5.2 和 Mythos 5.2,这两款新旗舰模型专为最严苛的技术任务打造。Anthropic 表示,它有意在训练过程中阻止这些模型获得可能直接加速 AI 开发的能力。
-
Fable 5.2 在 Artificial Analysis Intelligence Index v5 上以 65 分排名第一,领先 Gemini 4 Carbon 五分,领先其前代 Fable 5.1 十五分。峰值质量平均每项任务花费 26.50 美元,约为 Opus 5.5 的 2.6 倍。
-
在较低算力层级下,Fable 5.2 仍以 62 分在每个层级都优于其他所有模型,同时消耗的 token 少得多。
文本 询问关于本文的问题… 搜索
Anthropic 的 Claude Fable 5.2 和 Mythos 5.2 在该公司 IPO 前不久重新夺回 AI 性能领先地位,某些情况下优势明显。Opus 5.5 仍是 Anthropic 推荐的日常使用模型。
Claude Fable 5.2 和 Claude Mythos 5.2 共享相同的模型基础,但正如它们的前代一样,在访问权限上有所不同。Fable 包含安全防护措施,可阻止网络安全和生物学领域的风险任务,并向所有用户开放。Mythos 取消了其中某些限制,仅向通过 Anthropic 网络安全或生命科学验证计划申请的组织开放。
定价为每百万输入 token 8 美元、每百万输出 token 40 美元。至少从纸面上看,这比前代(分别为 10 美元和 50 美元)有所下调。用户实际支付的费用取决于 token 消耗量,而消耗量会因任务、设置和软件环境而异。Anthropic 将新模型定位为面向最严苛的技术工作,并继续推荐 Claude Opus 5.5 用于日常使用。
Anthropic 表示,这些模型的输出速度比 Fable 5.1 和 Mythos 5.1 快最多 30%。面向特定组织的可选快速模式可将 token 输出速度提升最多 2.5 倍,但费用翻倍,且仅在部分平台提供,包括 Claude Code、Claude Platform、Google Cloud 和 Microsoft Foundry。
Fable 5.2 在基准测试中跃升至明显领先
Artificial Analysis 的基准测试显示,Fable 5.2 明显领先于其竞争对手。在当前 Index v5 的最高算力档位上,它以 65 分位居第一,领先 Gemini 4 Carbon(60 分,High 档)5 分——谷歌仍未发布该模型;领先 Claude Opus 5.5(59 分,Max 档)6 分;并令人瞩目地领先 Claude Fable 5.1 达 15 分,而后者仅在 9 月初才发布。
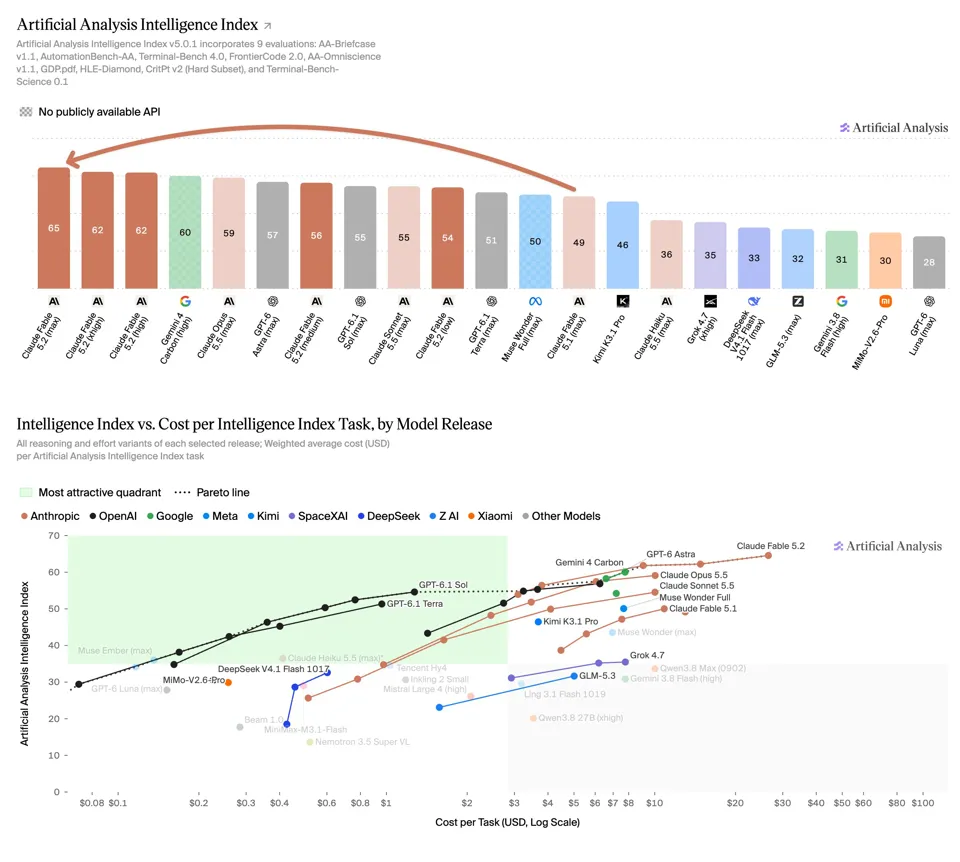
根据 Artificial Analysis 的数据,Fable 5.2 在九项单项测试中的五项取得最佳成绩,其中包括 HLE-Diamond 的 80% 和 Terminal-Bench-Science 的 73%。在智能体知识工作和基于终端的编程方面,Fable 5.2 落后于部分竞争对手。| 图片:Artificial Analysis
根据 Artificial Analysis 的数据,Fable 5.2 在九项单项测试中的五项取得最佳成绩。它在 HLE-Diamond(一项包含专家级学术问题的测试)上达到 80%,在 Terminal-Bench-Science(测试 AI 智能体能否在终端中独立运行科学工作流)上达到 73%,在 FrontierCode 2.0(评估智能体能否在真实开源项目中交付有用的代码变更)上达到 49%。
Fable 5.2 在智能体知识工作和基于终端的编程方面较弱。它在 AA-Briefcase(一项针对多步骤知识工作任务的基准测试)上达到 1,785 Elo,略低于 Claude Sonnet 5.5(1,813),但处于 Opus 5.5(1,800)的置信区间内。在 Terminal-Bench 4.0(衡量软件开发和安全等领域多步骤终端任务)上,它得分 60%,与 Opus 5.5 持平。Kimi K3.1 Pro(67%)、Gemini 4 Carbon(65%)和 Sonnet 5.5(64%)在此项排名更高。
不过,巅峰质量是有代价的。最高档位的单任务成本平均为 26.50 美元,约为 Opus 5.5(10 美元)的 2.6 倍,也大约是 Fable 5.1(12.99 美元)的两倍。根据 Artificial Analysis 的数据,Fable 5.2 在较低的 High 和 Xhigh 档位上仍能在 Intelligence Index 上获得 62 分,领先于任何档位上的其他所有模型,同时消耗的 token 少得多:每任务输出 98,000 个 token,而 Opus 5.5 在 Max 档位下为 173,000 个。
| Anthropic 基准测试结果 | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| 智能体编程 FrontierCode 2.0 | 49.1% Xhigh 推理强度 | 32.4% Xhigh 推理强度 | 45.5% | 42.8% | 41.1% Medium 推理强度 |
| 智能体编程 FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| 业务流程自动化 AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| 智能体科学研究 Terminal-Bench Science 0.1 | 74.6% 75.3%(Myth 5.2) | 52.6% | 58.7% | 68.1% | 64.8% |
| 网络安全 CyScenarioBench† | 76.3% Myth 5.2 | 61.7% Myth 5.1 | 67.6%(无安全防护) | 61% GPT-6 Cyber | — |
| 网络安全 CVE 重新发现 | 89.6% Myth 5.2 | 78.3% Myth 5.1 | 81.3%(无安全防护) | — | — |
| 蛋白质设计 从头结合剂设计(24 小时) | 85.1% Myth 5.2 | 79.1% Myth 5.1 | 82.6%(无安全防护) | — | — |
| 智能体搜索 WANDR(宽松评分) | 82.1% | 68.7% | 72.3% | — | — |
| 计算机使用 OSWorld 2.1(离线集,部分) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| 机器人技术 RoboDojoSim‡ | 64.9% | 27.6% | 39.4% | 29.8% | — |
| 知识工作 AA-Briefcase v1.1 | 66.1% 评分标准 | 61.5% 评分标准 | 61.2% 评分标准 | 52.0% 评分标准 | 61.8% 评分标准 |
| 1785 Elo | 1669 Elo | 1800 Elo | 1569 Elo | 1611 Elo | |
| 知识工作 远程劳动指数(RLI) | 41.3% 高推理强度 | 17.9% | 21.3% | 20.8% | — |
| 多学科推理 Humanity's Last Exam(使用工具) | 74.2% | 65.6% | 67.7% | 57.2% | — |
| 视觉图表识别 Chartography(不使用工具) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
Mythos 5.2 发现的安全漏洞远超所有前代模型
新模型还在网络安全领域创下纪录,而这一领域目前正引发激烈争论。Anthropic 表示,Mythos 5.2 发现的漏洞比早期模型更多,并且在复现和修复漏洞方面表现更佳。因此,面向公众开放的变体 Fable 会拦截大多数与安全相关的任务,包括渗透测试和漏洞利用代码生成。Opus 4.8 则会回应被拦截的网络安全请求,而 Opus 5 会回应被拦截的生物学请求。
Anthropic 使用一项名为 CVE Rediscovery 的内部测试,来检验模型在给定修复前项目状态的情况下,能够独立发现 CVE 数据库(Common Vulnerabilities and Exposures,即已知软件漏洞编目系统)中多少已公开的漏洞。
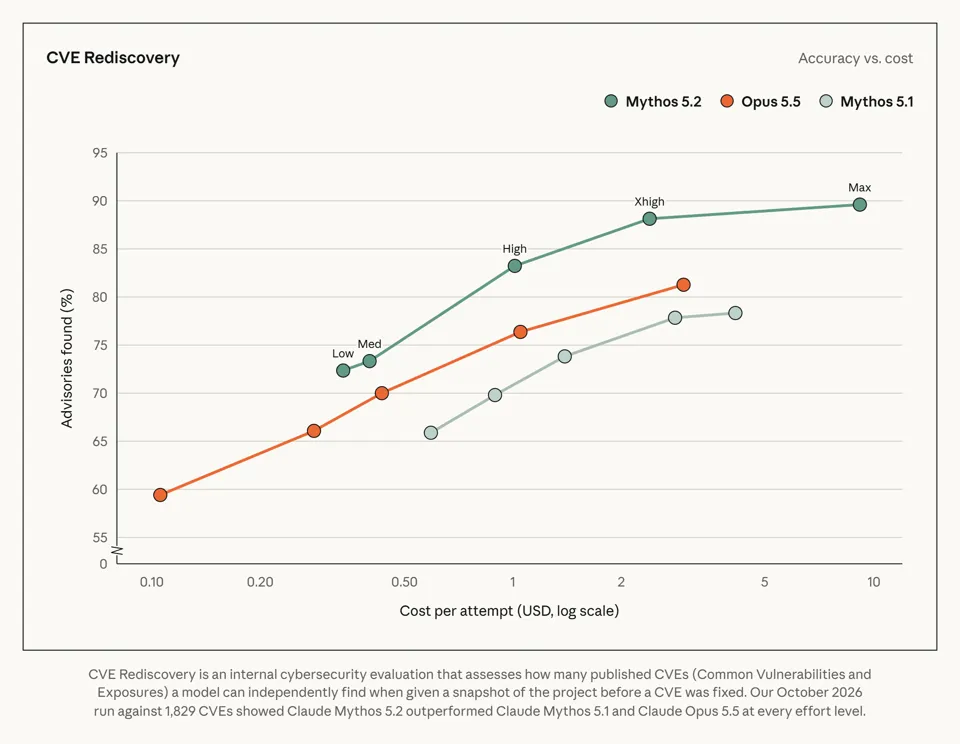
CVE Rediscovery:在独立发现已知漏洞(CVE)方面,Claude Mythos 5.2 在每个算力层级上都优于 Claude Opus 5.5 和 Claude Mythos 5.1。这项内部网络安全测试使用了 1,829 个 CVE,衡量模型在修复前的项目快照中能够自行发现多少个漏洞。| 图片:Anthropic
Anthropic 表示,在 2026 年 10 月使用 1,829 个 CVE 进行的测试中,Mythos 5.2 发现的漏洞比 Opus 5.5 多 10.2%,比 Mythos 5.1 多 14.4%。它在每个算力层级上都处于领先。据 Anthropic 称,一家安全公司报告称,Mythos 5.2 发现的确诊漏洞中,有六分之一是所有其他受测前沿模型都未能发现的。
Anthropic 限制可能加速 AI 发展的能力
Anthropic 表示,它在训练过程中有意抑制模型提升那些最可能直接加速 AI 发展的能力,即所谓的 RSI,目前这一概念正被广泛讨论为一种风险。该公司称,在优化加速器芯片的计算内核以及改进大语言模型架构等领域,Fable 5.2 和 Mythos 5.2 的表现与 Opus 5.5 大致相当。
据 Anthropic 称,智能体编程、硬件开发以及传统 AI 研究(包括可解释性研究)等相关能力不受影响。该公司表示,如今在人类指导下,Claude 编写了合并进 Anthropic 核心代码库的超过 90% 的变更。Anthropic 还声称,在一次内部测试中,该模型从零开始编写了一个操作系统。
Claude Fable 5.2 在 30 小时内形式化费马大定理
最可能引起关注的例子再次来自数学领域。Anthropic 称,约 1,000 个 Fable 5.2 智能体将费马大定理的证明完整形式化,将其转换为 Lean 编程语言,以便计算机能够逐步验证。
费马大定理指出,熟悉的方程 a² + b² = c² 对于高于平方的幂次没有整数解。几个世纪以来无人能够证明这一点,直到 Andrew Wiles 在 1995 年提出了一个超过一百页的证明。其机器验证如今首次完成,耗时 30 小时。
此前一个未公开的研究版 Claude 完成同样的任务需要 11 天,并且依赖专门构建的环境和人类研究员的指导。Anthropic 称,Fable 5.2 智能体从简短指令开始,自行组织协作,且未使用任何数学参考资料。唯一的进度指标是一系列中间引理。该模型使用的动作 token 仅为首次尝试的三分之一,生成的证明长度缩短了七倍。
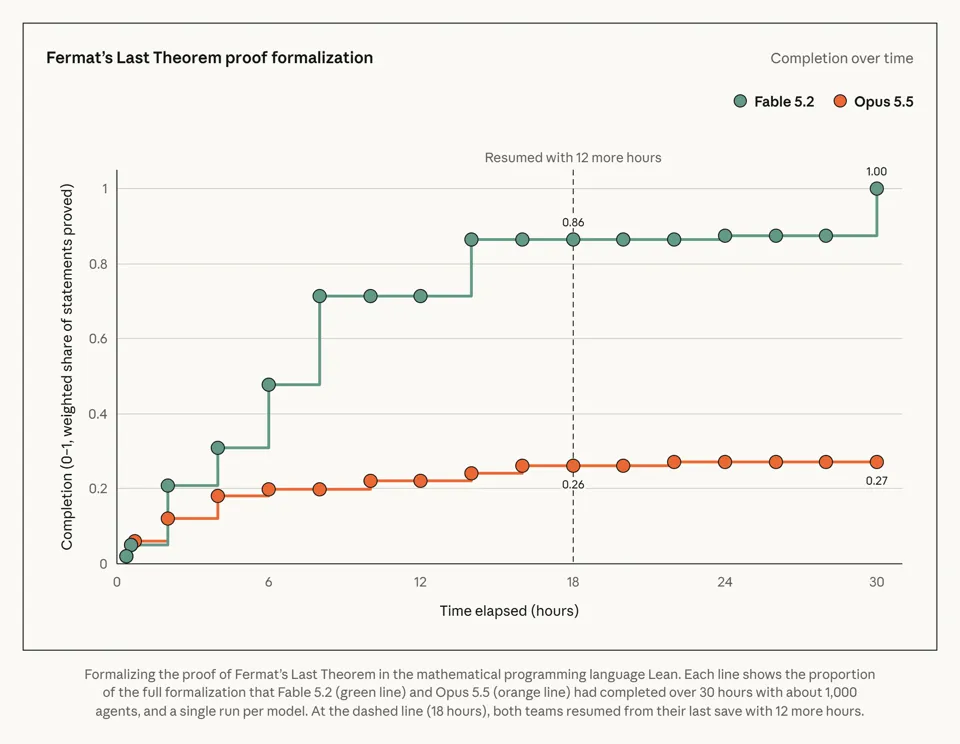
在数学编程语言 Lean 中形式化费马大定理的证明:约 1,000 个 Fable 5.2 智能体在 30 小时后达到完全形式化(1.00),而 Opus 5.5 在同一时间段内停滞在 0.27。18 小时后,两次运行均额外继续了十二小时。| 图片:Anthropic
Anthropic 在相同设置下用 1,000 个智能体运行了 Opus 5.5 作为对比。Opus 在 18 小时内仅完成了 26% 的形式化,此后到第 30 小时几乎没有取得任何进展。