Meta 研究揭示 RL 后训练致智能体重试能力下降
原标题:New Meta paper finds Reinforcement learning post-training makes an agent better on its first attempt...
85AI 研判分
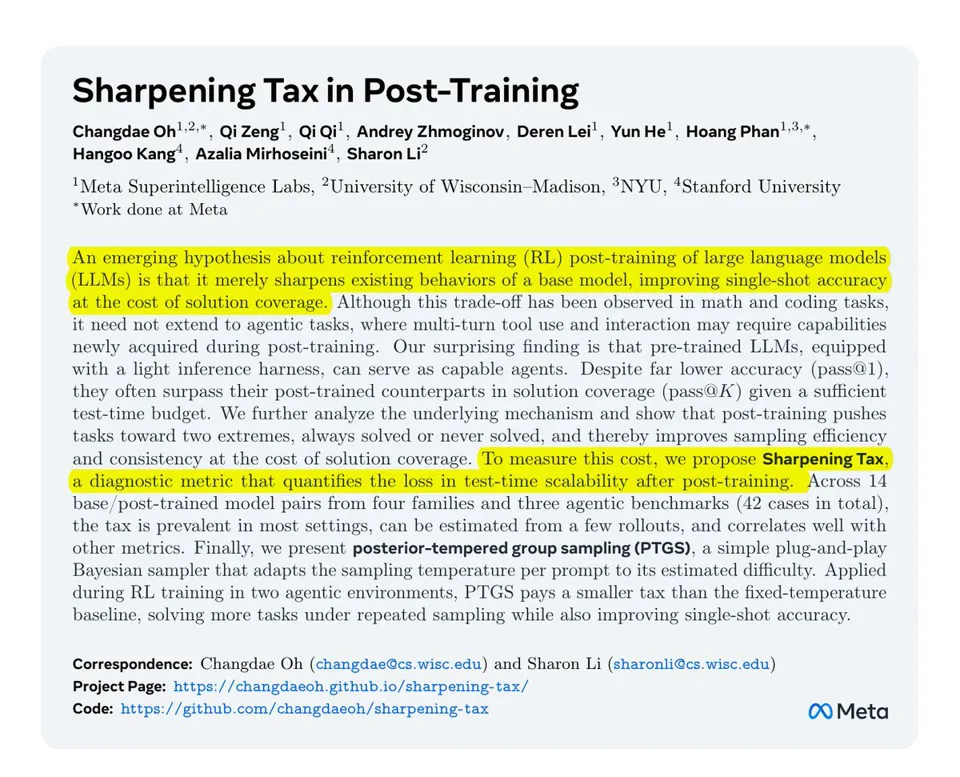
Meta 最新论文指出,强化学习(RL)后训练虽能提升智能体首次尝试的成功率,但会显著降低其在多次重试场景下的最终解决能力。实验显示,在 WebShop 等基准测试中,基础模型在允许 128 次重试时的表现优于经过 RL 微调的模型,这种现象被称为“锐化税”(Sharpening Tax)。该发现挑战了 RL 普遍增强智能体能力的传统认知,建议开发者在选择具备重试机制的智能体模型时,应重点评估其长期覆盖率而非仅关注首试准确率。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-29 17
Meta 最新论文发现,强化学习后训练(Reinforcement Learning Post-training)虽然能提升智能体在首次尝试时的表现,但在允许 128 次尝试的情况下,反而降低了其最终找到解决方案的能力。
人们通常认为强化学习能让智能体掌握新技能,例如工具调用(Tool Calling)。
这一观点主要源于数学和编程领域,因为在这些领域中,基础模型已经见过海量数据。
研究团队在 3 个智能体基准测试上运行了 14 对基础模型与后训练模型,每个任务最多允许 128 次尝试。他们还开发了 PTGS,这是一种采样器,能在处理困难提示词时提高温度,在处理简单提示词时降低温度。
在 WebShop 基准测试中,gemma-4-31B 基础模型在 128 次尝试内解决了超过 85% 的任务,而后训练版本仅解决了 56%。他们的“锐化税”(Sharpening Tax)指标在 42 组模型与基准测试配对中有 36 组为正值,这意味着覆盖率缩小了。
在为具备重试能力的智能体选择后训练模型之前,请衡量它最终能解决多少任务,而不要仅仅关注首次尝试的准确率。