新方法利用查询分布差异加速 RAG 检索
针对最大内积搜索(MIPS)在 RAG 场景下的性能瓶颈,该研究指出传统近似方法只关注键向量分布、忽略短查询与长文档之间的几何差异。作者提出利用查询分布特性的新检索方案,在保持精度的同时显著降低计算开销,并进一步扩展到隐私搜索场景。
报道正文
本文目录10 个章节
最大内积搜索(MIPS)是推荐系统、搜索和检索增强生成(RAG)的核心。给定一个查询向量,MIPS 系统会在包含数百万个候选键向量的数据库中搜索与查询最匹配的那一个。随后,与该最佳匹配键相关联的原始数据点被用于处理查询:在 RAG 中,最适合回答问题的文档通常会被前置到查询之前。
随着键的数量增长到数百万、向量维度达到数千,对查询与所有键进行穷举比较的计算成本会急剧上升。人们已经提出了大量近似方法,通过聚类和量化来以精度换取速度。这些基线方法侧重于键集合的性质来构建巧妙的索引结构,但它们的几何论证粗略地假设查询集合本身会与键集合相似,或者完全绕开对查询形态的任何考量。这在两个方面可能存在问题:在关键的 RAG 场景中,查询来自简短的、用户生成的问题,而键则代表冗长、信息丰富且经过精心整理的一段段文本,这使得键与查询存在显著差异。此外,大多数部署在生产环境中的 MIPS 用例面向的是具有稳定、特征明确的查询分布的既有用户群体——这一信号表明,通用的、与查询无关的方法错失了可利用的机会。针对可能的输入来源设计最有效的方法——而不是追求在所有可能输入上都表现良好——是现代机器学习的核心原则之一,有助于更高效地重新分配计算资源。
在发表于 ICML 2026 的论文 Amortizing Maximum Inner Product Search with Learned Support Functions 中,来自 Apple 的研究人员训练小型神经网络(NN)——针对固定的键数据库一次性离线训练——来学习如何更快地将查询路由到其最佳匹配。他们的方法以一次性的摊销成本来理解典型查询倾向于如何被匹配,从而换取推理时通过这些小神经网络实现更快、更准确的检索。
最大内积搜索的基础
MIPS 的一个基本原则是利用键集合的几何结构来加速搜索:典型的 MIPS 系统将键集合划分为 k 个簇——k 通常远小于键的总数 n——并为每个簇维护一个代表性质心。当收到一个新查询时,系统将其与这 k 个质心进行比较。然后,查询被路由到与其最接近的代表性质心所在的簇,随后与该簇中存储的所有键进行穷举比较。如果数据库有 n 个键和 k 个均匀分布的簇,那么第二步中考虑的有效键数量大约为 n/k——与朴素穷举方法中进行的 n 次比较相比,实现了 k 倍的加速。不幸的是,这种路由机制可能导致错误,因为质心路由并非精确方法,如下图所示(见图 1)。
图 1:基于几何的搜索方法可能失败并遗漏最近邻。这是因为它们依赖于基于到质心距离的空间划分。在动画中,一个最近邻被遗漏,因为它不与最近的质心相关联。
MIPS 作为支撑函数
从机器学习的角度来看,MIPS 之所以有趣,是因为它建立在一个在此工作之前被 largely 忽视的数学结构之上:将查询映射到与集合中任意键的最大内积的函数是该集合的支撑函数,这是凸分析中一个被深入研究的对象。该函数有两个重要性质:第一,它是凸的,因此可以用一类专门为凸函数设计的神经网络——输入凸神经网络(ICNN)——来近似。第二,该支撑函数在任意查询处的梯度返回最佳匹配的键本身。
这项工作的核心思想是学习一个神经网络,使其能够以低得多的计算成本模拟真实支撑函数(或其梯度)。这可以通过一种称为回归的经典机器学习技术来实现:只需预先计算大量训练样本,这些样本由采样的输入向量(用户查询)构成,并与 MIPS 产生的相关输出信号(最优得分或最优键向量本身)配对。然后只需训练一个参数化适当的神经网络,使其在给定输入时复现相应输出。
学习最大内积搜索的两种方式
如果按照上述数学方法完美地解决回归问题,那么用于模拟支撑函数的同一个神经网络也可以通过评估其梯度(通过自动微分)来输出最优键。在实践中,我们观察到,为这两项任务分别训练专门化的独立网络效果最佳:
SupportNet 神经网络架构可以使用(约束较宽松的)ICNN 直接学习支撑函数。该方法在数学上有原则依据,并与问题的凸结构相一致。我们发现,当用于为每个数据簇计算一个支撑函数以提升路由质量时,这种方法可以表现出色。
KeyNet 模型学习在输入查询时直接输出最匹配的键向量。基于齐次函数欧拉定理推导出的一致性损失,使其预测在几何上仍以底层支撑函数为基础,即使并未显式强制凸性。
两个模型都基于从相关查询分布中抽取的样本进行训练:对于每个采样查询,通过穷举搜索计算一次真实最优匹配并存储,从而创建一个监督数据集,该数据集捕捉了实际重要的查询分布下的 MIPS 解空间。
使用 SupportNet 的学习式路由
如图 1所示,处理更大规模数据的最简单方法是将键划分为多个簇,将查询与每个簇的质心进行比较,并根据这些 k 个分数将查询路由到最有希望的簇。这提供了一种廉价但粗糙的规则,容易出错,因为仅凭质心无法反映其所在簇的分布范围。事实上,一个簇中可能包含某个键,它远离自身簇的质心,却与查询距离很近;当查询靠近这样一个离群点时,质心路由会给该簇打低分并将其跳过,从而错过真正的最佳匹配。
如果能够获得每个簇的支持函数,那么就可以实现精确路由,因为每个支持函数都能精确量化该簇内任意键与查询匹配并取得高分的能力。这在图 2中有所展示,图中针对一个在嵌入空间中变化的查询,绘制了四个簇各自的支持函数。
图 2:依赖到质心的距离可能会产生误导,因为这些距离并未考虑每个簇中的每一个键。如果能够获得每个簇的支持函数,就可以根据给定查询与簇中任意键的匹配程度来进行分配。
基于这一理论洞见,我们提出用一个训练好的 SupportNet 联合学习这 k 个支持函数,该网络可以一次性输出 k 个分数。然后,我们可以用这 k 个分数中最大的那个来路由任何新的查询。SupportNet 模型能够回答一个比简单与质心比较更有用的问题:“对于这个查询,该簇内最佳的键有多好?”SupportNet 以经典的机器学习方式训练,也称为回归:我们生成从分布中采样的查询(通常是文本查询的嵌入),计算这些查询处的真实支持函数,并训练一个神经网络来复现这些值。
图 3:SupportNet 近似每个簇的支持函数,并基于与任意键的最佳匹配将查询分配到簇,而不仅仅是像典型几何方法那样只依赖质心。
我们在划分为 128 个聚类的 Natural Questions 数据集上,训练了规模递增的 SupportNet(XS、S、M 和 L → 分别为数据库大小的 1%、5%、10% 和 20%)。Natural Questions 是一个检索基准,它将常识性问题与来自大型文档数据库的段落配对,在我们的设置中约有 260 万个唯一段落。
下面的图 4展示了以召回率衡量的检索性能随不同成本概念的变化。路由召回率是指查询的真实分区(即包含精确最佳键的分区)落在路由器选择探测的分区之中的查询比例。对于这两张图,都会在与查询匹配的前 s 个聚类中执行穷举搜索,其中 s 按 2 的幂次增长 (1, 2, 4, 8, …, 128)。自然,当所有方法遍历全部 128 个聚类时,召回率都达到 1。
第一个标签页显示,对于固定的检索性能,学习型路由器能以比质心路由更低的延迟达到该性能。小型 SupportNet 模型达到 95% 路由召回率的速度比质心路由快约 1.9 倍(1.74 ms 对 3.36 ms),而大型模型的提升更大,它在 1.74 ms 内达到 97%。该图明确计入了运行我们的小型神经网络所带来的额外计算量,而非仅仅与质心进行比较。
第二个标签页的图仅关注路由质量,忽略了运行神经网络带来的开销。在固定的探索聚类预算下,它们更频繁地找到正确的分区:仅扫描数据库的 5%,学习型路由器就有约 90–93% 的概率恢复真实分区——中型(M)模型最高可达 92.6%——而质心基线为 87.5%。
SupportNet 路由器规模系列
图 4:不同规模 SupportNet 的路由性能(召回率)与延迟或我们允许路由器扫描的数据库比例之间的关系。所有路由器深度均为 16 层,在 128 聚类的 Natural Questions 数据集上训练。SupportNet 全面优于质心路由器:给定延迟目标,使用 SupportNet 可以获得更高的召回率;反之,与质心路由器相比,SupportNet 能以更低的延迟实现该召回率。
接入现有索引
SupportNet 路由取代了现有倒排文件索引(IVF)系统中基于质心的简单路由方式。借助 KeyNet,我们也可以保持 IVF 系统不变,只向它输入一个经过修改的查询。在这种情况下,KeyNet 自然地充当标准近似搜索索引前的*“查询重写器”*:预测最佳匹配在嵌入空间中可能出现的位置,然后让你常用的 IVF 系统从那里开始查找,而不是从原始查询开始。由于 IVF 索引经过高度优化,在 KeyNet 的辅助下,它能更快地找到结果。我们还依赖回归来训练 KeyNet,如图 5 所总结:将样本查询与其真实的最佳匹配键配对,并训练 KeyNet 神经网络来重现这种关联。
图 5:KeyNet 被训练用于将查询映射到其在数据库中的最佳匹配。与 IVF 索引结合使用时,通过这种映射对查询进行预处理会让搜索变得容易得多:转换后的查询现在离它要检索的目标近得多。
我们评估了规模递增的 KeyNet(XS、S、M 和 L → 数据库大小的 1%、5%、10% 和 20%),并在下面的图 6 中展示了这些不同规模的召回率–成本权衡。在第一个标签页中,搜索预算是实际耗时:使用最大的模型达到 99% 召回率所需时间最多可减少约 8 倍(0.23 毫秒,而原始查询为 1.8 毫秒)。和之前一样,第二个标签页只关注用 KeyNet 转换后的查询替换原始查询所带来的“质量”提升。x 轴是索引实际扫描的数据库比例:仅扫描数据库的 0.001%,经 KeyNet 映射的查询就能以 89–97% 的概率检索到真实键——最大模型(L)最高可达 96.7%——而原始查询为 86%;达到 99% 召回率所需扫描的键最多可减少约 11 倍(0.009% 对原始查询的 0.10%)。相同成本下获得更高召回率,或以一小部分成本获得相同召回率。
KeyNet 搜索器规模系列
图 6:使用 IVF 索引在基于 Natural Questions 数据集构建的数据库上进行搜索的性能(召回率)。图中对比了两种结果:直接用原始查询检索 IVF 索引,以及先用不同大小的 KeyNet 将查询映射后再执行搜索,所有 KeyNet 的深度均固定为 16 层。图中的延迟指映射查询并执行搜索所需的总时间,但原始查询的情况仅计入搜索时间。无论 KeyNet 规模大小,用 KeyNet 对查询进行预处理都是值得的:预处理开销会被下游更快的搜索所补偿。
我们展示了来自此前讨论过的同一 Natural Questions 数据集的示例,这些示例通过 FAISS IVF 索引提供服务。它是我们研究的多个数据集之一,且这一趋势在各数据集上保持一致。在整个搜索预算扫描范围内,用 KeyNet 预测的键查询索引始终优于用原始问题查询。
具体而言,下方的图 7 展示了五个 Natural Questions 示例:原始查询与 KeyNet 映射查询的前 3 条命中结果对比。
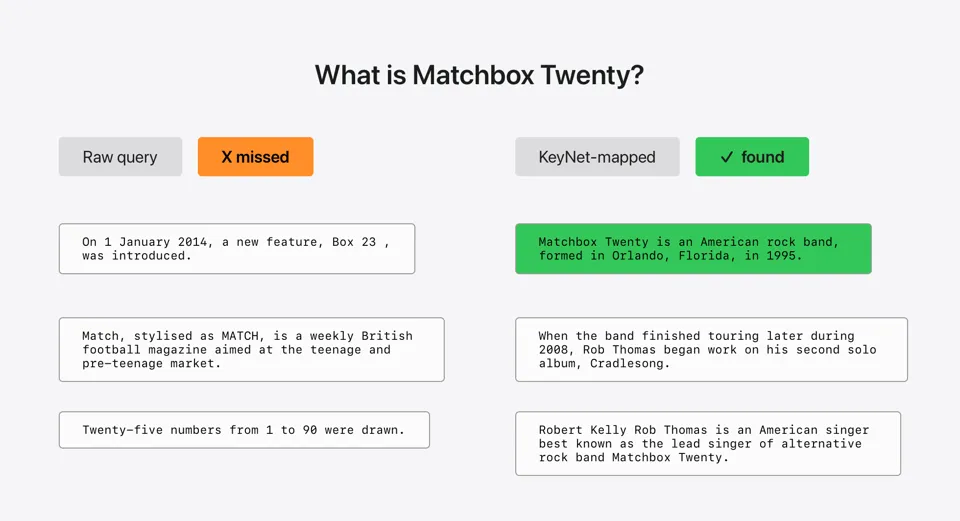
图 7:原始查询与 KeyNet 映射查询的前 3 条命中结果对比:“What is Matchbox Twenty?”
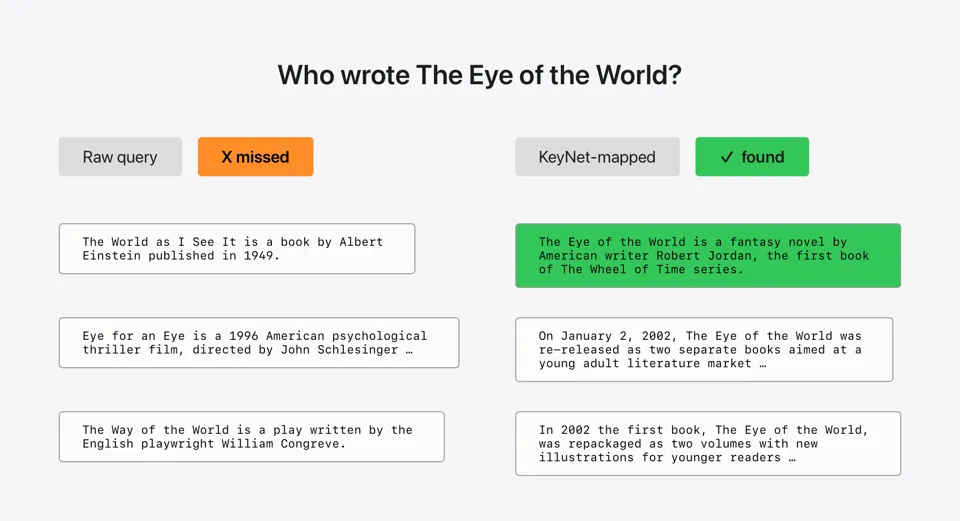
图 7:原始查询与 KeyNet 映射查询的前 3 条命中结果对比:“Who wrote The Eye of the World?”
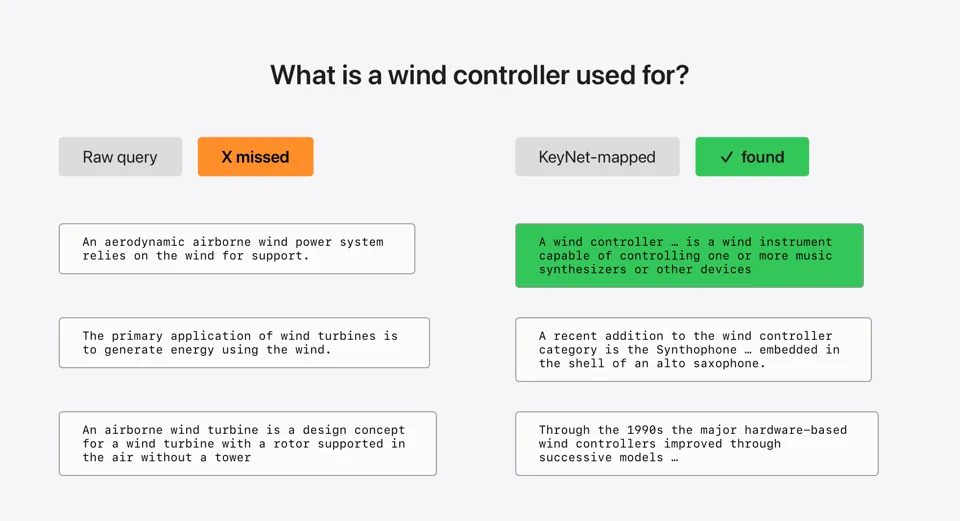
图 7:原始查询与 KeyNet 映射查询的 Top-3 命中结果对比:“What is a wind controller used for?”
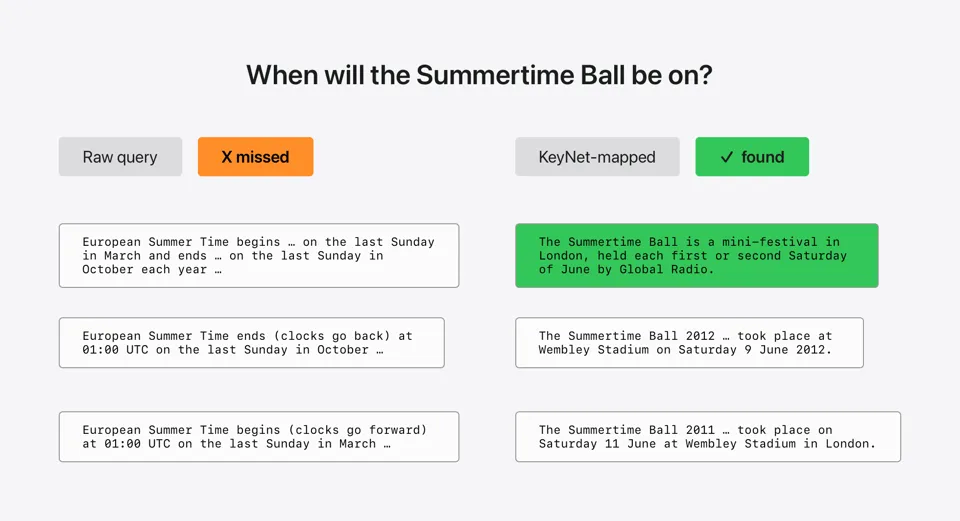
图 7:原始查询与 KeyNet 映射查询的 Top-3 命中结果对比:“When will the Summertime Ball be on?”
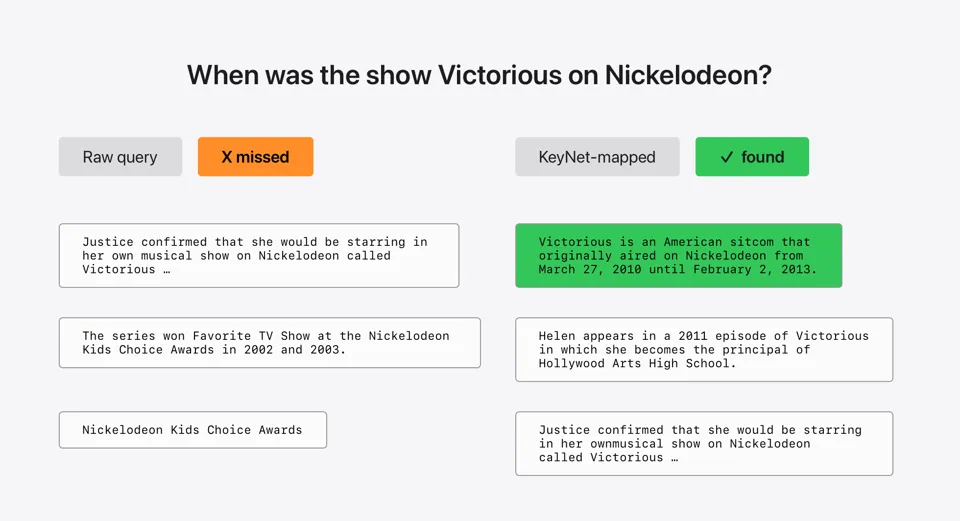
图 7:原始查询与 KeyNet 映射查询的 Top-3 命中结果对比:“When was the show Victorious on Nickelodeon?”
应该使用哪个网络?
两者之间的选择最终是一个实用性问题。当推理速度是瓶颈、且你只需要近似出最佳 key 时,使用 KeyNet。当你还需要一个经过校准的分数(用于重排序、阈值判断或下游使用),或者在较小模型规模下计算资源紧张时——在这种情形下 SupportNet 仍具竞争力——则使用 SupportNet。两者的训练方式相似,都能与现有的近似搜索基础设施集成,并且对查询模式中的轻度分布偏移具有较好的鲁棒性。最终,对于 key 集合极其庞大的超大规模 MIPS 系统,可能两者都需要:在所有聚类上训练一个 SupportNet 路由器,然后为每个聚类训练一个 KeyNet,帮助其常规索引更快地锁定最佳 key。
学习式检索的新方向
摊销式 MIPS 反映了当查询分布可预先获知时——这是生产 ML 系统中的常见情形——检索方法可以如何转变。通过将 MIPS 解直接编码进网络权重,该方法以一次性的训练(即所谓的摊销)成本换取快速、轻量的推理,并开辟了一条切实可行的路径,通向专门针对其所服务查询而定制的学习式检索系统。
相关阅读与更新。
[###
Amortizing Maximum Inner Product Search with Learned Support Functions](https://machinelearning.apple.com/research/amortizing-inner-product-search)
2026年7月2日研究领域 知识库与搜索,研究领域 方法与算法会议 ICML
最大内积搜索(MIPS)是机器学习中的一个关键子程序,其目标是在数据库(键)中找出与给定查询最对齐的向量。我们提出摊销式 MIPS:一种基于回归的方法,训练神经网络直接预测 MIPS 的解,从而将针对固定键数据库、从已知分布中抽取的查询反复求解 MIPS 的成本进行摊销。我们的关键洞见是……
阅读更多[###
使用 Wally 的可扩展隐私搜索](https://machinelearning.apple.com/research/wally-search)
2024年10月16日研究领域 隐私
本文提出 Wally,一种隐私搜索系统,支持针对大型数据库的高效语义和关键词搜索查询。当有足够多的客户端发起查询时,Wally 的性能显著优于以往的系统。在以往的隐私搜索系统中,对于每个客户端查询,服务器必须对每个数据库条目至少执行一次昂贵的密码学操作。因此,性能会下降……