OpenAI 发布 GPT-6 Cyber 可挖漏洞并给出修复方案
OpenAI 推出专为安全漏洞挖掘训练的 GPT-6 Cyber,能发现缺陷、构建可用漏洞利用并给出补丁建议。在定向测试中,该模型在 Firefox 中发现 81 个此前未知的严重漏洞且已被 Mozilla 修复,在 Linux 内核中复现 1724 个漏洞并为其中 948 个构建了可用利用,数量超过前代五倍。
报道正文
本文目录4 个章节
OpenAI 的 GPT-6 Cyber 既能入侵系统,也能提出修复方案
[Matthias Bastian](https://the-decoder.com/author/matthias-bastian/) [查看 Matthias Bastian 的 LinkedIn 个人资料](https://www.linkedin.com/in/matthias-bastian-128b71b1/) 2026年11月5日 
由 THE DECODER 提示生成的 Nano Banana Pro
要点
-
OpenAI 发布了 GPT-6 Cyber,这是一款专门训练用于发现安全漏洞、开发可用漏洞利用程序并提出补丁的 AI 模型。
-
在针对性测试中,GPT-6 Cyber 在 Firefox 中发现了 81 个此前未知的严重漏洞,Mozilla 已修复这些漏洞。
-
在 Linux 内核中,该模型复现了 1,724 个漏洞,并为其中 948 个开发出可用的漏洞利用程序,数量是其前代模型的五倍多。
文本 询问关于本文的问题… 搜索
OpenAI 推出了 GPT-6 Cyber,这是一款专门训练用于在软件中搜寻安全漏洞的 AI 模型。
OpenAI 表示,该模型能够发现缺陷、构建可用的漏洞利用程序并提出补丁。它还应能始终待在被划定的边界内,而这正是部分 OpenAI 模型近几个月来一直难以做到的事情。
该公司称,它训练 GPT-6 Cyber 遵守其操作护栏,所用手段之一是一个受 Hugging Face 事件启发的蜜罐。在没有任何特殊安全指令的情况下,GPT-6 Cyber 在 99.93% 的案例中避免了越界行为,高于其前代模型的 94.49%。在启用安全指令后,该模型在 100% 的测试中都保持在边界之内。总体而言,OpenAI 在其自身的准备框架中将 GPT-6 Cyber 的网络安全类别评级定为“严重”,这与它给“基础”模型 GPT-6 Astra 的评级相同。
在 ExploitGym 这一基准测试中——该测试用于评估模型能否利用远程系统中的给定漏洞——据 OpenAI 称,GPT-6 Cyber 的得分为 48.5%,而上一代 GPT-5.6 Cyber 为 32.1%。在一项针对在无法访问源代码的情况下寻找 Web 应用漏洞的新测试中,OpenAI 报告其命中率为 40.3%,而未经过网络安全训练的标准模型 GPT-6 Astra 为 32.0%。
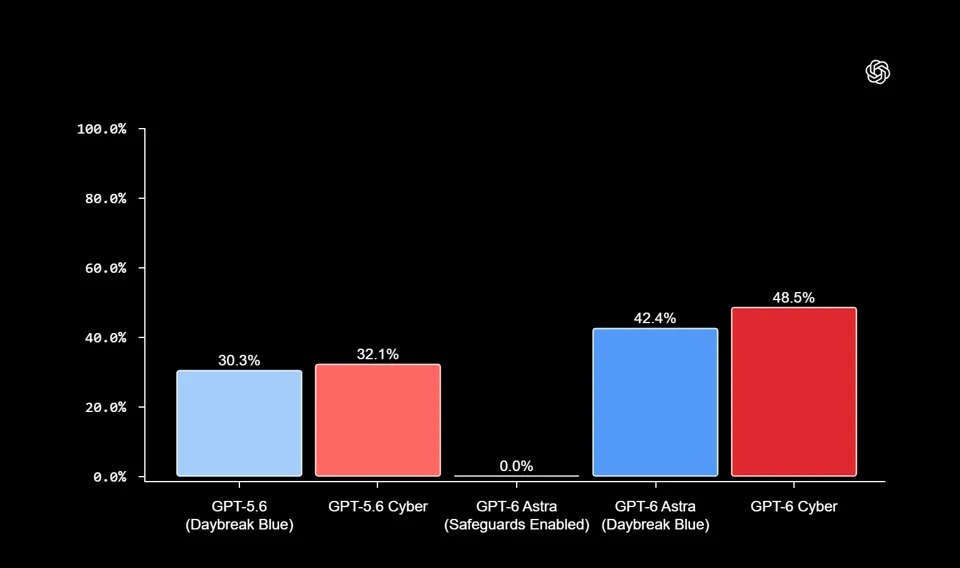
ExploitGym 结果:GPT-6 Cyber 以 48.5% 领先,其次是 GPT-6 Astra(Daybreak Blue),为 42.4%。启用防护措施的 GPT-6 Astra 得分为 0.0%。| 图片:OpenAI
完整结果可在系统卡中查看。所有基准测试数据均来自 OpenAI 自身。迄今为止,尚未有对该模型的独立测试结果公布。
GPT-6 Cyber 已在 Firefox 和 Linux 内核中发现真实漏洞
据 OpenAI 称,GPT-6 Cyber 已在真实世界的安全研究中取得成果。在一次针对性行动中,该模型在 Firefox 中发现了 81 个此前未知的严重漏洞,尽管该浏览器此前已用更早的 AI 模型进行过测试。该模型还表明,30 个已知问题的严重程度超出此前认知。Mozilla 已接受这些报告,并已发布修复程序。
据 OpenAI 称,在 Linux 内核中,GPT-6 Cyber 复现了 1,724 个安全漏洞,并为其中 948 个开发出可用的漏洞利用程序,是 GPT-5.6 Sol 在相同条件下所完成的 166 个的五倍多。该公司表示,已向 Linux 维护者报告了 304 项关键发现,并附上了建议的修复方案。
在Linux内核专项活动中,OpenAI构建了一套由侦察智能体和分析智能体组成的专用自动化系统。该系统首先扫描了内核中约5,034个与安全相关的位置,约占整个代码库的百分之七,随后将这些位置筛选至2,308个候选目标,并在隔离的虚拟机中确认了1,724个漏洞。在此基础上,系统开发出了OpenAI此前已报告的948个可用漏洞利用程序。据OpenAI称,整个运行过程在算力上花费了1,213,430美元,折算下来每个漏洞利用程序的成本为1,279美元。相比之下,Pwn2Own和TyphoonPWN等项目历来为同类发现支付的赏金在20,000至70,000美元之间。
OpenAI表示,这些智能体至少使用了十种此前连外部内核安全专家都不曾知晓的新型攻击技术。按照OpenAI的说法,模型不仅复现了已知的攻击模式,还找到了自己的方法。这一说法有多大分量,取决于你如何狭义地定义“自己的方法”。研究人员对于AI模型究竟能否真正做出新发现,还是仅仅对训练中见过的东西进行重新组合,仍存在分歧。
OpenAI目前仅向部分客户开放访问
据OpenAI称,GPT-6 Cyber初期通过API和Codex向Daybreak Red的一小部分精选客户提供。访问权限将逐步扩大到所有Daybreak Red客户。与此同时,GPT-5.6 Cyber向所有Daybreak Red用户开放,而针对GPT-6 Astra的Daybreak Blue alpha访问权限将扩展到更多组织和独立安全研究人员。
OpenAI承认,随着模型能力不断增强,滥用尝试也在增加。一些行为者和团体曾试图将模型能力迁移到自己的系统中。
OpenAI列出了若干应对措施:验证模型行为是否与用户权限相符的检查、针对新披露漏洞的定向监控、通过其所谓的Private Safety Processing进行的自动化安全检查、针对Daybreak Red的基于IP的访问限制,以及建议在有人工监督的隔离环境中运行该模型。
OpenAI 正在特别关注保护发电厂和水处理设施等关键基础设施。为了让防御者更容易获取支持,该公司提到了其十亿美元的"Daybreak for Frontline Defenders"资助计划,以及一个名为"Daybreak Red for Critical Infrastructure"的新子小组,用于授权测试。
OpenAI 谈到存在一个有限的窗口期,在此期间可以利用顶级模型来保障软件安全。其目标是让 Daybreak 计划扩展到各种规模的组织、独立研究人员和开源维护者。这是否真的可行则是另一个问题。Epoch AI 的研究人员刚刚展示,开放的 GLM 模型本可以利用已知但尚未修补的 Firefox 漏洞。