The Decoder · 2026/10/17 18:33:28
DeepSeek V4.1 Flash 发布,智能体任务性能超越更大模型且成本大幅降低
DeepSeek 发布开源模型 V4.1 Flash-1017,在智能体和编码任务中以更低成本超越更大竞品。该版本采用自反馈强化学习(RLSF)进行后训练,无需人工评估即可提升端到端项目开发能力,并首次向开发者开放内部搜索引擎 API。
报道全文原始报道全文
本文目录2 个章节
中国 AI 公司 Deepseek 发布了其 Flash 模型的更新版本,在智能体(agentic)和编程任务上取得了显著进展。该公司还首次向外部开发者开放了其内部搜索引擎。
DeepSeek-V4.1-Flash-1017 现已通过该公司的网站、应用程序和 API 提供。Deepseek 还在 Hugging Face 和 ModelScope 上以开源形式发布了模型权重。与其直接前代相比,该模型在基准测试中得分更高,任务完成速度更快,且输出内容更精简。公司将此次更新称为性能与成本权衡中的帕累托改进(Pareto improvement)。
为了从零开始构建完整的软件项目,Deepseek 采用了带自我反馈的强化学习(RLSF)。这种后训练方法允许模型利用其内部的置信度分数或自生成的批评作为奖励信号。这消除了对人类评估者或外部奖励模型的需求。Deepseek 表示,该方法改进了从游戏编程到 3D 建模以及设计工作等各类任务的端到端项目开发能力。该模型还能生成紧凑的解释性视频动画,类似于最近发布的 Opus 5.5。
该模型针对 Deepseek Harness(推荐 v0.2.1-rc.1 或更高版本)、Tencent CodeBuddy 和 WorkBuddy 等开发环境进行了调优。
较小的 Flash 模型在编程和智能体任务上击败更大的竞争对手
在 Deepseek 自己的基准测试中,V4.1-Flash-1017 的表现优于其前代 V4.1-Flash。它在多个编程和 AI 智能体类别中也击败了 Claude Opus 5、GPT 5.6-Sol、Kimi K3 和 GLM 5.3 等更大的竞争模型。
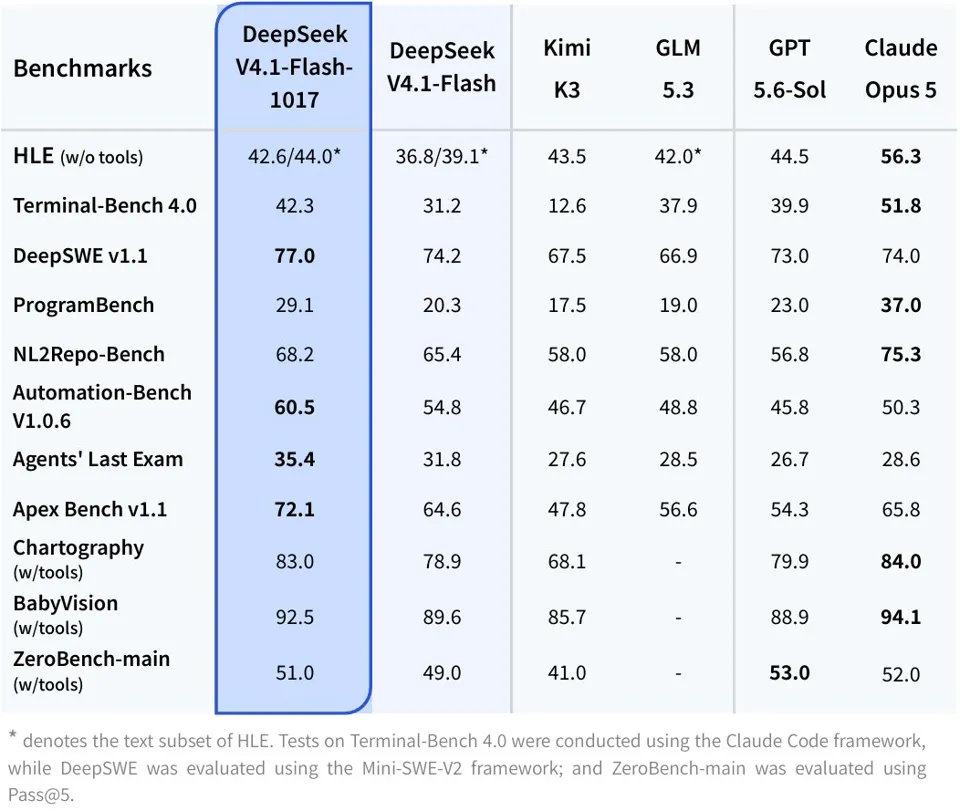
DeepSeek V4.1-Flash-1017 在所有测试类别中均优于其前代。| 图片:Deepseek
DeepSWE 基准测试的成本图表展示了更短的输出对效率的影响。V4.1-Flash-1017 以每任务平均略低于 0.10 的成本达到 72% 的分数。其前代模型得分为 74.2%,但每次运行的成本约为 $0.50。
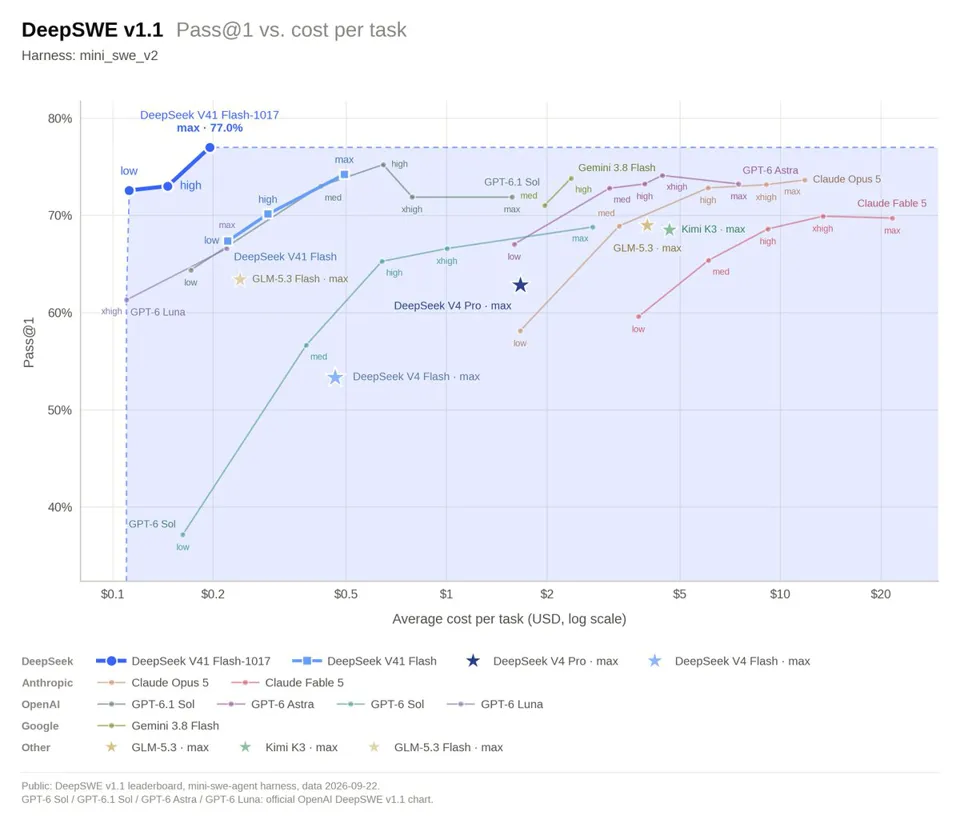
在每个 agentic coding 任务的平均成本上,Flash 模型大幅低于竞争对手。| 图片:Deepseek
GPT-6 Astra、Gemini 3.8 Flash 和 Claude Opus 5 等竞争对手模型在此图表中的成本介于每个任务 10 之间,且它们的准确率均无法与较小的 Deepseek 模型相媲美。独立的基准测试结果尚未发布,而且基准测试本身也只反映了情况的一半。例如,开发者对代码质量的印象可能与基准测试结果大相径庭。
Deepseek 将其内部搜索引擎转化为公共 API
除了语言模型外,Deepseek 还向所有开发者开放了其网络搜索工具(Search & Fetch APIs)。该公司表示,这些服务运行在其内部构建的搜索引擎上,该引擎每天已处理全球数亿次查询。设置详情见 API 文档。
每个端点的费用为每 1,000 次调用 $0.75。Deepseek API 用户可通过 Deepseek Harness、Claude Code 和 Codex 中的服务器端工具免费使用这些功能,直至 2026 年 10 月 31 日(UTC 时间下午 4)。
不过,将中国 AI 模型深度集成到工作流中这一做法的吸引力昨天有所下降。据 报道,中国政府计划收紧关于发布 open-weight 模型的规则,甚至可能完全阻止其发布。其中一个决定因素是特定系统是否位列能力最强的前 10 名模型之中。