清华微软提出 HarnessMM:智能体预规划跳过冗余 LLM 调用,Token 省近九成
原标题:New Tsinghua and Microsoft paper finds that DeepSeek Harness used 87.93% fewer tokens than its origi...
78AI 研判分
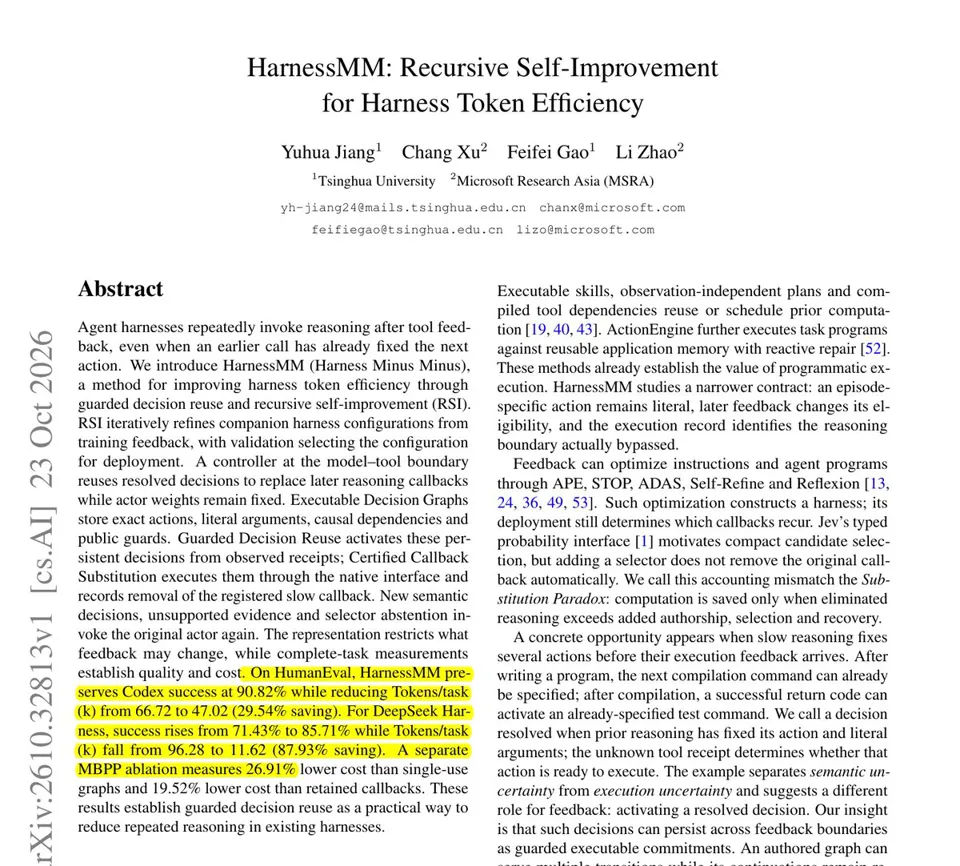
清华大学与微软联合研究提出 HarnessMM 框架,通过让模型预先编写带校验条件的后续命令序列,在工具结果满足条件时直接执行而无需再次调用 LLM。实验显示该方法在 HumanEval 任务上使 DeepSeek Harness 的 Token 消耗降低 87.93%,同时成功率从 71.43% 提升至 85.71%,显著优化了智能体的推理效率与成本。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-02 08
清华大学与微软的新论文发现,在 98 个 HumanEval 任务中,DeepSeek Harness 相比其原始版本减少了 87.93% 的 Token 使用量,同时成功率从 71.43% 提升至 85.71%。
Codex 和 DeepSeek Harness 等 Agent 工具通常在每次获取工具结果后调用 LLM 以决定下一步操作。然而,这一步骤往往早已确定,例如代码编译成功后运行测试。
HarnessMM 允许模型预先编写带有精确参数的未来命令,并为每个命令设置检查条件(如构建成功)。当工具结果通过检查时,Agent 直接执行该命令并跳过 LLM 调用。
在 98 个 HumanEval 任务上,Codex 保持了 90.82% 的成功率,同时比标准 Codex 少用了 29.54% 的 Token。DeepSeek Harness 的成功率从 71.43% 提升至 85.71%,且比原始版本少用了 87.93% 的 Token。
如果你的 Agent 执行的是可预测的流程链(如编写、构建、测试),不妨让模型一次性规划好这些步骤并附带通过性检查,而不是每一步都重新询问模型。