Google 发布 EmbeddingGemma 2 端侧多模态嵌入模型
Google 开源了基于 Gemma 4 的 EmbeddingGemma 2,这是一个支持文本、代码、图像、音频和视频的统一向量空间嵌入模型。该模型参数量仅 744M,在 Pixel 11 Pro 上全量运行仅需约 567MB 内存,性能超越许多大 2-12 倍的模型,显著提升了端侧隐私搜索能力。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-29 04
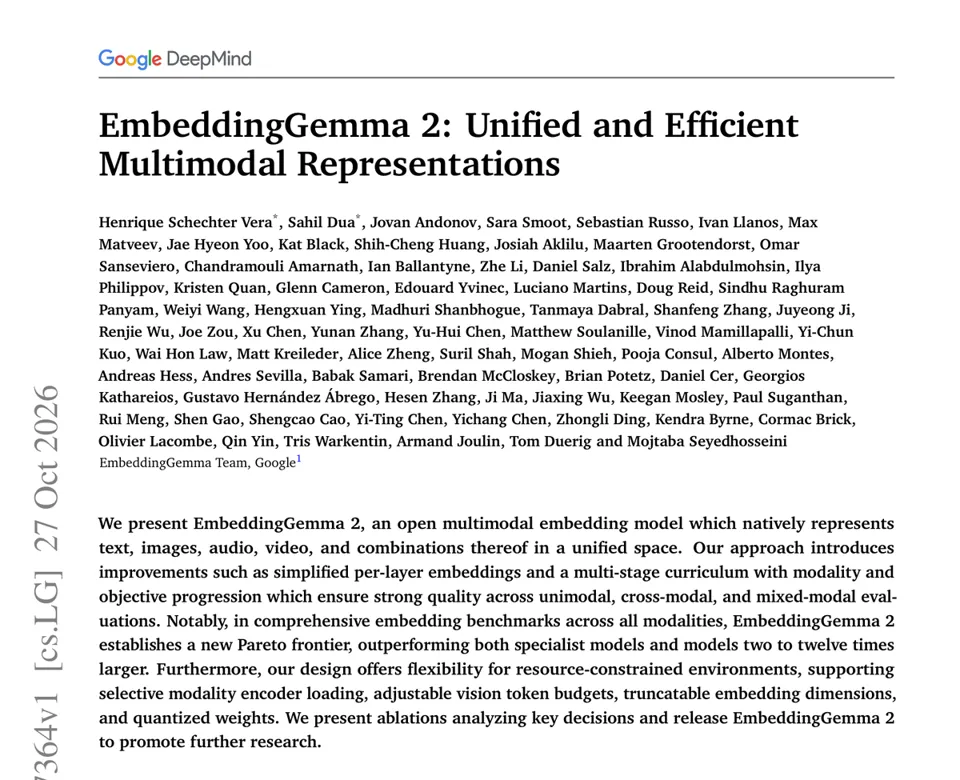
Google 发布了其 EmbeddingGemma 2 论文。
这是一款用于端侧多模态 AI 的嵌入模型,采用 Apache 2.0 许可证发布。
将文本、代码、图像、音频和视频映射到手机上的同一个可搜索空间。这为手机补上了缺失的一块:无需将数据发送至服务器,即可理解和搜索你自己的内容。
表明一个拥有 7.44 亿参数的开源模型可以对文本、图像、音频和视频进行嵌入处理,性能优于许多参数量大 2 到 12 倍的模型。
在 Pixel 11 Pro 上,量化后的文本权重约占 191MB 的活动内存,完整的多模态模型约占 567MB。
上下文窗口扩大 4 倍至 8K tokens,足以容纳约 5.5 分钟的音频、29 张图片或单次输入中的 58 个视频帧。
他们基于 Gemma 4 构建了 EmbeddingGemma 2,通过模仿更大的 Gemini Embedding 2 进行训练,随后使用对比学习进行微调。所有媒体类型共享同一个向量空间,且在 Pixel 11 Pro 上使用 4-bit 权重时,完整模型仅占用 567 MB 内存。
直接对语音进行嵌入的效果优于先转录再嵌入,在 MSEB 口语查询检索基准测试中得分分别为 69.54 和 57.59。代码搜索在 MTEB Code 上的得分为 78.68,较 EmbeddingGemma 1 的 68.76 有显著提升。