vLLM 官方博客 · 2026/10/23 08:00:00
GLM-5.3 优化:PCP/DCP 与 HiSparse 实现百万上下文
针对 GLM-5.3 在 H200 集群上服务长上下文智能体工作负载时的显存与预填充瓶颈,团队提出了基于 Prefill Context Parallelism (PCP) 和 Decode Context Parallelism (DCP) 的分离式架构。结合 Hybrid HiSparse 技术将 KV 缓存卸载至主机内存,该方案在保持同等吞吐量下实现了 1.7–3.2 倍的单用户推理速度提升,并成功支持 100 万 token 的超长上下文。
报道全文原始报道全文
本文目录9 个章节
TL;DR: 长智能体上下文使 GLM-5.3 在 H200 上面临两大限制:KV 缓存内存和预填充速度。我们在 16 张 H200 上解决了这两个问题,将其拆分为一个预填充节点和一个解码节点:
- 预填充上下文并行(PCP) 按 token 而非按 head 将每个提示词拆分到多个 GPU 上,这比张量并行更适合 GLM-5.3 的稀疏注意力机制。
- 解码上下文并行(DCP) 按 token 对预填充引擎的 KV 缓存进行分片,从而使 1M 上下文能够容纳在预填充节点上。
- 混合 HiSparse 允许解码阶段将 KV 保留在主机内存中,从而支持 1M token 的请求。
- 在 AgentX 上,采用 PCP8 × DCP8 预填充配合混合 HiSparse 解码,在相同吞吐量下,每用户速度是数据并行部署的 1.7–3.2 倍,且这是我们测试过的唯一能服务 1M token 上下文的配置。
在内存受限的部署中服务长上下文
智能体工作负载具有随每一轮对话增长的长上下文,这对 GPU 内存和预填充都造成了压力。在 H200 上,GLM-5.3 的权重占据了每张 GPU 的大部分内存,留给这些长上下文 KV 缓存的空间所剩无几。此外,由于每一轮都会向预填充中添加更多的工具输出和文件内容,在高负载下,预填充引擎可能成为整个部署的瓶颈。
第 1 部分展示了混合 HiSparse 如何让长上下文适应单个 8× H200 节点上的聚合部署。预填充/解码分离需要的不仅仅是这一点。在预填充节点上,我们使用 PCP 通过在提示词的 token 之间进行并行化来加速长提示词。然而,结合 MLA 时,这会导致每个 PCP rank 持有 KV 缓存的完整副本,因此我们将它与 DCP 结合以消除这种复制。在解码节点上,混合 HiSparse 允许在长上下文情况下实现更高的并发度。vLLM 新的模块化核心(Model Runner V2)使得组合所有这些功能变得更加容易。
为什么不用 TP 或 DP?
在 8× H200 节点上运行 GLM-5.3 预填充的两种标准方式是 DP8 和 TP8:
- DP8 将每个 prompt 分配给单个 GPU,因此其注意力机制无法利用其他七个 GPU。这限制了长 prompt 的首 token 生成时间(TTFT),且该 prompt 的 KV cache 必须容纳在该 GPU 的显存中。
- TP8 将注意力头(attention heads)分区到各个 GPU 上。由于 MLA 的潜在 KV cache 由全部 64 个头共享,每个 GPU 都存储完整的 cache,但仅读取用于服务其中的 8 个头。索引器(indexer)负责对所有先前 token 进行评分以选择稀疏 MLA 关注的 2,048 个 token,它并未被分区,因此其二次方复杂度在每个 GPU 上重复执行。
这两种方案都无法在不让每个服务 GPU 保留完整 KV cache 的情况下,将单个长 prompt 的注意力计算分散到八个 GPU 上。接下来的两节分别解决这两个问题:PCP 将 prompt 的查询(queries)拆分到各 GPU,而 DCP 则拆分其 KV cache。
PCP:按 token 拆分,而非按 head 拆分
在我们的 8× H200 prefill 引擎中,PCP 按 token 将每个 prompt 拆分到八个 GPU 上:每个 GPU 计算 prompt 八分之一的 queries,涵盖全部 64 个头。简单的拆分方式会导致负载不均。在因果注意力(causal attention)下,一个 token 需要关注其之前的所有 token,因此持有 prompt 末尾部分的 GPU 会比持有开头部分的 GPU 承担多得多的工作。PCP 转而将 prompt 切分为 16 个块并进行配对:GPU 取前部的一个块和后部的一个块,从而确保每个 GPU 获得相同比例的“廉价”和“昂贵”token(图 3 展示了这种在八个 GPU 上的 V 形模式)。这就是来自 Context Parallelism for Scalable Million-Token Inference 的负载均衡分片策略。最后,通过 all-gather 操作收集每个 GPU 新生成的 KV,使得每个 query 仍能关注完整的上下文。
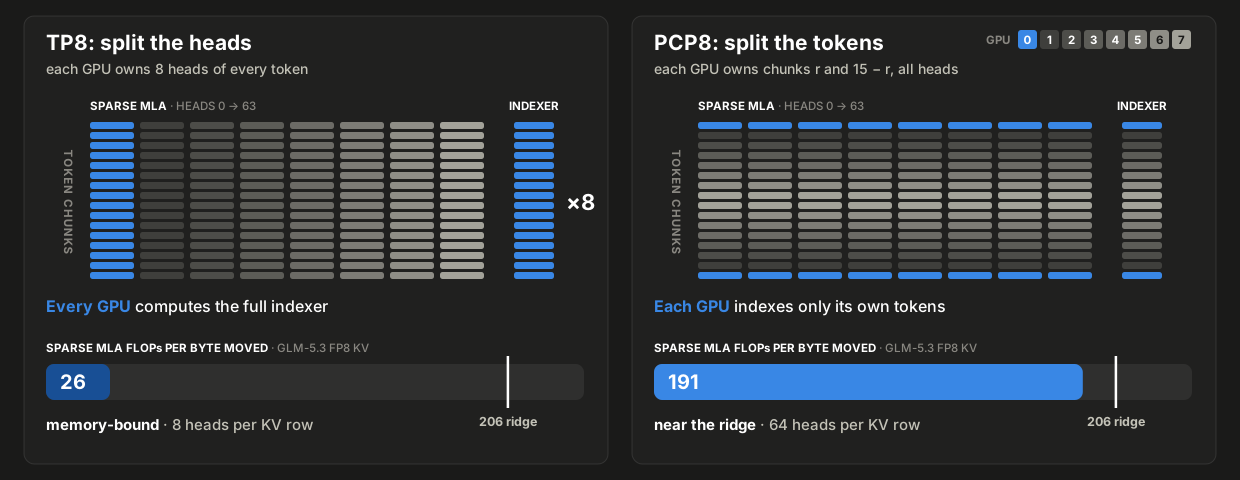
图 1. 在 TP8 和 PCP8 下,8 个 GPU 上的单次 prefill,颜色深浅表示拥有各部分数据的 GPU。柱状图显示稀疏 MLA 的算术强度;线条标记了 H200 在 BF16 精度下转为计算受限(compute-bound)的位置。
对于长 Prefill 而言,避免复制 Indexer 至关重要。Indexer 的成本随 Prompt 长度呈二次方增长,而稀疏 MLA(Sparse MLA)的成本仅呈线性增长,因为每个 Query 只关注固定的 2,048 个 Token。在从零开始计算 Prefill 的 FLOPs 时,当 Prompt 达到约 32K Token 时,Indexer 的成本在 TP8 下会超过稀疏 MLA;而在 PCP8 下,由于没有 GPU 复制该组件,这一交叉点推迟到约 256K Token。
综合来看,这使得 PCP 非常适合用于长 Prompt 的 Prefill。但 PCP 仍存在两项成本。首先,每块 GPU 都持有全部注意力权重,而 MoE 专家模型则通过 EP8 分布在八块 GPU 上。其次,由于每一层都需要对新的 KV 进行 All-Gather 操作,每块 GPU 最终仍需存储完整的 KV Cache。限制上下文长度的并非计算资源,而是这种被复制的缓存,而这正是 DCP 所要解决的问题。
DCP:也对 KV Cache 进行分片
一个包含 1M Token 的 GLM-5.3 请求需要 53.4 GiB 的 FP8 KV 3,但每块 GPU 仅有约 15 GiB 的空间。解码上下文并行(DCP)通过拆分缓存本身来解决这一问题:Token 以轮询方式分配给八块 GPU,因此每块 GPU 只存储每第八个 Token,同一请求在每块 GPU 上仅需 6.7 GiB(=53.4/8)。图 2 将其与 DP8 和 TP8 进行了对比。
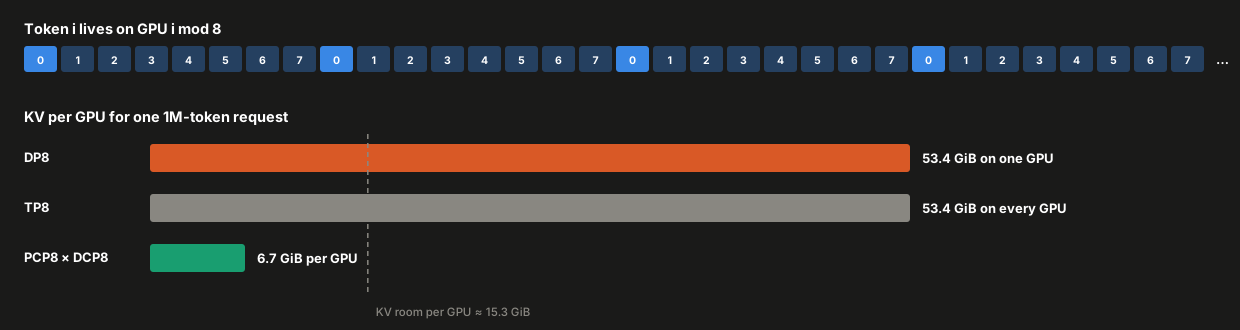
图 2。TP 复制了 MLA 的潜在 KV,因此八块 GPU 并未带来额外空间。DCP 将其除以八。
注意: PCP 拆分 Queries;DCP 拆分 KV。 这些名称源于历史原因。DCP 最初是为解码(Decode)设计的,在该阶段每个请求只有一个 Query Token,因此 KV Cache 是唯一值得拆分的对象。PCP 则是为预填充(Prefill)设计的,在该阶段 Prompt 中的大量 Query Token 构成了主要工作负载。我们的配置在 Prefill 引擎中同时运行这两者。
由于这种分片机制,每块 GPU 上的 Queries 所需的绝大部分 KV 现在位于其他 GPU 上。在解码阶段,DCP 将 Queries 发送到 KV 所在处:每块 GPU 在其自己的分片上进行注意力计算,并通过 Log-Sum-Exp 合并部分结果。而在本 Prefill 引擎中,做法相反:每一层,每块 GPU 将所有分片 All-Gather 到一个临时的全上下文副本中,针对其自身的 Queries 执行注意力计算,然后释放该副本。只有持久化的缓存被除以八进行分布。
图 3 将所有内容整合在一起。逐步剖析 PCP8 × DCP8 架构中的某一层,观察每个 GPU 存储哪些 KV、计算哪些 Query,以及哪些数据需要跨越互联总线传输。切换至 DP8、TP8 或 PCP8 模式可进行对比。请注意,这两种布局并不对齐:GPU 存储每第八个 token,但计算的是特定 chunk 的 query,这正是每一层都需要执行 all-gather 操作的原因。
这种 all-gather 操作并非零成本:每一层都要重新发送整个缓存上下文,因此其开销随上下文长度增长而增加。图 4 通过在同一台 PCP8 节点上运行相同的 2K-token prefill chunk(分别在启用和禁用 DCP8 的情况下,且保持相等的缓存上下文)来隔离这一开销。在上下文达到 64K tokens 之前,DCP8 每步增加约 6% 的开销;而在 248K tokens 时,这一比例上升至 15%。这就是获得 8 倍更大 KV 池所付出的代价。我们可以通过将每一层的 all-gather 与上一层的计算进行重叠来降低此开销,这是我们目前正在进行的优化工作。
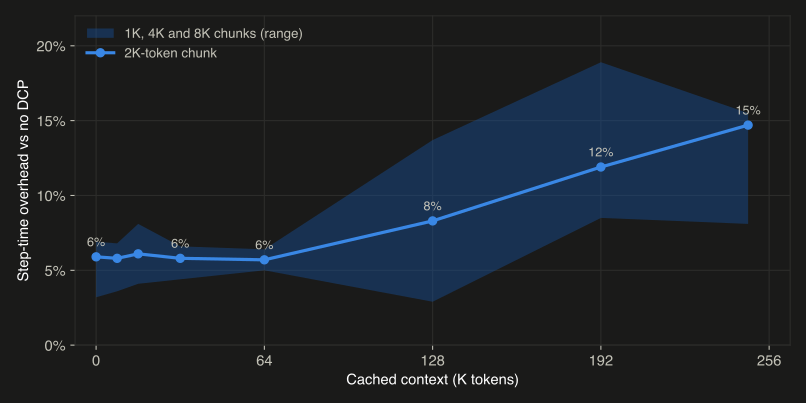
图 4. 在一台 8× H200 PCP8 引擎上,针对 2K-token chunk 的 DCP8 每步开销。阴影区域涵盖了 1K、4K 和 8K 的 chunk 大小。
当上下文超过大约 250K tokens 时,仅靠 PCP8 无法容纳 KV 缓存;在这种情况下,DCP 不再是额外的开销,而是使长 prompt 成为可能的关键因素。PCP8 × DCP8 的组合赋予了 prefill 引擎速度与容量双重优势。
部署方案
我们在两个 8× H200 节点上将其作为 Prefill/Decode (P/D) 分离式部署提供服务。两个引擎均使用 FP8 KV 缓存和带有三个 draft token 的 MTP 推测解码(MTP3):
- Prefill: 一个 PCP8 × DCP8 × EP8 引擎,配备 512 GiB 的 CPU KV 卸载空间,以便后续轮次复用前缀。
- Decode: 八个 DP rank,采用 EP8 以及来自 第一部分 的 Hybrid HiSparse(每个 rank 拥有 48 GiB 主机内存池 + 16 GiB 卸载空间),因此 decode 并发度受限于主机内存而非 HBM。
一个具备前缀感知能力的 llm-d 路由器将每个请求发送至 prefill 引擎,NIXL 连接器将其 KV 缓存移动到一个 decode rank,随后该 decode rank 流式返回生成的 token。
我们将 PCP8 × DCP8 预填充(prefill)与 DP8 预填充(八个 DP rank,每个配备 EP8 和 64 GiB CPU KV 卸载,总计相同的 512 GiB)进行对比;同时在解码节点上,将 Hybrid HiSparse 与纯 CPU KV 卸载进行对比,两种方案均使用相同的 512 GiB 主机内存(HiSparse 方案为 8 × 48 GiB HiSparse 池 + 8 × 16 GiB 卸载)。所有配置均使用相同的 16 块 GPU、主机内存以及 vLLM 构建版本。
结果
我们运行了 SemiAnalysis AgentX 基准测试:重放带有前缀复用的 Claude Code 轨迹,每个并发级别启动一个新服务器,运行时长为一小时,并采用 MTP3,其合成接受长度固定为 2.99,从而确保每种配置获得相同的推测加速比。吞吐量以每 GPU 的逻辑 tok/s 衡量(包含缓存部分):即输入加输出 token 数,计入前缀缓存的输入,除以全部 16 块 GPU。交互性指标采用 AgentX 的 P90 E2E 归一化每用户输出 tokens/s,对应图 5 的横轴。
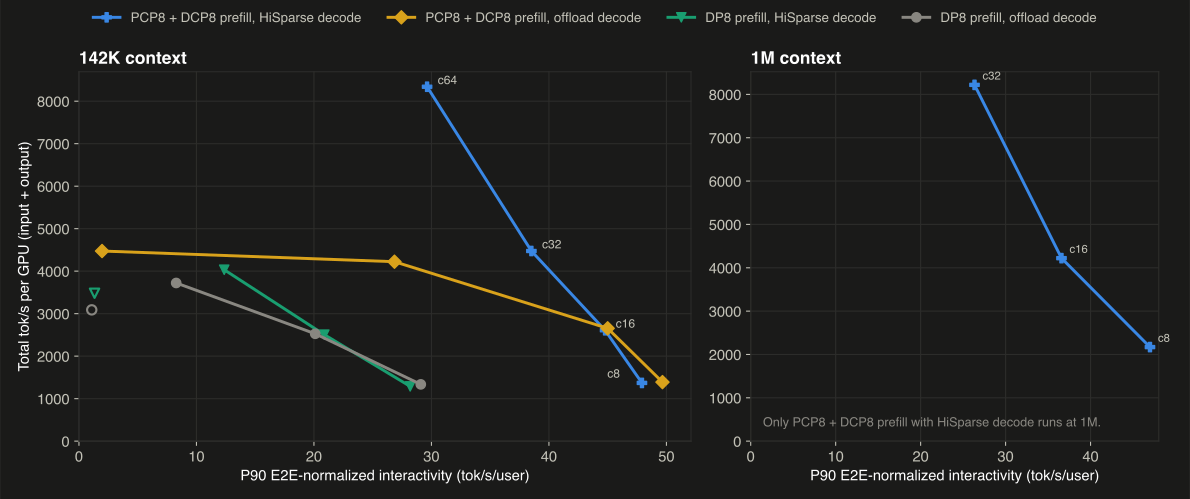
图 5。每个并发级别一个数据点,均在新的部署上运行,涵盖两个上下文限制:142K 下的 c8–c64 和 1M 下的 c8–c32。标签显示的是采用 HiSparse 解码的 PCP8 × DCP8 预填充配置的并发度;其他配置从右至左运行相同的并发度。空心点表示偏离各自配置的帕累托前沿。
在 c32 及以下时,部署主要受预填充瓶颈限制,因此预填充器的影响更大。在两种设置中均采用 HiSparse 解码的情况下,PCP8 × DCP8 预填充在相同吞吐量下提供了 DP8 的 1.7–3.2 倍交互性,并将中位 TTFT 从 1.5–5.2 秒降低至 0.8–0.9 秒。在此负载下,解码器差异不大:在 c8 和 c16 时,两种 PCP8 × DCP8 配置之间的差距仅在几个百分点以内,且在 c8 时仅使用卸载的解码略占优势。
从 c32 开始,部署逐渐转为受解码瓶颈限制,此时 HiSparse 解码展现出优势。在 c64 时,其吞吐量几乎翻倍,达到 8,340 logical tok/s/GPU,同时保持 29.6 tok/s/user 的用户体验,而其他所有配置的用户体验均降至 1–2 tok/s/user。
在 1M 上下文长度下,部署需要同时具备这两项能力。一个 DP8 prefill rank 无法容纳单个 1M-token 的请求,仅依靠 offload 的 decode rank 同样也无法做到。
实现特性组合
vLLM 中极具挑战性的工作之一,就是让此类特性能够相互组合。每个特性都会改变 KV cache 的布局、调度或移动方式,而所有组合都必须保持正确且高效。
对于 P/D(Prefill/Decode)分离架构,KV cache 需要在两个引擎之间转换布局。Prefill 引擎按 token 将每个请求的 KV 分片到八张 GPU 上。每个 decode rank 则需要在其自身的分页布局中获取完整的 KV,包括 MTP 层的 KV。NIXL connector 负责在两个节点之间完成这一重组过程,同时来自 CPU offload 的前缀复用机制也必须与之协同工作。
此处的每种配置均运行在 Model Runner V2 之上。它将模型特定状态从通用执行路径中隔离出来,并在无需 CPU–GPU 同步的情况下运行 speculative decoding。Hybrid HiSparse 正是基于此构建的。
试用体验
所有内容均可在 vLLM v0.32.0 或更高版本(vllm/vllm-openai:v0.32.0 镜像)上运行。上述结果是在 vLLM main 分支的 9e38b4111a 提交上测得的。复现 gist 固定使用了 2537629eb2 提交。Prefill 引擎的关键标志如下:
--prefill-context-parallel-size 8 \
--decode-context-parallel-size 8 \
--dcp-comm-backend ag_rs \
--enable-expert-parallel \
--attention-config '{"sparse_mla_force_mqa":true}'
若不使用 sparse_mla_force_mqa,那些 prompt 长度在 2,048-token top-k 范围内的 prefill batch 会走 dense MHA 路径。该标志强制它们也使用 sparse-MLA (MQA) kernel,从而确保每一行 KV 都能服务于所有 head。
致谢
这项工作由 Roberto L. Castro (Red Hat)、Simon Veitner (Red Hat)、Matthew Bonanni (Red Hat)、Lucas Wilkinson (Red Hat) 以及 Nicolò Lucchesi (Mistral) 共同完成。我们要感谢 Maroon Ayoub (Red Hat) 和 Robert Shaw (Red Hat) 对部署进行了压力测试、报告错误并修复了 bug。