Interconnects (Nathan Lambert) · 2026/10/17 22:06:54
Meta 发布 Muse Spark Open,美国开源模型重夺前沿地位
Meta 推出 Muse Spark Open,成为目前性能最强的美国开源权重模型,显著缩小了与中国顶尖开源模型的差距。与此同时,Reflection AI 的 Beam 和 Mistral Large 4 也相继亮相,标志着西方开源生态在前沿能力上实现实质性突破。
报道全文原始报道全文
本文目录3 个章节
本周,美国开源权重模型与前沿模型的差距显著缩小。Meta 率先发力,推出了 Muse Spark Open,这款模型目前以较大优势成为最强的美国制造开源模型;此外,Reflection 的首款模型 Beam 也值得关注。若没有这两款模型,由中国企业构建并发布的 20 多款开源权重模型将全面超越西方最佳模型。截至本文撰写时,Mistral 还发布了一款强劲模型 Mistral Large 4,其指数得分为 38(见下文),但尚未开放权重。据传,还有其他机构即将推出几款强大的美国开源权重模型!
在许多方面,美国与中国最佳模型之间的差距已缩小约一半。此前,对于追求极致性能的用户而言,美国最佳开源模型几乎毫无竞争力;如今,它们虽仍落后,但已具备相关性。
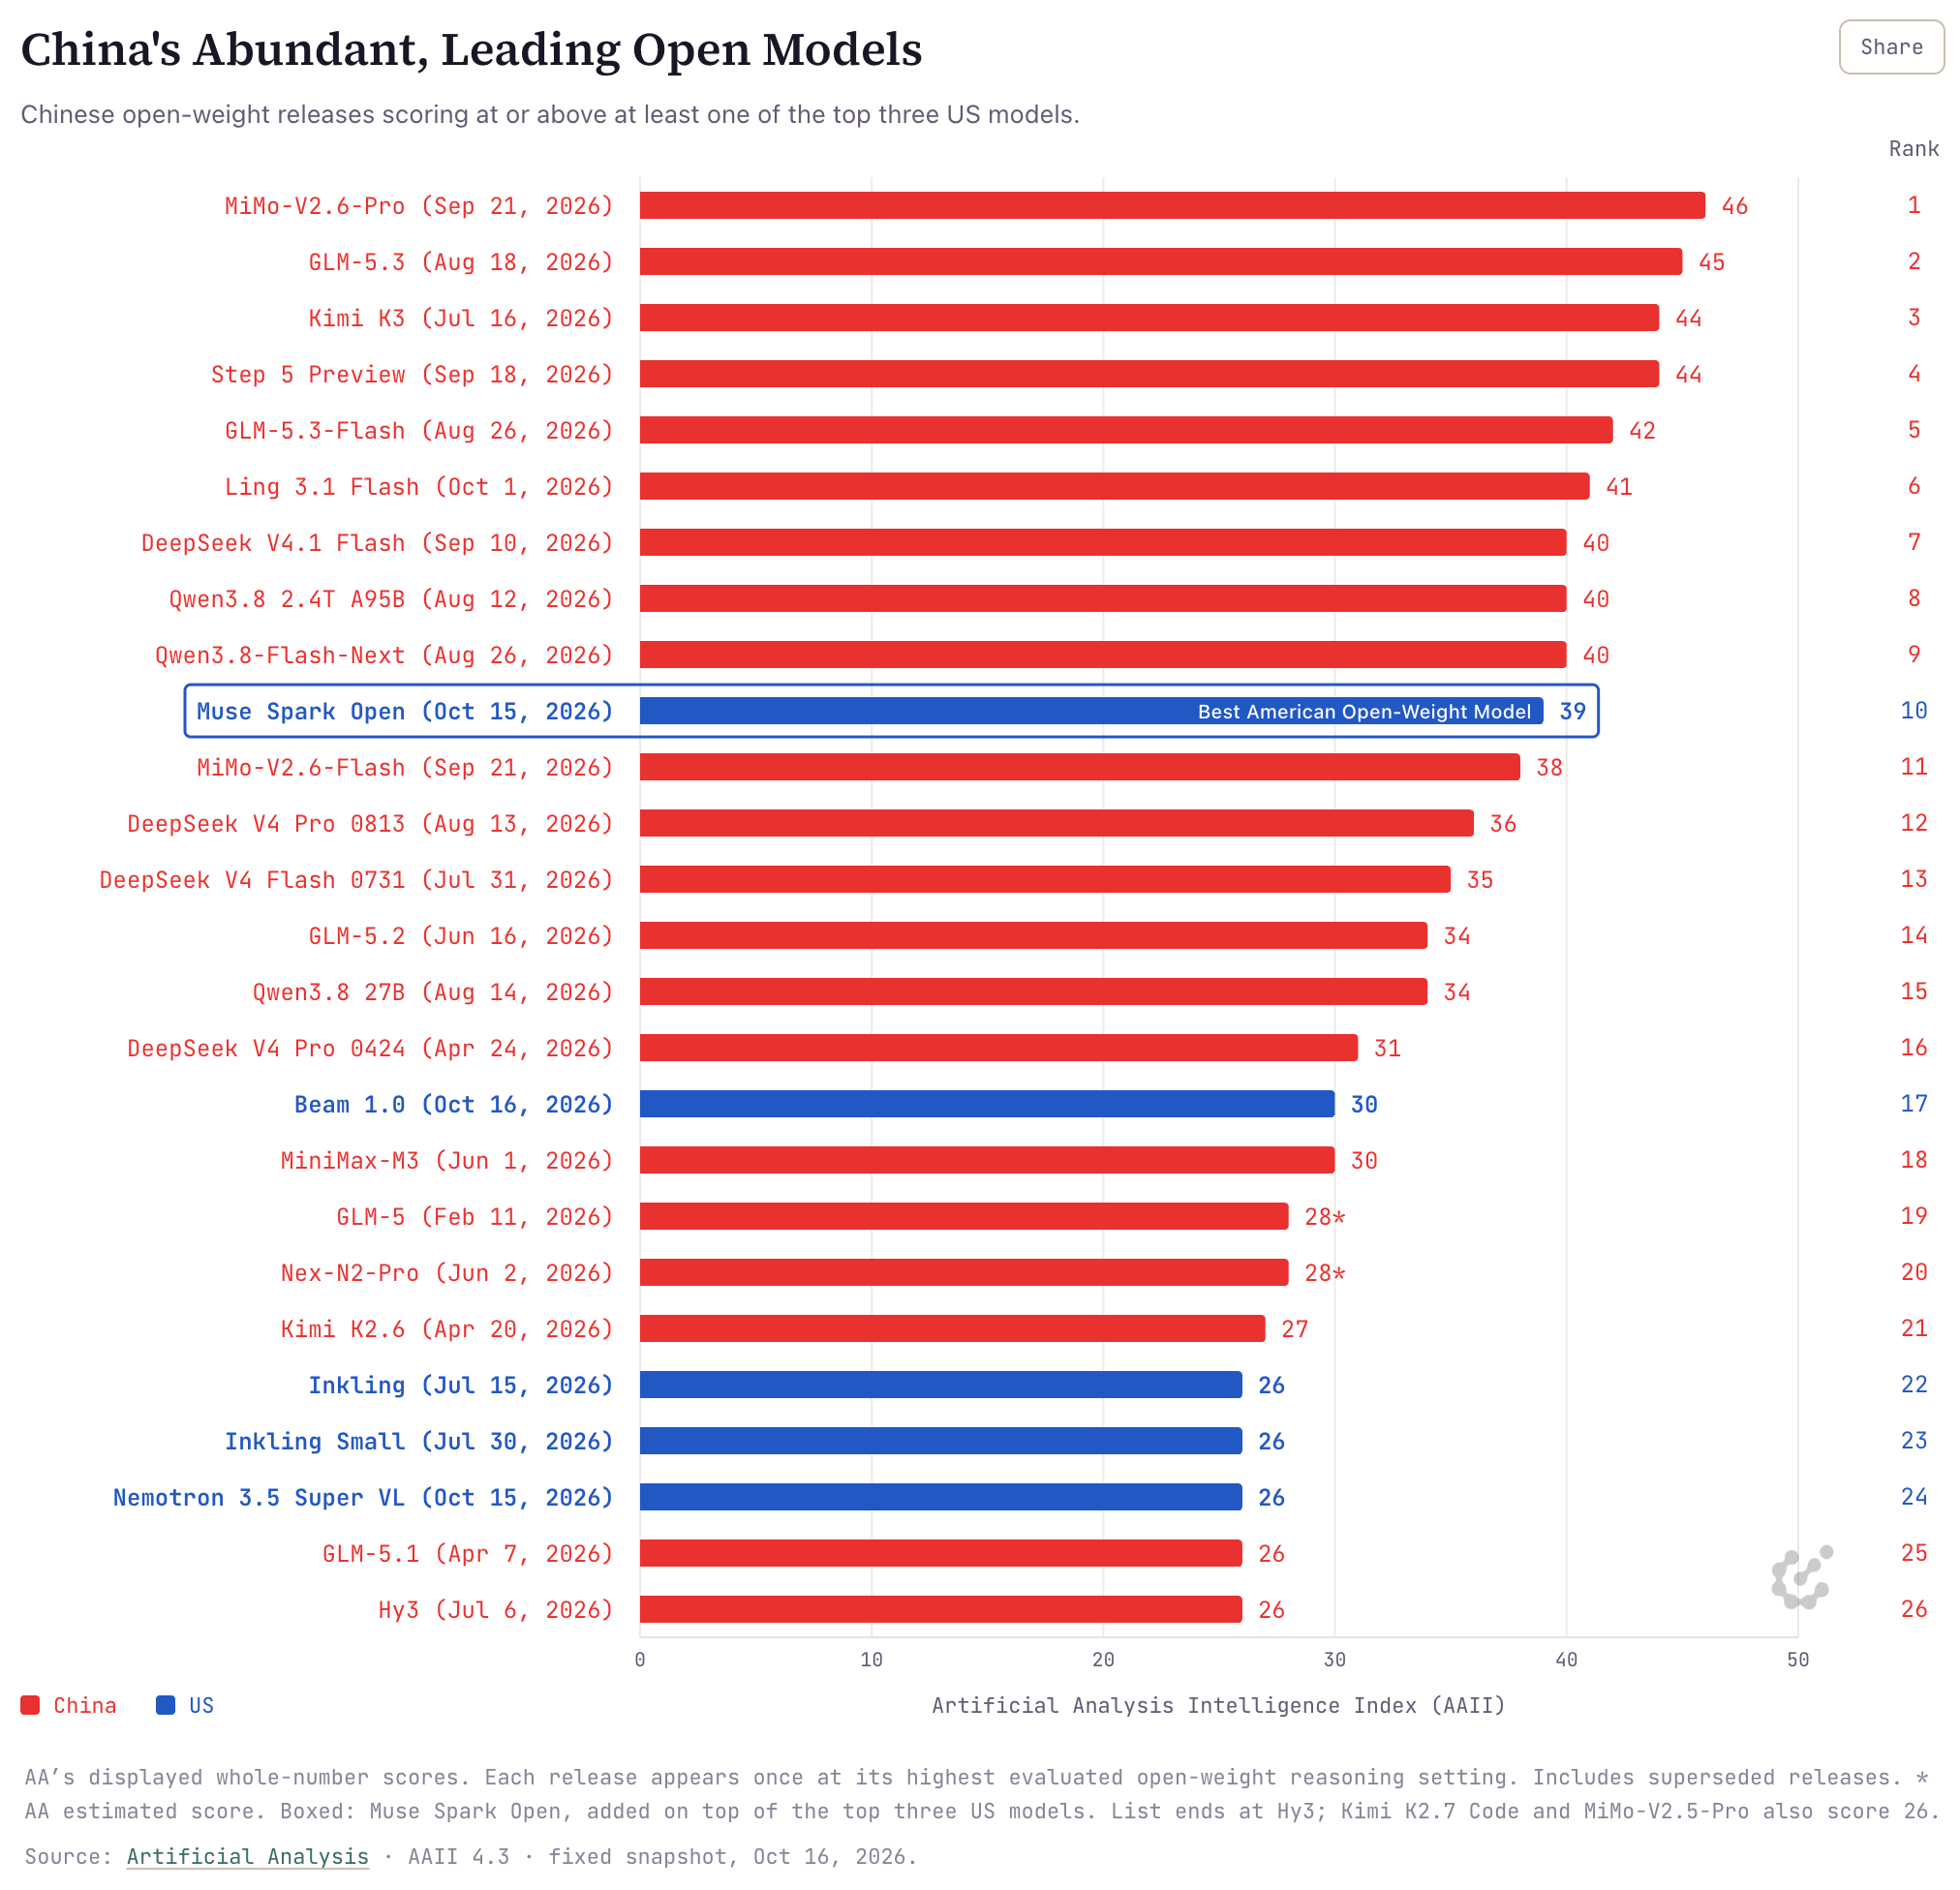
这描绘出前沿模型领域残酷而激烈的竞争态势。Reflection 和 Mistral 宣布了其模型得分,而 Meta 则抢在这两家实验室发布权重之前,直接放出了更智能模型的权重。所有这些模型都在与几个月前发布的中国模型展开竞争。业界普遍在问:自 8 月 18 日 GLM-5.3 和 7 月 16 日 Kimi K3 发布以来,Kimi 和智谱 AI 一直在做什么?
这是一个非常微妙的问题,我将在另一篇文章中深入探讨。今天的文章聚焦于 Meta 的转型、Muse Spark Open 对生态系统的影响,以及西方前沿实验室之间的力量平衡。
Muse Spark Open 为何有望崛起——又为何可能失败
我们在 Interconnects 的开源模型分析中反复观察到一个现象:在性能与参数规模相当的情况下,西方开源权重模型的采用率远高于中国模型(尽管中国模型通常发布得更早!)。Muse Spark Open 正是在这一背景下推出,恰逢开放式 LLM Agent 真正走向成熟之际(~GLM 5.2 的能力及其意义)。
得益于中国模型性能的快速提升,开源生态正经历需求加速增长的阶段。推理服务商正在迅速扩张规模,开源后训练经济体系逐渐成型,无数企业希望掌握自主智能能力。Muse Spark Open 的性能介于 GLM 5.2 之上、接近 DeepSeek V4.1 Flash,但略低于 GLM 5.3 或 Kimi K3。它应当完全“足够好”,能够顺利融入当前生态系统。
作为背景信息,以下是来自 Hugging Face 上 Muse Spark Open 模型卡的内容:
Muse Spark Open 是一个总参数量 816B / 激活参数量 42B 的开源权重模型,支持 100 万 token 上下文窗口。该模型专为编码和 Agent 任务设计,原生支持多模态。此开源版本经过额外的安全后训练,以增强其作为独立模型时的鲁棒性,防止在无系统护栏情况下被滥用。我们建议将 Muse Spark Open 部署于更广泛的 AI 系统中,并搭配适用于具体用例的额外护栏机制。
下图展示了各款 Muse 模型在 Artificial Analysis Intelligence Index 上的分布情况。
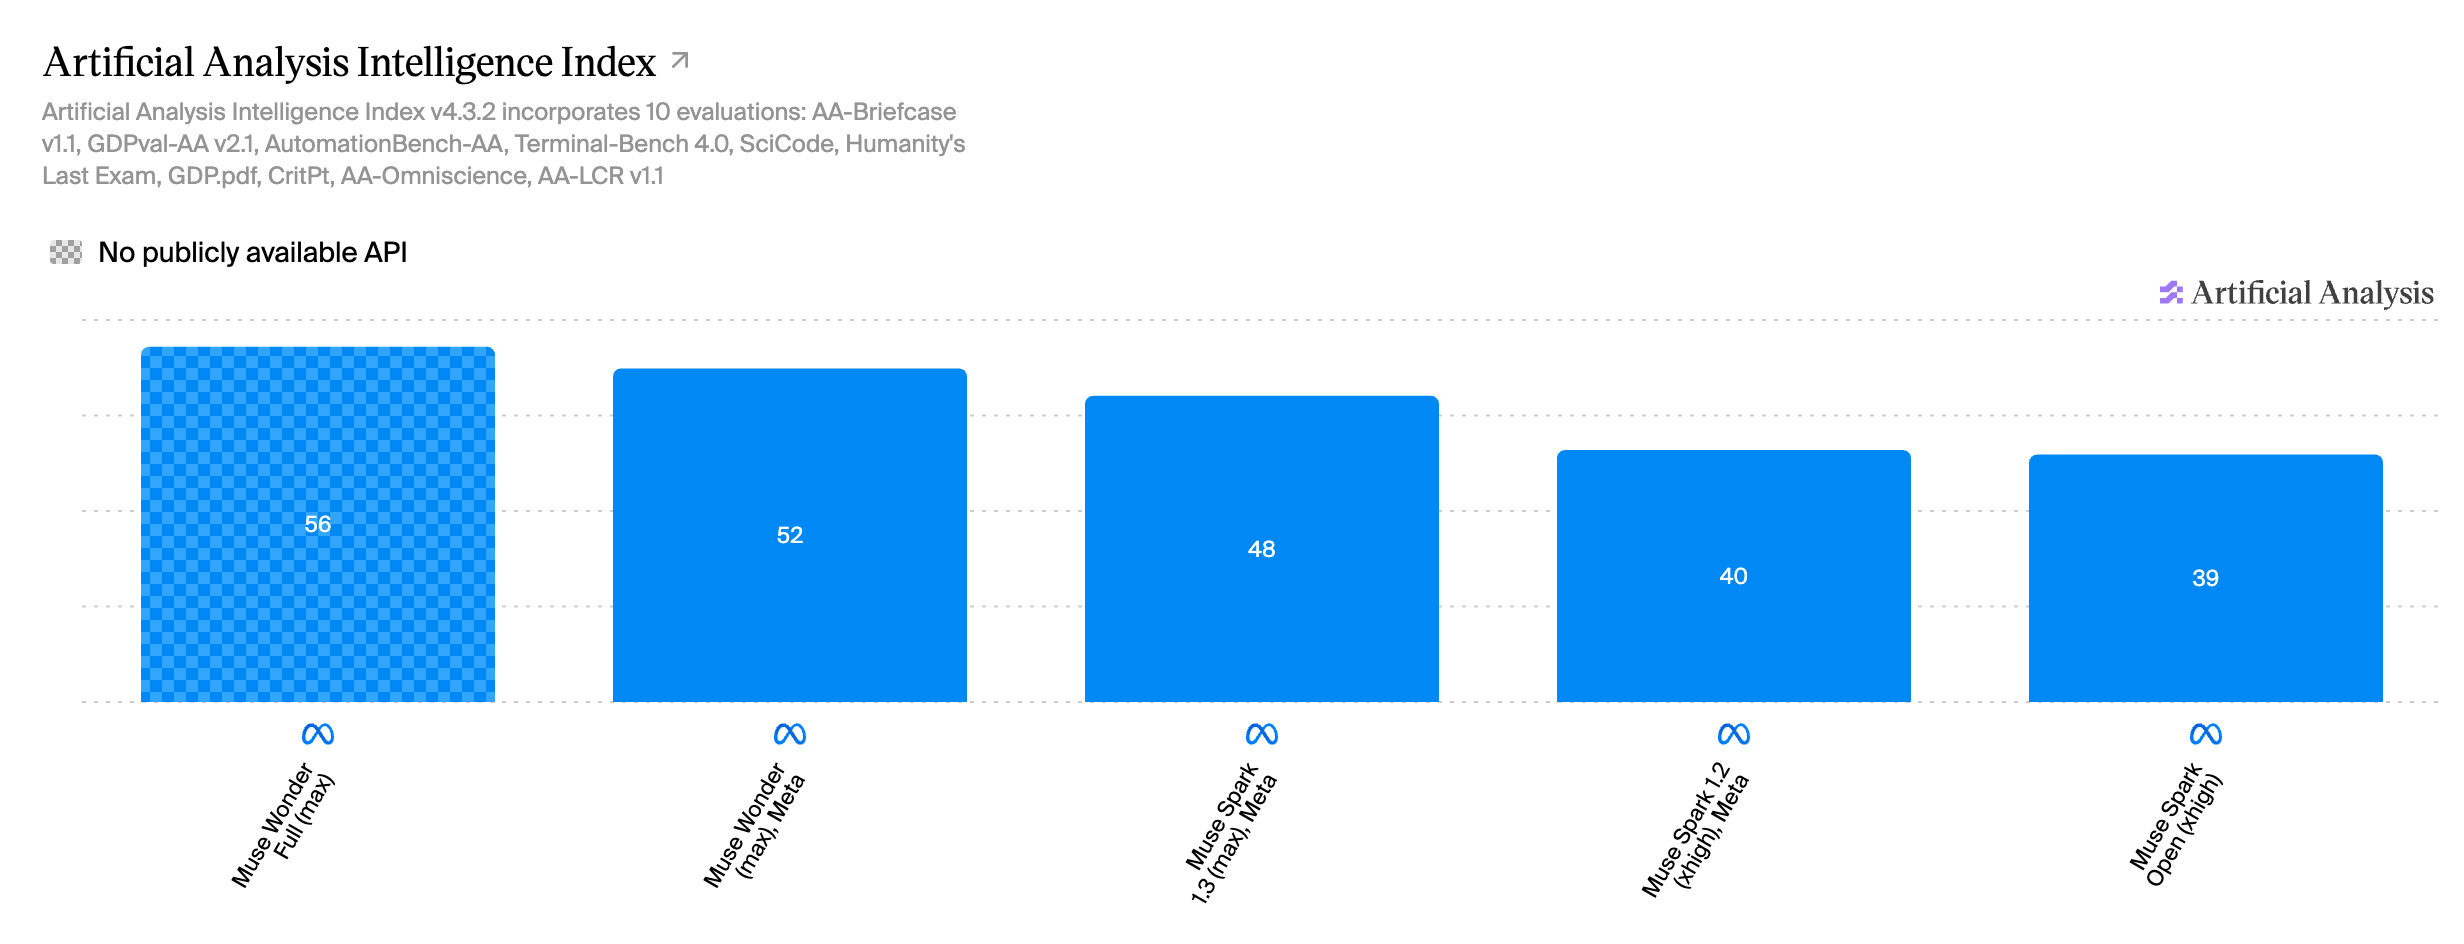
此处引用旨在呼应前文提到的模型卡片段。官方说明指出,该开源权重模型为准备此次公开发布而接受了额外的安全训练。许多观察者认为,由于该模型是在 Muse Spark 1.3 之后发布的,可能在安全训练过程中导致模型“受损”。
实际上,这更有可能只是 Muse Spark 1.2 的一次安全性微调(safety tune),在 Artificial Analysis 基准测试中仅导致 1 分的下降,旨在强化安全行为。当 Meta 发布 Muse Glimmer——一款 30B 参数的智能体模型时,Alex Wang 表示,他们正准备以开放权重(open weights)的形式发布 Muse Spark 1.2 模型,这与上述情况相符。
如果说有什么因素会阻碍 Muse Spark Open 的发展,那将是他们为其设计的特定许可证。简而言之,这份定制许可证包含了过去几年我们在构建开源模型过程中所见(并在此批评过)的所有限制性许可条款。具体如下:
- 在产品中使用该模型的用户必须在产品中显示“Built with Muse”。Meta 曾在 Llama 上采取过这一做法,Kimi 也尝试过,但几乎没有人遵守。
- 存在收入门槛限制,即在整个业务中部署该模型且月收入超过 2000 万美元的公司,需要与 Meta 签订单独的许可证协议。其他知名的开源模型提供商也在采取类似措施,以便为转售推理服务建立收入分成协议。
- Muse Spark Open 要求用户同意可接受使用政策(acceptable use policy),这在真正的“开源软件”领域意味着该模型极不开放。
- 上述所有条款同样适用于模型的输出结果及衍生作品,因此如果将模型用于合成数据生成,是否存在法律上的模糊地带尚不明确。
该许可证确实允许将 Muse Spark Open 用于内部研究和应用。
我们目前处于一种奇怪的平衡状态:这份许可证复杂且在法庭上未经证实,但许多参与者可能会选择忽略它。许多人将通过各种推理服务提供商基于该模型进行开发,而 Meta 可能只会追究那些严重的违规行为。
目前,许可证尚未成为决定 AI 采用率的关键因素,但未来情况可能会发生变化。这就是为什么我们认为,对于试图竞争并重获市场采用的实验室来说,为其模型制定复杂的、非标准的开放许可证是一种不必要的战略风险。
Meta 是 Tier 1(OpenAI/Anthropic)还是 Tier 2(Gemini/xAI)前沿实验室?
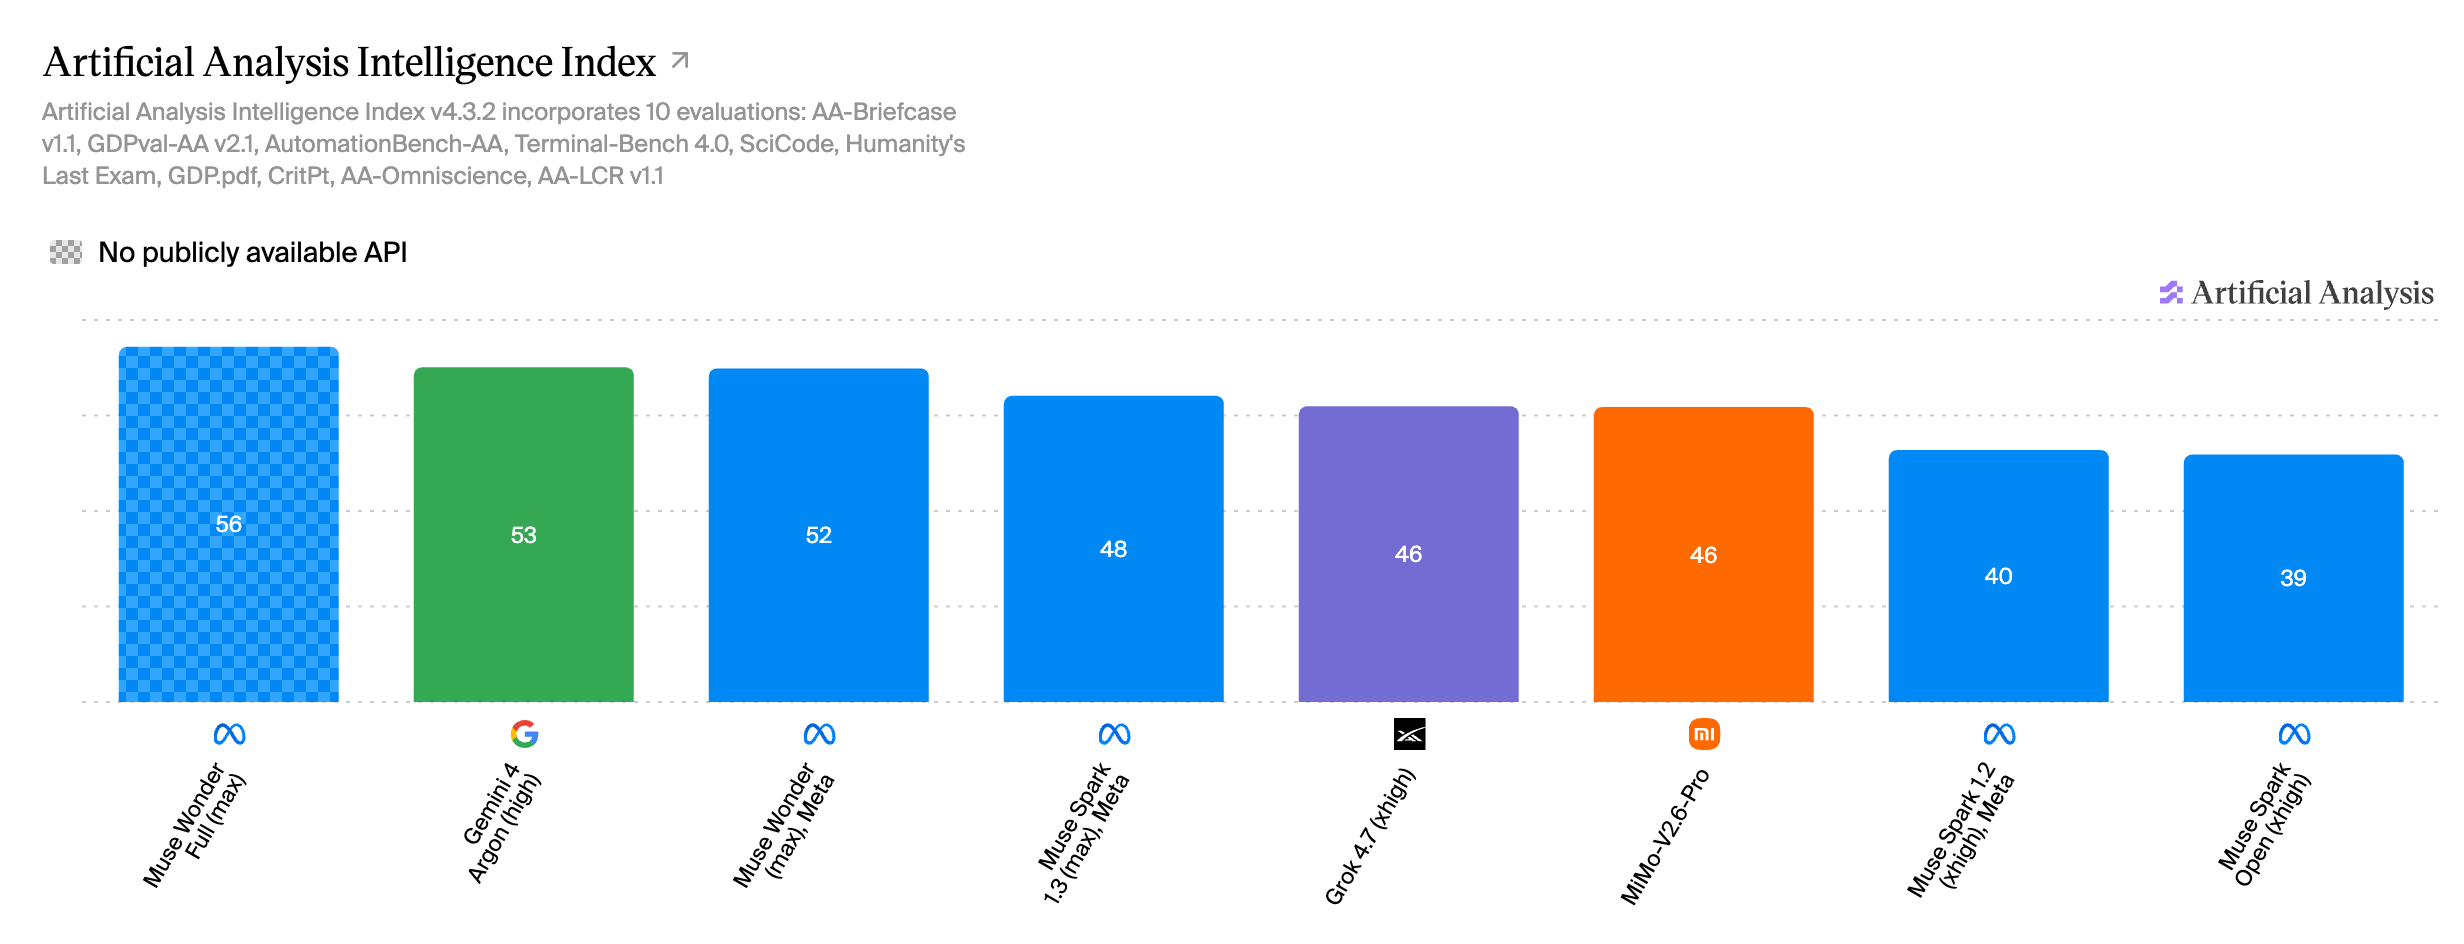
就在 Muse Spark Open 发布前几天,Meta 推出了其闭源前沿模型 Muse Wonder 和 Muse Wonder Full。1 在传统基准测试中,这些是非常强大的模型,仅次于 Anthropic 的 Opus 5.5,与 OpenAI 的 GPT-6-Astra 或 Google 的 Gemini-4-Argon 相当。
这些重大发布距离 Meta 大规模 AI 战略转向仅一年有余,这一转向以 CEO Mark Zuckerberg 发布的 Personal Superintelligence 帖子为标志,当时该帖子招致了大量批评。Meta 是唯一一家同时拥有开源和闭源前沿模型的美国公司。阿里巴巴的 Qwen 采取了类似的策略,但方式更加偏向开放。
对这些模型的整体印象(vibe checks)都很不错,但人们原本预期它们在真实场景使用中不会立即挑战 Anthropic 和 OpenAI 最新模型的精细度水平。我很期待更深入地试用它们——是时候再订阅一个 AI 服务了。
我喜欢 Meta 近期的表现势头:推动自家产品和方向,打造广受欢迎的 Muse agent,并在适当时机拿下诸如“美国开源权重模型领先者”这样的头衔。无论其在财务上是否成功,这种独特的视角都契合其作为企业的历史轨迹。
感觉总有一家实验室在紧追 Anthropic 和 OpenAI 这对领跑组合。目前尚不清楚从长远来看 Gemini 和 xAI 是否已退出竞争,但这两家目前的 offerings(产品/服务提供)比 Meta 要混乱得多。如果你听听 Zuck 和 Alexandr Wang 在 The Cheeky Pint 上的访谈,他们显然对一种高所有权、每位研究员配备高算力的实验室有着非常具体的愿景,我认为这种模式将会奏效。许多实验室因层层官僚主义和激励错位而消亡。与此同时,Alex Wang 拥有超过 200 名直接下属——也就是说这是一个管理层级极少、结构非常扁平的组织——并且他们正在持续稳定地推出模型和产品改进。
构建模型的世界观很大程度上取决于资源、算力、数据和人才(这些都需要巨额资金作为支撑),但将它们组织起来却极其困难。Gemini 常被描述为一个难以推进工作或实现成长的地方——这种说法虽然有些夸大,毕竟那里有很多员工乐在其中,但其中确实存在合理的内核。层层叠叠的管理架构很容易阻碍优秀模型的诞生。
尽管我今天在赞扬 Meta,但 Llama 的失利常被归咎于管理层过度干预,导致模型决策更多出于政治考量而非性能表现。xAI 则处于另一条赛道上,其问题可能在于人才流失率过高,或缺乏足够的组织架构来长期维持顶尖模型的开发。
回顾过去几年,Meta、Gemini 和 xAI 都产出了大致处于性能前沿的模型,但 OpenAI 和 Anthropic 的区别在于它们能够持续保持前沿地位。Anthropic 似乎最为从容且组织有序,拥有清晰的规划和对这类组织运作方式的愿景,并因此确立了领先优势。OpenAI 的表现则起伏不定,但在部署模型的前沿领域仍能紧随其后,同时在公开科学突破方面保持领先(从纳维-斯托克斯方程到 o1 的推理时扩展)。
以下是本文重点关注的几家公司的现状,以及代表整体开源权重模型领先地位的小米 V2.6 Pro。排名顺序为:Anthropic > OpenAI > Meta ≈ Gemini > xAI ≈ 中国开源权重模型 > 美国开源权重模型。
AI 行业的未解之问
经过长期预测前沿模型竞赛将变得过于昂贵,以至于许多参与者难以跟上步伐,我们可能正在看到这一趋势在西方模型中上演。鉴于各模型之间的差距如此接近,我们似乎离“一家独大”的递归自我改进(RSI)还很遥远,但美国能够参与竞争的实验室数量正在从最初充满惊喜的广泛范围,逐渐缩小至 Anthropic、OpenAI、Meta、Gemini 和 xAI 这五家。如果微软开始发布模型——正如他们近期公布的强大的缩放科学成果所示——凭借其超大规模业务的雄厚资金支持以及直接获取 OpenAI 知识产权用于训练模型的优势,它们也有可能加入这一行列。
来自 Mistral、Nemotron、Reflection、Arcee 等“第三梯队”玩家的最佳模型,对开源或闭源前沿领域的影响力正变得越来越微弱。这些模型仍然可以获得相当可观的采用率,足以支撑业务增长,但构建真正前沿模型的成本如今已达到每个主要模型数十亿美元的量级,只有巨头公司才能维持这种投入。
尽管资源规模大幅扩张,该行业的技术核心在预测模型在实际应用中的成功程度方面,命中率依然不高。是的,评估基准是一个不错的代理指标,但为什么像 Anthropic 这样的领先实验室会从 Claude Fable 5 这样的爆款模型,转向 Claude Opus 5 这样的彻底失败之作,随后又凭借 Opus 5.5 重回巅峰?准确预测这一点蕴含着数十亿美元的商机,各大实验室肯定也在努力尝试,但从根本上说,模型在长尾表现上仍然在很大程度上是不可知的。
在所有剩余的竞争者中,从长远角度来看,押注 Meta、Gemini 和 Microsoft 在财务上似乎要容易得多,因为它们拥有充裕的资产负债表。这是一种认为“AI 发展需要时间,且 OpenAI/Anthropic 并没有秘密配方”的观点。毕竟,这是历史上收入增长最快的行业——竞争自然会极其激烈。
目前,Meta 的估值低于 2 万亿美元,而 Anthropic 正接近其轰动一时的 IPO,估值也处于同一水平。在相同的技术领域,Meta 似乎落后半步,但从长远来看,两者似乎几乎站在同一起跑线上,且 Meta 拥有极其盈利的核心业务。这两者的估值中必有一个需要大幅修正。我和朋友们一直在思考一个有趣的思想实验:你预计 Anthropic 在 2027 年 11 月的公开估值会是多少?那 2028 年呢?
只要 Meta 以及 OpenAI 和 Anthropic 的“竞争对手”们继续存在,围绕 AI IPO 的负面估值压力就会越大(这还没算上对安全风险的定价)。身处绝对前沿可能既充满财务动荡,又极具价值。时间会证明一切——我们知道市场可以在很长一段时间内保持非理性。
Muse Wonder 和 Muse Wonder Full 推测是不同的预训练运行版本,其中 Full 是一个更大的模型,但这并不明确,而且这也属于 AI 行业糟糕命名传统的一部分。鉴于近期关于循环架构(looped architectures)的所有新闻,“full”有可能只是一个更多循环的版本,但我没有足够的信心将这一假设写入正文。