vLLM 官方博客 · 2026/10/19 08:00:00
vLLM 实现弹性专家并行近零停机扩缩容
vLLM 通过异步准备与 NIXL EP 技术,将弹性专家并行(Elastic EP)的 GPU 扩缩容停机时间从数十秒降至约 1-2 秒。该优化显著提升了 DeepSeek V4 Pro 等 MoE 模型在动态负载下的服务连续性,实现了近乎无感知的资源调度。
报道全文原始报道全文
本文目录13 个章节
在第一篇关于 Elastic EP 的文章中,我们展示了 vLLM 如何在不重启的情况下向正在运行的 DEP 部署(采用专家并行 MoE 的数据并行注意力机制)添加或移除 GPU。虽然避免了重启,但在重新配置期间服务仍然会停止,因为我们需要初始化新的 worker、准备扩展后的通信组、加载模型权重,并重复执行内核预热和 CUDA Graph 捕获。在我们的 DeepSeek V4 Pro 基准测试中,从 16 个 GPU 扩展到 20 个 GPU 时,这种暂停持续了 100 秒;而从 20 个 GPU 缩容回 16 个 GPU 时,暂停持续了 56 秒(详细数据见性能部分)。
在这篇文章中,我们将介绍如何通过异步准备和 NIXL EP 实现近乎零停机时间的 Elastic EP 重新配置。在同一基准测试中,我们将停机时间缩短至:从 16 个 GPU 扩展到 20 个 GPU 时仅 0.82 秒,从 20 个 GPU 缩容回 16 个 GPU 时仅 1.96 秒。这使得我们可以几乎不影响服务性能地进行扩缩容。
将拓扑准备与服务重叠进行
我们将 vLLM 的重新配置流程重组为两个阶段:后台准备和短暂提交。现有的 worker 使用独立的后台线程来准备并预热目标通信、传输模型权重,并与加入的 worker 同步执行相关信息(如自动调优结果),同时继续使用当前的通信组和 CUDA Graph 处理请求。与此同时,加入的 worker 进行初始化、接收模型权重,并准备其通信和 GPU 执行环境。在提交阶段,vLLM 会短暂暂停调度器,激活已准备好的拓扑结构,然后恢复服务。这些更改是在异步准备和准备/提交优化中引入的。
准备工作涵盖以下四项主要任务:
- 初始化加入的 Worker。 启动其进程,并为模型和执行分配存储空间。
- 准备通信。 设置目标通信组并扩展 EP 通信器(EP communicator)。
- 传输模型权重。 通过 NVLink 或 RDMA,将所需的权重从现有 Worker 传输到加入的 Worker。
- 准备执行。 在加入的 Worker 上完成必要的编译、内核预热(kernel warmup)、调优设置以及 CUDA Graph 构建。
在提交阶段(commit phase)之后,异步专家并行负载均衡(EPLB, Expert Parallel Load Balancing)允许新的 Worker 开始处理注意力机制(attention),而现有 Worker 则继续处理专家计算(expert computation)。随后,EPLB 会在后台将专家重新分布到扩展后的组中。
主要挑战在于,在不涉及或干扰正在服务请求的 Worker 的情况下,准备通信和 GPU 执行环境。
原地扩展 EP 通信
在 NIXL EP 出现之前,vLLM 中可用的 EP 通信后端采用固定成员制:每个实例都是为特定的 Rank 集合创建的。添加或移除 Rank 需要创建一个新的实例。即使该实例可以在后台创建,仍然存在两个问题。
首先,旧实例和新实例需要独立的通信缓冲区及其他资源,包括内存注册、IPC 句柄以及 RDMA 队列对(QP, Queue Pairs)。同时保持两个实例存活会增加通信内存占用,并且需要重复进行设置,而不是复用现有资源。
其次,切换 EP 通信器会改变 EP 通信内核所使用的缓冲区和通信状态。这会导致先前捕获的 CUDA Graph 失效,必须在恢复服务前重新捕获。这意味着需要在所有保留的 Worker 上,针对多种 Batch Shape 重复进行预热和 Graph 构建。在我们的 DeepSeek V4 Pro 基准测试中,即使在异步准备的情况下,在提交阶段执行预热和 Graph 重捕获仍导致扩容期间出现 58 秒的服务暂停,以及缩容期间出现 44 秒的服务暂停。
为解决这些问题,我们设计了 NIXL EP,这是一个专为弹性 EP(Elastic EP)定制的 EP 通信库。它支持原地添加或移除 Rank,并复用相同的 NIXL Agent、缓冲区和连接。新节点可以在现有 Worker 持续提供服务的同时建立连接,且仅加入的节点需要建立新的连接和注册。此外,NIXL EP 确保捕获的 EP Dispatch 和 Combine 条目在重新配置后依然有效,从而允许保留的 Worker 复用其现有的 CUDA Graph。
在准备阶段,vLLM 的后台线程会连接加入的对等节点(peers),但不会激活它们。随后在提交阶段,系统会在不替换通信器(communicator)的情况下激活这些已准备好的对等节点。
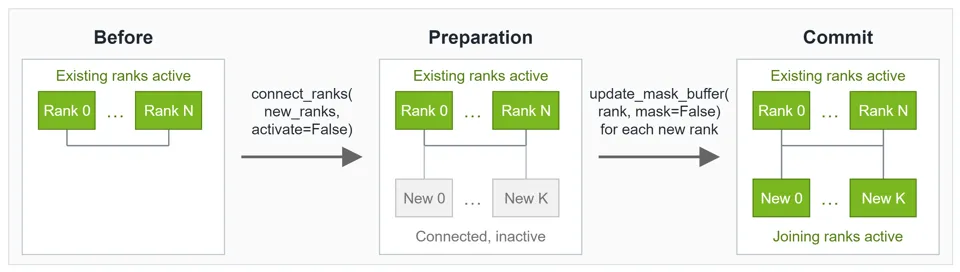
同一个 NIXL EP 通信器从当前活动组进展到已连接但未激活的加入对等节点,然后在提交时激活目标组。
图 1. 连接并激活新的 EP 对等节点。绿色 rank 表示处于活动状态;灰色 rank 表示已连接但被屏蔽。在提交阶段,新对等节点会被激活,而无需替换 agent 或缓冲区。
vLLM 仍会为新的拓扑结构创建新的 DP 协调组和 EPLB 组,但它们的通信运行在捕获的模型前向传播之外,因此切换到这些组不会使 CUDA graphs 失效。
在现有 worker 上保留 CUDA graphs
CUDA graph 记录 GPU 操作,以便 vLLM 能够重放前向传播过程,而无需每次都由 CPU 重复启动各个操作。捕获的内核节点包含其启动配置和参数值,其中包括指向输入和输出张量的指针。虽然内存内容可以在多次重放之间发生变化,但记录的指针必须保持有效。这些要求是 CUDA graph 执行契约的一部分。
vLLM 为不同的批次形状和执行模式分别捕获独立的 graph,并在每次捕获之前运行预热(warmup)前向传播。
保留已捕获的 CUDA graph 不仅仅意味着让通信器对象存活。NIXL EP 还确保内核启动配置、graph 可见的通信参数以及输入和输出张量地址在重新配置期间保持稳定。其内核从设备状态中读取活动组成员信息,该状态可以就地更新。
我们还修改了 vLLM,以确保周围计算内核的已捕获参数、启动配置以及输入和输出张量地址在重新配置期间保持稳定:
- 我们复用保留工作节点的融合 MoE 执行对象,而不是为不同的活跃 EP 大小重新构建它们。
- 我们在重配置过程中保持图可见工作区和调度输出的地址及布局稳定,以便已捕获的专家内核能够继续使用它们。调度输出同时也是专家计算的输入。如果它们的地址或布局随 EP 大小发生变化,已捕获的专家内核仍会使用旧的指针和偏移量。
- 我们保留专家路由张量的底层存储,并就地更新映射关系。这使得 EPLB 能够在不移动已捕获内核所使用的张量的情况下更改映射内容。
综上所述,这些改动使得保留的工作节点在扩容和缩容后都能复用其现有的 CUDA 图。
独立准备加入的工作节点
现有工作节点需要保留其 CUDA 图,而加入的工作节点则没有。
加入的工作节点通常通过运行包含 EP 调度和合并操作的模型前向传播,以及与其他工作节点交换批次信息来进行准备。这些步骤需要其他工作节点的参与,但现有工作节点已经在当前拓扑上处理真实请求。
NIXL EP 允许每个加入的工作节点在预热和图准备期间临时屏蔽所有远程 EP 对等节点。仅该工作节点的本地排名处于 EP 通信活跃状态。我们还修改了 vLLM,使这些准备过程无需等待来自其他工作节点的 DP 批次信息。这使加入的工作节点能够在不需要现有工作节点参与的情况下运行其虚拟批次并捕获 CUDA 图。
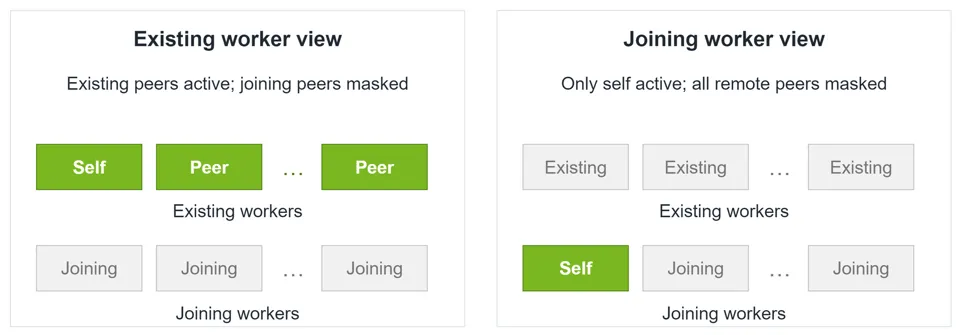
现有工作节点在与当前对等节点保持活跃的同时屏蔽加入的对等节点。每个加入的工作节点仅保持自身活跃以进行本地预热和图捕获,并屏蔽所有远程对等节点(包括其他加入的工作节点)。
图 2。绿色排名表示 EP 通信活跃;灰色排名表示被屏蔽。现有工作节点协同服务,而每个加入的工作节点在准备阶段屏蔽所有远程 EP 对等节点。
捕获完成后,NIXL EP 可以在不使计算图失效的情况下重新激活对等节点。加入的工作节点在作为扩展组的一部分开始提供服务时,会复用其本地已捕获的计算图。
DeepSeek V4 Pro 上的性能表现
扩容与缩容耗时
下表展示了哪些阶段在服务暂停期间运行,以及哪些阶段在后台运行而现有工作节点继续提供服务。
| 阶段 | A: 阻塞式 | B: 异步准备 | C: 异步准备 + 计算图复用 |
|---|---|---|---|
| 初始化加入的工作节点 | 服务暂停 | 后台运行 | 后台运行 |
| 准备目标通信拓扑 | 服务暂停 | 后台运行 | 后台运行 |
| 传输模型权重 | 服务暂停 | 后台运行 | 后台运行 |
| 在加入的工作节点上进行预热和计算图捕获 | 服务暂停 | 服务暂停 | 后台运行 |
| 在现有工作节点上进行预热和计算图捕获 | 服务暂停 | 服务暂停 | 无需执行(现有计算图保持有效) |
| 激活目标拓扑结构 | 服务暂停 | 服务暂停 | 服务暂停 |
配置 C 仅由 NIXL EP 支持。
- 停机时间: 观察到的服务中断时长,即正在处理的请求停止推进且新请求不被接纳的时间段。
- 总耗时: 完整扩缩容操作的持续时间,包括准备阶段。
这两个指标是分别测量的。
| 指标 | A: 阻塞式 | B: 异步准备 | C: 异步准备 + 计算图复用 |
|---|---|---|---|
| 16 至 20 GPU:停机时间 | 99.62 s | 58.04 s | 0.82 s |
| 20 至 16 GPU:停机时间 | 56.25 s | 44.07 s | 1.96 s |
| 16 至 20 GPU:总耗时 | 99.72 s | 97.27 s | 92.34 s |
| 20 至 16 GPU:总耗时 | 56.21 s | 51.46 s | 9.32 s |
所有配置均通过了数值正确性检查,包括对每个加入的工作节点的检查。
在增加 GPU 的同时维持 SLO
我们在 16 个 GPU 上部署了 DeepSeek V4 Pro,随后将传入请求速率从约每秒 8 个请求逐渐增加到每秒 16 个请求。我们针对三种部署方案重放了相同的包含 11,391 个请求的场景:一种保持在 16 个 GPU,一种重启并扩展到 20 个 GPU,另一种使用带有 NIXL EP 的 Elastic EP 扩展到 20 个 GPU。服务级别目标 (SLO) 设定为滚动 p95 首 Token 延迟低于 5 秒。
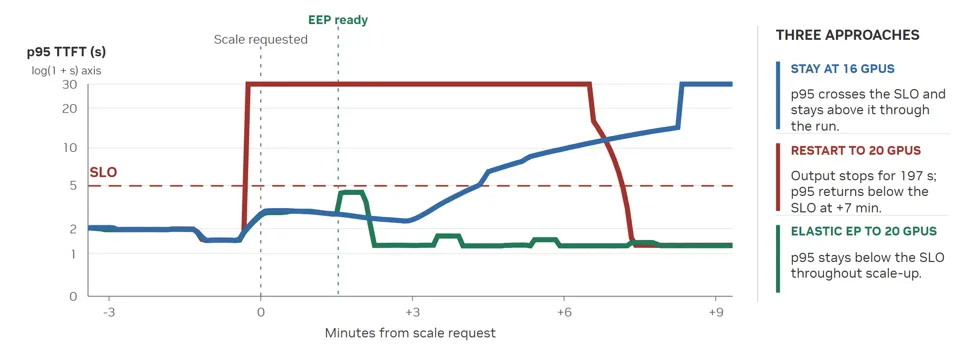
Elastic EP 在整个场景期间始终保持在 SLO 阈值以下。在准备阶段,其服务性能与静态 16-GPU 部署相当。扩容后,其性能与恢复后的 20-GPU 部署相匹配。
图 3. 请求负载上升时的端到端服务表现。曲线显示 30 秒滚动 p95 结果,失败请求被赋予 30 秒惩罚值而非实测 TTFT。
- Elastic EP 完成了全部 11,391 个请求,并在整个场景期间始终保持在 SLO 阈值以下。
- 在准备阶段,Elastic EP 的服务性能与静态 16-GPU 部署相当,后台准备工作未造成可见的性能下降。
- 扩容后,Elastic EP 的性能与恢复后的 20-GPU 部署相匹配,扩容后未出现可见的性能下降。
试用 Elastic EP
后台准备、CUDA graph 复用以及加入节点上的独立 graph 捕获功能,现已在最新的 vLLM 和 NIXL 版本中提供。通过 pip 安装即可开始使用 Elastic EP。
有关完整的使用示例,请参阅 vLLM Elastic EP 测试中的 cuda_graphs_heavy_nixl_ep 用例。该示例包含服务器配置和扩缩容 API 调用。它在发送请求的同时将规模从两个 GPU 扩展到四个再缩回,并检查准备期间的服务状态以及每次调整大小前后的模型准确性。
未来展望
通过 Dynamo Snapshot 恢复预热工作节点
我们已有效解决了长时间服务中断的问题。下一个挑战是更快地让新容量就绪。我们计划集成 Dynamo Snapshot,使加入的工作节点能够恢复已初始化的进程和 CUDA 状态,从而避免重复进行编译、内核预热、graph 构建及其他启动工作。
目标拓扑的通信必须单独准备,因为快照无法恢复这部分内容。从检查点存储恢复大型模型权重可能会占据主要的恢复时间,因此我们计划保留 Elastic EP 现有的从已有工作节点进行 GPU 到 GPU 权重传输的方式。
通过 NIXL EP 实现最先进的 EP 通信
我们的目标是在保持对 Elastic EP 和容错机制全面支持的同时,通过 NIXL EP 实现业界领先的调度(dispatch)与合并(combine)性能。即将推出的 NIXL EP 性能更新是迈向这一目标的下一步(请参阅 NIXL EP 路线图 RFC)。
将 Elastic EP 接入 Dynamo 和 llm-d 编排系统
在引擎层能力就绪之后,下一步是将 Elastic EP 应用于编排器的自动扩缩容(autoscaler)中。目前,vLLM、Dynamo 和 llm-d 社区已在推进相关集成工作。
这些工作包括 vLLM 的外部负载均衡器开发 以及 Dynamo 的 Elastic EP 提案。
如果您正在运行大规模推理服务,我们鼓励您尝试 Elastic EP,并分享您的工作负载及运维需求。如果您从事推理基础设施构建,我们欢迎为 vLLM Elastic EP 和 NIXL EP 做出贡献。让我们共同推动 Elastic EP 在生产环境中的落地。
致谢
- 感谢来自 Red Hat 的 Tyler Michael Smith 和 Sage Moore,他们在整个工作中提供了宝贵的反馈和详尽的评审。
- 感谢 Linoy Geva(NVIDIA),她在准备阶段为服务性能优化做出了贡献。
- 感谢整个 NIXL 团队在 NIXL EP 方面付出的努力。
- 感谢 Tzu-Ling Kan、Julien Mancuso 以及整个 Dynamo 团队,他们为在 Dynamo 中支持 Elastic EP 付出了努力。