BOSS 直聘团队开源 Nanbeige4.3-33B 智能指数达 20 分
BOSS 直聘旗下基础模型团队 Nanbeige 以 Apache 2.0 协议开源了 33B 稠密推理模型 Nanbeige4.3-33B,在 Artificial Analysis 智能指数 v5 上取得 20 分,与 Qwen3.8 27B(xhigh)持平。该模型支持 524K token 上下文,可在笔记本本地运行,终端操作与物理推理是相对强项,但知识类基准明显落后于 Qwen3.8 27B。
报道正文
本文目录3 个章节
Nanbeige 发布 Nanbeige4.3-33B:一款开放权重模型,在 Artificial Analysis Intelligence Index v5 上以 20 分与 Qwen3.8 27B(xhigh)持平,终端使用能力更强但知识储备较弱
Nanbeige 是 BOSS 直聘(由看准有限公司运营的中国招聘平台)的基础模型研究团队。其稠密 33B 推理模型以 Apache 2.0 协议开放权重,仅支持文本输入与输出,上下文窗口为 524K token,体积小到足以在笔记本电脑上本地运行。
关键结果:
➤ 在 30B 总参数规模下具备竞争力。 Nanbeige4.3-33B 与 Qwen3.8 27B(xhigh)均得分 20,而 Muse Glimmer(high,30B)为 6 分。
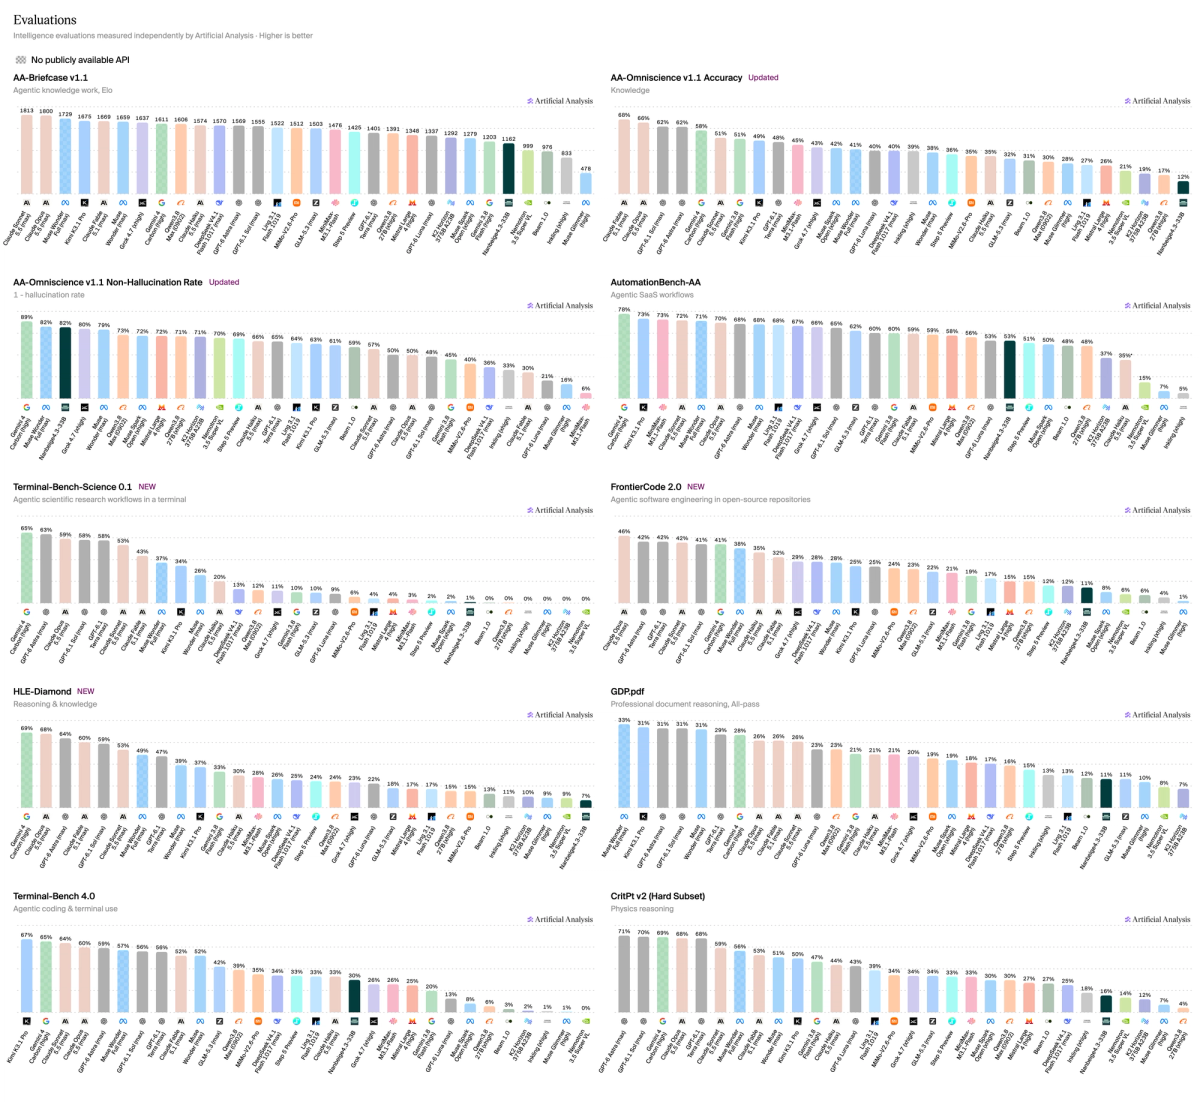
➤ 终端使用与物理推理是相对优势。 Nanbeige 在 Terminal-Bench 4.0 上得分 30%,在 CritPt v2 的 Hard Subset 上得分 16%,而 Qwen3.8 27B 分别为 6% 和 4%。
➤ 尽管总分相同,优势领域与 Qwen3.8 27B 不同。 Nanbeige 在 AutomationBench-AA 上优于 Qwen3.8 27B(53% 对 48%),但在 AA-Briefcase v1.1(1162 对 1391 Elo)、FrontierCode 2.0(11% 对 15%)和 HLE-Diamond(7% 对 15%)上落后。
➤ 在 Omniscience 上弃答率高、幻觉率低。 Nanbeige 在 AA-Omniscience v1.1 上得分 -4,而 Qwen3.8 27B 为 -6,幻觉率为 18% 对 29%。它正确回答的问题更少(12% 对 17%),并对 71% 的问题选择弃答。
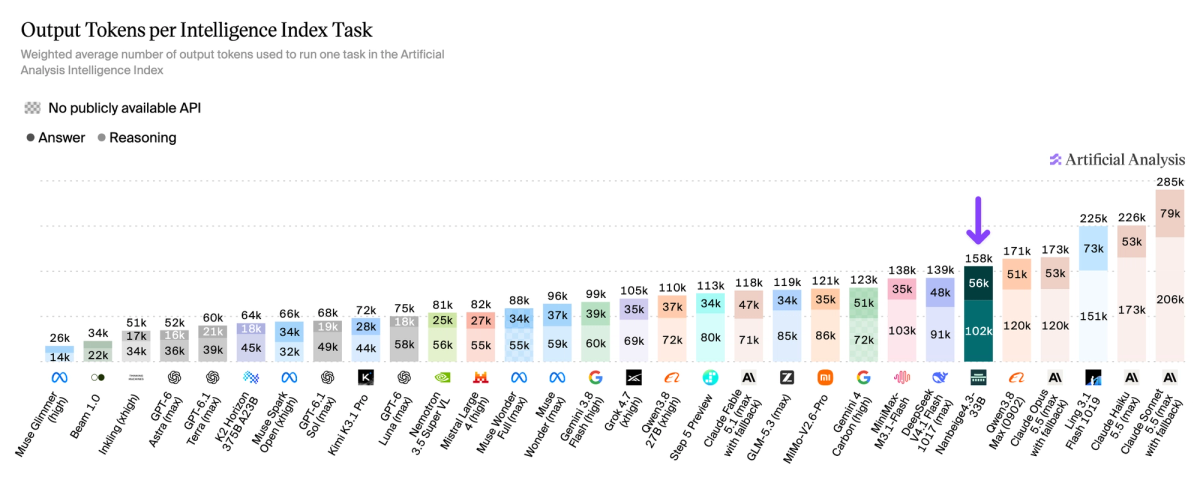
➤ 智能水平相近,但每项任务输出 token 更多。 Nanbeige 在每个 Intelligence Index 任务上使用 158K 输出 token,而 Qwen3.8 27B 为 110K,约多出 44%。
其他模型详情:
➤ 类型: 开放权重推理模型(Apache 2.0 许可证)
➤ 规模: 33B 总参数(稠密)
➤ 模态: 仅文本输入与输出
➤ 上下文窗口: 524K
➤ API 可用性: 暂无确认的公开第一方或第三方 API
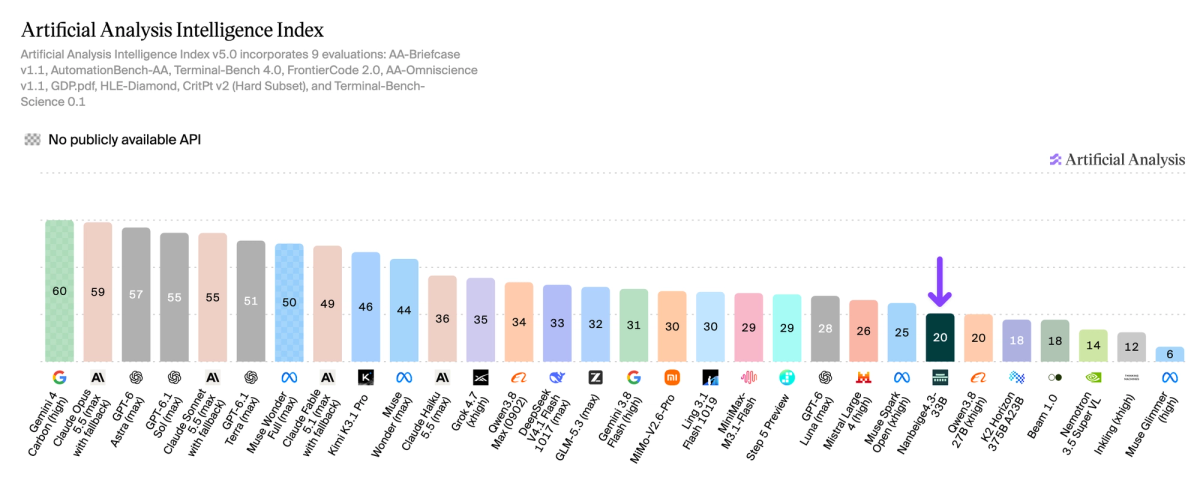
Nanbeige4.3-33B 以 33B 总参数在 Intelligence Index 上达到 20 分,与 27B 参数、同样 20 分的 Qwen3.8 27B 并列,并在 Intelligence Index 与总参数量的关系上确立了新的帕累托最优点。 Nanbeige4.3-33B 和 Qwen3.8 27B 均为稠密模型。DeepSeek V4.1 Flash 1017(max)以 552B 总参数得分 33,但其 MoE 架构每个 token 仅激活 16B。
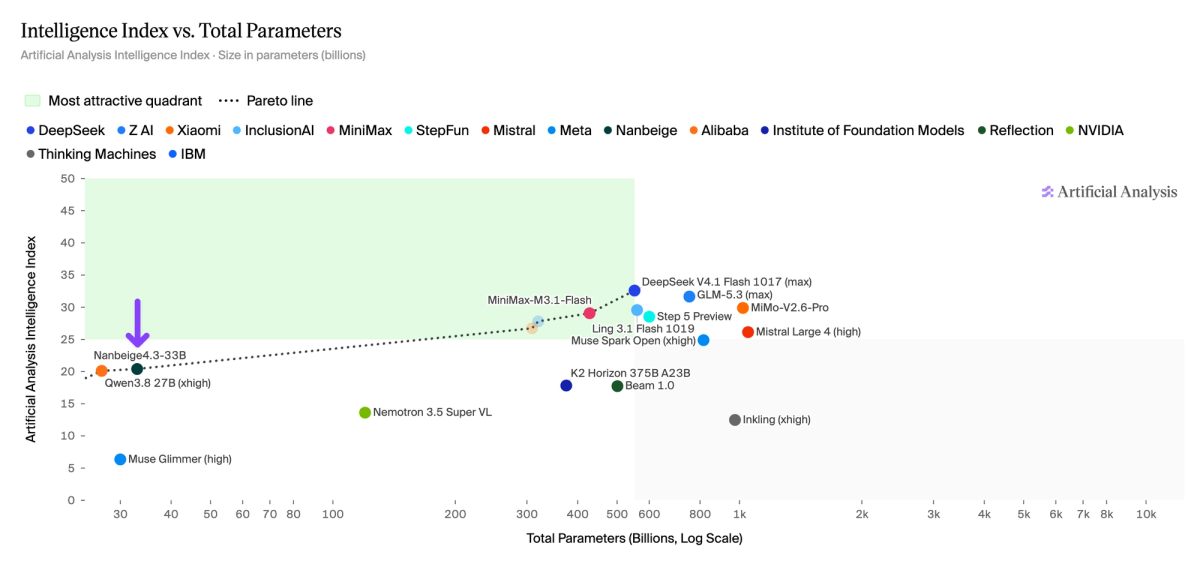
Nanbeige4.3-33B 在 AA-Omniscience v1.1 中的结果体现了选择性作答。 其幻觉率为 18%,而 Qwen3.8 27B 为 29%;其尝试作答率为 29%,而 Qwen3.8 27B 为 43%。总体而言,Qwen 答对的问题更多:17% 对 12%。
在 Intelligence Index 的每项任务中,Nanbeige4.3-33B 使用了 158K 输出 token,而 Qwen3.8 27B 为 110K——尽管两者得分均为 20,前者却多用了 44%。 该加权平均值涵盖九项 v5 评估中的答案 token 与推理 token,其中包括智能体工具调用轮次。
Artificial Analysis Intelligence Index v5 各项评估的完整结果