TypeSafe 发布 Jev 决策模型:结合 LangGraph 构建低成本结构化 AI 代理
TypeSafe AI 推出新型模型 Jev,它不生成文本而是直接输出代码可执行的结构化决策。该方案旨在通过“代码掌控工作流、AI 处理窄域决策”的范式,替代昂贵且缓慢的传统 LLM 通用调用,并结合 LangGraph 实现生产级智能体的高效部署。
报道正文
本文目录9 个章节

Sydney RunkleHunter LovellSeptember 25, 20269min返回博客创建智能体创建智能体
上周,TypeSafe AI 发布了 Jev,这是一种新型模型。与传统 LLM 不同,Jev 并不生成文本。它做出的决策可以直接被你的代码执行,从而实现 TypeSafe 所称的 AI 驱动软件,其核心理念是“代码掌控工作流,AI 处理狭窄且结构化的决策”。TypeSafe 将其哲学概括为构建“生产级系统,而非全能神”(prod, not god)。
随着前沿 LLM 的能力日益增强,我们开始将它们视为“全能神”,在处理输入模糊的任务时纷纷求助于它们:如文本生成、文档提取、搜索、排序、研究、分类等。不幸的是,“全能神”既昂贵又缓慢。即使你只需要一个“是”或“否”的答案,每次调用都要为这种通用性买单。
这就是为什么 Jev 的发布引起了如此广泛的关注。在狭窄的决策任务上,例如许多智能体所依赖的路由和分类步骤,TypeSafe 的基准测试显示,Jev 的运行速度比领先的 LLM 快至多 200 倍,成本低至多 400 倍。
对于 LangChain 团队而言,TypeSafe 的方法让我们感到一种近乎怀旧的情愫。我们的使命是让智能体变得实用且无处不在,我们的开源生态系统也随着模型格局的变化而演进,但在每一步发展中,我们始终回归到两个核心问题:如何让模型做出有用的决策?以及如何可靠地执行这些决策?
LangGraph正是我们对这两个问题的回答。基于协助数千家企业将 AI 投入生产的经验,我们构建了 LangGraph,它允许你将模型驱动的决策与确定性代码相结合,从而构建出可靠且可观测的系统。Jev 则为这些系统提供了一种更快、更廉价的决策方式。在本文中,我们将介绍如何利用 Jev 和 LangGraph 构建“生产级系统,而非全能神”。
用于决策的 Jev
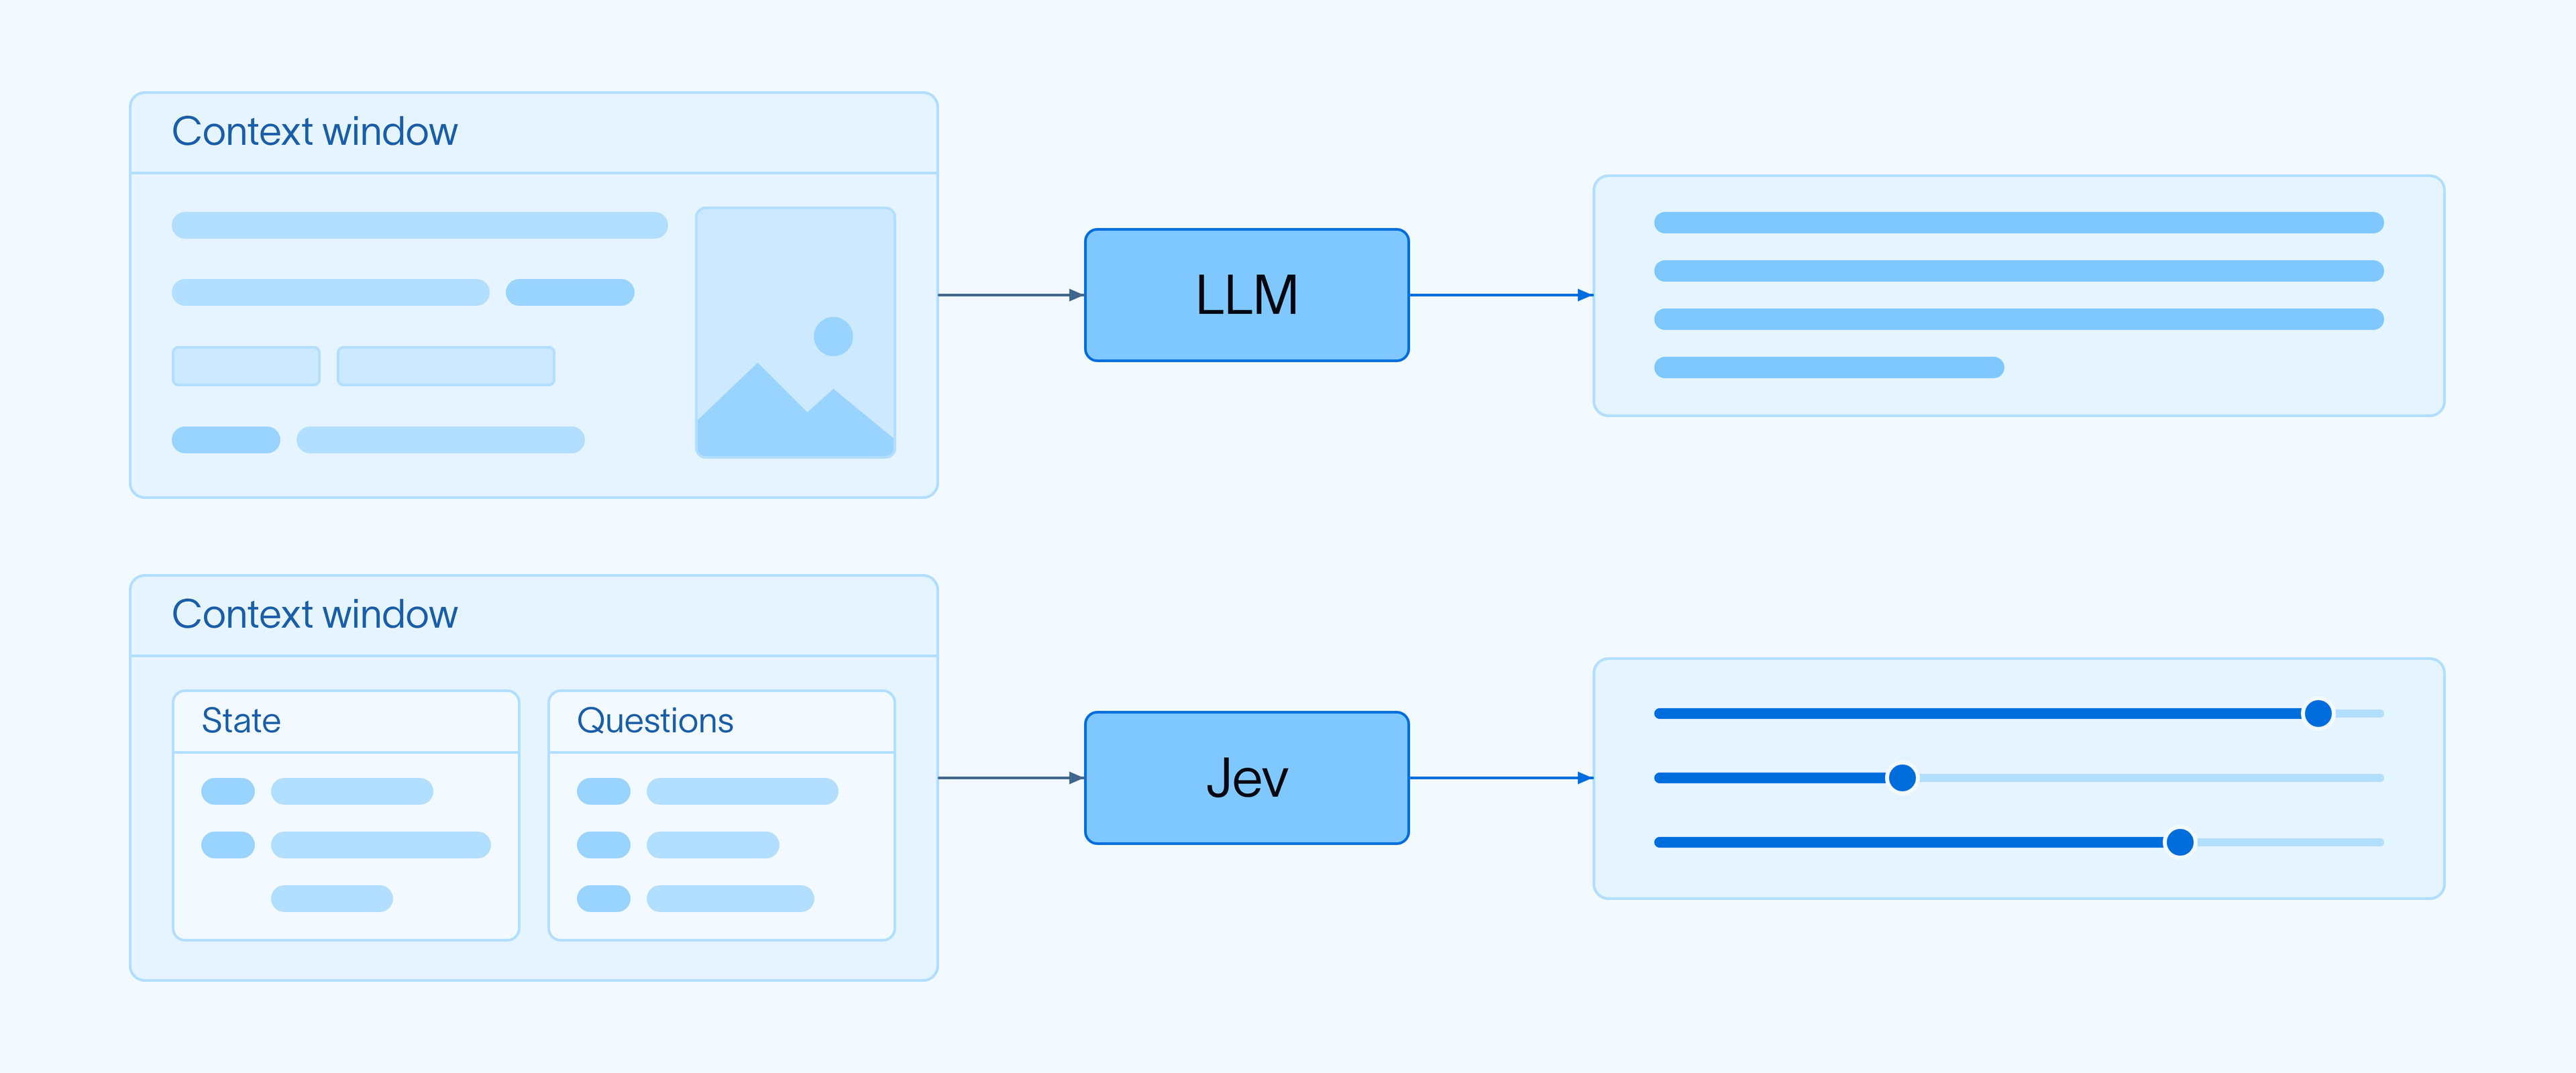
Jev 从前沿 LLM 的能力包中剥离出“判断”这一项,并将其转化为一种成本低廉到无需计量的基础原语。TypeSafe 将其称为 System One(系统一)模型,或者更通俗地称为决策模型。你只需输入状态和一组问题,它便会返回带有概率的类型化答案。
TypeSafe 的文档阐述了构建软件的三种方式。传统软件由显式逻辑构成,每个分支都由人工编写且可审计,但因此显得僵化。Agent 则走向了另一个极端:单个模型在每一步中统筹所有决策,控制流从代码转移到了提示词中。AI 驱动的软件采取的是中间路线:代码保留结构并处理精确计算,而模型仅介入那些需要语义判断的分支节点。
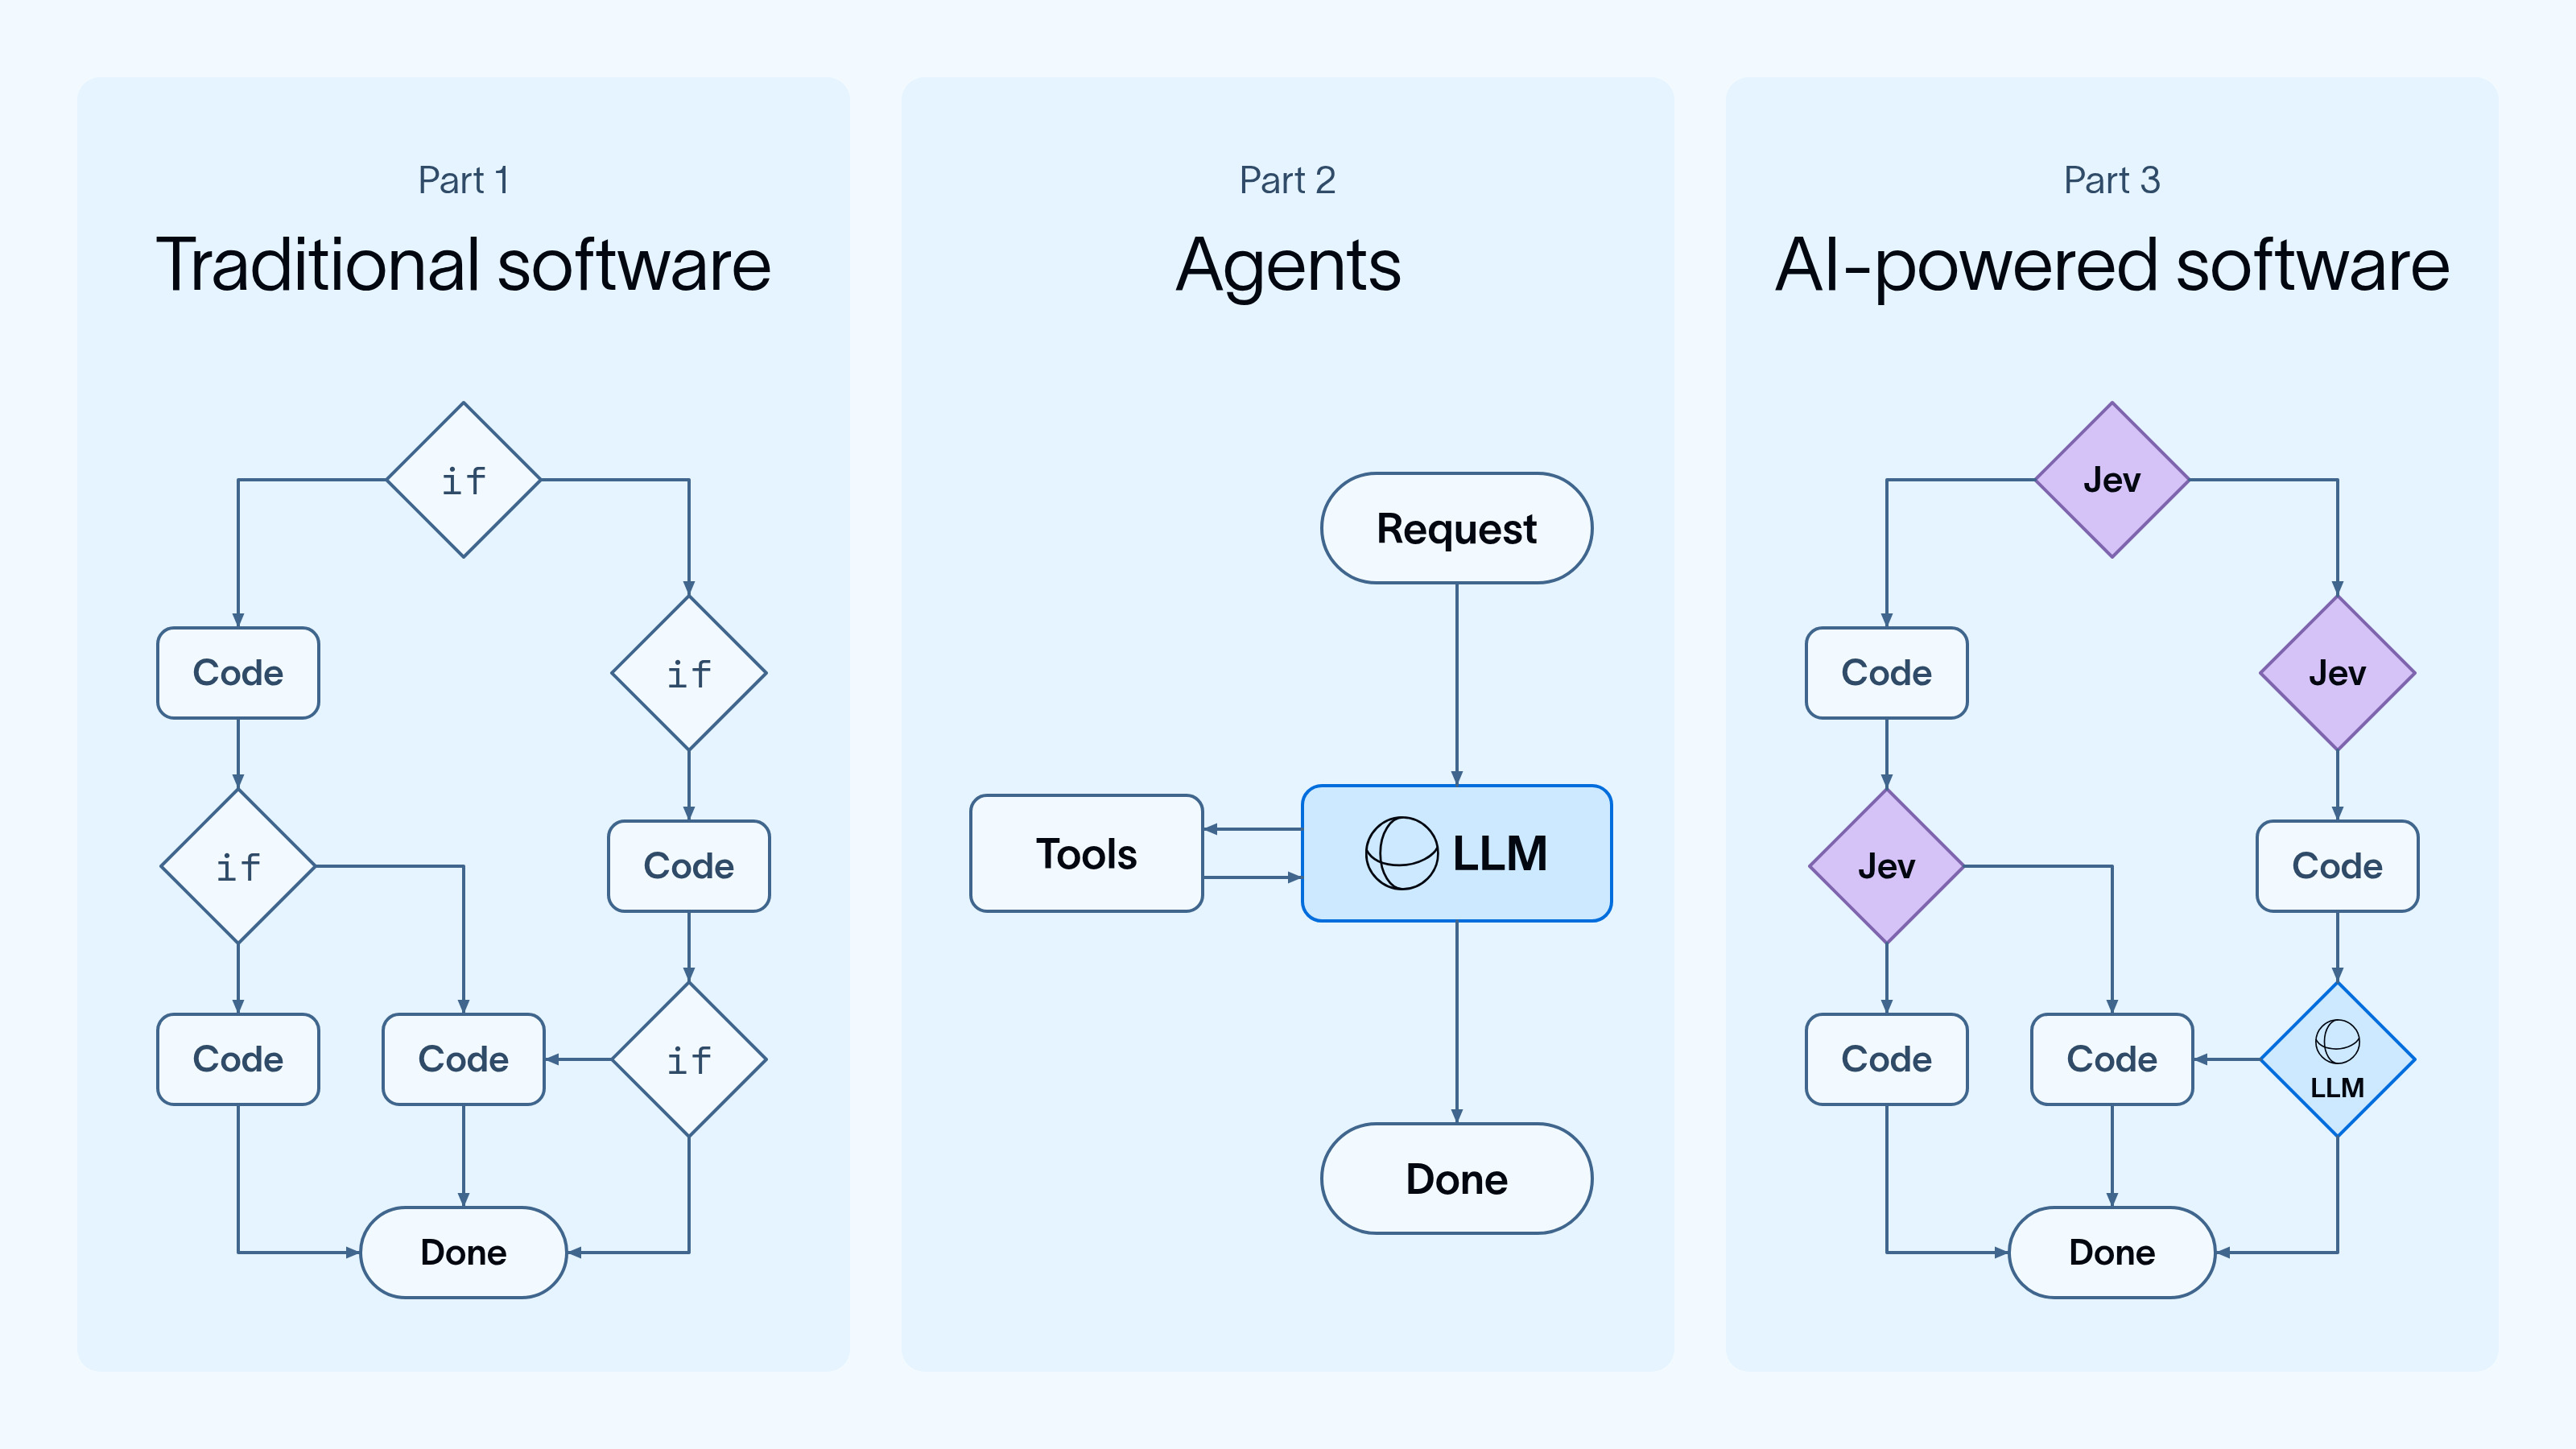
以下几项特性有助于 Jev 成为生产级 系统的可组合组件:
- 结构化: 答案以带有概率的类型化形式返回,使代码能够基于结果进行可预测的分支处理
- 并行化: 你可以针对同一状态同时提出多个问题
- 快速: 决策成本足够低,允许在单次运行中执行大量决策
- 自一致性: System One 旨在通过重复评估返回稳定的答案。
💡 Jev 的一致性是对 LLM 非确定性的一种令人欣喜的改变。向 LLM 在不同运行中询问相同的问题,可能会得到不同的答案。Jev 的设计目标是针对相同输入返回相同的答案。在一项早期的 Jev-as-a-judge 实验中,其在 100 次重复运行中的评分几乎纹丝不动,波动远小于我们测试的任何 LLM 评判器。
例如,这段视频帮助你直观理解 Jev 与 LLM 的工作方式有何不同。这里的任务是确定输入是否包含各种类型的 PII(个人身份信息):
真实应用会做出海量决策,且每个决策都错综复杂地依赖于之前的选择。一旦决策变得如此廉价,挑战就转变为如何编排这些决策,而这正是 LangGraph 的用武之地。
使用 LangGraph 进行编排
多年来,我们一直协助团队构建围绕 LLM 的系统,几乎每个团队都会遇到同样的两个问题:
- 上下文管理很难。 为了让模型做出正确的决策,其上下文窗口需要包含“下一步所需的恰当信息”。这些信息往往模糊不清,并且随着应用的运行而不断变化。
- 模型驱动的系统仍需具备可靠性。 它们必须能够应对故障、支持人工干预,并确保每一步都可观测。
现有的框架解决了部分问题,但没有一个能在不限制用户构建方式的前提下同时解决这两个问题。因此,我们构建了 LangGraph。目前,它每月的下载量已超过 6000 万次,并被众多正在使用 AI 的财富 50 强公司所采用。
状态即上下文
LangGraph 应用由三个部分组成。节点(Nodes) 是工作单元:可以是普通代码、模型调用、工具调用,或是一个完整的子图。状态(State) 是节点读取和更新的信息。边(Edges) 决定下一个运行的节点,既可以沿固定路径执行,也可以根据当前状态动态决定。
任何图都可以作为更大图中的节点,因此经过测试的小型组件可以组合成更大的系统。TypeSafe 的 宣言 对智能持相同观点:小型、清晰可读的原语是让复杂系统保持可信的关键。
随着图的运行,每一步的结果都会累积到状态中。该状态成为后续每一步的上下文,同时也决定了接下来哪些节点会运行。
与其将领域知识 打包进提示词,不如将其 编码在图的拓扑结构中:明确哪些决策会被做出、按什么顺序做出,以及每个决策能看到什么状态。正如 TypeSafe 所言,这就是软件如何基于意图和常识进行分支的方式。判断力来自模型,但流程保持在你可以检查和测试的代码中。
可靠的运行时
正如 TypeSafe 宣言 所主张的,只有当某个组件足够可靠时,才允许它在无人值守的情况下运行;只有当你能够检查、测试并约束它时,才在其基础上进行构建。LangGraph 在运行时层面处理了这一点:
- 持久化执行:模型驱动的步骤具有非确定性,因此相同的输入可能导致模型发起不同的调用,并使运行进入不同的路径。失败后从头重启比缓慢更糟糕,因为重跑可能无法复现相同的路径。检查点(Checkpointing)会在每一步持久化状态,因此失败的运行可以基于已做出的决策继续恢复
- 人机协同:当某个步骤在系统采取行动前需要审核时,中断机制允许你暂停、批准并从中断处继续执行
- 可观测性:模型驱动的步骤每次执行的行为并不一致,因此你需要通过 LangSmith 中的追踪功能来查看做出了哪些决策以及原因
这些特性并非 LLM 独有。Jev 同样接收非结构化文本上下文并返回判断结果,因此它也需要同样的保障,而图结构会自动为每个节点提供这些保障。
示例:用于证据开示的文档审查
在诉讼中,公司在向对方移交(生产)文件之前必须审查每一页内容,单个案件可能涉及数十万页文档。其中大部分审查工作都是对同一类有限判断的重复执行,这使得它非常适合使用 Jev。
对于每一页文档,Jev 在一次请求中回答三个问题,每个答案都对应图中的一条路由:
- 该页面是否与请求相关?如果不相关,则将其搁置。
- 是否包含个人信息?如果包含,则由 LLM 对 PII(个人身份信息)进行脱敏处理。
- 是否可能享有特权?如果可能,则转入
attorney_review(律师审查),这会暂停图以等待人工介入。
剩余的所有内容即可准备移交。以下是该流程的快速演示(在实际应用中,页面是并行处理的):
Jev 负责所有分类任务,而图仅在页面需要更多处理时才进行升级:例如交由 LLM 进行脱敏,或交由律师进行特权判定。
我们运行了相同的图,分别使用 Jev 处理分类任务 和 Sonnet 作为评判者。在多次试验中,Jev 在分类步骤上的速度比 Sonnet 快 5–6 倍。两次运行均在 LangSmith 中进行了追踪,因此你可以打开任意页面查看其采取的路由路径及背后的概率分布。LangSmith 还为 Jev 这类决策模型提供了专用视图,展示每次决策的输入和校准后的输出:
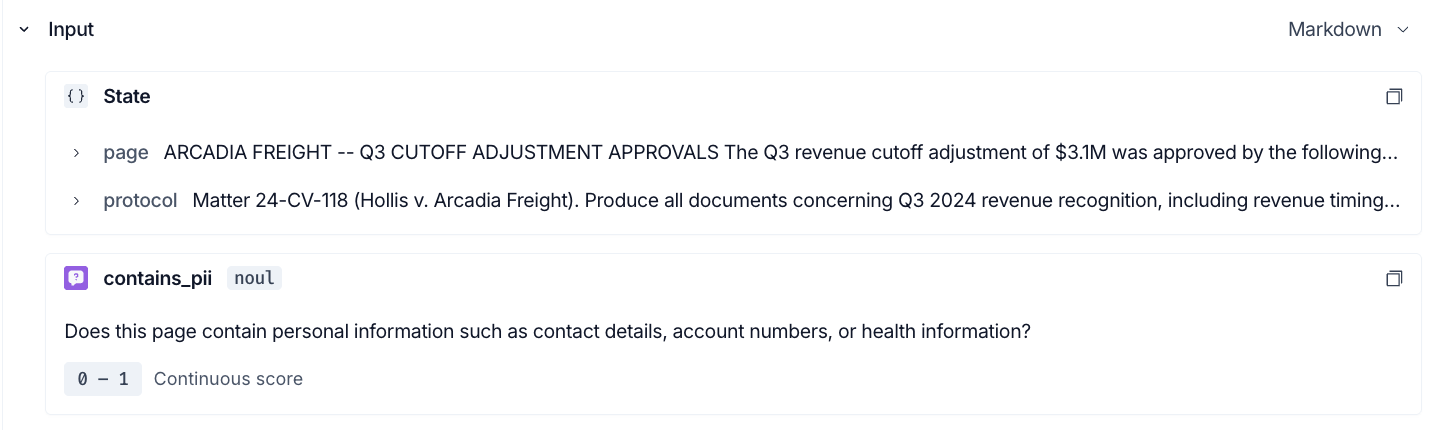
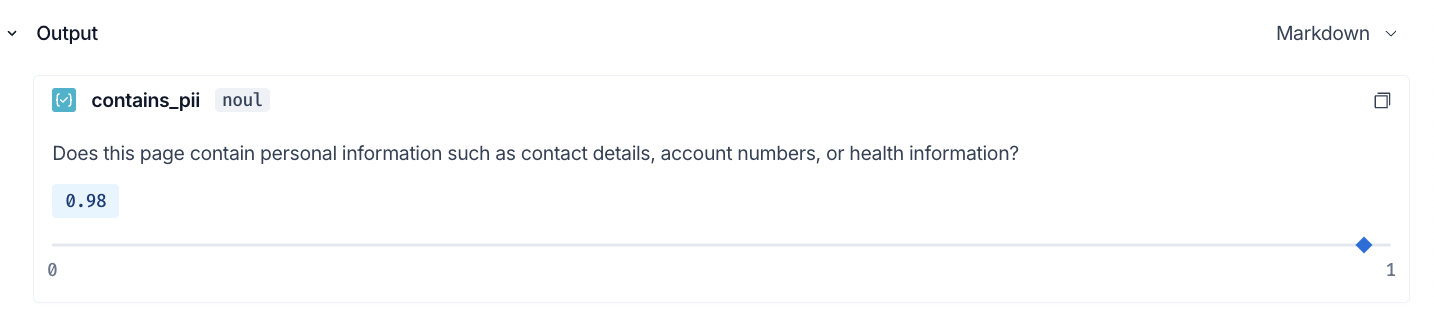
这是智能的大解绑(Great Unbundling)
过去三年里,大多数 Agent 都将所有任务路由给同一个前沿 LLM。Jaya Gupta 将接下来的趋势称为“智能的大解绑”:各项能力被拆解开来,并分配给能够胜任该任务的最低成本模型。Jev 提取出判断力,返回结构化决策而非生成的文本。一旦这些组件分离,就需要某种机制通过路由每一步并决定何时升级来处理它们,将它们重新整合起来——这正是运行时(Runtime)的职责。
浏览器自动化展示了这一理念在实际中的应用。浏览器 Agent 读取页面并决定下一步操作:点击按钮、填写字段或滚动页面。这听起来像是开放式任务,但在任何给定时刻,页面上仅提供有限的一组可交互元素,因此下一步动作实际上是从列表中做出选择。
Browserbase 围绕这一理念重构了 Stagehand 的 act()。Stagehand 负责标记页面上的可交互元素,Jev 则选择动作类型和最佳候选元素,任何置信度低于 0.7 的情况都会回退到 LLM。在早期测试中,act() 的中位延迟从 1.97 秒降至 0.46 秒,速度提升了约 4.3 倍。
对于大多数用例而言,Jev 并不能完全取代 LLM。它处理那些有把握的有限选项,并将其他所有情况交给 LLM。这正是 Gupta 所描述的转变:从“默认使用前沿模型,后续再优化”转向“默认使用低成本模型,仅在例外情况下使用前沿模型”。我们预计会看到更多此类模式:决策模型在动作空间受限的情况下进行快速、低成本的调用,而将开放式推理以及小模型不确定的案例留给 LLM 处理。
开发者们已经开始朝这个方向迈进。正如一位开发者本周告诉我们的那样:“我基本上正在把我们现有的每一个 agent 都转换为由 Jev 驱动的工作流。”
入门指南
- 通过 LangGraph 三年图工程实践 了解 LangGraph 运行时的工作原理
- 通过 基于 Jev 构建 Harness 查看 Jev 如何融入 agent harness,包括模型路由和自动模式分类器
- 使用 LangSmith 监控和评估你的 agents
致谢
本文由 Sydney Runkle 和 Hunter Lovell 撰写。
感谢 Kevin Frank、Harrison Chase、Eugene Yurtsev 和 Nathan Drezner 提供的审阅与建议。
