Latent Space · 2026/10/10 22:04:11
Standard Bots CEO 访谈:工业机器人闭环数据修正机制对 AI Agent 可靠执行的启示
AI 原生工业机器人制造商 Standard Bots 通过 C 轮融资估值达 10 亿美元,其核心方法论在于利用真实部署中的边缘案例数据进行闭环修正。该实践表明,在追求高可靠性执行时,针对特定场景的高质量反馈数据比盲目扩大数据集规模更具价值,这一思路可直接迁移至软件智能体的优化中。
报道全文原始报道全文
本文目录7 个章节
提到机器人与 AI,你脑海中首先浮现的可能是像 Figure 的 AI 驱动机器人和 1X 的 NEO 家用机器人这样的全尺寸人形机器人。这些或许代表了未来,但可以说在 2026 年更为重要的是工业机器人——它们通常并非人形。
Standard Bots 自称是“美国最大的 AI 原生工业机器人制造商”。该公司最近完成了由 General Catalyst 和专注于机器人领域的基金 RoboStrategy 领投的 C 轮融资,筹集了 2 亿美元,估值达到 10 亿美元。其客户包括 NASA、亚马逊和洛克希德·马丁。
我们采访了 Evan Beard(联合创始人兼 CEO)和 Leif Jentoft(AI 负责人),以深入了解 Standard Bots 的 AI 技术栈及其模型的工作原理。
作为背景介绍,Standard Bots 的工业机械臂专为机床上下料、焊接和装配等任务设计。以下是 Jentoft 的一段快速演示:
预训练模型与特定任务适配
据 Beard 介绍,Standard Bots 拥有一个共享基础模型,客户可以通过演示和微调对其进行适配。Jentoft 补充说,Standard Bots 运行着一系列模型,其中包括用于机床上下料的零样本感知系统。
Beard 表示,其最大的模型参数量在低十亿级别——因此按照前沿实验室的标准来看,它并不算大。
“我们认为数据质量远比原始数据量重要,”Jentoft 说,“我们专注于从针对性数据中挖掘最大价值,而不是盲目追求尽可能大的数据集。”(这与 Jev 创作者 Diogo Almeida 提到的“最苦涩的教训”不谋而合,他最近告诉我们,正确的任务和正确的数据可能比算力更重要。)
“我们的市场准入优势让我们能够获取最高价值的数据,”他补充道。“现场干预只需几十个示例就能修复边缘情况。”
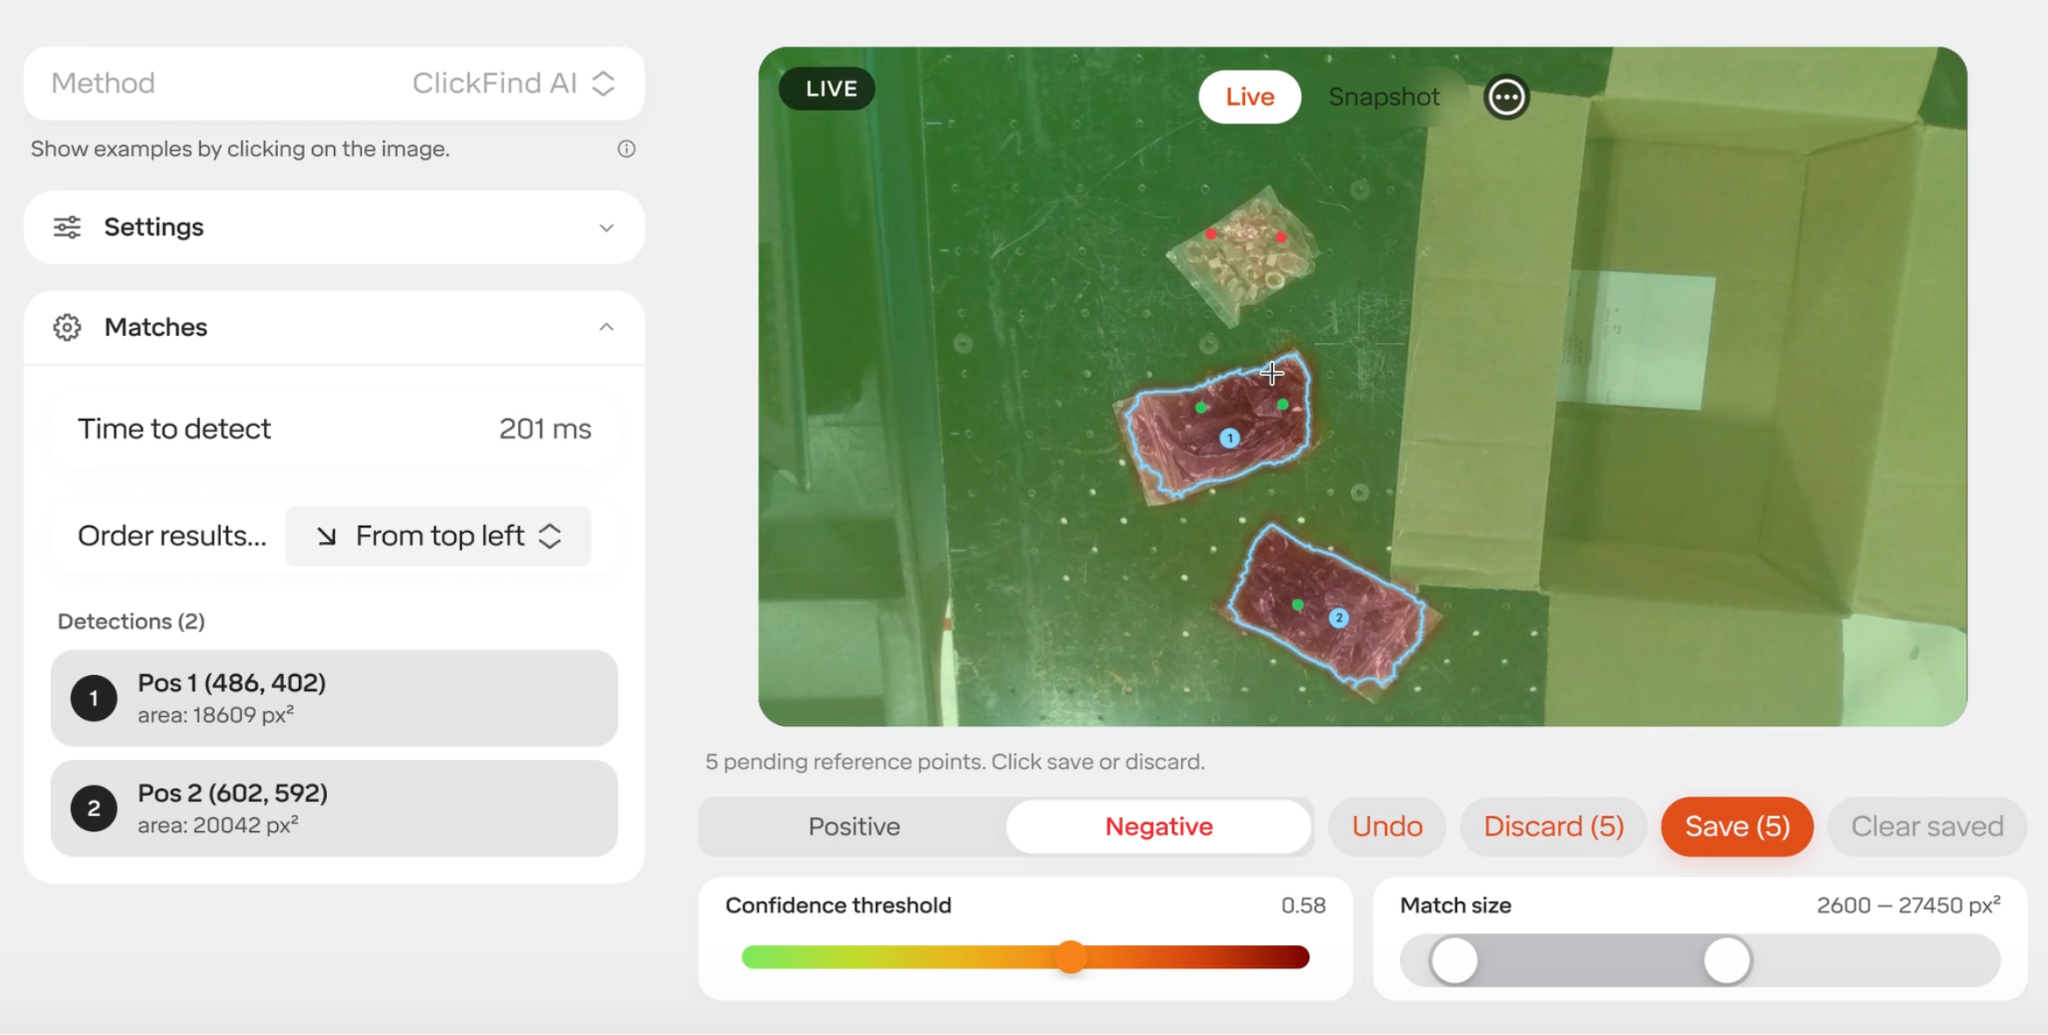 使用 ClickFind 设置零件识别。
Beard 指出,Standard Bots 专注于短周期任务,以满足生产对节拍时间和可靠性的要求。对于工作流中不需要学习行为的部分,该公司采用传统编程方式。
Beard 表示,模型训练在云端进行,但推理在本地运行。
模型具体做什么?
我询问 Jentoft,在一个典型的机器人作业流程中,学习到的模型具体负责什么,以及工作流的哪些部分使用了传统编程?
作为示例,他提到了其针对多品种小批量制造(high-mix manufacturing)的机床上下料解决方案。
“我们构建了一个零样本(zero-shot)系统,允许用户告诉机器人在特定任务中寻找哪些零件。模型负责感知——即定位和识别零件——而传统编程则处理运动控制以及周边的单元逻辑。”
以下是机床上下料的演示:
Jentoft 说:“该任务的骨干网络(backbone)基于超过十亿张图像进行训练,这使得机器人能够区分不同的光照条件、材料类型,并将物体与其背景分离开来。”
完整的 AI 技术栈
早在四月,我们就邀请了 Applied Intuition 参与播客节目,讨论 “物理 AI”(Physical AI) 及其与屏幕内 AI 的区别。其中一个关键认知是:物理 AI 不仅受限于模型的智能水平:真正的难点在于将模型部署到真实硬件上,并需同时满足安全性、延迟、功耗、成本和可靠性等约束条件。
但对于 Standard Bots 而言,这也可以成为一种优势,因为它掌控着从软件到硬件的“全栈”。Jentoft 指出,公司自主控制机械臂、末端执行器、控制系统以及 AI。
“这让我们能够协同优化模型与控制策略,”他说。“尽管其他地方有各种说法,但目前没有任何模型是真正硬件无关的,而底层控制与高层功能的协同优化,在性能和迭代速度方面都是一个巨大的优势。”
Skild 是一家致力于构建 “通用机器人智能” 的公司,它或许会对“硬件无关”这一说法提出异议——其目标是实现 跨硬件泛化。
本地推理:传感器、边缘 GPU 与“动作块”
Beard 曾提到,推理是在本地完成的,这对核心客户——工厂而言尤为重要。
“对于工厂来说——这也是我们目前业务的主要部分,而且我们看到那里蕴含着巨大的机遇——你需要在本地进行推理,”他说。
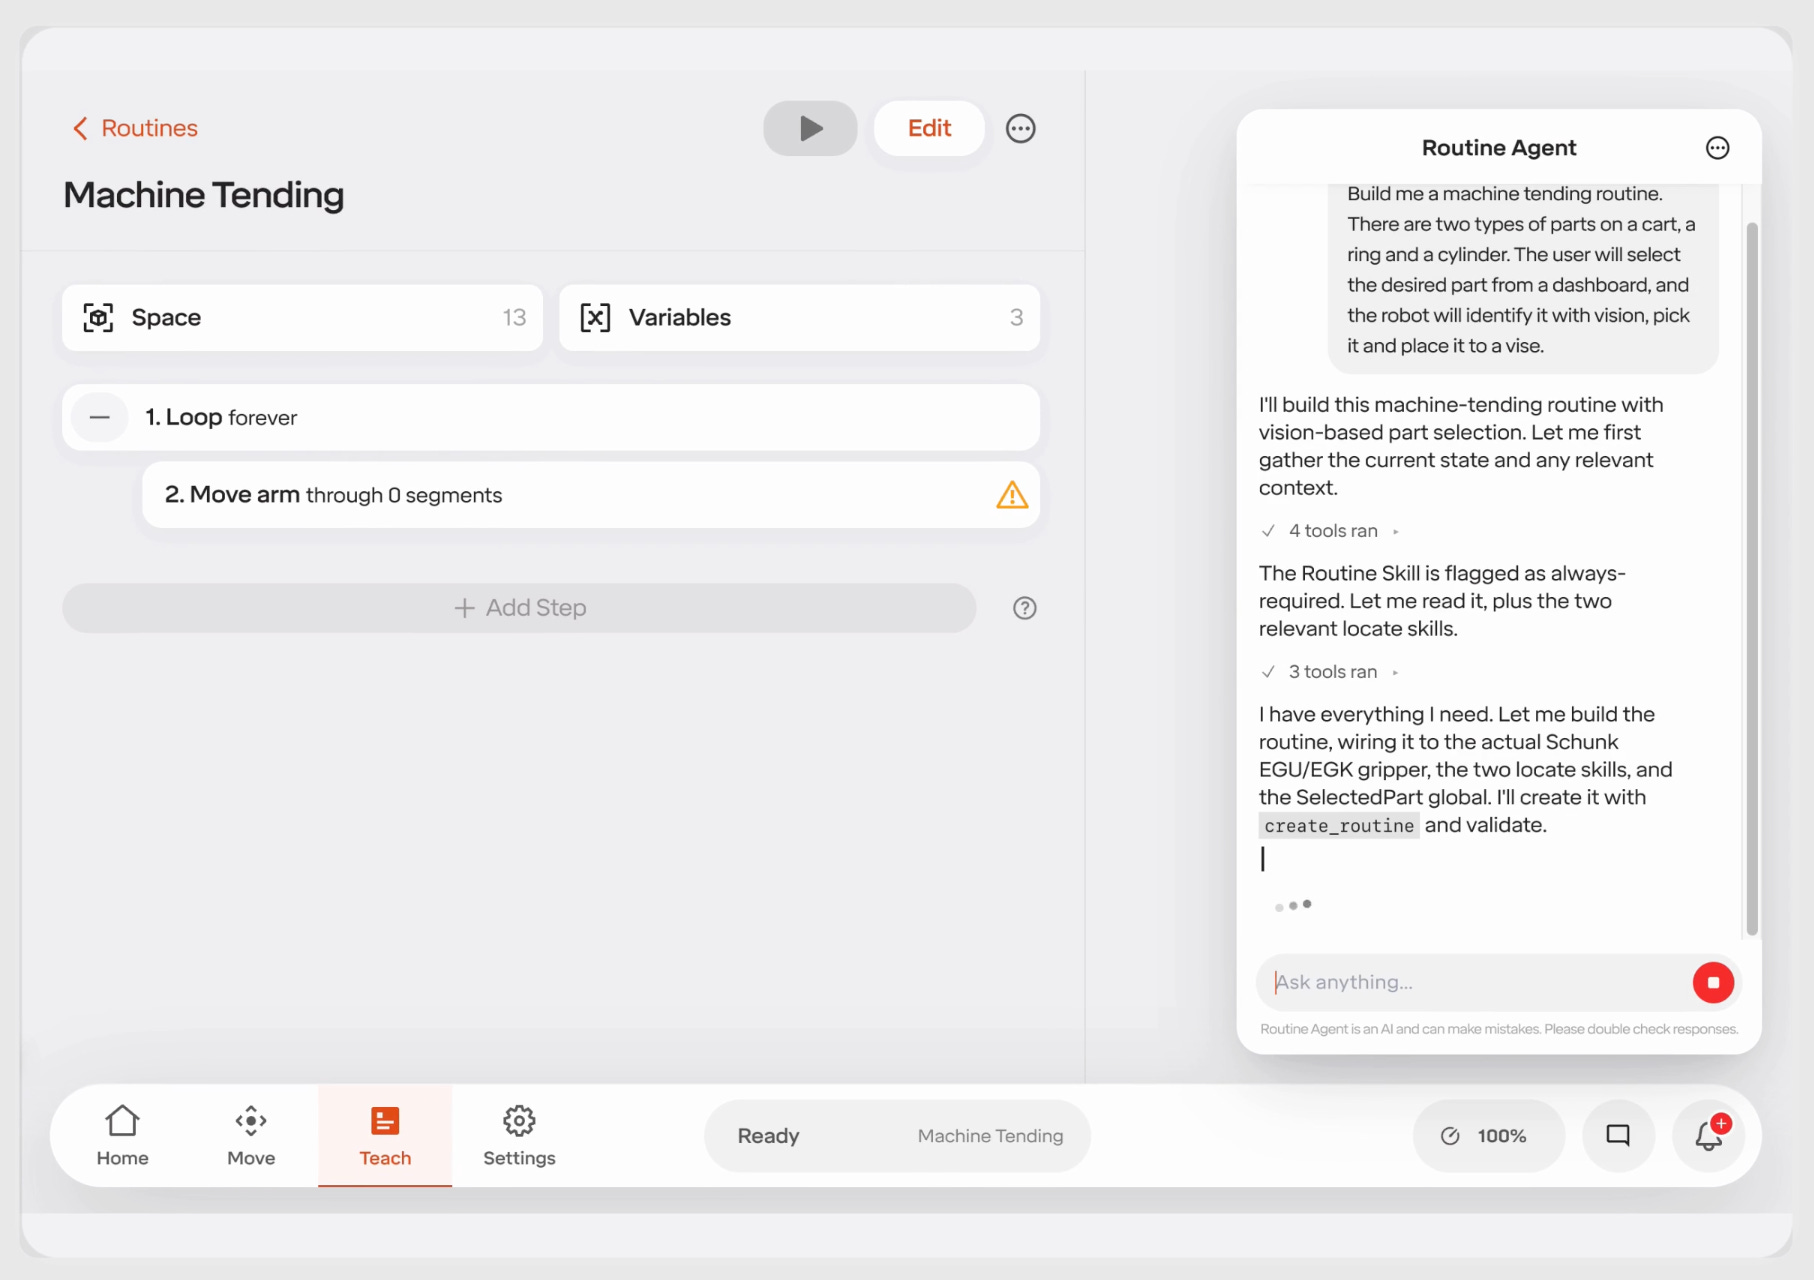 一个正在构建机床上下料例程的 AI 智能体。
在机床上下料场景中,模型负责识别零件,而传统编程则处理运动控制。Jentoft 还描述了模型如何生成动作并输入到机器人的控制系统中。
“腕部相机和其他 传感器 通过 内部千兆以太网 将原始像素和信号馈入系统,并在内部路由,从而避免线缆缠绕,”他解释道。“位于 边缘的 GPU 处理这些数据以生成 动作块(action chunks),随后将其流式传输至底层控制。”
他强调,推理刻意选择在本地运行。
“云算力用于机器人领域在运营上极其困难——大多数工厂和仓库没有可靠的互联网连接,对于移动机器人而言更是如此。正常运行时间对客户接受度至关重要,因此我们将闭环保持在本地。”
生产故障与车队学习
Standard Bots 尽可能使用仿真,但 Beard 表示,某些生产任务——包括涉及液体、吸附或切割柔性材料的任务——在当前仿真器中难以复现。
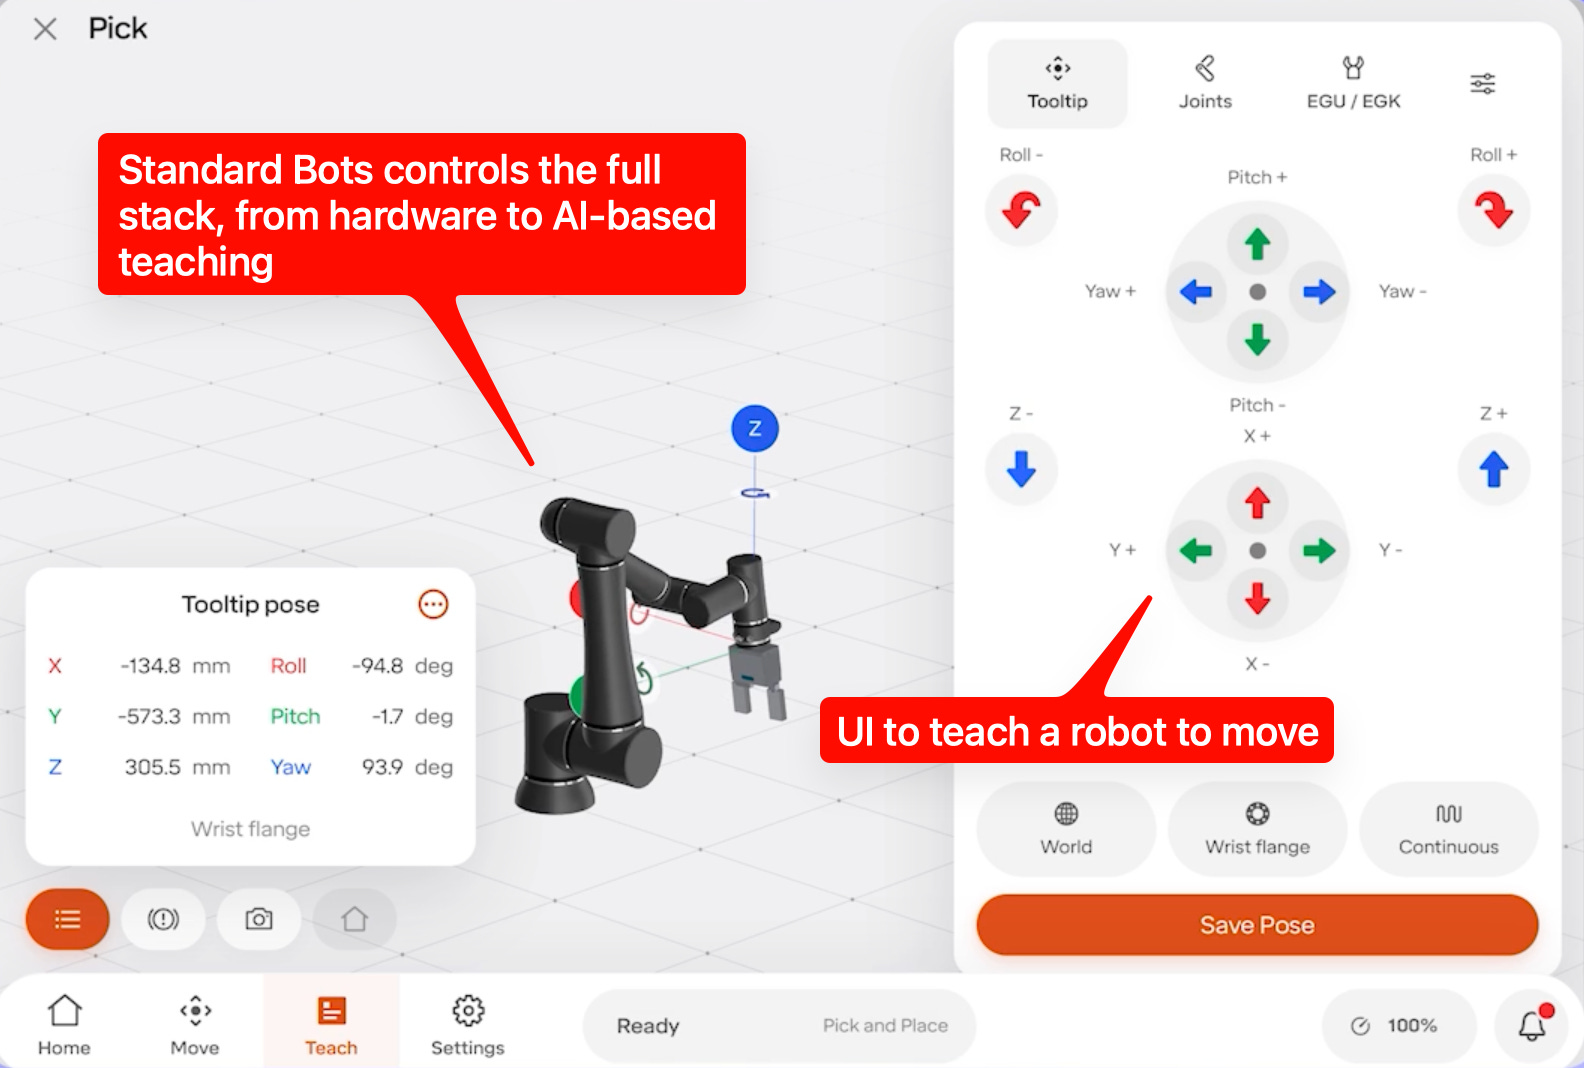
真实世界的演示是学习过程的另一部分。以下是使用手持触控设备教机器人的演示:
那么,它在机器人任务失败时如何处理?这些经验是否会回流到模型中?
Jentoft 回应道:“我们从部署环境中捕获失败信号和人工修正数据,而如何使用这些数据则取决于客户。”
他指出,其许多国防领域的客户“在物理隔离(air-gapped)的环境中部署,没有任何数据回传”。但对于非物理隔离环境的客户,“车队学习(fleet learning)能为他们自身的应用带来足够的收益,因此我们通常不会遇到因贡献数据以换取性能提升而产生的抵触情绪。”
StandardOS:一个 AI 机器人开发平台
Standard Bots 已经扩展了其平台,允许外部开发者使用。通过 StandardOS,它提供了一套 API 和 SDK。
据 Beard 介绍,开发者可以使用 Standard Bots 的 API,利用其技术栈中的任意部分来构建机器人应用,包括引入自己的模型。他举例提到了 NVIDIA Cosmos,这是一个面向物理 AI 的开放全模态世界模型家族(版本 3 已于五月底发布)。
目前,这需要开发者自行编写集成代码。但 Standard Bots 计划简化在其机器人上收集数据、训练模型以及部署模型的过程。
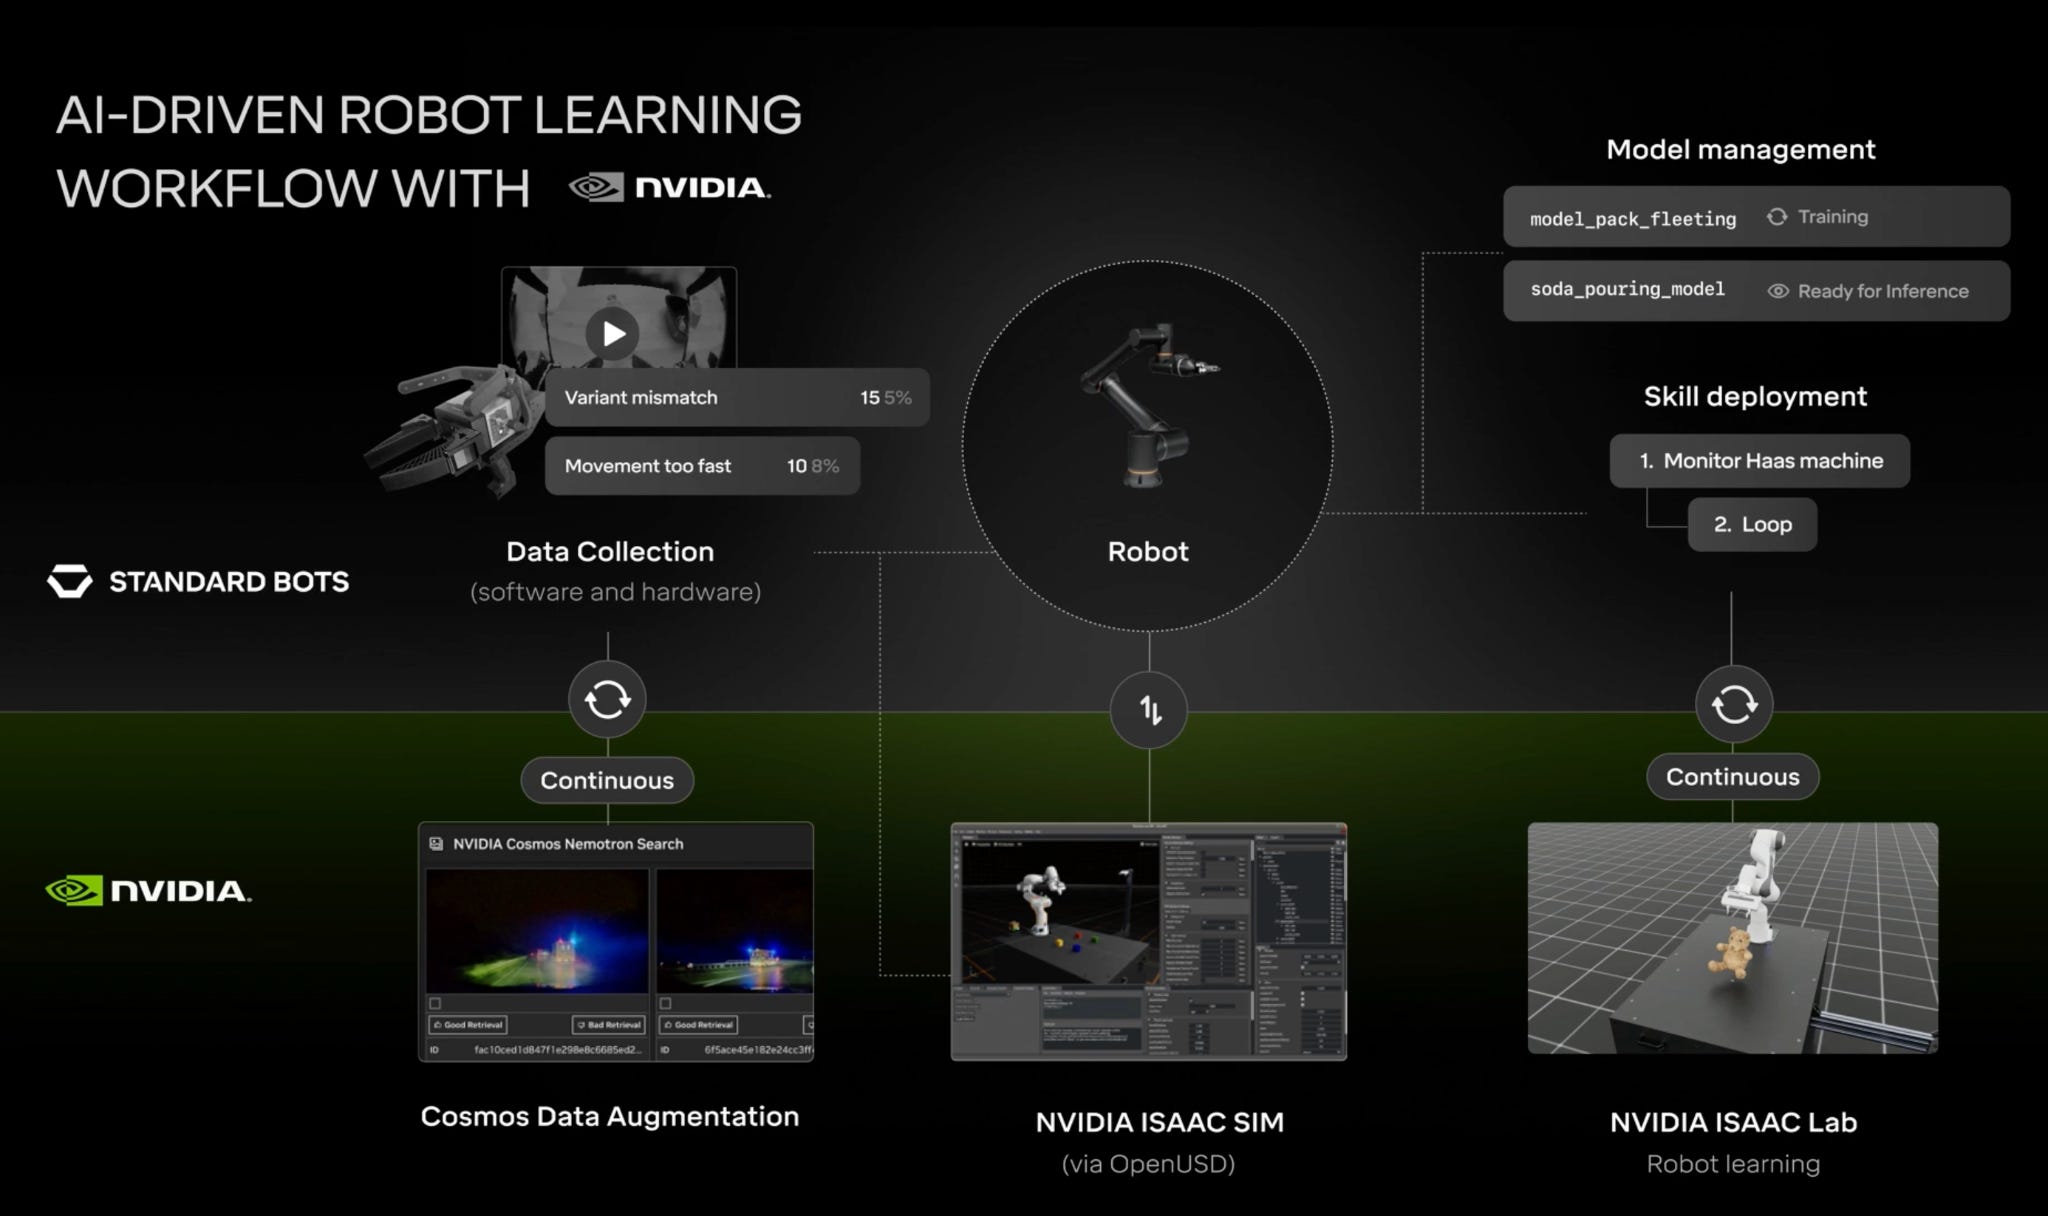 基于 NVIDIA 软件的 AI 机器人学习工作流;图片来源:Standard Bots。
聚焦于定向数据
Standard Bots 并不是当下最引人注目的机器人公司,但它已经在 NASA、亚马逊、洛克希德·马丁等企业的工业自动化场景中得到了部署。
对于 AI 工程师而言,或许最有价值的经验在于 Standard Bots 如何将 AI 适配到特定任务中。它保持模型角色的专注性,并利用来自实际部署的修正数据来解决边缘案例(edge cases)。当然,你也可以将同样的方法应用于软件智能体。
正如 Jentoft 所说——这也是 Jev 最近的一个教训——关键在于“从定向数据中挖掘最大价值,而不是盲目追求尽可能大的数据集”。