Artificial Analysis 发布 Code2Video-AA 基准 Claude Opus 5.5 领跑视频生成
Artificial Analysis 推出独立实现的 Code2Video-AA 基准,用于评估大模型通过代码生成营销视频的能力。Claude Opus 5.5 以显著优势位居榜首,但成本约为 GPT-6.1 Sol 的十倍。该基准基于 114 个设计简报和超过 35,000 次成对比较,从五个维度计算 Elo 评分。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-10-26 22
介绍 Code2Video-AA,这是我们对 HeyGen 的 Code2Video Bench 的独立实现,旨在评估模型通过代码创建产品和品牌营销视频的能力。
Code2Video-AA 在 114 个设计简报上测试模型,要求它们将每个产品或品牌营销简报转化为 @HyperFrames_ HTML 组合,然后我们将这些组合渲染为视频。模型输出通过与其它模型输出的成对比较进行评估,涵盖五个维度:吸引力(Engagement)、提示意图(Prompt Intent)、构图(Composition)、时间一致性(Temporal Consistency)和工艺(Craft)。我们利用这些比较结果计算每个维度的 Elo 评分,然后取平均值以生成主要的 Code2Video-AA Elo 分数。Code2Video-AA 是与 @HeyGen 合作开发的。
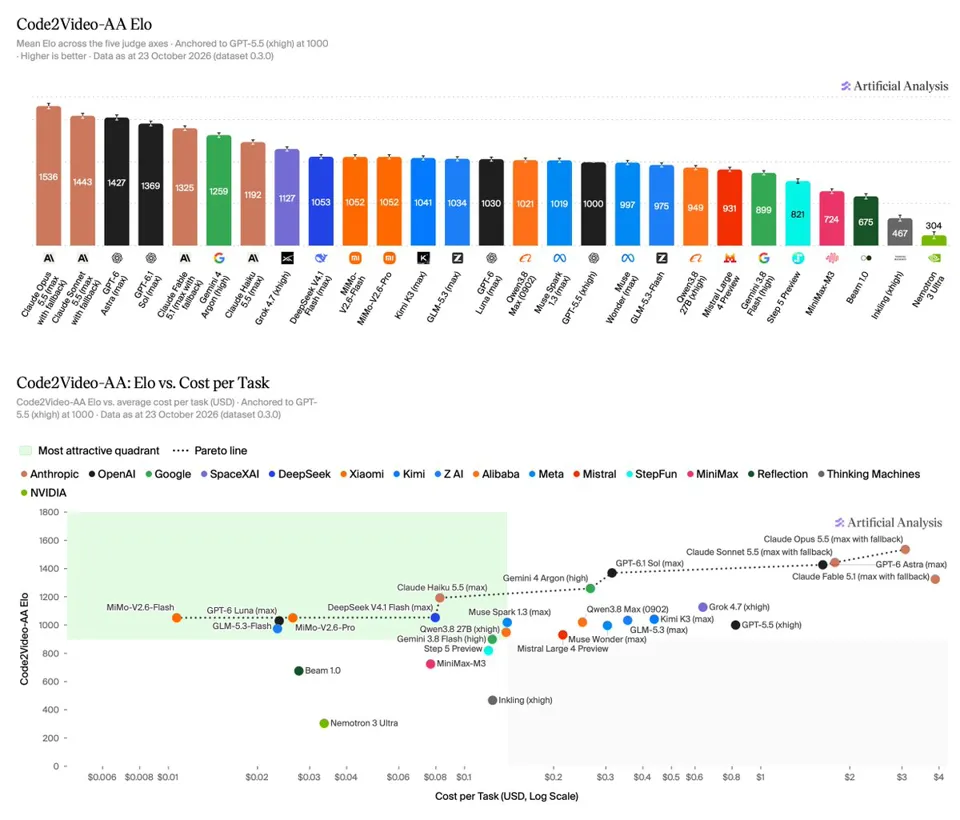
Claude Opus 5.5(最大配置含回退机制,1536 分)在 Code2Video-AA 中领先 93 分,但每项任务成本为 $3.08,约为 GPT-6.1 Sol(最大配置,1369 分)的 10 倍,后者落后 167 分。
主要发现:
➤ Claude Opus 5.5 在所有五个评判维度上均处于领先地位: 模型在 5 个维度上进行评判:吸引力、提示意图、构图、时间一致性和工艺。Claude Sonnet 5.5(最大配置含回退机制,1443 分)和 GPT-6 Astra(最大配置,1427 分)在总分上统计并列第二。
➤ 每项任务的成本差异超过 300 倍,从 $0.01 到 $3.89 不等: 排名第四的 GPT-6.1 Sol(最大配置)每项任务成本为 $0.31,比 Claude Opus 5.5(最大配置含回退机制)的 $3.08 低约 90%。
➤ 开放权重模型至少落后 483 分: DeepSeek V4.1 Flash(最大配置,1053 分)、MiMo-V2.6-Flash(1052 分)和 MiMo-V2.6-Pro(1052 分)是领先的开放权重模型,每项任务成本在 $0.01 到 $0.08 之间。
Code2Video-AA 详情:
➤ 模型在不使用工具的情况下仅进行一次响应测试。我们使用 HyperFrames 进行渲染,且无网络访问权限。
➤ 评判员(Gemini 4 Argon,高配置)在五个维度上对视频对进行比较:吸引力、提示意图、构图、时间一致性和工艺,最终得分由各个维度 Elo 的组合计算得出。
➤ 超过 35,000 条裁决根据 Elo 对 27 个模型进行排名,并附带 95% 置信区间。
更多结果、示例视频以及 Code2Video-AA 的工作原理详见下方推文串。