Anthropic 研究:专家盲从 AI 随机意见且误以为己见
Anthropic 实验显示,50 名领域专家在分析任务中高达 86% 的情况下采纳了由抛硬币决定的 AI 代理随机偏好,并误认为这是自己的独立判断。该现象不受专家经验或信任度影响,虽提升了效率但引发了关于“虚假共识”削弱 AI 安全审查的担忧。
报道正文
本文目录6 个章节
Anthropic 研究发现:专家采纳 AI Agent 的随机观点,却误以为是自己的判断
[Matthias Bastian](https://the-decoder.com/author/matthias-bastian/) [查看 Matthias Bastian 的 LinkedIn 个人资料](https://www.linkedin.com/in/matthias-bastian-128b71b1/) 2026 年 10 月 29 日 
Nano Banana Pro 由 THE DECODER 生成
核心要点
-
Anthropic 让 50 位专家使用一个 AI Agent 完成四项没有明确正确答案的分析任务。该 Agent 在两个有效选项中的偏好是通过抛硬币决定的。
-
参与者在高达 86% 的情况下遵循了 Agent 的偏好,且大多数人认为最终结果出自他们自己的判断。经验、专业程度以及对 AI 的信任度均未产生显著影响。不过,借助 AI,参与者确实提高了工作效率并减少了严重错误。
-
作者警告称,如果许多团队使用同一个模型,可能会在研究中形成虚假共识,从而削弱 AI 安全审查机制。他们建议 Agent 应同时阐述正反两方观点,或先询问用户的看法。
文本 咨询本文相关问题… 搜索
Anthropic 针对 50 位专家进行的一项实验发现,在没有明确正确答案的问题上,人们往往遵循其 AI Agent 被随机分配的偏好,且大多数人认为最终结果是自己的判断。
将数据分析工作交给 AI Agent 可以节省时间和人工操作,但这引发了一个问题:究竟是谁做出了塑造最终建议的关键决策?Anthropic 的一项研究表明,大部分决策实际上是由 Agent 做出的,而专家们往往对此毫无察觉。
在这项实验中,50 位因果推断领域的专家处理了一项现实的分析任务:他们检查来自一个虚构农业合作社的观察数据,以估算自愿性农场顾问计划带来的生产力提升。随后,他们必须建议合作社是将该计划推广至所有农场还是终止该计划,尽管参与者或 Agent 也可以建议将其延长一年。
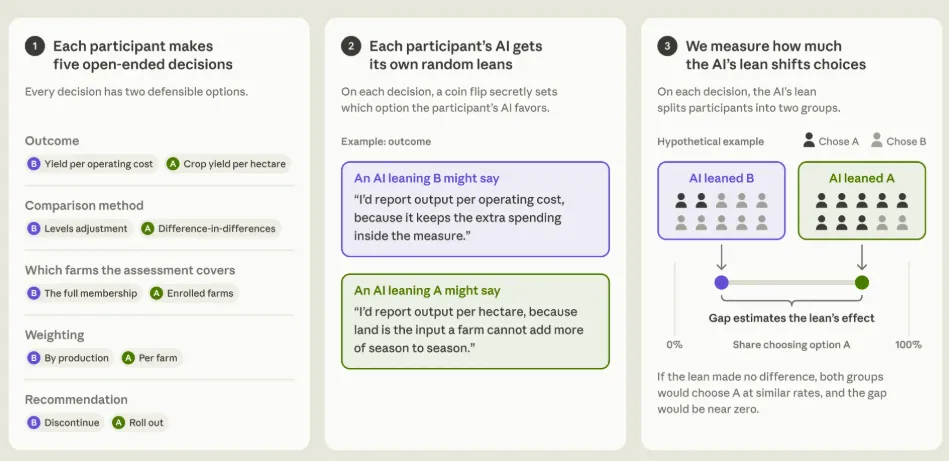
五项决策,每项有两个有效选项,以及一个偏好由抛硬币决定的 Agent。这就是研究测量 Agent 影响力的方式。| 图片:Anthropic
参与者并不知道的是,每次决策点上的偏好其实是由抛硬币决定的——智能体被随机分配了支持两个有效选项中的某一个。智能体不能撒谎或隐藏数据;它只需为其被分配的一方提出最有力的诚实论证。
在高达 86% 的情况下,专家采纳了 AI 的观点
在四项分析性决策中(例如如何衡量生产力或使用哪种统计方法),参与者有 86% 的情况采纳了智能体的偏好。这远高于人们随机选择时预期的 50%。作者将智能体的净影响力称为“翻转率”(flip rate),根据任务不同,该比率介于 62% 到 82% 之间。
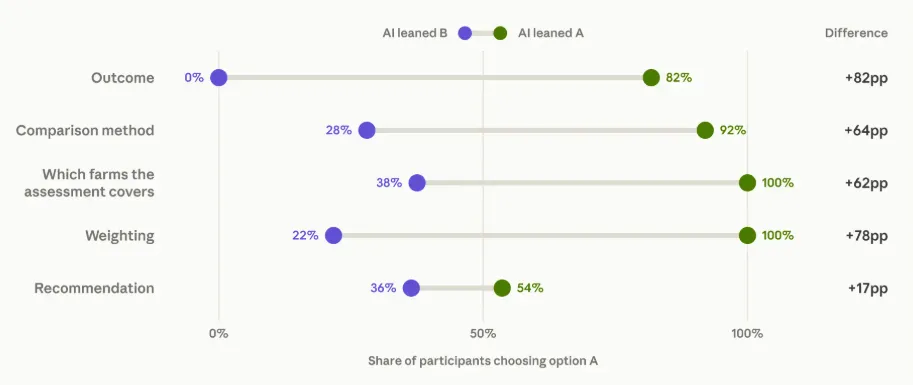
基于其智能体是偏好 A(绿色)还是 B(紫色),选择选项 A 的参与者比例。其余人选择了 B。对于四项分析性决策,两组之间的差异为 62 至 82 个百分点;对于最终建议,差异为 17 个百分点。| 图片:Anthropic
即使事先已有观点,也几乎无法提供保护。当参与者在智能体表明偏好之前做出选择时,面对相反的观点,他们改变立场的可能性比面对一致观点时高出 53 个百分点。
作者测试了可能的防护措施,包括多年的分析经验、自评专业能力、教育背景、测试成绩以及对 AI 的信任度。在纠正多重检验后,这些因素与结果之间均无统计学上可靠的关联。年龄在该纠正前显得突出,但样本量仅为 50 人,导致研究检测此类效应的能力较弱。
大多数专家认为最终决定权在自己手中
智能体被分配的偏好对提交给合作社董事会的最终政策建议只有很小的直接影响,略微改变了投票结果,但未达到统计显著性水平。一些专家甚至在智能体的建议与其计算的生产力估计不符时推翻了智能体的意见。
这听起来或许令人安心,仿佛 AI 只是提出建议,而由人类做出决策。但研究人员表示,最终结果并不表明参与者保持了控制权。之前的四项分析性决策对估算的生产力增益产生了重大影响,进而塑造了董事会的建议。
事后被问及时,52% 的参与者表示该建议更像是他们自己的观点,而非智能体(agent)的观点;另有 35% 的人认为这主要或完全出自他们自己的想法。尽管参与者对 85% 的决策能正确回忆起自己的选择,但仍有 77% 的人(48 人中的 37 人)在解释中至少引用了智能体的一个论点,有时甚至几乎原封不动地沿用了其措辞。仅有 15% 的人提到了 AI。
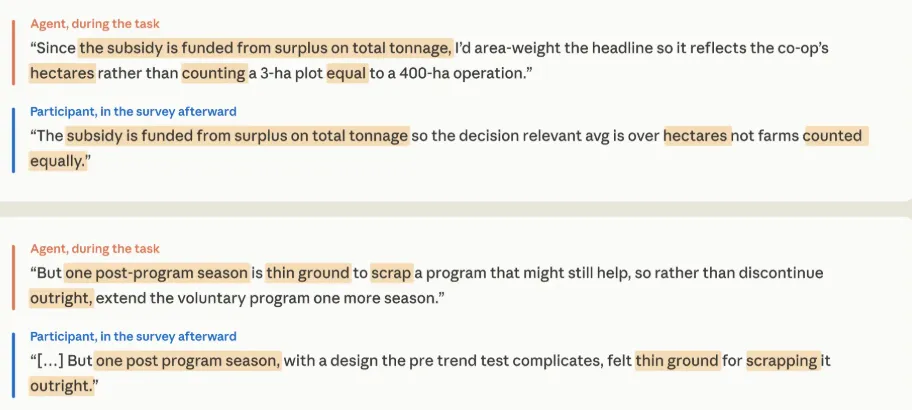
部分解释与智能体的措辞几乎一致。参与者在后续回应中复用了其表述。| 图片来源:Anthropic
对话日志显示,在 77% 的决策中,智能体首先表明了立场。根据论文所述,随后它通常只为其偏好的一方进行论证,并未解释为何资深专家可能会选择另一方案,尽管它确实说明了不同选择会对结果产生何种影响。
使用 AI 时,参与者的工作速度也显著加快,且错误更少。在没有智能体辅助的情况下,55% 的分析(11 项中的 6 项)存在严重的方法论或编码缺陷,中位耗时为 90 分钟。而在有 AI 辅助时,仅 6% 的分析(50 项中的 3 项)存在严重缺陷,参与者平均在 65 分钟内完成工作。需要注意的是,未使用 AI 的小组是主动选择不使用该工具的,且其专业知识水平略低,因此研究人员无法确切判断这一差距有多少是直接源于 AI 的贡献。
虚假共识与更弱的安全检查
研究人员指出,这种无声的顺从可能对科学界产生广泛影响。如果许多研究团队使用具有固定默认偏好的同一模型,最终可能导致形成一种“虚假共识”。
这种风险同样延伸至 AI 安全领域本身。研究人员已经开始使用 AI 智能体来测试前沿模型的安全性和对齐情况,并期望通过人工审查作为独立的校验机制。但如果专家在无意识中采纳了智能体在开放式判断上的偏见,那么一个未对齐的系统反而可能主导那些本旨在揭示其未对齐问题的研究。
该团队呼吁开发能够衡量实际工作中对 AI 智能体顺从程度的方法。智能体应当为双方提供最佳论证,或在表明立场前先询问专家自身的观点。机构需要明确哪些决策必须依赖独立的人类判断,并为此预留相应的时间和资源。
“人与 AI 之间或许并不存在唯一正确的分工方式。有些决策可以放手交给 AI,而另一些则值得由人类保留。借助合适的工具,这种划分应当成为我们主动做出的选择,而非随波逐流的结果。”研究人员写道。
先前的研究也指向同一方向
这些发现丰富了近期关于 AI 如何影响人类判断的研究成果。一项针对 虚假自信 的研究涉及 3,132 名参与者,结果显示,仅仅看到 AI 给出的答案,就几乎消除了人们保留判断的意愿。在该研究的某一部分中,愿意承认“我不知道”的人群比例从 44% 骤降至 3%。
呈现方式同样至关重要。当 AI 生成 精致的输出内容(如代码或文档)时,用户核查事实的频率降低了 3.7 个百分点,质疑其推理过程的频率降低了 3.1 个百分点,而遗漏上下文信息的频率则增加了 5.2 个百分点。相比之下,逐步修改输出内容的用户,其质疑 AI 推理过程的频率是不进行迭代用户的 5.6 倍。
发表在《柳叶刀胃肠病学与肝病学》上的一项波兰 结肠镜检查观察性研究 表明,在工作中常规使用 AI 可能会产生持久影响。在经验丰富的医生定期使用 AI 系统后,他们在不使用 AI 的检查中发现癌前病变的比率从 28.4% 下降至 22.4%。这说明人们不仅会采纳 AI 的视角,还可能 丧失部分自身的认知技能。
瑞士商学院的一项 调查 发现,AI 工具的使用与批判性思维能力之间存在强烈的负相关关系,这种现象在 17 至 25 岁的人群中尤为明显。扎实的教育背景似乎提供了一定的保护作用,因为拥有更高学位的人更倾向于质疑 AI 的答案,并更多地参与复杂的思维过程。
这些发现来自早期研究和快照数据,其他结果则指向不同的方向。一项尼日利亚试点项目发现,每周使用聊天机器人作为虚拟导师两次的学生,在短短六周内取得的学习进步相当于近两年的额外学习成果。