Artificial Analysis (@ArtificialAnlys) · 2026/10/14 00:34:38
Artificial Analysis 发布决策模型基准:Jev 在分类与工具调用中成本仅为大模型十分之一
Artificial Analysis 推出首个专门针对“决策模型”(Decision Models)的基准测试指数 v1.0,涵盖知识、推理、分类及工具调用能力。数据显示,专用决策模型如 Jev 在结构化输出任务中具备显著的速度和成本优势,尽管通用大模型(如 Claude Haiku 5.5)准确率略高,但成本高出数倍且延迟更高。该基准旨在帮助开发者在特定场景下权衡使用轻量级决策模型还是重型语言模型。
报道全文原始报道全文
Artificial Analysis (@ArtificialAnlys) · 2026-10-13 16
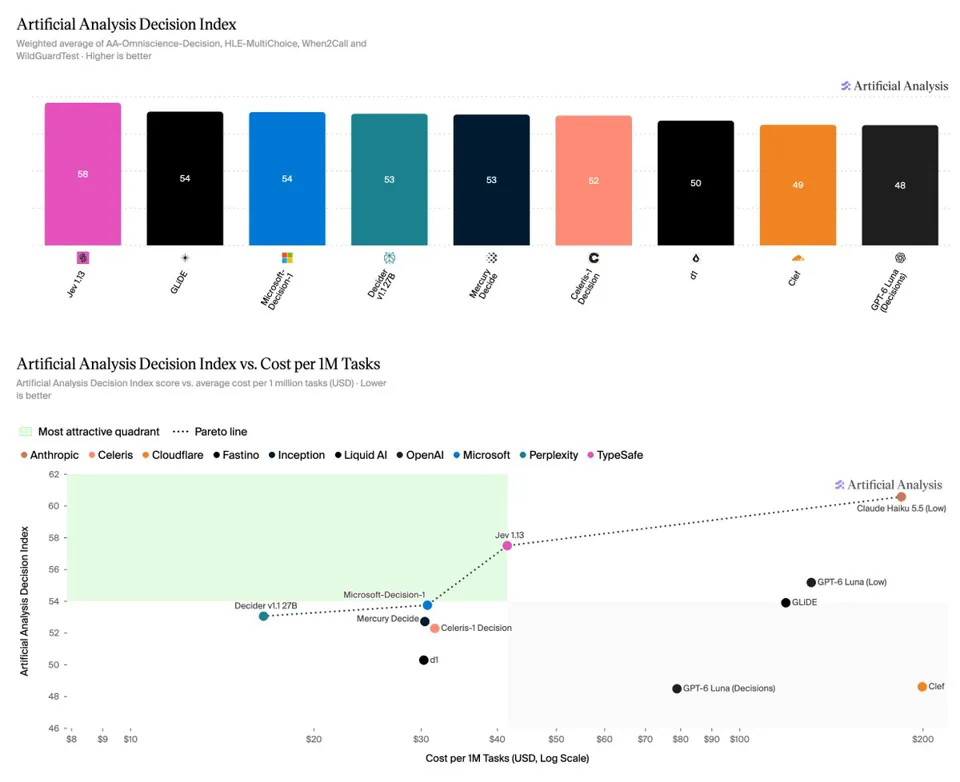
隆重推出 Artificial Analysis Decision Index(决策指数),该基准测试涵盖分类、工具调用、知识及推理能力。在决策模型中,Jev 表现领先;尽管 Claude Haiku 5.5 等语言模型的准确率更高,但其成本和延迟也显著增加。
决策模型能够输出带有相关概率的结构化答案或分类结果,相比使用语言模型,可提供更快的响应速度和更低的成本。Artificial Analysis Decision Index v1.0 对比了决策模型的能力、成本和速度,并将其与语言模型进行了比较。
Artificial Analysis Decision Index v1.0 中的基准测试包括:
➤ AA-Omniscience-Decision:一个包含 500 个问题的私有数据集,改编自专有的 AA-Omniscience 基准测试,用于衡量决策模型的知识水平及幻觉倾向
➤ HLE-MultiChoice:来自 Humanity’s Last Exam(人类最后考试)的 513 道纯文本多选题,测试决策模型的推理能力
➤ When2Call:NVIDIA 推出的工具调用基准测试,评估模型能否正确决定是调用工具、请求澄清、拒绝回答还是直接回复,考察与 agentic workflows(智能体工作流)和 tool routing(工具路由)相关的能力
➤ WildGuardTest:一项安全基准测试,评估模型在有害用户请求、助手拒绝回应以及有害回复方面的分类能力。我们使用了原始 1,725 行测试数据中的 835 行子集,这些数据在所有三个标签上均获得三位人类标注者的一致同意,并排除了那些持续触发模型拒绝回答的问题
关键结果:
➤ Jev 1.13 领跑 Decision Index,并位于 Capability vs. Cost(能力与成本)帕累托前沿:@typesafeai 的 Jev 1.13 在 Artificial Analysis Decision Index 中得分 58,领先于 @fastinoAI 的 GLiDE(54 分)和 @Microsoft 的 Microsoft-Decision-1(54 分)。@perplexity_ai 的 Decider v1.1 27B 每百万任务成本最低,为 17 美元,而 Microsoft-Decision-1(31 美元)和 Jev 1.13(42 美元)同样位于能力与成本的帕累托前沿。Celeris-1 Decision 的单任务耗时最短,仅为 0.06 秒,比 Jev 1.13(单任务 0.13 秒)快两倍以上
➤ 决策模型在知识与推理任务上的校准度较差:在所有被选答案的概率水平上,几乎所有决策模型的准确率均低于其对应的概率值。这一差距在 AA-Omniscience-Decision 和 HLE-MultiChoice 基准测试中最为显著,而大多数模型在 WildGuardTest(分类)和 When2Call(工具调用)任务上的校准表现相对较好
➤ 决策模型相比语言模型具有显著的速度和成本优势,但在知识与推理方面表现落后:在分类和工具调用任务中,领先的决策模型性能与语言模型相当,但速度更快、成本更低。然而,在知识和推理任务上,语言模型的表现大幅优于决策模型。Claude Haiku 5.5 (Low) 在 Decision Index 上得分为 61,比 Jev 1.13 高出 3 分,但其每项任务的耗时为 1.4 秒,而 Jev 1.13 仅为 0.13 秒(慢 11 倍);每百万次任务的成本为 184 美元,而 Jev 1.13 仅为 42 美元(贵 4.4 倍)
我们将持续开发 Artificial Analysis Decision Index,以帮助开发者和企业更好地理解何时以及如何应用决策模型。