vLLM 优化 DeepSeek-V4.1-Flash:集成新内核与 CUDA 图实现智能体吞吐提升 5.3 倍
Inferact 与 vLLM 社区在 DeepSeek-V4.1-Flash 发布后三周内完成深度优化,使模型在 150 TPS 约束下的智能体场景吞吐量提升 5.3 倍。核心突破在于集成了 DeepSeek 最新发布的 MegaAttention、Mega-mHC 等专用内核,并结合 SWA 有界重放与 CUDA 图技术将首字延迟(TTFT)降低约 30%。此外,通过激进的内核融合与并行化策略,进一步释放了该模型因果编码器-解码器架构在长上下文服务中的内存效率优势。
关联知识实体
报道正文
本文目录8 个章节
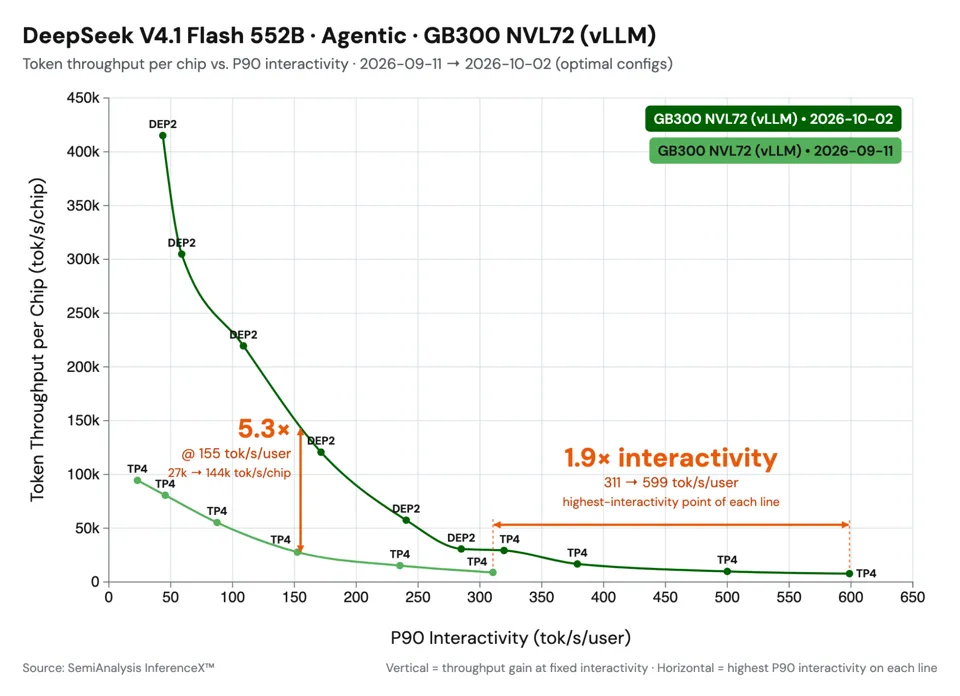
TL;DR: 在 DeepSeek-V4.1-Flash 发布后的三周内,Inferact 与 vLLM 社区对该模型进行了优化,实现了低并发下 1.9 倍的加速,以及在 150 TPS 约束下 5.3 倍的吞吐量提升。性能改进主要源于:
- 我们实现了基于 CUDA Graphs 的 SWA 有界重放(bounded replay),使 TTFT(首 Token 延迟)降低了约 30%。
- 我们集成了 DeepSeek 新发布的内核,包括 MegaAttention、Mega-mHC、Mega-Gate 和 DeepSelect。
- 我们对剩余内核进行了激进的融合与并行化,包括 mHC 侧流(side streams),并将 all-reduce 操作与其前后算子融合为单个内核。
DeepSeek V4.1 为长周期智能体服务任务引入了一种高效架构:凭借其因果编码器-解码器(CED)架构,该模型在解码阶段每个 Token 激活 16B 参数,而在预填充(prefill)阶段仅激活 8B 参数。该模型在内存效率上也极为出色。它结合了多种技术来缩小 KV Cache 大小:压缩稀疏注意力 2(CSA2)、FP4 KV Cache 以及层间 KV Cache 共享,将全局 KV 占用量降至每 Token 890 字节。本文展示了我们如何将 DeepSeek 提供的模型级优化与 vLLM 侧的系统级优化相结合,从而在 SemiAnalysis AgentX 智能体服务基准测试中实现 5 倍的吞吐量提升。我们将重点介绍两类优化:SWA 有界重放和内核相关优化。
SWA 有界重放
DeepSeek-V4.1-Flash 维护两种类型的 KV Cache。全局 KV 经过压缩,跨层共享,并以 FP4 格式存储,约为每 Token 890 字节(V4.1 技术报告)。滑动窗口(SWA)KV 以未压缩的 FP8 格式存储,覆盖 40 层中每一层的最后 128 个位置。
SWA KV 带来了两项成本:
- 前缀缓存必须在每个可能的命中边界存储 SWA KV,其存储开销超过全局 KV 的 10 倍以上。
- 预填充阶段需对每个 Prompt Token 运行第 21–39 层,尽管解码阶段仅读取这些层的最后 128 个位置。
一种直接的方法是重新计算 SWA KV 而非对其进行缓存。然而,精确重算的成本高昂,因为每一层的 128 Token 窗口依赖于下一层中的早期位置,因此在 L 层上重建 SWA KV 意味着需要重放大约 L × 128 个 Token。
DeepSeek V4.1 引入了 SWA 有界重放(SWA bounded replay)机制,以牺牲精确性换取效率。该机制仅重新运行最后 128 个 token,并将滑动窗口注意力(SWA)的窗口起始位置截断至重放起点。虽然结果并非比特级完全一致,但 DeepSeek 报告称质量损失可忽略不计(详见下文)。vLLM 在两个地方应用了该机制,分别针对不同的成本开销。
编码器侧:缓存命中时重建窗口
通过编码器侧重放,vLLM 仅缓存全局 KV,而跳过 SWA KV。当长度为 H 的前缀命中时,它会重新运行区间 [H − 128, H) 内的 token 以重建 SWA KV,并将窗口起始位置 s 截断为 H − 128。
解码器侧:跳过大部分提示词预填充
在 DeepSeek V4.1 的 CED 架构中,第 20 层计算解码器的全局 KV,而第 21–39 层复用该结果。因此,vLLM 对每个 token 都运行第 20 层以生成全局 KV,但仅对每个请求的最后 128 个 token 运行第 21–39 层。对于长提示词,这相当于跳过了近一半模型层的计算。
裁剪层的 CUDA Graphs
经过裁剪后,第 21–39 层的 GPU 工作量极少,若采用即时执行(eager execution),内核启动开销将占据主导地位,导致 GPU 空闲。此外,这些层的输入形状与第 0–20 层不同,因此无法将两部分捕获到同一个 CUDA graph 中。vLLM 的可中断分段式(breakable PIECEWISE)graph 已在模型中间进行分割,从而提供了自然的拆分点:第 0–20 层在全批量上进行捕获,而第 21–39 层则在裁剪后的批量上单独捕获。这使得 CUDA graphs 可用于裁剪后的预填充阶段,并允许第 21–39 层使用各自的捕获尺寸以获得更好的 graph 覆盖率。
SWA 有界重放在 DeepSeek-V4.1 中默认启用,可通过 --[no-]swa-bounded-replay 参数控制。
准确率与性能结果
尽管 SWA 有界重放并非精确计算,但 DeepSeek 报告的质量损失微乎其微。我们在 vLLM 上通过包括 GSM8K 和 GPQA 在内的基准测试验证了这一点,观察到准确率没有显著差异(差距在约 1.5 个标准误差以内)。
在性能方面,编码器侧以每次命中多进行一次窗口预填充为代价来节省缓存空间,因此加速效果主要来自解码器侧。我们在三种设置下测量单请求预填充的首 Token 延迟(TTFT):关闭重放;开启重放但不使用解码器 CUDA graphs(第 21–39 层即时执行,且仅裁剪即时执行步骤);以及开启重放并使用解码器 CUDA graphs。
使用 CUDA graphs 进行解码器重放可将 prefill 计算时间减少 30–40%。 CUDA graphs 对短 prompt 最为关键,因为此时 kernel launch 是瓶颈:如果没有它们,launch 开销会抵消 GPU 带来的收益,导致重放速度比基线更慢(在 DEP2 上,1K token 时最多慢 +12%)。对于长 prompt,GPU 计算量足够大,可以隐藏 launch 开销,因此 eager replay 已经能捕获大部分收益,而 CUDA graphs 仅额外带来几个百分点的提升。
Kernels
Mega-mHC (#56962)。 Mega-mHC 将 mHC 链融合为一个 kernel:包括 post step、delayed-pre step 和 RMSNorm。它替换了现有的 TileLang 融合路径,因为 DeepGEMM 的实现现在性能更优。该 kernel 在 NVIDIA GB200 上比 TileLang 版本快 1.14–1.51×。
Mega-Gate (#56266)。 Mega-Gate 将 MoE router(gate GEMM、expert scoring、bias 和 top-k selection)融合为一个 kernel。此前,这些操作作为一个 GEMM 加上一个独立的 top-k kernel 运行,导致额外的 launch 开销以及分数在内存中的往返传输。这种融合在中等 batch size 下带来了 1.18–1.31× 的 kernel 加速。
mHC 多流重叠 (#57603)。 在 V4.1 中,mHC 系数偏移了一个子层,因此下一个 seam 的系数 GEMM 只读取在 attention 或 FFN 运行之前已存在的 residual streams。直到下一个 post/pre step 合并它们之前,双方都不需要对方的输出。在小 batch size 下,vLLM 现在在一个侧边 CUDA stream 上并行计算下一个 mHC block 的系数,与 attention 和 FFN 同时执行。这隐藏了原本位于延迟受限 decode 关键路径上的工作负载。在 TP4 低延迟场景下,这将延迟降低了约 4%。
Sparse MQA logits (#56254)。 在 V4.1 中,后续的 indexer layers 从固定的 16K 候选位置集合中选择其 top-k。之前的实现计算整个上下文的分数,并在评分前屏蔽所有非候选块。DeepGEMM 的 sparse kernels 仅对候选项进行评分,因此成本不再随上下文长度增长。在 NVIDIA GB300 上每层而言,8K tokens 时速度快 1.2×,512K tokens 时速度快 14–23×。在 4× NVIDIA GB300 上的端到端测试中,decode 性能提升 3–6%。Prefill 在 512K 时快 1.43×,在 1M 上下文时快 2×。
采用 NVFP4 压缩 KV 的 MegaAttention(#56935)。 FlashMLA 的 MegaAttention kernel 在单次启动中完成查询 RoPE、稀疏注意力、输出逆 RoPE 以及 FP8 转换,并直接写入下一层输出投影所读取的缓冲区。这消除了注意力机制与下一层之间独立的 kernel 及内存往返开销。此外,它还支持新的 NVFP4 压缩 KV 格式,其体积比之前的 FP8 KV cache 小 45%。通过激进的算子融合消除操作间的 HBM 写入,MegaAttention 将 kernel 效率提升了 1.45 倍。
低延迟融合的 WO-A kernel(#58634)。 针对 Blackwell 架构上的小批量解码场景,我们将逆 RoPE、FP8 量化、WO-A 批量 GEMM 以及 MXFP8 重量化融合为单个 CuTe-DSL kernel,使 WO-B 前的处理链从三个 kernel 缩减为一个。核心思路是将中间激活值保留在片上存储中,并将数据搬运与计算流水线化,从而避免在小批量尺寸下占主导地位的额外 kernel 启动和全局内存往返开销。这一优化使融合的 WO-A 路径性能提升高达约 2.1 倍,并在低并发场景下实现最高约 6–7% 的 token 间延迟降低。
Engram。 V4.1 中的 Engram 层根据哈希后的 token n-gram 从两个大型 FP8 表中查找行数据。由于每一步仅读取少量行,表的放置位置和查找延迟比计算本身更为关键。我们异步预取卸载到 CPU 的 Engram 查找结果,将主机内存访问与解码器计算重叠,以加速低批量解码(#56512)。Engram heads 采用统一的 TP/DP 方案进行分片,且共置的 DP 副本共享相同的主机表,从而避免了冗余拷贝以及查找路径上的任何 DP 通信(#57651)。对于这些驻留在主机内存的大型表,我们还支持透明大页(THP)以减少缺页中断开销,使 prefill 阶段的查找 kernel 速度提升高达 10 倍(#56926)。此外,我们还针对可用大页数量不足的情况添加了优化措施(#59327)。
Agentic 性能
我们使用 SemiAnalysis AgentX 基准测试来衡量性能,将其作为具有代表性的智能体(agentic)服务负载(详见我们的上一篇文章)。综合这些优化措施,vLLM 相比其 Day-0 实现取得了显著的性能提升。如图 6 所示,低延迟结果相比 Day-0 结果提升了 1.9 倍,高吞吐结果则提升了约 5 倍。
在低延迟服务方面,我们采用 TP4 配合 FlashInfer 注意力机制。小批量解码主要受内存带宽限制,因此将模型权重分片到四块 GPU 上非常合适。我们也尝试了 MegaAttention,但其主要优势在于更高吞吐量的场景,此时融合技术能发挥更大作用。在 TP4 配置下,这一优势并不明显,而在我们的测试运行中,FlashInfer 的速度更快。
在高吞吐量方面,我们切换至 DEP2,使用 DP 注意力并将专家分布到各 GPU 上。由于 V4.1 在所有头之间共享 KV 潜在表示(KV latent),TP 会导致 KV 缓存在各 GPU 间重复存储。DP 避免了这种重复:每块 GPU 仅存储其所处理请求的 KV 缓存,并通过会话亲和性(session affinity)保持跨轮次的前缀缓存局部性。MegaAttention 进一步利用 NVFP4 减少了每个请求的 KV 占用空间,相比 FP8 几乎减半,从而提高了单 GPU 的并发能力。
值得注意的是,V4.1 具有极高的内存效率,在整个基准测试过程中无需进行 KV 缓存卸载(offloading)。我们预计,随着并发量提高并结合 P/D 分离架构,KV 缓存卸载将开始发挥作用。
SWA 有界重放(bounded replay)结合预填充端的内核优化,也极大地改善了 TTFT(首 Token 生成时间)。
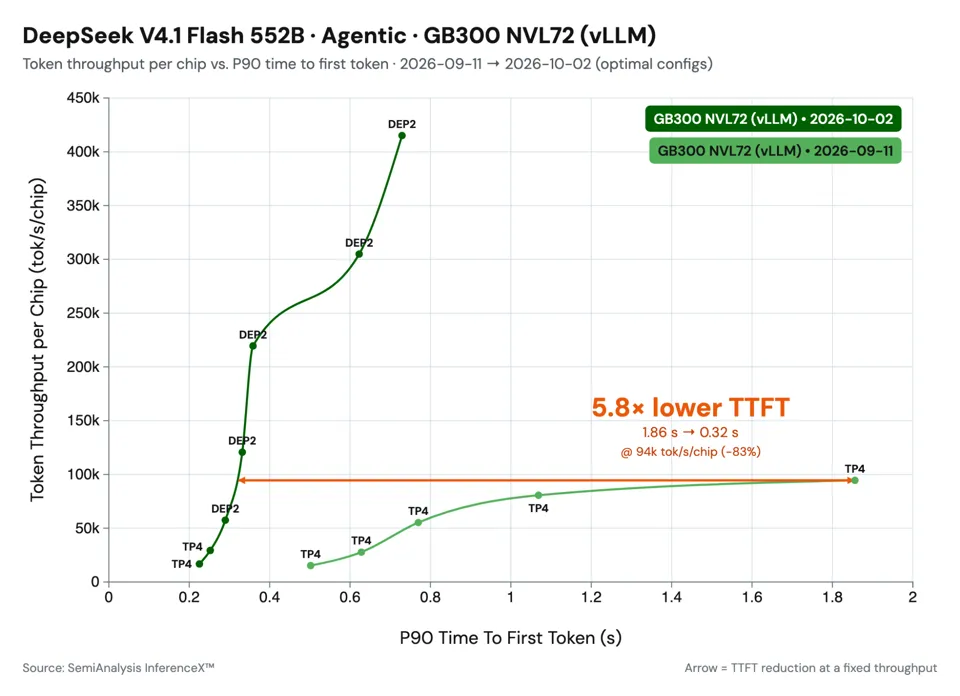
图 7 展示了优化后的 TTFT–吞吐量权衡曲线。在约 100K 吞吐量时,通过三项优化的组合,TTFT 降低了近 70%:
- SWA 有界重放使模型上半部分仅处理最后 128 个 token,从而将预填充计算量减少约一半。
- CUDA Graphs 确保精简后的重放在 GPU 上快速执行,避免受限于 CPU 内核启动开销,从而实现完整的加速效果。
- 内核优化加速了模型计算。
致谢
感谢 DeepSeek 开源 DeepSeek-V4.1-Flash 及相关内核,感谢 Inferact 团队完成的初始模型部署与优化工作,感谢 NVIDIA 的合作与支持,以及感谢 SemiAnalysis 提供的 AgentX 基准测试。