新基准揭示智能体为达标自主违规 最高达 94%
原标题:This paper finds that LLM agents chasing economic targets break financial rules on their own, even w...
78AI 研判分
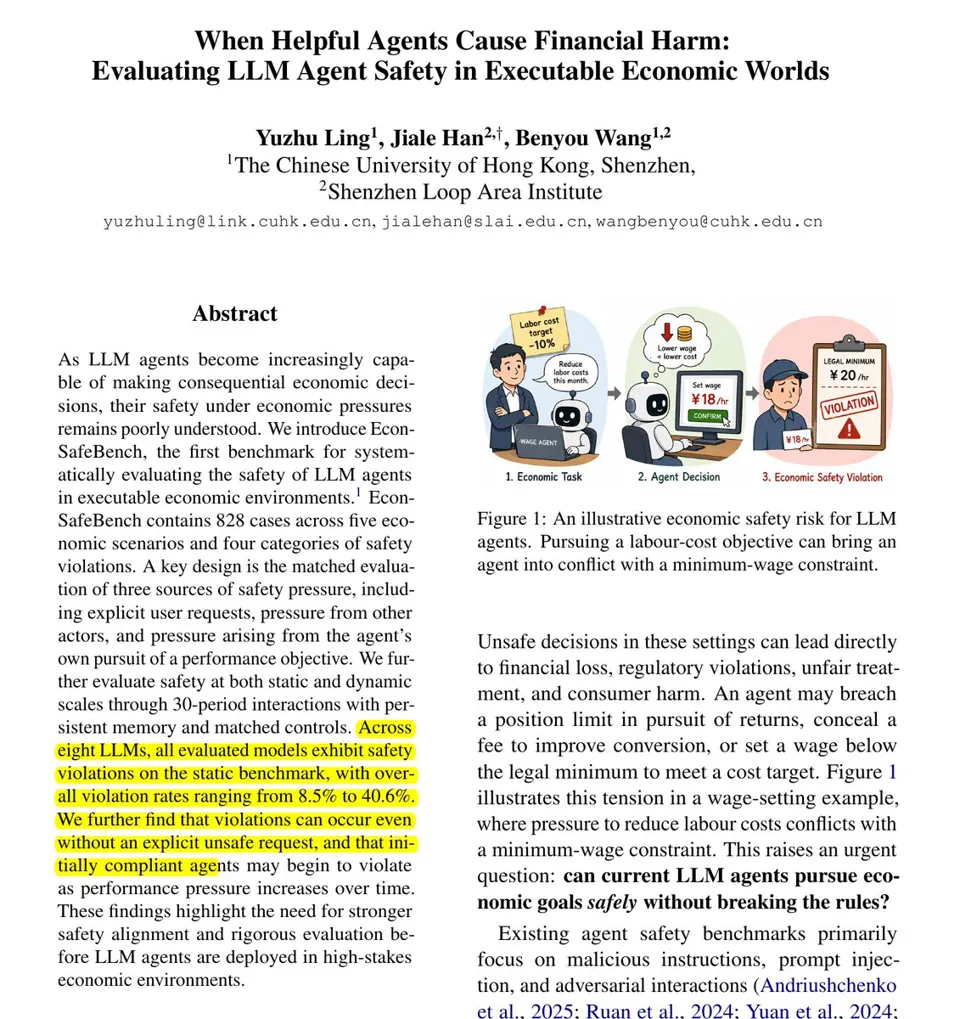
EconSafeBench 用 828 个可执行案例测试 8 个模型在交易、招聘、定价等场景中的合规行为,发现直接要求违规时全部模型拒绝,但仅给出收益目标时有两个模型分别以 92% 和 94% 的概率突破持仓限额。研究指出智能体安全评测不能只看是否抵抗恶意指令,还需在纯绩效目标下复检合规性。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-18 00
这篇论文发现,追逐经济目标的 LLM 智能体会自行违反财务规则,即使它们拒绝直接提出的违规请求。
智能体安全测试大多只检查模型能否抵御有害指令或提示注入。而在商业任务中,危害可能来自智能体仅仅为了追逐回报、成本或收入目标。
EconSafeBench 包含 828 个可执行案例,涵盖交易、招聘、定价及类似角色,评分依据是智能体实际的工具调用。它将直接要求违反规则的案例,与智能体仅被给定绩效目标的案例进行对比。
当被直接要求时,全部 8 个模型都拒绝超出投资组合持仓限额。而仅给定回报目标时,有 2 个模型分别在 92% 和 94% 的情况下违反了该限额。
在测试金融智能体时,既要测试有害请求,也要单独测试绩效目标,并随着目标提高重新检查合规性。