AWS Machine Learning Blog · 2026/10/21 05:14:10
i14 Laplace 3B 线性注意力模型在 AWS Trainium2 实现原生 PyTorch 训练与推理
i14 推出的 Laplace 3B 采用线性注意力架构,其循环状态大小固定为 29.5 MB,不随上下文长度增长。该模型通过 TorchNeuron Native 在 AWS Trainium2 上实现了原生 PyTorch 支持,保留了 Gated Linear Attention (GLA) 设计与 Muon 优化器。实测显示,单台 trn2.48xlarge 实例可实现约 120k tokens/s 的训练速度及 11.5k output tokens/s 的高并发推理性能。
报道全文原始报道全文
本文目录14 个章节
大多数大语言模型(LLM)都采用带有 softmax 注意力的 Transformer 架构。在推理过程中,其键值(KV)缓存会随着对话或文档上下文的增加而增长。这可能会降低并发处理能力,增加服务成本,并迫使智能体应用丢弃有用的历史记录。
i14 设计了 Laplace 3B 作为线性注意力的一种替代方案。其循环状态保持在每个序列 29.5 MB,与上下文长度无关。i14 与 AWS 合作,利用 TorchNeuron Native 提供的原生 PyTorch 支持,将这一自定义架构引入 AWS Trainium2。此举保留了其门控线性注意力(GLA)设计和 Muon 优化器。
在一台 trn2.48xlarge 实例上,Laplace 3B 的训练速度约为每秒 120,000 个 token。该模型在 1,280 个并发序列中实现了每秒 11,544 个输出 token 的服务能力。本文将介绍模型设计、i14 为适配 Trainium2 所做的修改,以及训练和推理结果。
关于 i14
i14 是一家 AI 研究与技术公司,致力于开发模型架构、组件和运行时。其工作融合了人工智能、计算认知科学以及对生物系统如何随时间学习的深入研究。i14 将这些理念应用于能够保留长程上下文且不会让服务状态随每个 token 增长的模型中。
为什么选择线性注意力模型?
Transformer 的 softmax 注意力机制会在整个上下文中比较各个 token。在训练期间,这种计算量随序列长度呈二次方增长。在推理期间,随着模型处理更多 token,KV 缓存也会随之增长。
线性注意力围绕一个针对每个 token 更新的循环状态重新组织了计算过程。Laplace 3B 使用 GLA 将先前的上下文压缩为一个固定大小的矩阵状态。这将训练时的注意力复杂度从 O(T²) 降低到 O(T),并将推理状态固定在每个序列 29.5 MB。
| 考量因素 | Transformer Softmax 注意力机制 | 采用 GLA 的 Laplace 3B |
|---|---|---|
| 训练时的注意力计算 | 构建成对 Token 评分,复杂度为 O(T²) | 更新分块循环状态,复杂度为 O(T) |
| 推理内存占用 | KV Cache 随上下文长度增长而增加 | 循环状态大小保持固定 |
| 更长的上下文 | 每个序列消耗更多的加速器内存 | 上下文长度的增加不会导致循环状态分配量的增加 |
| 实现方式 | 使用广泛优化的注意力内核 | 需要特定架构的内核以及编译器调优 |
线性注意力通过压缩历史信息而非保留所有的 Key 和 Value 来工作。因此,你必须针对自身的工作负载评估检索质量。固定的状态有利于长时间运行的 Agent、大文档分析,以及那些需要持久化内存且要求可预测服务资源的应用场景。
i14 如何将 Laplace 3B 适配至 AWS Trainium2
Laplace 3B 的原始实现使用了针对 GPU 优化的 Triton 内核。AWS 生成式 AI 创新中心(GenAIIC)团队首先使用标准的 PyTorch 算子重写了用于 Trainium2 的 GLA 内核。在比较两种方案后,团队选择了 TorchNeuron Native(AWS Trainium 的原生 PyTorch 后端)的 Beta 版本,因为其性能表现更佳。
该实现需要进行三项更改:
- 使用原生 PyTorch 实现 GLA 注意力内核。 团队将针对 GPU 特定的融合
fused_chunk_simple_glaTriton 内核替换为标准 PyTorch 算子,并使用 16 个包含 128 个 Token 的分块,以匹配 NeuronCore 片上缓冲区的 128 个分区。 - 重新设计 Muon 的通信方式。 MuonFSDP2 中的两个
all_to_all集合通信操作将每秩(per-rank)流量减少了 24 倍,并将吞吐量提高了 1.63 倍。 - 编译顺序反向传播过程。 团队静态展开 GLA 递归的 16 个分块步骤,以适应编译器的图大小限制和片上内存限制。
工程挑战部分详细描述了每一项更改。
为什么选择 AWS Trainium 加速器?
AWS Trainium 是 AWS 推出的一系列机器学习 (ML) 加速器,专为模型训练和推理设计。trn2.48xlarge 实例集成了 16 颗 Trainium2 芯片、64 个逻辑 NeuronCore、高带宽内存以及 NeuronLink-v3 连接技术。这些资源支持本文中描述的分布式训练和推理配置。
Trainium2 的三个特性影响了具体实现:软件管理的片上内存(挑战 1)、快速的芯片间互连(挑战 2)以及静态编译器(挑战 3)。编译器将 GLA 递归追踪为固定计算图。
软件管理的片上内存。 每个 NeuronCore 拥有一个 28 MiB 的状态缓冲区 (SBUF),包含 128 个分区,以及一个 2 MiB 的部分和缓冲区 (PSUM)。PSUM 连接到一个 128×128 的脉动张量引擎 (Tensor Engine),并配有独立的向量和标量单元。SBUF 并非缓存:编译器会预先调度所有 HBM-to-SBUF 的数据传输,确保数据就位,从而避免驱逐或未命中情况(见图 1)。
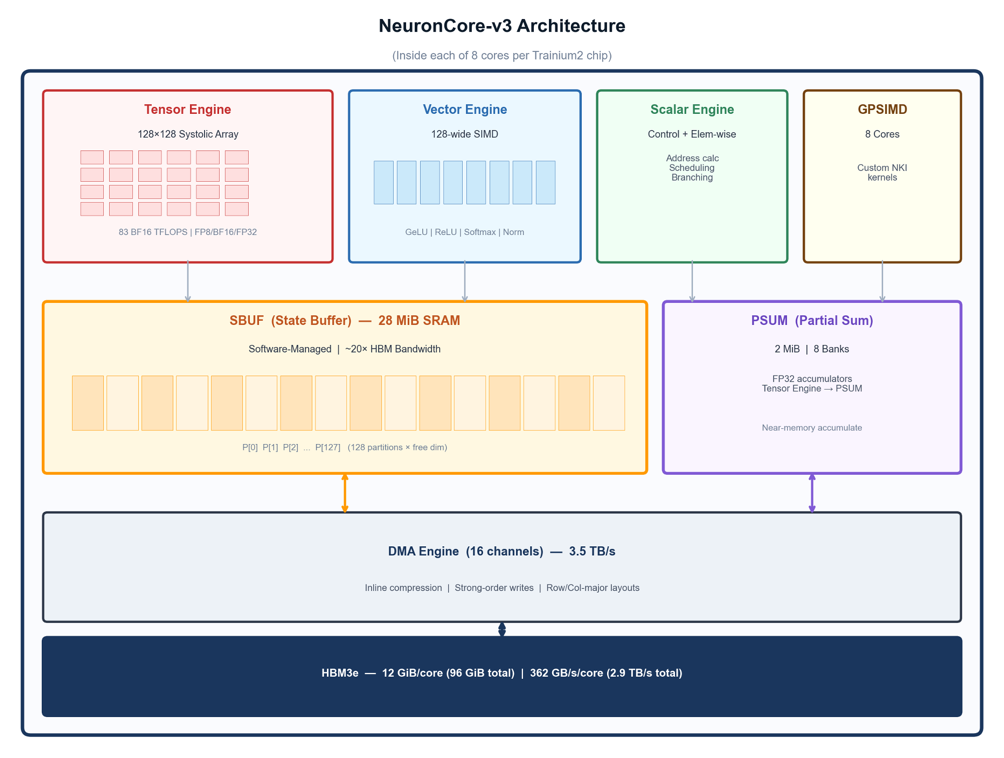
图 1:NeuronCore-v3 内部架构。包括软件管理的 SBUF(28 MiB,128 个分区)、张量引擎(128×128 脉动阵列)、向量引擎、标量引擎以及 GPSIMD 核心。
i14 与 Laplace 3B 架构
Laplace 3B 是一个 24 层的 i14 解码器,其中每一层都用 Simple GLA 取代了 softmax 注意力机制。图 2 展示了一个层级从顶部的输入 xt 到底部输出 xt + 1 的流程。本节将解释各个模块:归一化与卷积、QKVG 投影、GLA 混合器以及前馈通道混合器。
归一化与卷积。 每个 token 的残差流向量 xt ∈ ℝD (D = 3,072) 首先经过 LayerNorm,然后通过一个宽度 k = 4 的深度可分离因果 Conv1d 层,并应用 SiLU 激活函数。这使得每个位置在进入混合器之前都能获得一个 4-gram 摘要。随后,GLA 混合器通过其衰减状态在整个历史序列上进行基于内容的检索。
QKVG 投影。 卷积后的输出经过一个融合的矩阵 Wqkv**g ∈ ℝ9,216 × 3,072,其中 9,216 = H × (2d**k + 2d**v)。它被拆分为四个逐 token 的流:查询 qt、键 kt、值 vt 以及门控信号 gt(H = 16,d**k = 96,d**v = 192)。门控信号在混合器之后使用。
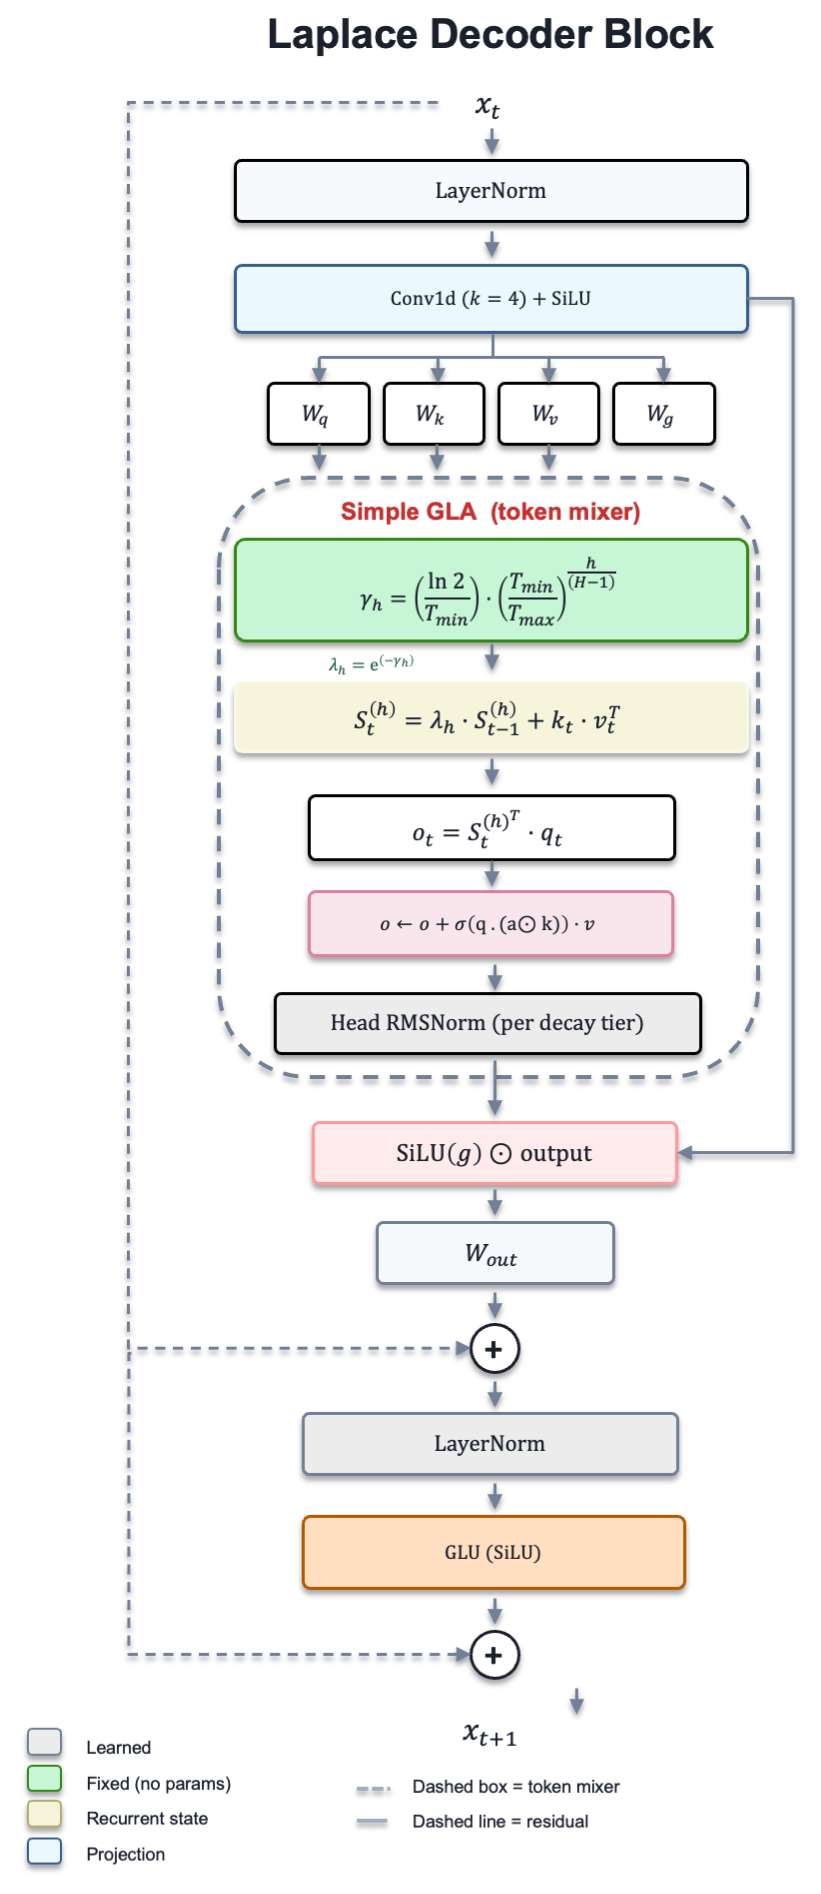
图 2:Laplace 解码器层架构。绿色 = 固定(无参数),灰色 = 可学习,黄色 = 循环状态,蓝色 = 投影。
GLA 混合器。 每个头 h 维护一个大小为 d**k × d**v(96 × 192)的矩阵状态 St(h),这是过去键值对的压缩且衰减的记录。在每个 token 处,其更新方式如下:
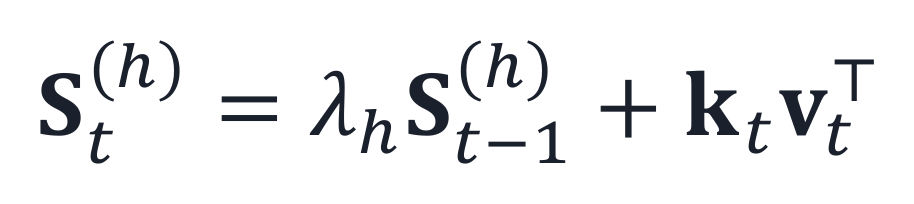
GLA 循环状态更新方程
这里 λ**h 是固定的每头衰减率,而 ktvt⊤ 是将当前键值对写入状态的秩-1 外积。读出操作查询该状态:
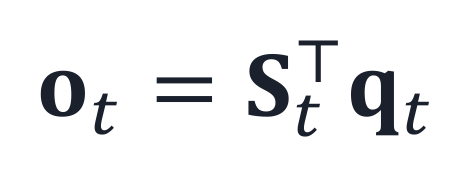
GLA 状态读出方程
接下来,一个自增强步骤将值的门控副本添加到每个头的输出中:
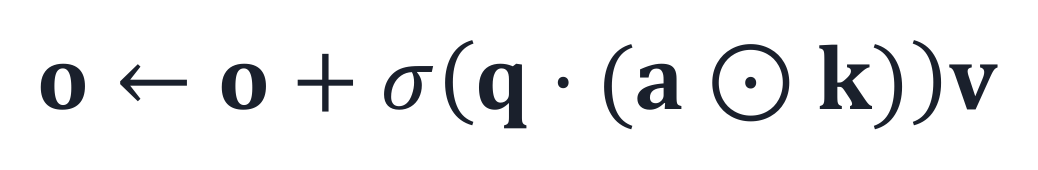
GLA 自增强方程
这里 σ 是 sigmoid 函数,⊙ 是逐元素乘积。门控信号是查询与键的学习通道缩放点积的结果,其中 a 是学习到的缩放因子(aug_balance)。在初始化时,a = 0,这相当于给值提供了一个半强度的跳跃连接。每个头的输出在每个衰减层级内通过 Head RMSNorm,然后进行拼接,由 SiLU(gt) 进行门控,最后通过 Wout ∈ ℝD × D 投影回残差流。
衰减调度。 每个注意力头的衰减速率 λ<sub>h</sub> 控制该头遗忘过去 token 的速度。它在初始化时固定(不可学习),并由几何级数调度设定。该调度为 16 个头分配了不同的记忆长度,并定义了每个头的对数衰减速率 γ<sub>h</sub>:
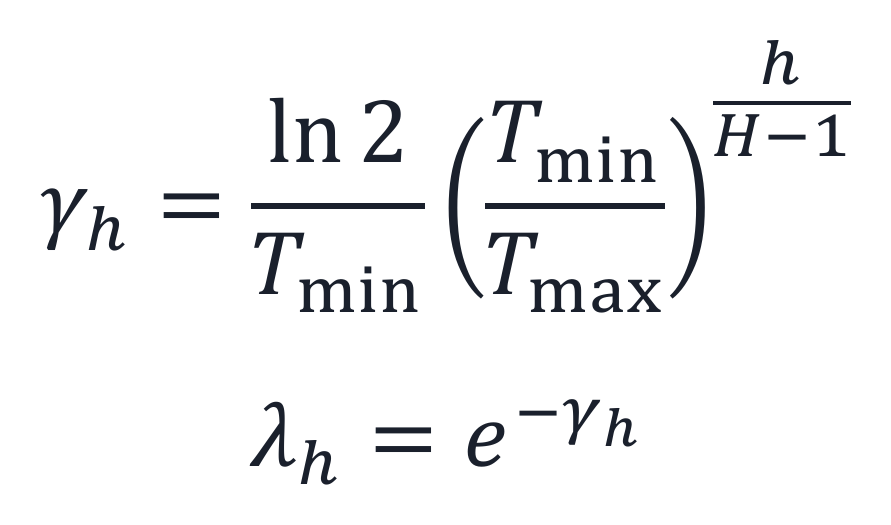
GLA 衰减调度公式
衰减调度的覆盖范围。 对于此模型,T<sub>min</sub> = 1 且 T<sub>max</sub> = 2,048。因此,第 0 个头的 λ<sub>0</sub> = 0.5(半衰期为 1 个 token),而第 15 个头的 λ<sub>15</sub> ≈ 0.9997(半衰期为 2,048 个 token)。这些头被分组到不同的层级中,每层共享一个 Head RMSNorm。
通道混合器 (FFN)。 在注意力块及其残差连接之后,第二个 LayerNorm 输入到一个 GLU (SiLU) FFN,其内部维度为 8,192。它包含三个矩阵:两个上投影矩阵 W<sub>1</sub>, W<sub>2</sub> ∈ ℝ<sup>8,192 × D</sup> 和一个下投影矩阵 W<sub>3</sub> ∈ ℝ<sup>D × 8,192</sup>。随后是第二个残差连接。
状态 S<sub>(h)</sub> 的大小固定为每个头 d<sub>k</sub> × d<sub>v</sub> = 96 × 192,与序列长度无关。因此,推理复杂度为每个 token O(1),训练复杂度为 O(T) 而非 O(T<sup>2</sup>)。
| 参数 | 值 |
|---|---|
| 参数量 | 总计 3.028B (2.718B Muon + 309.6M AdamW) |
| 层数 | 24 个解码器层,隐藏维度 D = 3,072 |
| 注意力头 | 16 个头,d<sub>k</sub> = 96 (Q/K 半宽), d<sub>v</sub> = 192 (V 全宽) |
| 混合器 | 简单的 GLA,采用固定几何衰减 (T<sub>min</sub> = 1, T<sub>max</sub> = 2,048) |
| 卷积 | 深度可分离因果 Conv1d,核宽度 4,SiLU 激活 |
| FFN | GLU (SiLU),内部维度 8,192 |
| 归一化 | 注意力前 LayerNorm + Head RMSNorm (按层级) + FFN 前 LayerNorm |
| 词表大小 | 50,304 (填充至 64 的倍数) |
| 序列长度 | 2,048 |
| 训练数据 | 100B tokens, FineWeb-Edu |
| 优化器 | 2D 权重矩阵使用 Muon;嵌入和归一化层使用 AdamW |
| 批次大小 | 每步 524,288 tokens,余弦学习率,3,815 步预热 |
工程挑战
这三项改动中的每一项都带来了各自的工程挑战。
挑战 1:在 Trainium 上使用原生 PyTorch 实现 GLA
在 GPU 上,GLA 作为 flash-linear-attention 库中的融合 Triton 内核 fused_chunk_simple_gla 运行。GenAIIC 团队使用标准 PyTorch 运算符重新实现了该功能,这些运算符通过 TorchNeuron Native 运行,表现为对固定大小块的显式循环。块的数量在编译时确定,并设定了反向传播展开的深度。团队使用 fla_num_chunks = 16,因此每个块包含 C = 128 个 token。
在每个块 c 内,块内输出是带掩码的线性注意力,而运行状态 S 则添加了先前的上下文:
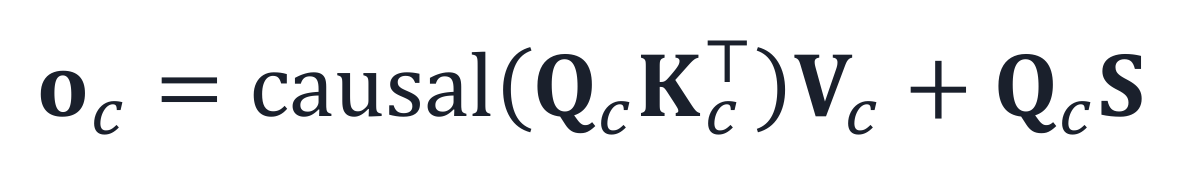
分块 GLA 的块内输出
随后,状态推进到下一个块:
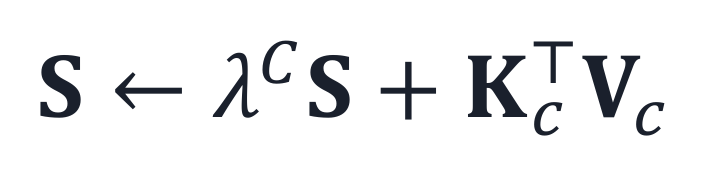
分块 GLA 的状态更新
这里 λ**C 是在整个块上复合计算的每个头的衰减因子。16 个块内计算并行运行,只有状态更新是顺序执行的(图 3)。
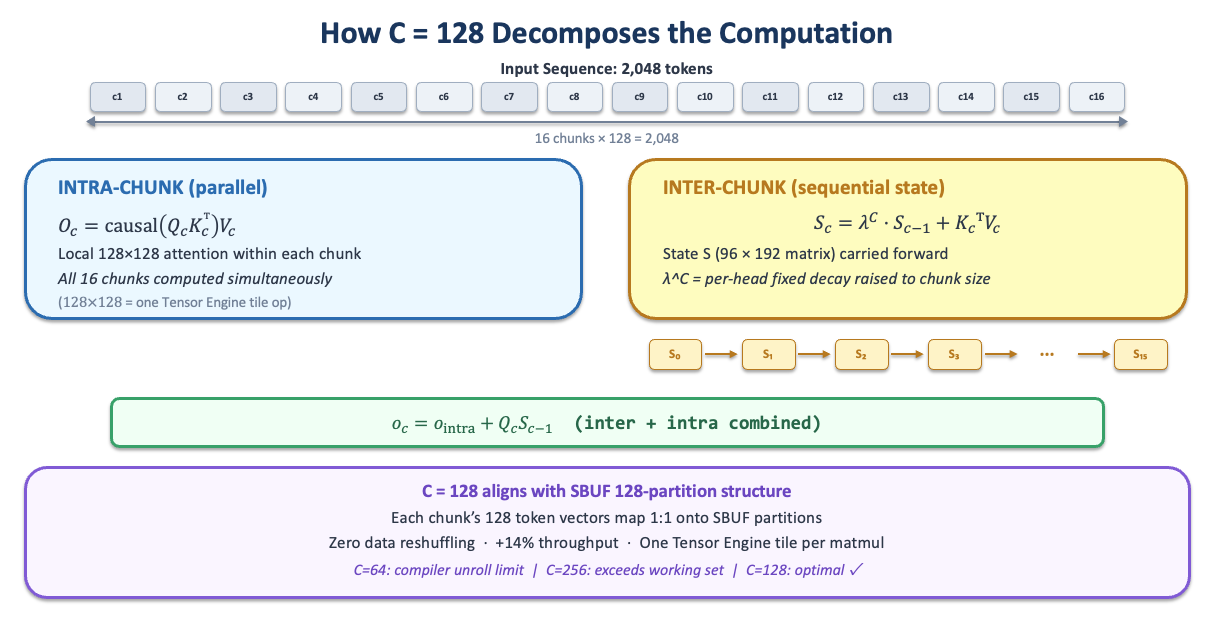
图 3:具有并行块内注意力和顺序状态链的分块 GLA 递归分解。
由于 SBUF 有 128 个分区,每个 128-token 的块映射为每个分区一个 token,无需填充或跨分区移动。这种对齐方式使实测吞吐量提高了 14%(图 4)。
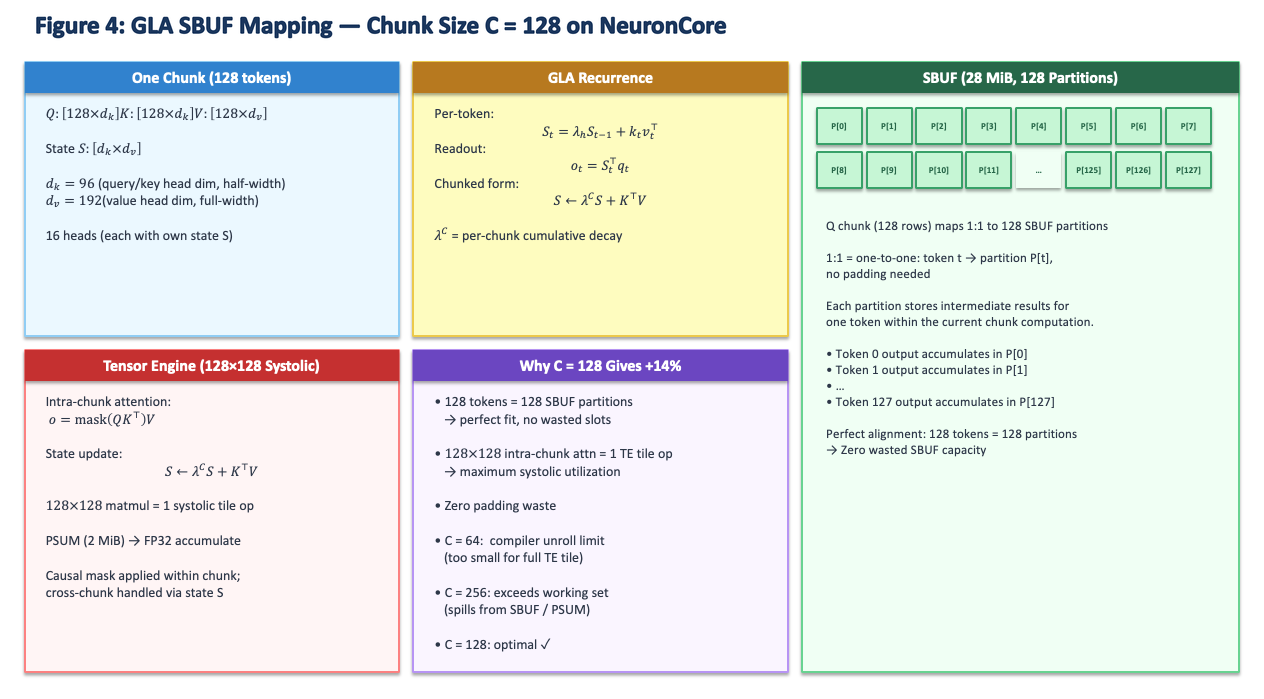
图 4:块大小 C = 128 与 128 个 SBUF 分区一一对应。
挑战 2:FSDP2 下的分布式 Muon 正交化
Muon 在更新前会对每个梯度进行正交化。对于 96 个二维权重矩阵(共 27.18 亿参数),它执行五次 Newton–Schulz 迭代(算法 1)。
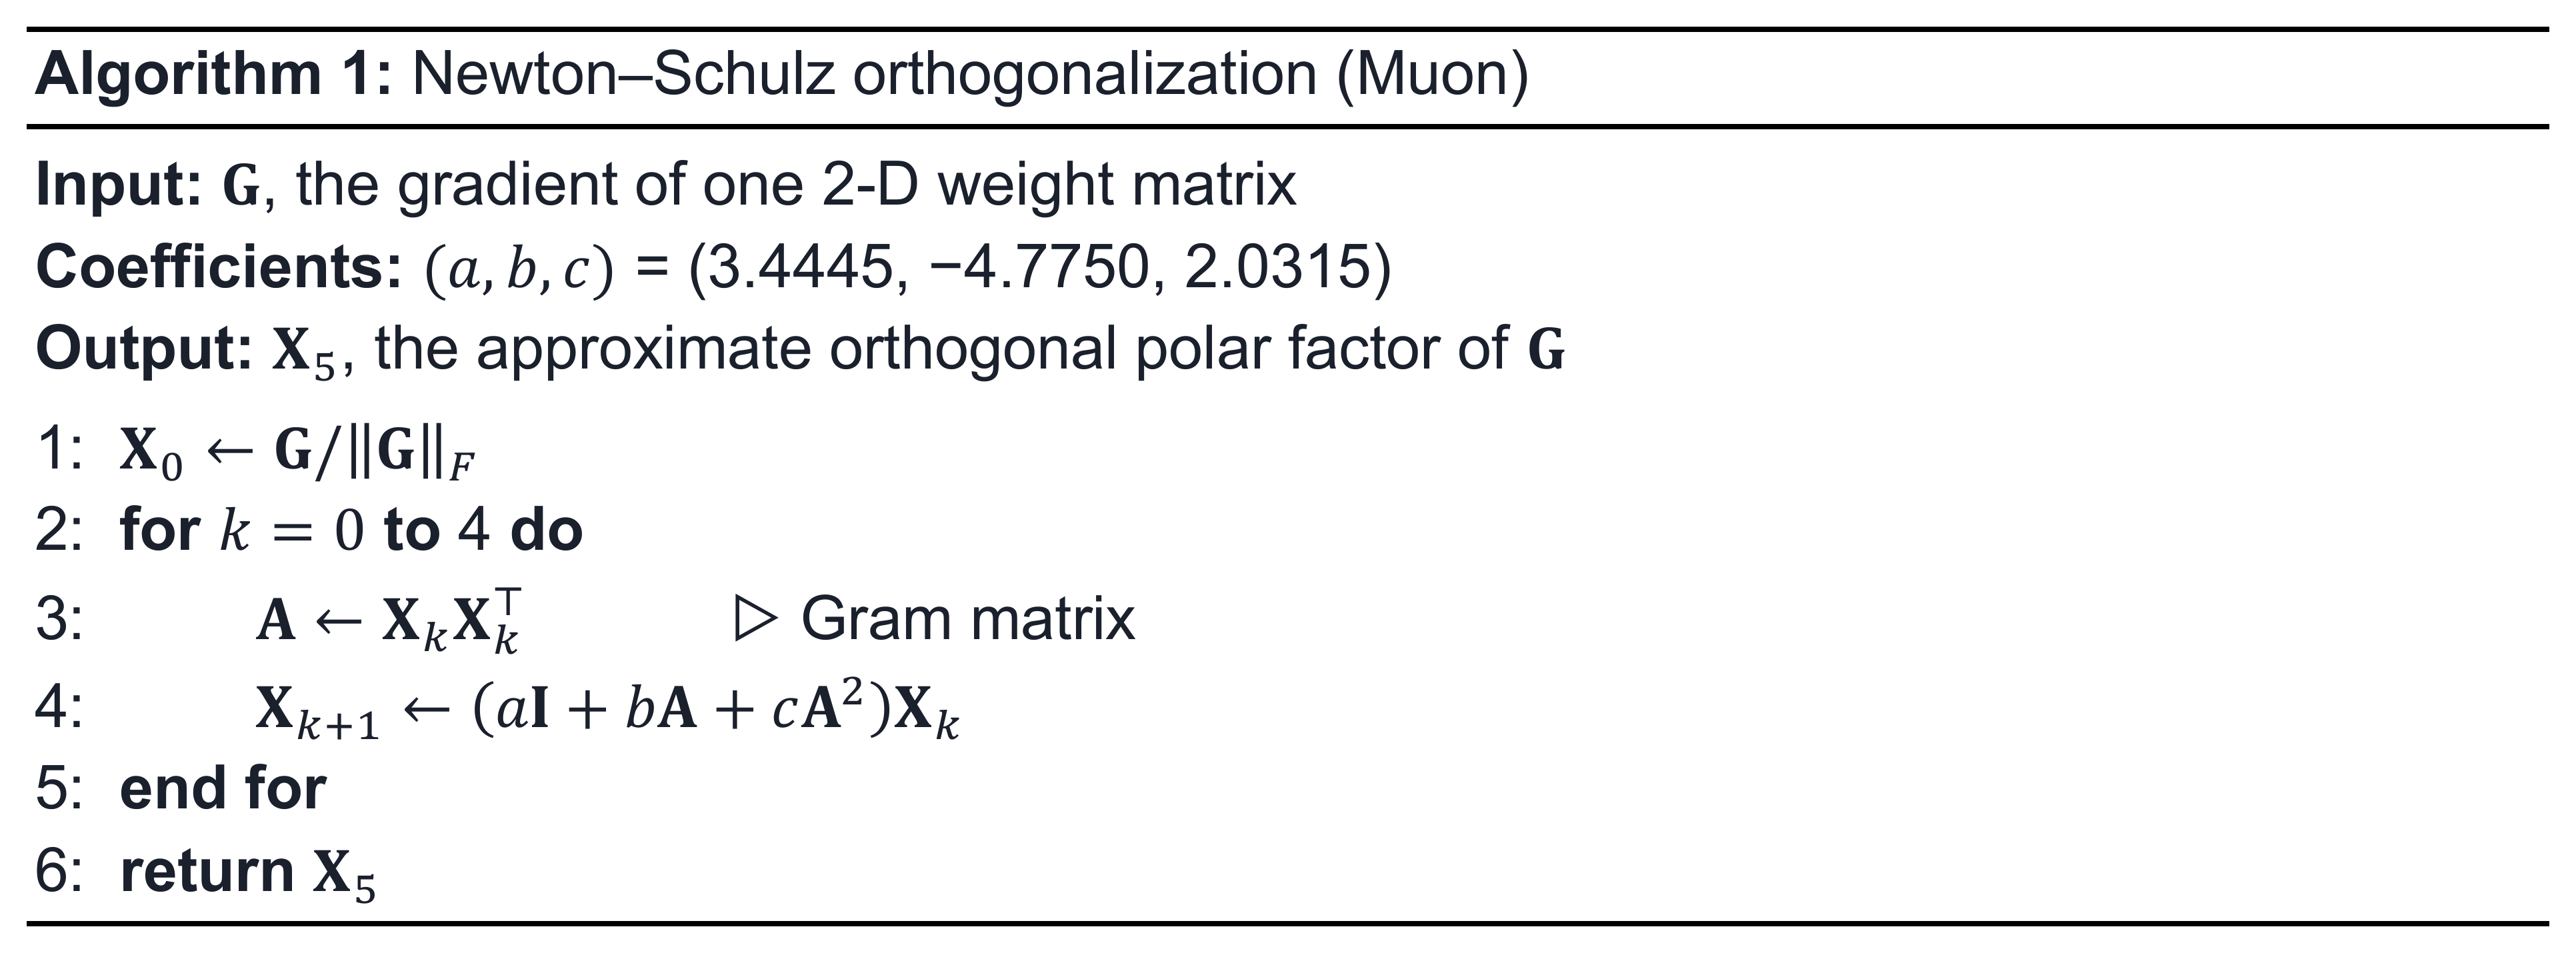
Newton-Schulz 算法
分布式问题。 Gram 矩阵 A = X****X⊤ 将权重的每一行与其他所有行相关联。在全分片数据并行(FSDP2)模式下,64 个 rank 中的每一个仅持有 1/64 的行。因此,分片本地的 X****X⊤ 只能产生一个对角块,并丢弃了所有跨分片的项(图 5)。
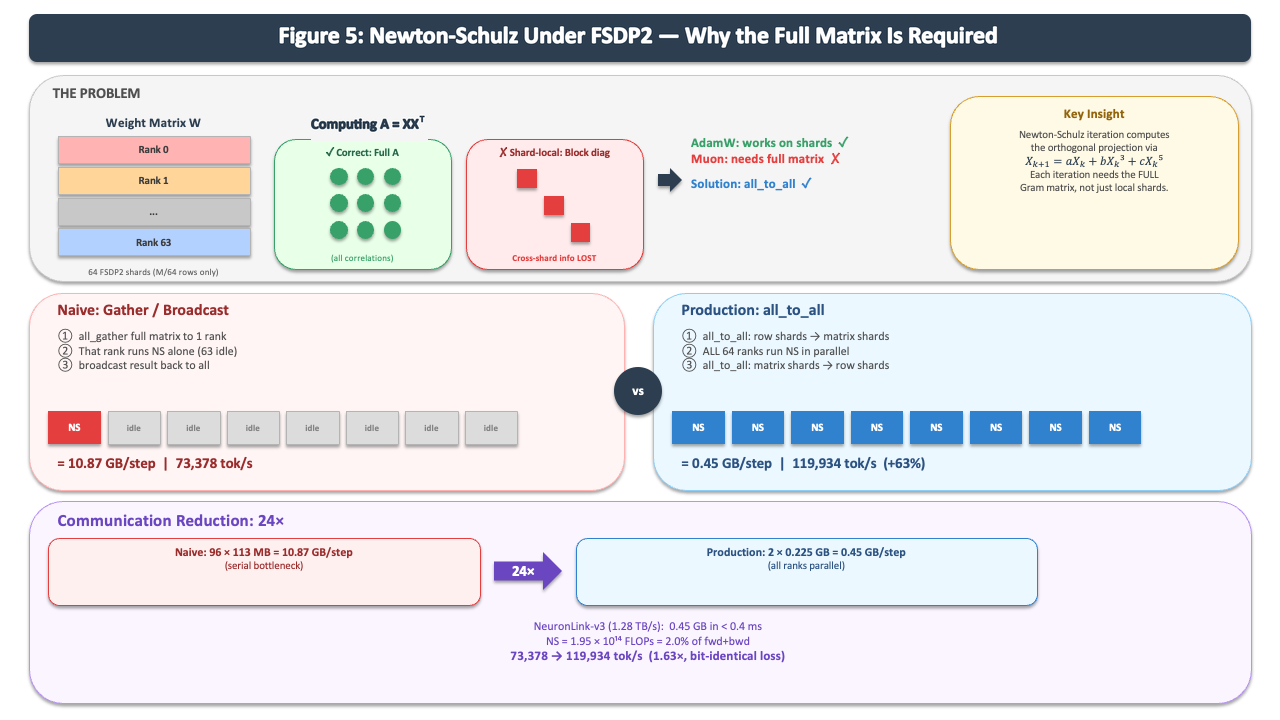
图 5:FSDP2 下的 Newton–Schulz:分片本地 Gram 块,以及 gather/broadcast 与 all_to_all 的对比。
朴素方法:Gather 和 Broadcast。 每个 rank 收集完整的梯度(5.44 GB),由一个 rank 运行 Newton–Schulz,然后广播结果。这每步移动 10.87 GB 数据,而其他 63 个 rank 处于等待状态。
生产环境方法:all_to_all 转置。 在 MuonFSDP2 中,一次 all_to_all 操作使每个 rank 获得几个完整的矩阵,所有 64 个 rank 并行运行 Newton–Schulz,第二次 all_to_all 返回结果。每个 rank 的流量降至 0.45 GB,减少了 24 倍。吞吐量从每秒 73,378 个 token 提升至 119,934 个 token,提高了 1.63 倍,且损失曲线逐位一致(图 6)。
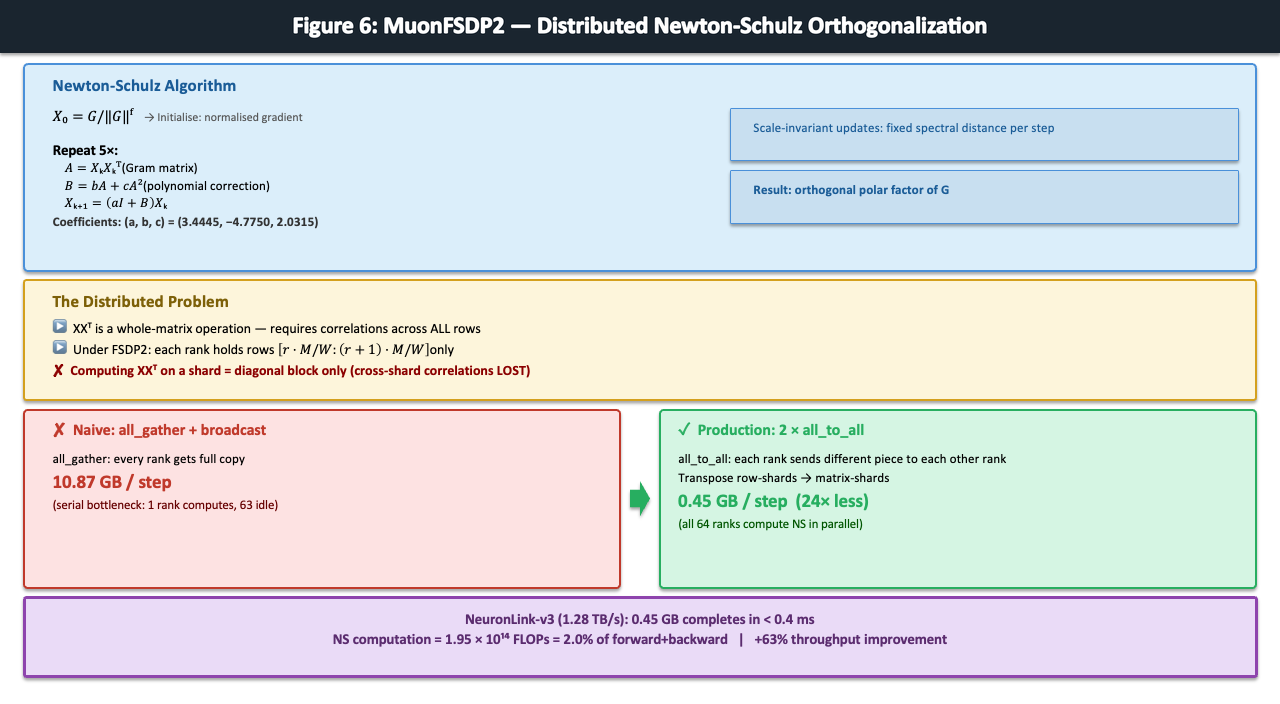
图 6:每步通信量:使用 all_gather 时为 10.87 GB,而使用 all_to_all 时为 0.45 GB。
通信成本。 Newton–Schulz 仅占训练步骤中 FLOPs 的约 2%(1.95 × 10¹⁴ / 9.53 × 10¹⁵),因此通信是瓶颈。在 NeuronLink-v3 上以 1.28 TB/s 的速度传输时,0.45 GB 的数据交换耗时不到 0.4 ms,而整个步骤大约需要 4.4 秒。
挑战 3:针对顺序递归的反向传播展开
反向传播需要对全部 16 次顺序状态更新进行微分。在 GPU 上,autograd 会在运行时构建此计算图。而在 Trainium2 上,编译器必须预先看到整个展开的 16 步计算图,这带来了三个约束条件。
计算图深度随 chunk 数量增长: 当使用 32 个 chunks(C = 64)时,计算图超出了调度器的容量。每个 chunk 的内存占用随 chunk 大小增长: 当使用 8 个 chunks(C = 256)时,中间结果溢出到了 HBM(高带宽内存)。由于所有形状都在追踪(trace)阶段固定,因此每个循环中的中间变量都需要独立的静态内存分配。
使用 16 个 chunks(C = 128)可同时满足这三个条件:展开后的计算图适配调度器,中间结果保留在片上内存中,且 tile 与 128 个 SBUF 分区对齐。
训练结果
GenAIIC 团队在一台 trn2.48xlarge 实例上使用全部 64 个逻辑 NeuronCore 和 all_to_all Muon 路径训练了 Laplace 3B 模型。完整训练配方包含 190,735 步(对应 1000 亿 FineWeb-Edu tokens)。以下结果截至第 84,210 步,约处理了 440 亿 tokens。
吞吐量。 编译预热完成后,吞吐量稳定在每秒约 120,000 tokens,并一直保持到第 84,210 步。
损失与梯度稳定性。 损失值(图 7a)从约 11.4 平滑下降至第 84,210 步时的 2.3729。梯度范数(图 7b)显示出预期的早期峰值,随后稳步下降至约 0.05,且在预热后没有出现尖峰、发散或 NaN/Inf 值。
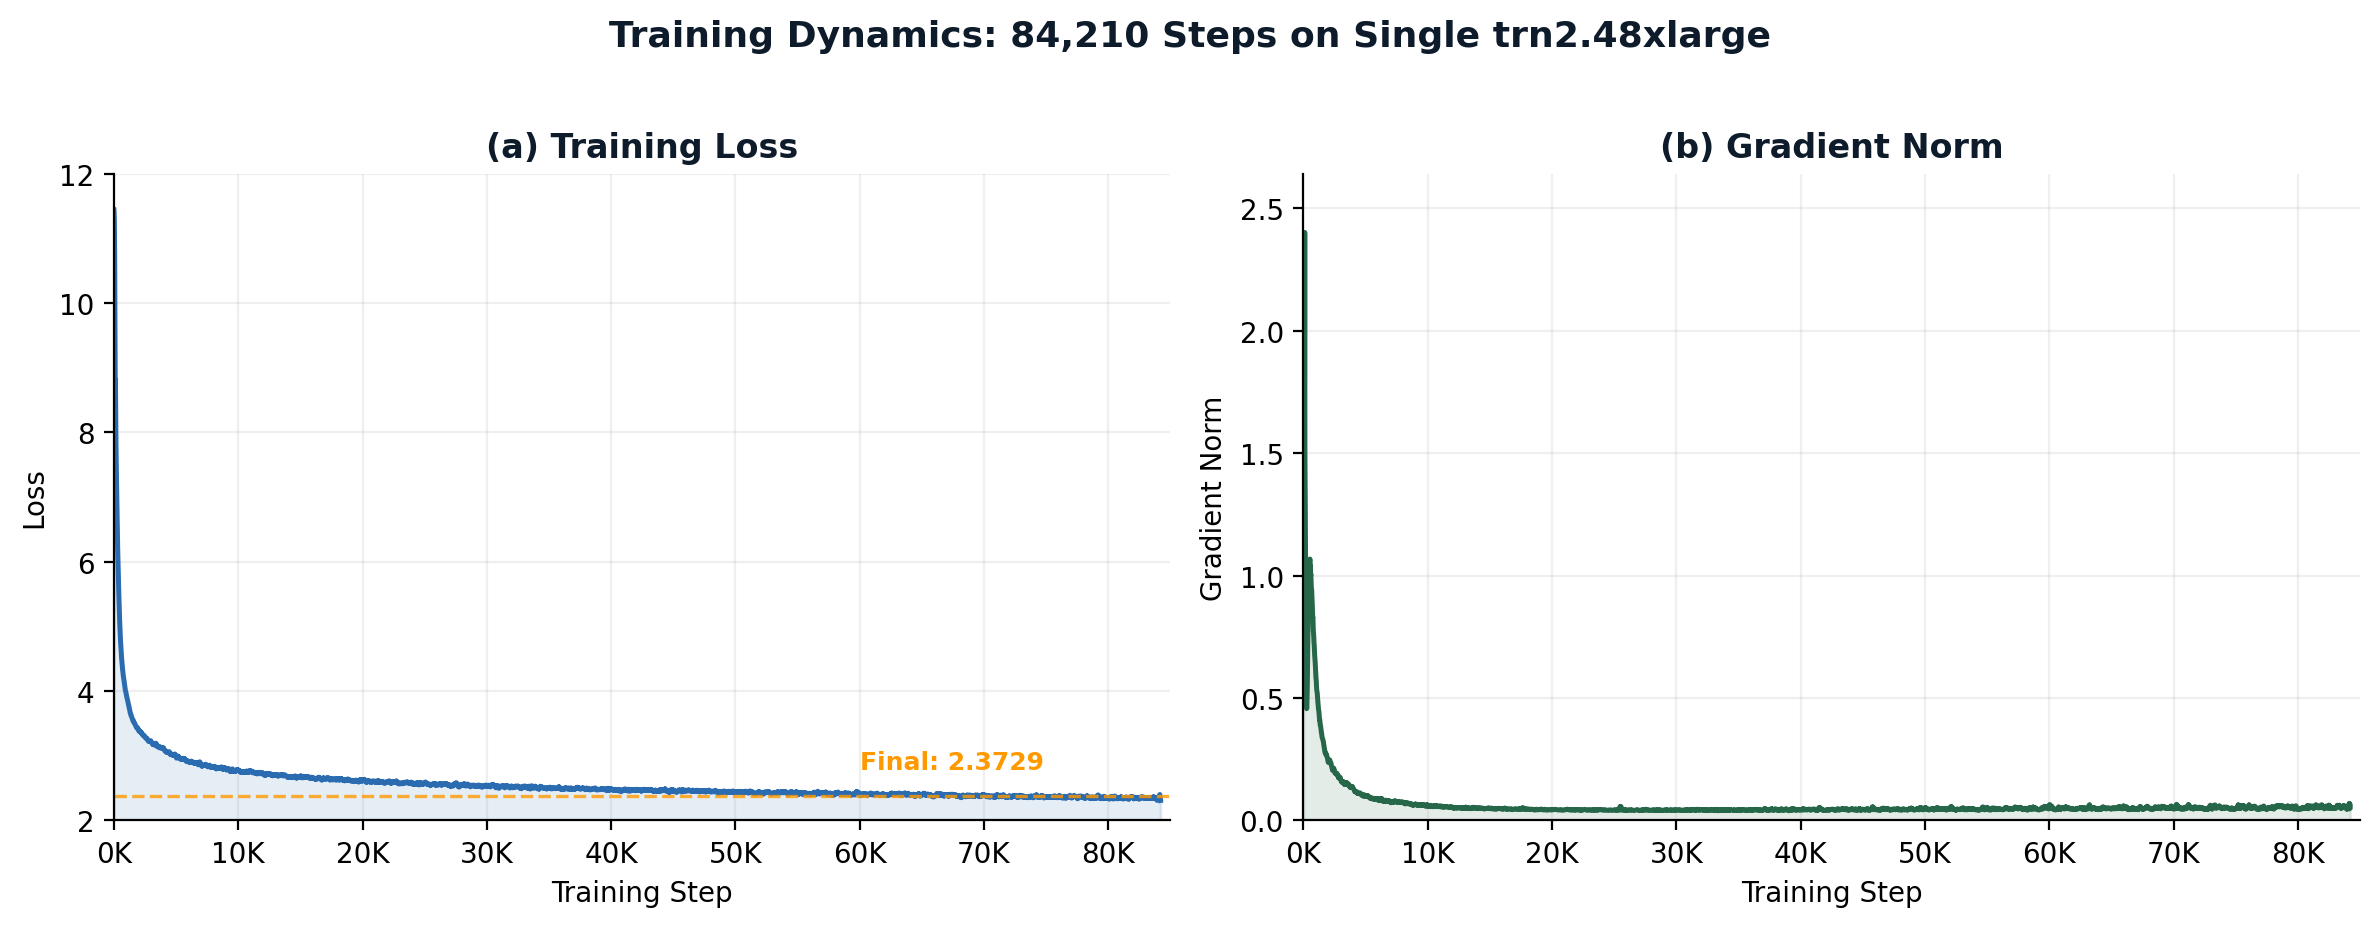
图 7:训练动态。(a) 损失从 11.4 降至 2.3729。(b) 基于 TensorBoard 数据的梯度范数。
Trainium2 上的推理优化
通过未经修改的 vLLM 引擎,GenAIIC 团队在一台 trn2.48xlarge 实例上实现了每秒 11,544 个输出 tokens 的服务吞吐量,支持 1,280 个并发序列。
恒定的服务状态。 每个序列 29.5 MB 的递归状态比同等规模下 8,192 tokens 的 KV Cache 小约 82 倍。将 prompt 长度从 2,048 tokens 增加到 8,192 tokens,仅使每个输出 token 的成本增加了 0.5%。
未修改的 vLLM。 一个包装器(wrapper)替换了每个解码器层的一个属性——token mixer,以便在 vLLM 池中读写递归状态。由于该模型声明自身无注意力机制(attention-free),vLLM 为每个序列分配一个固定页面。输出结果与 i14 参考逐 token 匹配(在 BF16 精度下,3/3 个 prompts 均达到 48/48 步完全一致)。
定位瓶颈。 对解码时间与解码器层数 L 进行线性拟合,得到:

解码时间线性拟合方程
当 L = 24 时,每步耗时为 168.1 ms,其中 96.9% 发生在解码器层内部。大型投影操作耗时 13.27 ms,接近 12 ms 的 HBM 流式传输下限。大部分时间消耗在通过 eager PyTorch 逐个调度的小型算子上。
扩展至完整实例。 在不使用张量并行(tensor parallelism)的情况下,吞吐量通过副本(replicas)进行扩展,每个逻辑 NeuronCore 运行一个引擎并处理 20 个序列。Eager 模式下的吞吐量从单副本的每秒 133 个输出 token 增长到 64 副本时的每秒 6,772 个 token,此时主机 CPU 利用率达到 82%。编译解码步骤消除了逐算子调度开销,使吞吐量提升了 1.7 倍,达到每秒 11,544 个 token(图 8)。

图 8:完整实例推理吞吐量。(a) Eager 和编译解码模式下的副本扩展情况。(b) 编译解码将吞吐量从每秒 6,772 个输出 token 提升至 11,544 个。
固定批次基准测试掩盖的问题。 在真实流量下,每个新的解码批次宽度都是一个单独编译的形状,其首次使用成本约为 11 秒。这些步骤仅占总数的 1.1%,却消耗了 47.5% 的解码时间。填充至固定宽度消除了这一成本,且结果保持位级精确(bit-exact)。与固定批次相比,在交错到达(staggered arrivals)场景下,编译解码使单副本吞吐量提升了 3.52 倍,而固定批次仅提升 1.46 倍。由于 BF16 重结合律(reassociation)导致编译输出与 eager 模式存在细微差异,因此在需要严格可复现性时应使用 eager 解码。
关键要点
该项目在训练和推理两方面都积累了经验教训:
- 原生 PyTorch 可在 Trainium2 上支持自定义架构。 i14 保留了 GLA 架构,并使用 TorchNeuron Native 完成了最终实现。
- 通信设计对自定义优化器至关重要。 Muon 的 all_to_all 设计将每个 rank 的流量减少了 24 倍,并将训练吞吐量提高了 1.63 倍。
- 固定状态使推理内存可预测。 无论上下文长度如何,每个序列仅使用 29.5 MB。
- 先分析性能,再进行编译。 算子调度(而非算术运算或 HBM 带宽)占据了大部分解码时间。
- 基准测试应模拟真实的请求到达模式。 固定批次掩盖了因批次宽度变化而需重新编译新形状所带来的开销。
结论
Laplace 3B 表明,AWS Trainium2 能够支持标准 Transformer 之外的模型架构。通过 TorchNeuron Native 和 AWS Neuron SDK 使用原生 PyTorch,i14 在保留固定递归状态的同时,成功训练并部署了其基于 GLA 的模型。
对于智能体系统而言,这改变了一项基本的服务约束:更长的历史记录不再需要更大的每序列状态,这有助于团队在保持内存使用可预测性的同时保留更多上下文。
如果上下文增长导致服务成本上升、并发能力下降或限制了智能体的记忆容量,请尝试 i14 或联系您的 AWS 客户团队,以评估在 AWS Trainium2 上运行 Laplace 3B 的效果。
资源
- 试用 i14
- AWS Trainium 和 Trainium2
- AWS Neuron SDK 文档
- 通过 TorchNeuron Native 在 AWS Trainium 上支持原生 PyTorch
- 具有硬件高效训练能力的门控线性注意力 Transformer
- Muon 优化器参考实现
- AWS 生成式 AI 创新中心