谷歌量子 AI 用 105 量子比特验证量子优势
谷歌量子 AI 团队在超导处理器上运行量子魔方游戏,以 98.3% 的硬件胜率超越 88.9% 的经典理论上限,首次将量子纠缠优势转化为可测量、可基准化的工程指标。该实验规模扩展至 105 量子比特,为量子计算在系统级验证与跨平台基准测试提供了可复用的方法论。
报道正文
本文目录8 个章节
一个没有量子计算机就赢不了的游戏
2026年11月19日
Shashwat Kumar 和 Rodrigo Cortiñas,Google Quantum AI、Google Research 研究科学家
在一台超导处理器上,我们把量子力学最奇特的特征之一变成了可以测量、可以基准测试,并能在多达 105 个量子比特规模的系统上加以利用的东西。
快速链接
这里有一个你现在就可以尝试的、周日报纸风格的谜题。画一个 3×3 的网格。在每个单元格中填入 +1 或 −1,并满足两条规则:每一行的乘积必须为 +1,每一列的乘积必须为 −1。
来吧,我们等你……
你没做出来,对吧?这背后有一个优雅的原因。一行要乘积为 +1,就需要有偶数个 −1。一列要乘积为 −1,就需要有奇数个 −1。把所有行加起来,你会得知网格中 −1 的个数是偶数。把所有列加起来,你会得知它是奇数。嗯……这不可能!
这个网格必须同时是两件互相矛盾的事。这样的表格并不存在;它是一个悖论。
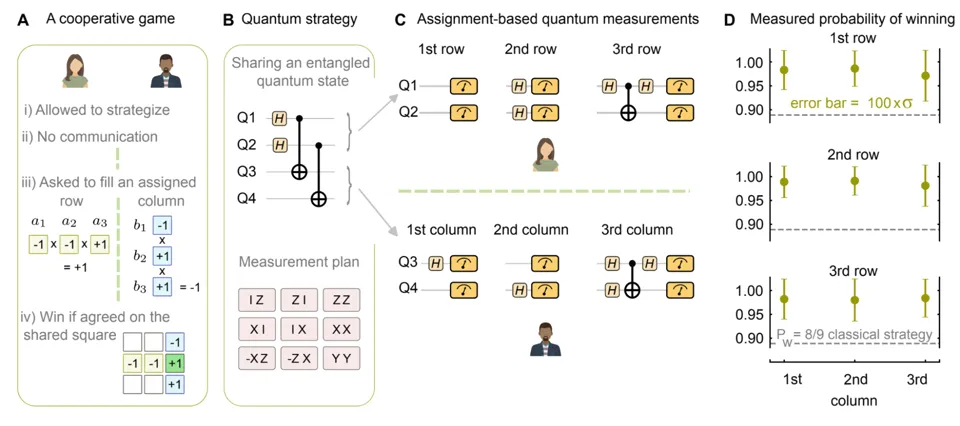
现在把这个谜题变成一个游戏:每一轮,Alice 拿到一行,Bob 拿到一列。两人不能交谈,Alice 按行规则填充她的行,Bob 按列规则填充他的列。如果他们在各自行与列相交的方格中填入相同的数字,他们就赢了。任何事先制定的方案都只是一张预先写好的表格,这意味着他们最多只能赢 9 轮中的 8 轮。如果他们使用量子计算机,情况就会改变。它不会填出那个不可能的网格,但原则上,它能让他们赢下每一轮。
原因是一种被称为量子语境性的性质,它可以说是量子力学最奇特的特征。爱因斯坦曾有一句名言:当我们不看的时候,月亮是否还在那里?这是他坚持物理性质应当独立于是否有人测量而存在的方式。对于量子系统而言,语境性是一个精确且可实验检验的陈述:答案可以是否定的——你无法为你可能测量的一切赋予固定的、预先存在的值。
一次测量所产生的结果,可能取决于你同时进行的其他哪些兼容测量(即取决于其上下文)。这不仅是一个深刻的哲学命题,更是前沿科学和一项新技术的基础。在上面的游戏中,Alice 和 Bob 可以利用这一点来设计出解决方案。他们的答案并非从预先写好的隐藏表格中查得;那张表格根本不存在。他们的答案是在测量过程中产生的,而量子关联将它们紧密地编织在一起,其紧密程度超出了任何经典规则手册所允许的范围。
纠缠通常被视为量子计算“魔法配方”中的头号主角。但越来越多的理论表明,上下文性才是更深层的资源,正是它让某些量子算法真正超越了经典对应算法。问题在于,直到最近,上下文性几乎只在少数粒子构成的小系统中得到验证。它能否在真实量子计算机所依托的多体系统中存续并保持有用,一直是一个悬而未决的问题。
这正是我们着手回答的问题。在发表于Science的论文“Quantum-classical separation in bounded-resource tasks arising from measurement contextuality”中,我们在超导量子处理器上演示并测量了上下文性。我们的量子比特以 98.3% 的胜率赢得魔法方块游戏,在上下文性测试中超越经典极限,并在多达 105 个量子比特的任务中优于经典策略。在此过程中,这些任务被证明是一种灵敏的新型量子硬件基准测试,能够捕捉到随机电路测试所遗漏的细微错误。
超越经典界限
我们在 Willow 量子处理器上运行了通常被称为魔法方块游戏的任务。Alice 和 Bob 各自持有两个量子比特,共享两对纠缠的贝尔对,而非预先写好的表格,并使用为其分配的行或列的预设设置进行测量,以得到各自的 ±1 条目。
可设想的最佳经典策略至少会在九局中输掉一局,胜率最高为 88.89%。当我们把全部九个版本的游戏各玩 100,000 次时,我们的量子比特大约每六十局才输一局,胜率达到 98.30%(0.9830 ± 0.0001)。
这一差距具有实际意义且统计显著:我们的量子比特协同表现优于任何预先写好的表格所能允许的程度。这是因为没有任何单元格的值是预先固定的。每个答案只有在与其所在行或列的其余部分(即其上下文)一同被测量时才会成形,而共享纠缠使 Alice 和 Bob 对共享单元格的答案保持一致。
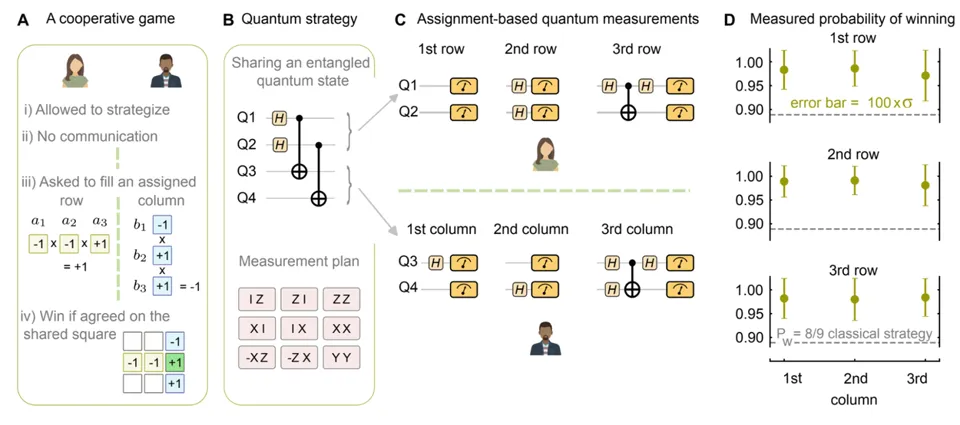
借助共享纠缠和预先约定的测量方案,Alice 和 Bob 原则上可以在每一轮都在交点处达成一致。在我们的硬件上,噪声导致大约每 60 次出现一次失败。
为上下文性赋予一个数值
魔法方块游戏展示了上下文性的潜在威力,因此我们接下来着手测量一台机器的上下文性程度。我们使用了一个贝尔–科亨–斯佩克不等式,它与著名的贝尔测试密切相关——后者表明,像上述贝尔对这样的纠缠粒子无法携带预先固定的答案。我们的不等式将一组关联量打包成一个单一数值 χ。用上面游戏中的行和列来表示,它写作 χ = R1 + R2 + R3 − C1 − C2 − C3,其中 R 和 C 分别代表 Alice 和 Bob 先前需要计算的行和列的乘积:
| +1 | +1 | +1 | R1 = (+1)(+1)(+1) = +1 |
|---|---|---|---|
| +1 | −1 | −1 | R2 = (+1)(−1)(−1) = +1 |
| −1 | +1 | −1 | R3 = (−1)(+1)(−1) = +1 |
| C1 = (+1)(+1)(−1) = −1 | C2 = (+1)(−1)(+1) = −1 | C3 = (+1)(−1)(−1) = +1 | χ = 4 |
任何测量结果预先确定的宇宙都必须遵守 χ ≤ 4(试几组表格你就会发现,χ 只能取 -4、0 和 4)。量子力学允许其取值最高达到 6,而这只有在所有 Rs = +1 且所有 Cs = -1 时才会发生。与大多数此类测试不同,这一测试是态无关的:无论你如何制备量子比特都无关紧要,这使它成为机器本身的属性,而非精心选择的输入所决定的属性。
测量 χ 要求很高:每一行和每一列都必须在同一对量子比特上依次测量,且不能扰动它们。我们用一个额外的辅助量子比特(“ancilla”)来完成这一测量,它接收每个结果并被测量,从而使两个主量子比特保持完好。我们连续进行了 540 次测量,重复了 1,000 次。
我们测得 χ = 5.590 ± 0.008。
轻松超过经典界限 4,且仅距量子极限 7%。这个数字说明:上下文性就存在于这台机器的这一量之中。
它能在规模上存活吗?
两个量子比特是一回事,但量子效应很脆弱,每增加一个量子比特都会带来可能将其淹没的噪声。有用的量子计算需要许多量子比特协同工作,因此问题在于上下文性能否在规模上存活。
在 GHZ 奇偶博弈中,N 个参与者共享一个纠缠的 GHZ 态(所有量子比特为 0 与所有量子比特为 1 的叠加态)。每个参与者得到一个一比特的问题,并在不通信的情况下用一个比特作答。如果所有答案的奇偶性(偶数或奇数)与问题所设定的规则相符,他们就获胜。随机猜测有一半的概率获胜,而最佳的经典策略也只是稍好一些:三个参与者时为 75%,随着参与者增加而趋近 50%。共享的 GHZ 态则每次都能获胜。我们最多用 71 个参与者进行了博弈,每个量子比特对应一个参与者。噪声使我们低于 100%,并随着每增加一个量子比特而增长,因此我们的领先优势收窄,但我们始终保持在经典界限之上。我们还验证了跨越 45 个量子比特的真正纠缠,这超过了许多早期 GHZ 实验的完整规模。
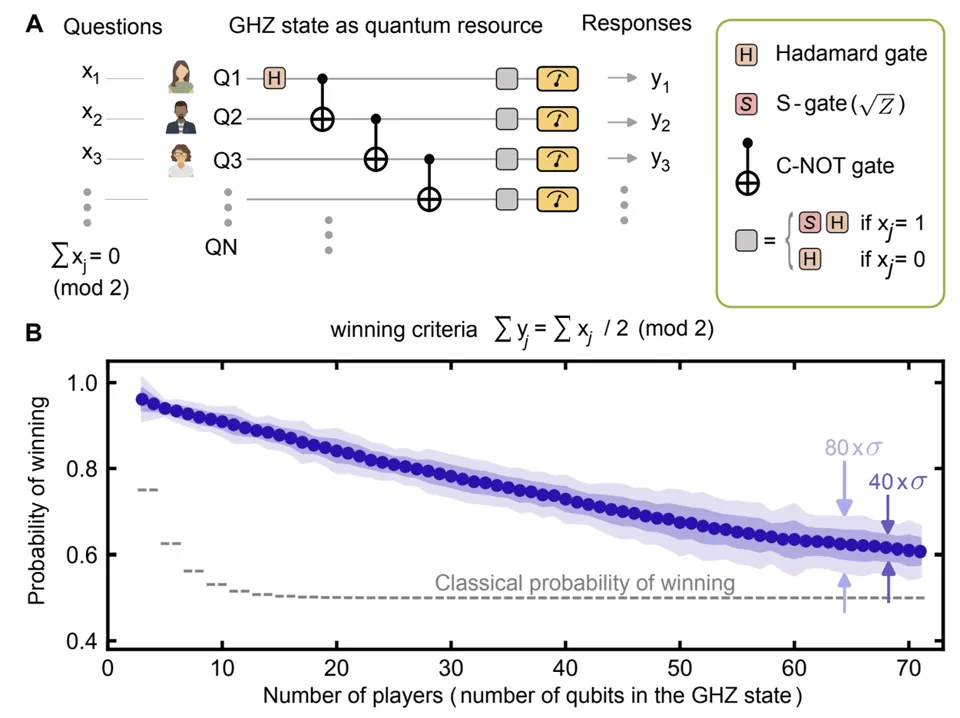
每位玩家根据其问题比特所确定的基来测量自己的量子比特。尽管存在硬件噪声,测得的胜率仍以多个标准差高于最佳经典策略,最多可达 71 位玩家。
除了多人游戏之外,同样的物理原理也将浅层量子电路与经典电路区分开来。2018 年,一项里程碑式的定理证明,一个特定问题——寻找隐藏线性函数——可以由常数深度的量子电路解决,而任何常数深度的经典电路都无法做到。这种量子优势的来源可以追溯到语境性(contextuality)。
在这个证明中,常数深度至关重要。它意味着电路不会随着问题规模增大而变得更深。由于每个输出比特都在固定步数内计算完成,信息只有时间传播很短的距离。因此,每个经典输出只能“看到”输入的一小片邻域,就像一条必须在三分钟内穿越整座城市的传闻。而量子电路由于纠缠已经预先建立,因此不受这种限制。
该算法此前从未在真实硬件上大规模运行过。我们运行了它,在规模高达 105 个量子比特的网格上求解隐藏线性函数实例,成功概率超过二分之一,并且严格采用了理论所规定的浅层电路方案。
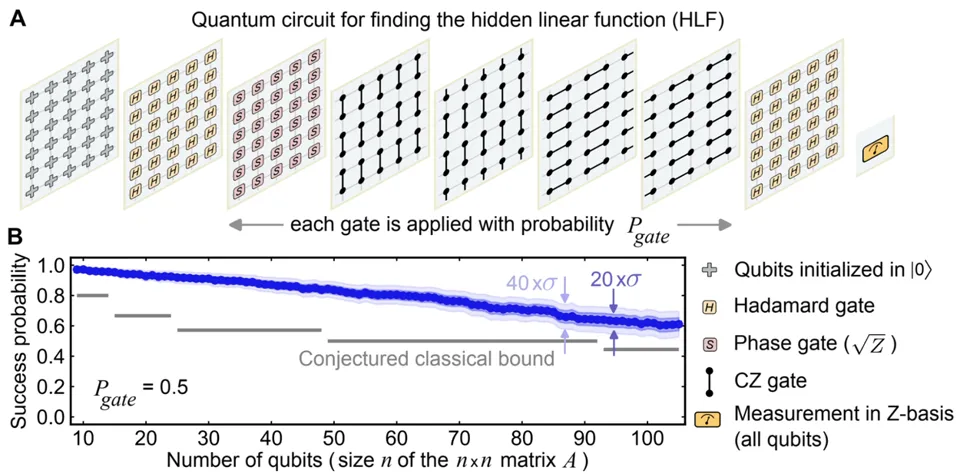
通过施加几层门,我们可以在处理器上编码一个隐藏线性函数问题。随着系统规模增大,噪声使成功概率从约 1 降至达到最大处理器规模时的 0.6,但仍高于推测的经典界限。
意外的收获:一把更好的尺子
在运行这些实验的过程中,一些有用的东西随之出现。这些任务要求许多量子比特同时且精确地保持一致。运行它们揭示了我们系统中微妙的相干错误——那种会使量子态略微偏离目标的错误——而传统的随机电路基准测试往往会将其平均掉,使其变得不可见。
这表明语境性还有第二种用途:不仅是作为一种计算资源,还可以作为一把尺子。
大多数基准测试问的是处理器能否越过某个经典门槛。而这些任务给硬件设定的是由物理本身决定的上限:χ = 6、获胜概率为 1、完美的上下文分数。机器所达到的水平与自然所允许的极限之间的距离,成为一个客观且有意义的分数。而且,与那些越往后越容易越过的经典门槛不同,这个上限永远不会移动。我们的量子处理器越强,这类基准测试的区分度就越高。这对于化学和材料科学中的分子模拟等现实应用尤为重要,因为它衡量的是处理器运行结构化算法的能力——在这类算法中,细微的错误无处藏身。
接下来是什么
一个关于物理系统在无人观测时是否始终存在的、延续近一个世纪的争论,原来可以有一个可测量的检验。对于我们的量子比特,结论很明确:并非我们所测量的一切都具有等待被观测的预先存在的值。理论将上下文性与纠错量子计算机运行完整算法所需的“魔法态”联系起来,而我们团队最近使用魔法态培育制备了这些魔法态。
在多个量子比特上测量上下文性,使我们能够在真实硬件上探究物理学和计算机科学中的一个开放问题:究竟是什么赋予了量子计算机优势。
致谢
这项工作由 Google Quantum AI 团队与我们的学术合作者共同完成。我们感谢所有构建和维护硬件、控制电子设备、低温系统和软件的人,正是他们使这些实验成为可能。